

Velkommen, Habr!
Vi var de første som introduserte temaet og fortsetter å følge utviklingen av det. Spesielt har vi funnet interaksjonen mellom Kafka og . En oversikt (og ganske forsiktig) om dette ble publisert på bloggen til Confluent allerede i oktober i fjor, skrevet av Gwen Shapiro. I dag ønsker vi å rette oppmerksomheten deres mot en ferskere, april-artikkel av Johann Gyger, som, selv om han ikke unngikk spørsmålstegnet i tittelen, betrakter temaet på en mer konkret måte, og supplere teksten med interessante lenker. Beklager vår frie oversettelse av «chaos monkey», hvis dere kan!
Innledning
Kubernetes er laget for å håndtere arbeidsoppgaver som ikke har tilstand. Vanligvis er slike arbeidsmengder representert ved mikrotjenestearkitektur, de er lette, lett kan skaleres horisontalt, følger prinsippene for 12-faktorapplikasjoner, og lar oss arbeide med sikringsautomater (circuit breakers) og kaosaper (chaos monkeys).
Kafka, plassert på den andre siden, fungerer i essens som en distribuert database. Dermed må du håndtere tilstand når du jobber, og det er mye mer tungvint enn en mikrotjeneste. Kubernetes støtter arbeidsoppgaver med tilstand, men som Kelsey Hightower påpeker i to av sine tweets, bør de håndteres med forsiktighet:
Noen synes at hvis de påfører Kubernetes til en arbeidsmengde med tilstand, blir det en fullt administrert database som kan konkurrere med RDS. Det er ikke slik. Kanskje hvis du jobber hardt nok, legger til ekstra komponenter og involverer et SRE-team, klarer du å sette opp RDS over Kubernetes.
Jeg anbefaler alltid å være ekstremt forsiktig med å kjøre arbeidsmengder med tilstand på Kubernetes. De fleste av dem som lurer på, «kan jeg kjøre arbeidsmengder med tilstand på Kubernetes», har ikke tilstrekkelig erfaring med Kubernetes, og ofte heller ikke med den arbeidsmengden de spør om.
Så, bør man kjøre Kafka på Kubernetes? Et motsatt spørsmål: Vil Kafka fungere bedre uten Kubernetes? Derfor ønsker jeg å understreke i denne artikkelen hvordan Kafka og Kubernetes komplementerer hverandre, og hvilke fallgruver som kan oppstå ved å kombinere dem.
Kjørets tid
La oss snakke om det grunnleggende – kjørets tid som sådan
Prosessen
Kafka-brokere er effektive når det kommer til CPU-bruk. TLS kan tilføre noen kostnader. Samtidig kan Kafka-klienter belaste CPU-en mer, hvis de bruker kryptering, men dette påvirker ikke brokerne.
Minne
Kafka-brokere bruker mye minne. Størrelsen på JVM-haugen bør vanligvis begrenses til 4–5 GB, men du vil også trenge mye systemminne, siden Kafka bruker sidecache aktivt. I Kubernetes bør du derfor angi grenser for containere for ressurser og forespørslene deretter.
Datagrunnlag
Datagrunnlag i containere er ephemeral – data går tapt ved omstart. For Kafka-data kan du bruke volum, og effekten vil være den samme: dataene dine vil gå tapt etter en avslutning. Dine meldinger kan likevel bli bevart på andre brokere som replikaer. Derfor, etter en omstart, bør den mislykkede brokeren først replikere all data, og denne prosessen kan ta tid. emptyDirDet er derfor viktig å bruke permanent datalagring. La oss si at dette er en ikke-lokal permanent lagringsløsning med XFS-filsystemet eller mer presist, ext4. Unngå NFS. Jeg advarer deg. NFS versjoner v3 eller v4 vil ikke fungere. For å oppsummere, vil Kafka-brokeren stoppe hvis den ikke kan slette datakatalogen på grunn av et problem med 'dumme omdøpinger', som er en kjent utfordring i NFS. Hvis jeg fortsatt ikke har overbevist deg, vennligst les denne artikkelen nøye.
Datagrunnlaget bør være ikke-lokalt, slik at Kubernetes kan velge en ny node mer fleksibelt etter omstart eller relokalisering. .
Nettverk
Som i de fleste distribuerte systemer avhenger ytelsen til Kafka sterkt av at nettverksforsinkelsene er minimal og båndbredden maksimal. Prøv ikke å plassere alle brokerne på samme node, da dette vil redusere tilgjengeligheten. Hvis en Kubernetes-node feiler, vil hele Kafka-klyngen også feile. Sørg heller ikke for å spre Kafka-klyngen over hele datasentre. Det samme gjelder Kubernetes-klyngen. Et godt kompromiss i dette tilfellet er å velge forskjellige tilgjengelighetssoner.
Konfigurasjon
Vanlige manifester
Kubernetes-siden har om hvordan man konfigurerer ZooKeeper ved hjelp av manifester. Siden ZooKeeper er en del av Kafka, er dette et praktisk utgangspunkt for å bli kjent med hvilke Kubernetes-konsepter som er relevante her. Når du har forstått dette, kan du bruke de samme konseptene med Kafka-klyngen.
- Pod: pod – er den minste distribuerte enheten i Kubernetes. I en pod finnes arbeidsbelastningen din, og selve poden tilsvarer en prosess i klyngen din. En pod kan inneholde en eller flere containere. Hver ZooKeeper-server i ensemblet og hver broker i Kafka-klyngen vil kjøre i en egen pod.
- StatefulSet: StatefulSet – er et Kubernetes-objekt som arbeider med flere arbeidsbelastninger som bevarer tilstander, og slike belastninger krever koordinering. StatefulSets gir garantier om rekkefølgen av podene og deres unikhet.
- Headless-tjenester: Tjenestene lar deg koble podene fra klientene ved hjelp av et logisk navn. Kubernetes håndterer da lastbalansering. Imidlertid, ved operasjoner med arbeidsbelastninger som bevarer tilstander, som i tilfelle ZooKeeper og Kafka, må klientene dele informasjon med en spesifikk instans. Her er headless-tjenester nyttige: i et slikt tilfelle vil klienten fortsatt ha et logisk navn, men den trenger ikke å kontakte poden direkte.
- Volum for langvarig lagring: slike volumer er nødvendig for å konfigurere ikke-lokal blokk-lagring som nevnt ovenfor.
På tilbyr et omfattende sett med manifester for enkelt å komme i gang med Kafka på Kubernetes.
Helm-diagrammer
Helm er en pakkehåndterer for Kubernetes som kan sammenlignes med pakkehåndterere for OS, som yum, apt, Homebrew eller Chocolatey. Med den kan man enkelt installere forhåndsdefinerte programvarepakker beskrevet i Helm-diagrammer. Et godt tilpasset Helm-diagram forenkler den komplekse oppgaven med å konfigurere alle innstillinger for å bruke Kafka på Kubernetes. Det finnes flere Kafka-diagrammer: den offisielle befinner seg , det er en fra , en annen er fra .
Operatører
Siden Helm har visse ulemper, får et annet verktøy mer popularitet: Kubernetes-operatører. En operatør pakker ikke bare programvaren for Kubernetes, men lar deg også distribuere slik programvare og administrere den.
I listen over nevnes to operatører for Kafka. Den ene er . Med Strimzi er det enkelt å sette opp et Kafka-klynge på minutter. Nesten ingen konfigurasjon kreves, i tillegg tilbyr operatøren noen praktiske funksjoner, som punkt-til-punkt TLS-kryptering innen klyngen. Confluent tilbyr også .
Ytelse
Det er viktig å teste ytelsen ved å gi den installerte Kafka-instansen dine kontrollpunkter. Slike tester kan hjelpe deg med å oppdage potensielle flaskehalser før problemene oppstår. Heldigvis tilbyr Kafka allerede to verktøy for ytelsestesting: kafka-producer-perf-test.sh og kafka-consumer-perf-test.sh. Bruk dem aktivt. For referanse kan du sammenligne med resultatene beskrevet i av Jay Kreps, eller orientere deg etter om Amazon MSK av Stéphane Maarek.
Operasjoner
Overvåkning
Transparens i systemet er veldig viktig - ellers forstår du ikke hva som skjer. I dag finnes det kraftige verktøy som gir overvåkning basert på metrikker i cloud-native stil. To populære verktøy for dette formålet er Prometheus og Grafana. Prometheus kan samle metrikker fra alle Java-prosesser (Kafka, Zookeeper, Kafka Connect) ved hjelp av JMX-exportøren - den enkleste måten. Hvis du legger til metrikker fra cAdvisor, vil du få en mer omfattende forståelse av hvordan ressurser brukes i Kubernetes.
Strimzi har et nyttig Grafana-dashboard for Kafka. Det visualiserer nøkkelmetrikker, som for eksempel ikke-replikerte sektorer eller de som er offline. Alt er veldig forståelig. Disse metrikene suppleres med informasjon om ressursbruk og ytelse, samt stabilitetsindikatorer. Dermed får du en grunnleggende overvåking av Kafka-klusteret helt gratis!
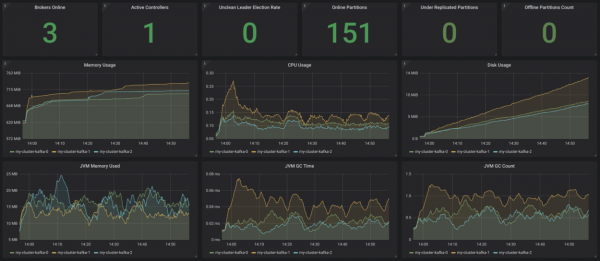
Kilde:
Alt dette ville være fint å supplere med klientovervåking (metrikker for konsumenter og produsenter), samt overvåking av forsinkelse (for dette finnes ) og end-to-end overvåking – for dette, bruk .
Logging
Logging er en annen svært viktig oppgave. Sørg for at alle containere i installasjonen din av Kafka logger til stdout og stderr, og sørg også for at Kubernetes-klusteret ditt samler alle logger i en sentral logginfrastruktur, for eksempel i .
Sunnhetssjekk
Kubernetes bruker livssjekker (liveness) og klarhetsjekker (readiness) for å sjekke om poddene dine fungerer som de skal. Hvis livssjekken mislykkes, vil Kubernetes stoppe denne containeren, og deretter automatisk starte den på nytt hvis omstartpolitikken er riktig satt. Hvis klarhetsjekken mislykkes, isolerer Kubernetes denne podden fra å håndtere forespørslene. Dermed krever slike situasjoner ikke lenger manuell inngripen, noe som er en stor fordel.
Rullende oppdateringer
StatefulSets støtter automatisk oppdatering: når du velger strategien RollingUpdate, vil hver Kafka-pod bli oppdatert sekvensielt. Dette kan redusere nedetid til null.
Skalering
Å skalere Kafka-klusteret er en utfordrende oppgave. Imidlertid er det veldig enkelt å skalere poddene i Kubernetes til et bestemt antall repliker, noe som betyr at du kan deklarativt definere så mange Kafka-brokers som du ønsker. Den mest kompliserte delen av dette er gjenfordelingen av sektorer etter oppskalering eller før nedskalering. Nok en gang vil Kubernetes hjelpe deg med denne oppgaven.
Administrasjon
Oppgaver knyttet til administrasjonen av Kafka-klyngen din, spesielt oppretting av emner og omfordeling av partisjoner, kan utføres ved hjelp av eksisterende shell-skript ved å åpne kommandolinjegrensesnittet i podene dine. Imidlertid er ikke denne løsningen spesielt elegant. Strimzi støtter emnestyring gjennom en annen operatør. Det er her det er rom for forbedringer.
Sikkerhetskopiering og gjenoppretting
Nå vil tilgjengeligheten til Kafka vår avhenge av tilgjengeligheten til Kubernetes. Hvis Kubernetes-klyngen din går ned, så vil i verste fall også Kafka-klyngen gå ned. I henhold til Murphys lov vil dette nødvendigvis skje, og du vil miste data. For å redusere risikoen for slike hendelser, bør du grundig utvikle et sikkerhetskopieringskonsept. Du kan bruke MirrorMaker, og et annet alternativ er å benytte S3 til dette, som beskrevet i denne fra Zalando.
Konklusjon
Når du arbeider med små eller mellomstore Kafka-klynger, er det definitivt fornuftig å bruke Kubernetes, da det gir ekstra fleksibilitet og forenkler arbeidet med operatører. Hvis du har svært strenge ikke-funksjonelle krav når det gjelder latens og/eller båndbredde, kan det imidlertid være bedre å vurdere et annet distribusjonsalternativ.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish