

Vi har utviklet et datasenternettverksdesign som gjør det mulig å distribuere beregningsklynger på mer enn 100 000 servere med en topp bisection bandwidth på over en petabyte per sekund.
I Dmitrij Afanasevs presentasjon vil du lære om de grunnleggende prinsippene bak det nye designet, skalering av topologier, de utfordringene som oppstår, mulige løsninger, samt egenskapene ved ruting og skaleringsfunksjoner for forwarding plane i moderne nettverksenheter i 'tette' topologier med mange ECMP-ruter. I tillegg ga Dima en kort oversikt over organisering av ekstern tilkobling, det fysiske laget, kablingsystemet og måter å øke kapasiteten ytterligere på.
— God dag alle sammen! Jeg heter Dmitrij Afanasev, jeg er nettverksarkitekt hos Yandex og jobber hovedsakelig med design av datasentre.
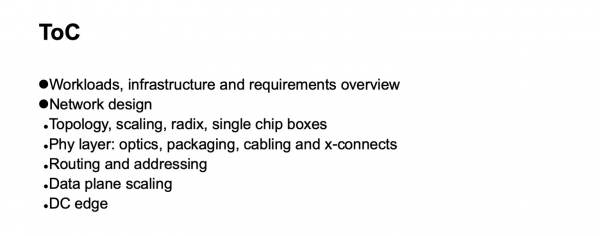
Min presentasjon vil omhandle det oppdaterte datasenternettverket til Yandex. Dette er i stor grad en evolusjon av designet vi hadde tidligere, men det finnes også noen nye elementer. Dette er en oversiktlig presentasjon, ettersom vi måtte få plass til mye informasjon på kort tid. Vi begynner med valget av logisk topologi. Deretter vil det være en oversikt over control plane og utfordringer med skalerbarheten til data plane, valget av hva som vil skje på det fysiske nivået, og vi vil se på noen spesifikasjoner av enhetene. Vi vil også ta opp hva som skjer i datasenteret med MPLS, som vi snakket om for en tid tilbake.
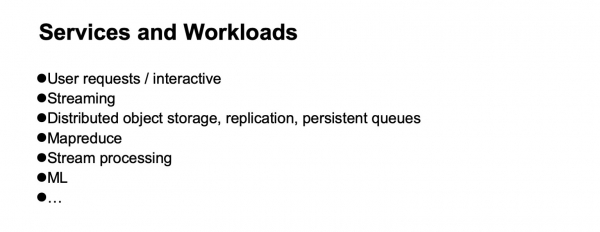
Så, hva er Yandex i forhold til belastninger og tjenester? Yandex er en typisk hyperskala-leverandør. Ser vi fra brukernes perspektiv, så handler det først og fremst om behandling av brukerforespørselene. Det finnes også forskjellige streamingtjenester og datalevering, ettersom vi også har lagertjenester. Når vi snakker om backend, dukker det opp infrastrukturbelastninger og tjenester som distribuerte objektlagringssystemer, datarekrepasjon og, selvfølgelig, vedvarende køer. En av de viktigste belastningstypene er MapReduce og lignende systemer, sanntidsbehandling, maskinlæring, osv.
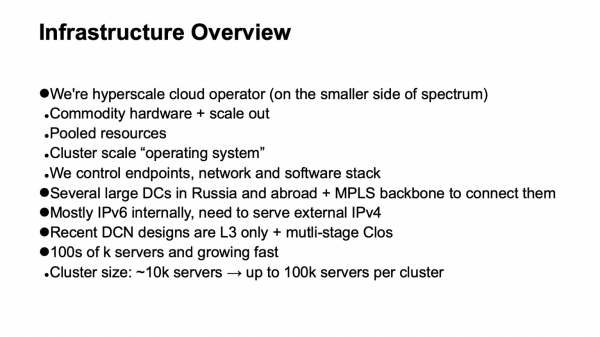
Hvordan er infrastrukturen bygget opp som ligger til grunn for alt dette? Igjen, vi er en relativt typisk hyperskaler, selv om vi kanskje befinner oss litt nærmere den siden av spekteret hvor de mindre hyperskalere befinner seg. Men vi har alle kjennetegnene. Vi bruker kommersiell maskinvare og horisontal skalering der det er mulig. Vi har en fullverdig ressurspooling: vi arbeider ikke med enkeltmaskiner eller enkeltstativ, men sammenfatter dem i en stor pool av utskiftbare ressurser med noen ekstra tjenester som håndterer planlegging og tildeling, og vi arbeider med hele denne poolen.
Dermed oppstår det neste nivået — operativsystemet på nivået til dataklynger. Det er veldig viktig at vi har full kontroll over technologie-stakken som brukes. Vi kontrollerer endepunktene (verter), nettverket og programvare-stakken.
Vi har flere store datasentre i Russland og i utlandet. De er koblet sammen med en backbone som bruker MPLS-teknologi. Vår interne infrastruktur er praktisk talt helt bygget på IPv6, men fordi vi må betjene ekstern trafikk som fremdeles stort sett kommer inn via IPv4, må vi på en eller annen måte levere forespørslene som kommer via IPv4 til frontend-servere, og i tillegg navigere litt i den eksterne IPv4-internett – for eksempel for indeksering.
De siste iterasjonene av designet for datasenternettverk bruker flerlags Clos-topologier, og de benytter bare L3. Vi har forlatt L2 for en stund siden og lettet på pusten. Endelig inkluderer infrastrukturen vår hundretusener av beregningsmessige (server) instanser. Den maksimale størrelsen på klyngen var for en tid siden rundt 10 000 servere. Dette skyldes i stor grad hvordan de spesifikke operativsystemene på klyngen, planleggerne, ressursallokeringen osv. kan operere. Nå er målet en størrelse på rundt 100 000 servere i én dataklynge, og vi har fått oppgaven med å bygge nettverksfabrikker som gjør det mulig å effektivt gjennomføre ressurspooling i en slik klynge.
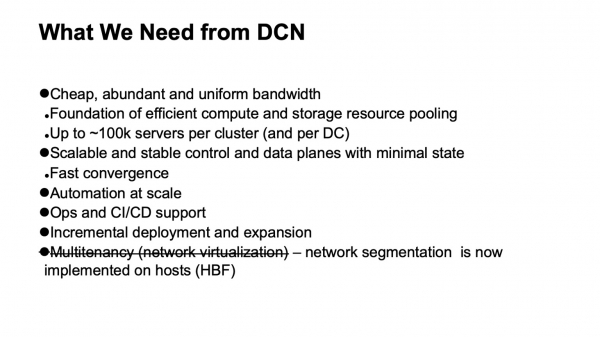
Hva ønsker vi fra datacenternettverket? Først og fremst — mye rimelig og tilstrekkelig jevnt fordelt båndbredde. Fordi nettverket er grunnlaget som gjør at vi kan samle ressurser. Den nye målestørrelsen er omtrent 100 000 servere i en klynge.
Vi ønsker også, selvfølgelig, et skalerbart og stabilt control plane, fordi det oppstår mye hodebry på en så stor infrastruktur, selv fra tilfeldige hendelser, og vi vil ikke at control plane skal gi oss mer hodebry. Samtidig ønsker vi å minimere tilstanden i det. Jo mindre tilstand, desto bedre og mer stabilt fungerer alt, og det er enklere å diagnostisere.
Selvfølgelig trenger vi automatisering, fordi det er umulig å administrere en slik infrastruktur manuelt, og det har vært umulig i lang tid. Vi trenger i størst mulig grad støtte for driftsprosesser og støtte for CI/CD, så langt det lar seg gjøre.
Med slike størrelser på datacentere og klynger har oppgaven med å støtte inkrementell distribusjon og utvidelse uten nedetid blitt presserende. Hvis man på klynger med tusen maskiner, muligens opp til ti tusen maskiner, fortsatt kan rulle ut som én operasjon — det vil si at vi planlegger å utvide infrastrukturen, og flere tusen maskiner legges til som én operasjon, så er en klynge med omtrent hundre tusen maskiner ikke noe som oppstår umiddelbart, den bygges over tid. Og det er ønskelig at det som allerede er utdelt, den infrastrukturen som er rullet ut, er tilgjengelig i løpet av denne tiden.
Og et krav som vi hadde og som har falt bort: støtte for multitenancy, det vil si virtualisering eller segmentering av nettverket. Nå trenger vi ikke å gjøre dette på nivået til nettverksfabrikken, fordi segmenteringen har flyttet til vertene, og dette har lettet skaleringen enormt. Takket være IPv6 og det store adresseområdet, trenger vi ikke å bruke dupliserte adresser i den interne infrastrukturen; all adressering var allerede unik. Og takket være at vi har flyttet filtrering og segmentering av nettverket til vertene, trenger vi ikke å opprette noen virtuelle nettverksenheter i datacenternettverkene.
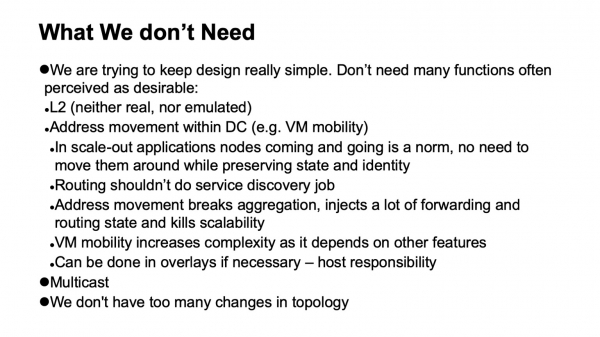
En viktig ting er at vi ikke trenger. Hvis vi kan fjerne noen funksjoner fra nettverket, gjør det livet vårt mye enklere og utvider som regel valget av tilgjengelig maskinvare og programvare, samt forenkler diagnosen.
Så hva er det vi ikke trenger, hva kunne vi gi avkall på, ikke alltid med glede i øyeblikket det skjedde, men med stor lettelse når prosessen var fullført?
Først og fremst, å gi avkall på L2. Vi trenger verken reell eller emulert L2. Det brukes i stor grad ikke på grunn av at vi kontrollerer applikasjonsstakken. Våre applikasjoner skalerer horisontalt, de arbeider med L3-adressering, og de er ikke særlig bekymret for at en enkelt instans slukkes, de ruller bare ut en ny, det er ikke nødvendig å rulle den ut på den gamle adressen, fordi det finnes et eget nivå for service discovery og overvåking av maskiner som er i klyngen. Vi overfører ikke denne oppgaven til nettverket. Nettverksoppgaven er å levere pakker fra punkt A til punkt B.
Vi har heller ikke situasjoner der adresser flyttes innen nettverket, og dette må spores. I mange design er dette vanligvis nødvendig for å opprettholde VM-mobilitet. Vi bruker ikke mobilitet for virtuelle maskiner i den interne infrastrukturen til store Yandex, og vi mener dessuten at selv om dette gjøres, bør det ikke skje med støtte fra nettverket. Hvis det er absolutt nødvendig å gjøre, bør det gjøres på verts-nivå, og adresser som kan migrere, bør plasseres i overlays, slik at vi ikke berører og innfører for mange dynamiske endringer i ruting-systemet til selve underlaget (transportnettverket).
En annen teknologi vi ikke bruker er multicast. De som ønsker, kan jeg gjerne fortelle mer om hvorfor. Dette letter livet betydelig, fordi hvis noen har jobbet med det og sett hvordan control plane for multicast ser ut – i alle installasjoner bortsett fra de enkleste, er dette en stor hodepine. Og dessuten er det vanskelig å finne en godt fungerende åpen implementering, for eksempel.
Og til slutt, vi designer nettverkene våre slik at det ikke skjer for mange endringer. Vi kan forvente at strømmen av ytre hendelser i rutingssystemet er liten.
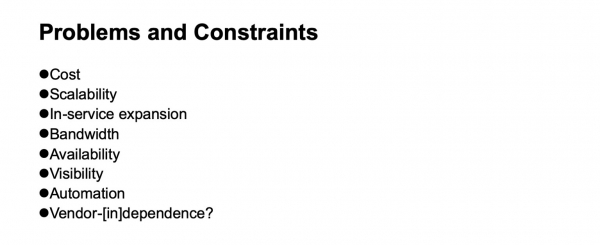
Hvilke problemer og begrensninger må vi ta hensyn til når vi utvikler et datasenternettverk? Kostnader, selvfølgelig. Skalerbarhet, hvor mye vi ønsker å vokse. Behovet for å utvide uten å stoppe tjenesten. Båndbredde, tilgjengelighet. Synligheten av hva som skjer i nettverket, for overvåkningssystemer og driftsteams. Støtte for automatisering – igjen, så langt som mulig, ettersom ulike oppgaver kan løses på ulike nivåer, inkludert innføring av flere lag. Og så, avhengighet fra leverandører, så lite som mulig. Selv om i forskjellige historiske perioder, avhengig av hvilken del vi ser på, har denne uavhengigheten vært lettere eller vanskeligere å oppnå. Når vi ser på laget av nettverksbrikker, har det til nylig vært veldig betinget å snakke om uavhengighet fra leverandører, hvis vi ønsket brikker med høy båndbredde.
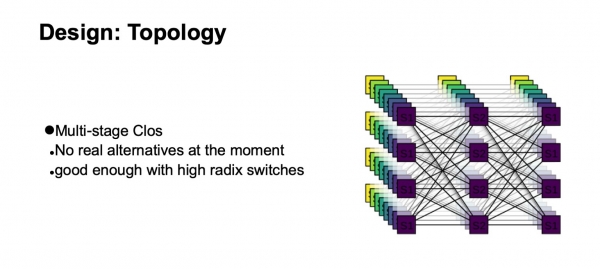
Hvilken logisk topologi vil vi bygge nettet vårt på? Det vil være en flernivå Clos. Faktisk finnes det per nå reelle alternativer. Og Clos-topologien er ganske god, selv når vi sammenligner den med ulike avanserte topologier som nå mer er av akademisk interesse, dersom vi har svitsjer med stor radix.
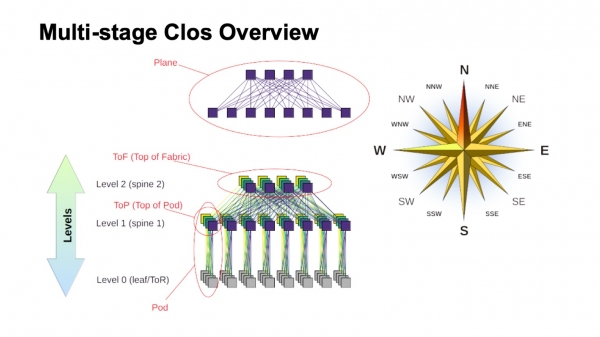
Hvordan er en flernivå Clos-nettverk omtrent organisert og hva kalles de ulike elementene i det? Først og fremst kompassrosen, for å orientere oss hvor nord, sør, øst og vest er. Nettverk av denne typen bygges vanligvis av de som har veldig høy øst-vest trafikk. Når det gjelder de andre elementene, er det øverst en virtuell svitsj som er bygd opp av mindre svitsjer. Dette er hovedideen med den rekursive byggingen av Clos-nettverk. Vi tar elementer med en viss radix og kobler dem sammen slik at det vi får, kan betraktes som en svitsj med større radix. Hvis det trengs enda mer, kan prosessen gjentas.
I tilfeller som for eksempel med to-nivå Clos, der man klart kan skille ut komponentene som er vertikale i mitt diagram, pleier de å bli kalt plan. Hvis vi bygde en Clos med tre nivåer av spine-switcher (alle som ikke er grense- eller ToR-switcher og som kun brukes for transit), ville planene se mer kompliserte ut; to-nivåene ser slik ut. Enhetene av ToR- eller leaf-switcher og de associerte spine-switchene på det første nivået kaller vi Pod. Spine-switchene på nivået spine-1 øverst i Pod er toppen av Pod. Switchene som befinner seg øverst i hele fabrikken er det øverste laget av fabrikken, Top of fabric.
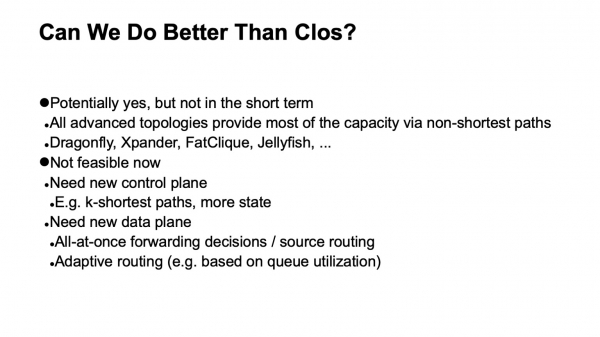
Selvfølgelig kommer spørsmålet: Clos-nettverk har blitt bygget en stund, selve ideen stammer fra tidene med klassisk telefoni, TDM-nettverk. Kanskje har det dukket opp noe bedre, kanskje kan vi gjøre det bedre på en eller annen måte? Både ja og nei. Teoretisk sett ja, men i praksis er det definitvt nei på kort sikt. Fordi det finnes et visst antall interessante topologier, hvorav noen faktisk brukes i produksjon; for eksempel brukes Dragonfly i HPC-applikasjoner. Det finnes også interessante topologier som Xpander, FatClique, Jellyfish. Hvis man ser på foredrag på konferanser som SIGCOMM eller NSDI de siste årene, vil man oppdage et ganske stort antall arbeider om alternative topologier som har bedre egenskaper (på en eller annen måte) enn Clos.
Men alle disse topologiene har en interessant egenskap. Denne hindrer implementeringen av dem i datasenter-nettverkene som vi prøver å bygge på vanlig maskinvare og som koster ganske rimelige penger. I alle disse alternative topologiene er dessverre størstedelen av båndbredden ikke tilgjengelig via de korteste stiene. Derfor mister vi umiddelbart muligheten til å bruke tradisjonell kontrollplane.
Teoretisk sett er løsningen på problemet kjent. Dette inkluderer for eksempel modifikasjoner av link state ved bruk av k-korteste ruter, men igjen er det ingen protokoller som er implementert i produksjon og massevis tilgjengelig på utstyret.
Vidare, ettersom mesteparten av kapasiteten ikke er tilgjengelig via de korteste rutene, må vi endre ikke bare kontrollplanet slik at det kan velge alle disse rutene (og forresten, dette er en betydelig større tilstand i kontrollplanet). Vi må også modifisere forwarding planet, og som regel krever det minst to ekstra funksjoner. Dette er muligheten til å ta alle beslutninger om videresending av pakker på en gang, for eksempel på verten. Faktisk er dette kilderuting, noen ganger omtalt i litteraturen om sammenkoblede nettverk som all-at-once forwarding decisions. Og så har vi adaptiv ruting — dette er allerede en funksjon vi trenger på nettverksenhetene, som for eksempel innebærer å velge neste hop, basert på informasjon om den minste købelastningen. Som eksempel er det mulig å ha andre alternativer.
Dermed er retningen interessant, men dessverre kan vi ikke anvende den akkurat nå.
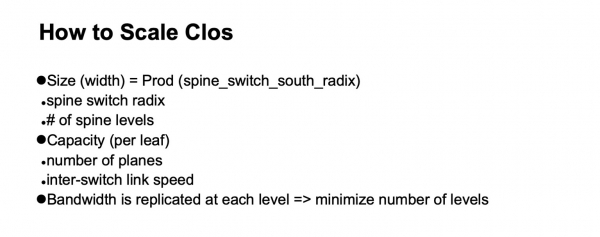
Ok, vi har landet på den logiske Clos-topologien. Hvordan skal vi skalere den? La oss se på hvordan den er strukturert og hva vi kan gjøre.
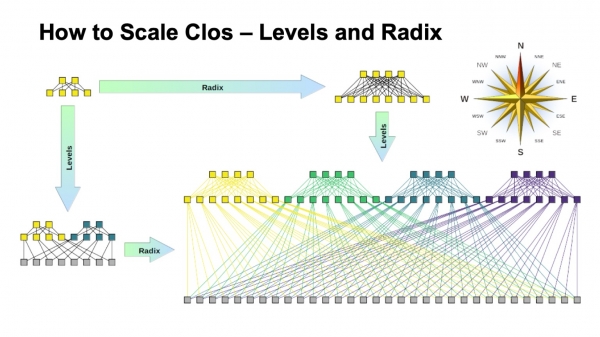
I Clos-nettet er det to hovedparametere som vi kan variere for å oppnå ulike resultater: radikene til elementene og antallet nivåer i nettverket. Jeg har skjematisk vist hvordan begge deler påvirker størrelsen. Ideelt sett kombinerer vi begge.
Det er tydelig at den endelige bredden på Clos-nettet er produktet av alle sluttbryterne i den sørlige radiksen, antall lenker vi har nedover, og hvordan det forgrener seg. Slik skalerer vi nettverksstørrelsen.
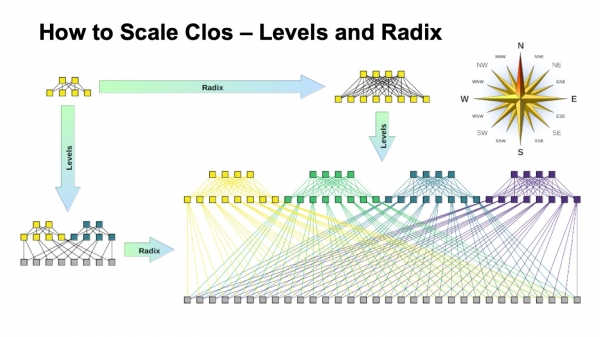
Når det gjelder kapasitet, spesielt på ToR-brytere, er det to skaleringsalternativer. Vi kan enten, mens vi opprettholder den generelle topologien, bruke høyhastighetslenker, eller vi kan legge til flere plan.
Hvis vi ser på den utvidede varianten av Clos-nettet (nederst til høyre) og går tilbake til bildet av Clos-nettet nederst…
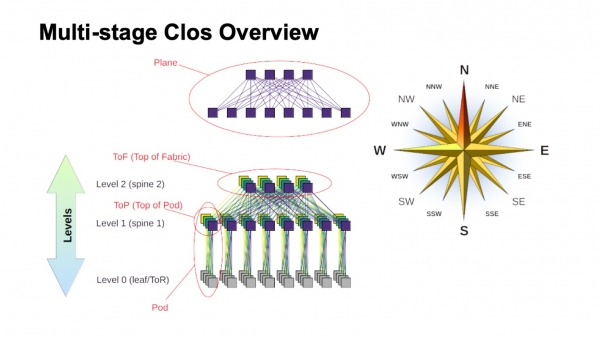
… er det akkurat den samme topologien, men i dette lysbildet er den komprimert mer kompakt og fabrikkplanene er lagt oppå hverandre. Det er det samme.
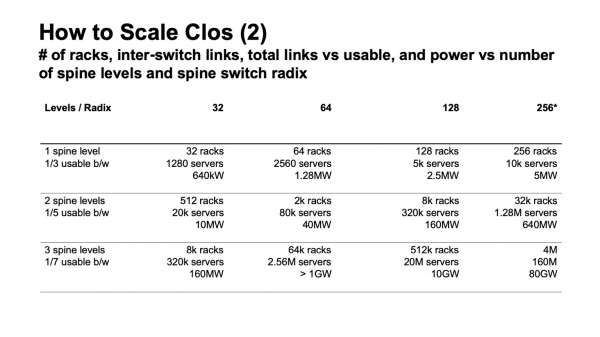
Hvordan ser skaleringen av Clos-nettet ut i tall? Her har jeg oppgitt data om hvilken maksimal bredde nettverket kan ha, hvor mange stativer, ToR-brytere eller leaf-brytere, hvis de ikke er i stativene, vi kan få avhengig av hvilken radiks av brytere som brukes for spine-nivåene, og hvor mange nivåer vi bruker.
Her er hvor mange rack vi kan ha, hvor mange servere og omtrent hvor mye strøm dette kan kreve med en beregning på 20 kW per rack. Jeg nevnte tidligere at vi siktet mot en klusterstørrelse på rundt 100 000 servere.
Det er tydelig at det i hele denne konstruksjonen er interessante elementer knyttet til to og en halv varianter. Det finnes en variant med to lag spine switches og 64-porters svitsjer, som er noe under kravene. Deretter er det gode alternativer for 128-porters (med radix 128) spine switches med to nivåer, eller switches med radix 32 med tre nivåer. I alle tilfeller, der hvor radix og nivåer øker, kan man lage et svært stort nettverk, men hvis man ser på det forventede strømforbruket, er det som regel gigawatt. Man kan legge til kabler, men så mye strøm kan vi sannsynligvis ikke få på ett sted. Ser man på statistikken, er det svært få datasentre med beregnet kapasitet på over 150 MW. Det som er høyere, er som regel datasenterkampus, flere store datasentre som ligger relativt nært hverandre.
Det er også en viktig parameter. Hvis du ser på venstre kolonne, vil du se at usable bandwidth er angitt. Det er ikke vanskelig å merke seg at i et Clos-nettverk går en betydelig del av portene til å forbinde svitsjer med hverandre. Usable bandwidth, den nyttige båndbredden, er det vi kan gi ut mot serverne. Selvfølgelig snakker jeg om betingede porter og akkurat om båndbredden. Vanligvis er lenkene innen nettverket raskere enn lenkene mot serverne, men for hver enhet av båndbredde som vi kan gi ut til serverutstyret vårt, må vi ta hensyn til at det også er en eller annen båndbredde internt i nettverket. Og jo flere nivåer vi lager, jo større blir de relative kostnadene for å gi denne båndbredden ut.
Videre er selv denne ekstra båndbredden ikke helt lik. Så lenge avstandene er korte, kan vi bruke noe som DAC (direct attach copper, altså twinax-kabler), eller multimode optikk som fortsatt er tilgjengelig til en rimelig pris. Så snart vi går over til lengre avstander — er det som regel single mode optikk, og kostnadene for denne ekstra båndbredden øker betydelig.
Og igjen, tilbake til forrige lysbilde, hvis vi lager et Clos-nettverk uten re-signering, er det ikke vanskelig å se på skjemaet, se hvordan nettverket bygges - ved å legge til hvert nivå av spine-switcher, gjentar vi hele den båndbredden som var nederst. I tillegg til nivået - i tillegg til den samme båndbredden, like mye som det var på forrige nivå, porter på svitsjene, enda så mange transceivere. Derfor er det veldig ønskelig å minimere antall nivåer av spine-switcher.
Basert på dette bildet, er det klart at vi virkelig ønsker å bygge på noe som svitsjer med radix 128.
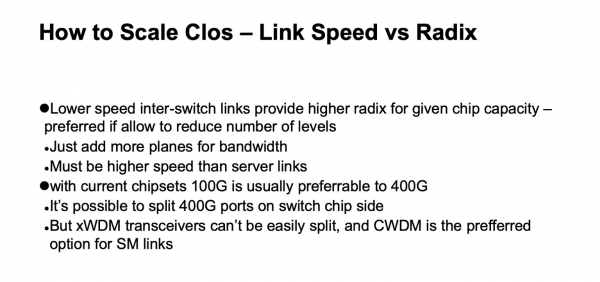
Her er det i grunn det samme som jeg nettopp har sagt, dette lysbildet er mer for senere vurdering.
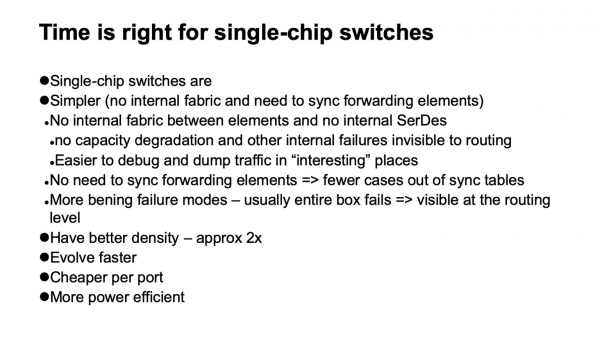
Hvilke alternativer har vi for hva vi kan velge som slike svitsjer? En veldig hyggelig nyhet for oss er at slike nettverk endelig kan bygges på enbrikkesvitsjer. Og det er veldig bra, de har mange hyggelige egenskaper. For eksempel har de nesten ingen intern struktur. Det betyr at de er lettere å feile. De feiler, uten tvil, men de feiler heldigvis helt. I modulære enheter er det et stort antall feil (veldig ubehagelige) hvor det ser ut som det fungerer fra naboers og control plane's perspektiv, men for eksempel har en del av fabrikken gått bort, og det fungerer ikke med full kapasitet. Og trafikken balanseres basert på at det er fullstendig funksjonelt, og vi kan oppleve overbelastning.
Eller, for eksempel, oppstår det problemer med backplane, fordi det også finnes høyhastighets SerDes-er inne i modulære enheter - det er virkelig komplisert bygget innvendig. Eller tabellene mellom forwarding-elementene synkroniseres eller synkroniseres ikke. Generelt inneholder enhver høyytelses modulær enhet, bestående av mange elementer, vanligvis den samme Clos-nettverket, bare at det er veldig vanskelig å diagnostisere. Ofte er det til og med vanskelig for selve leverandøren å diagnostisere.
Og det har mange feilscenarier der enheten degraderer, men ikke faller helt ut av topologien. Siden vi har et stort nettverk, brukes lastbalansering aktivt mellom identiske enheter, nettet er veldig regulært, det vil si at en rute der alt fungerer, ikke skiller seg fra en annen rute, er det mer fordelaktig for oss å miste en del enheter fra topologien enn å havne i en situasjon der noen av dem ser ut til å fungere, men egentlig ikke gjør det.
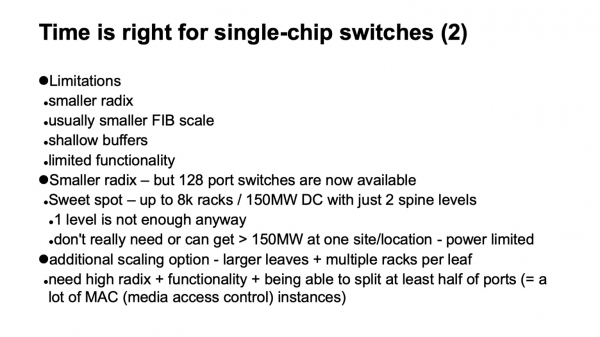
Den neste hyggelige funksjonen ved chip-baserte enheter er at de evolverer bedre og raskere. De har også vanligvis bedre kapasitet. Når vi ser på de store innsamlede konstruksjonene vi har, er kapasiteten per rack-enhet i form av porter med samme hastighet nesten dobbelt så bra som for modulære enheter. Enhetene bygget rundt en enkelt chip viser seg å være merkbart billigere enn modulære enheter, og de bruker mindre energi.
Men selvfølgelig er det ikke så enkelt, det finnes ulemper. For det første har de praktisk talt alltid lavere radialitet enn modulære enheter. Hvis vi kan få en enhet bygget rundt en enkelt chip med 128 porter, kan vi få en modulær enhet med flere hundre porter uten store problemer.
Det er merkbart mindre størrelse på videresendingstabeller, og generelt alt som gjelder skalerbarhet i datanettverket. Grunne buffere. Og generelt ganske begrenset funksjonalitet. Men det viser seg at hvis man kjenner disse begrensningene og tar seg tid til å omgå dem eller bare ta dem i betraktning, så er det ikke så skummelt. Det at radialiteten er mindre, er ikke lenger et problem med de nylig lanserte enhetene med en radialitet på 128; vi kan bygge oss med to lag av spine-enheter. Uansett kan man ikke bygge noe interessant i størrelse med mindre enn to. Med ett nivå får man bare veldig små klynger. Selv våre tidligere design og krav overskred dem fortsatt.
Faktisk, hvis en løsning ligger litt på grensen, finnes det en annen måte å skalere på. Siden det laveste nivået, der serverne er koblet til, er ToR-svitsjer eller leaf-svitsjer, er vi ikke pålagt å koble bare en rack til dem. Derfor, hvis løsningen mangler med to ganger, kan vi vurdere å bruke en svitsj med større radikser på bunnenivå og for eksempel koble to eller tre rack til én svitsj. Dette er også et alternativ, det har sine kostnader, men fungerer godt og kan vise seg å være en god løsning når det er nødvendig å fordoble størrelsen.
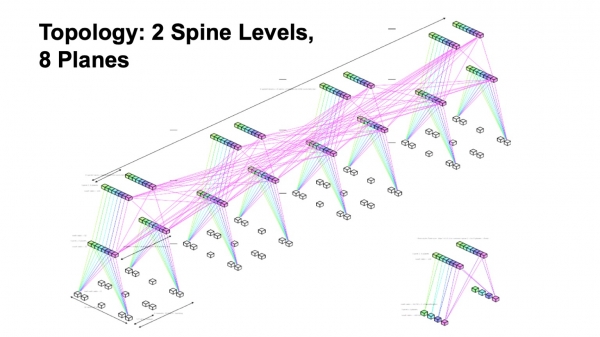
For å oppsummere bygger vi med en to-nivå spine-topologi, med åtte lag av fabrikken.
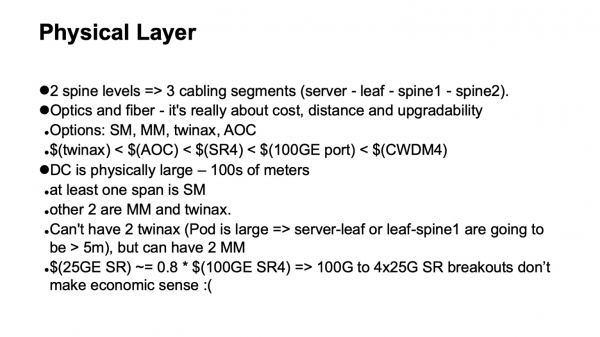
Hva skjer med fysikken? Veldig enkle beregninger. Hvis vi har to nivåer av spines, har vi totalt tre nivåer av svitsjer, og vi forventer at det vil være tre kabelfragmenter i nettverket: fra servere til leaf-svitsjer, til spine 1, til spine 2. Alternativene vi kan bruke er twinax, multimode, single mode. Her må vi ta hensyn til hvilken båndbredde som er tilgjengelig, hva det vil koste, hvilke fysiske dimensjoner det har, hvilke spenninger vi kan håndtere, og hvordan vi vil oppgradere.
Når det gjelder kostnadene kan alt organiseres i en linje. Twinax er betydelig billigere enn aktiv optikk, billigere enn multimode transceivere, hvis vi ser på prisen per lengde, noe billigere enn en 100-gigabit port på svitsjen. Og det, merk deg, er billigere enn single mode optikk, fordi på strekninger hvor single mode kreves, er det fornuftig å bruke CWDM i datasentre av flere grunner, og å jobbe med parallell single mode (PSM) er ikke veldig praktisk, vi får veldig store fiberbunter, og hvis vi stopper opp ved disse teknologiene, får vi omtrent en slik hierarki på prisene.
En annen bemerkning: dessverre er det ikke veldig mulig å bruke oppdelte 100 til 4x25 multimode porter. På grunn av konstruksjonsmessige egenskaper koster SFP28 ikke mye mindre enn QSFP28 på 100 Gbit. Og denne oppdelingen fungerer ikke så godt for multimode.
En annen begrensning er at på grunn av størrelsen på beregningsklyngene og antall servere, blir datacentrene våre fysisk store. Dette betyr at minst én spenning må utføres med single-mode. Igjen, på grunn av den fysiske størrelsen på Pods, vil det ikke være mulig å gå over to spenninger med twinax-kabler.
Som et resultat, hvis vi optimaliserer for pris og tar hensyn til geometrien til denne konstruksjonen, får vi én spenning med twinax, én spenning med multimode og én spenning med single-mode ved bruk av CWDM. Dette tar høyde for mulige oppgraderingsveier.
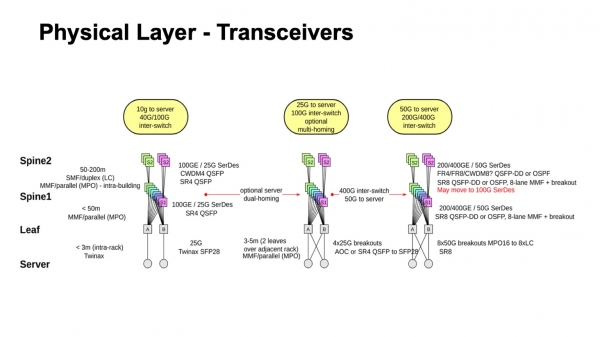
Slik ser det ut, hva som har skjedd nylig, hvor vi beveger oss, og hva som kan være mulig. Det er klart, i det minste når det gjelder å bevege seg mot 50-gigabit SerDes for både multimode og single-mode. Videre, hvis vi ser på hva som finnes i single-mode transceivere nå og på lang sikt for 400G, da ofte når 50G SerDes kommer på den elektriske siden, kan optikken allerede være på 100 Gbps per bane. Så det er ganske mulig at i stedet for overgang til 50, vil vi ha overgang til 100-gigabit SerDes og 100 Gbps per bane, fordi mange leverandører lover at tilgjengeligheten deres forventes snart. Perioden der 50G SerDes var de raskeste, ser ut til å være kortvarig, fordi de første eksemplarene av 100G SerDes vil bli rullet ut allerede neste år. Og etter en stund vil de kanskje koste rimelige penger.
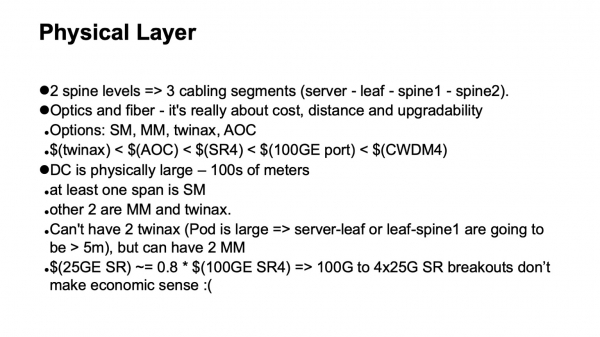
En annen detalj angående valg av fysikk. Egentlig kan vi allerede nå bruke 400- eller 200-gigabit porter med 50G SerDes. Men det viser seg at det ikke gir mye mening, fordi som jeg nevnte tidligere, ønsker vi en tilstrekkelig høy radix på switchene, innenfor rimelighetens grenser, selvsagt. Vi ønsker 128. Hvis vi har en chipkapasitet som er begrenset og øker lenkehastigheten, reduseres radiksen, det er ingen mirakler.
Og den totale kapasiteten kan vi øke ved å legge til plan, og samtidig er det ikke spesielle kostnader, vi kan øke antallet plan. Hvis vi mister radiksen, må vi introdusere et ekstra nivå, så med de nåværende forutsetningene, med den maksimalt tilgjengelige kapasiteten per chip, viser det seg at det er mer effektivt å bruke 100-gigabit porter, fordi de gir oss en større radix.
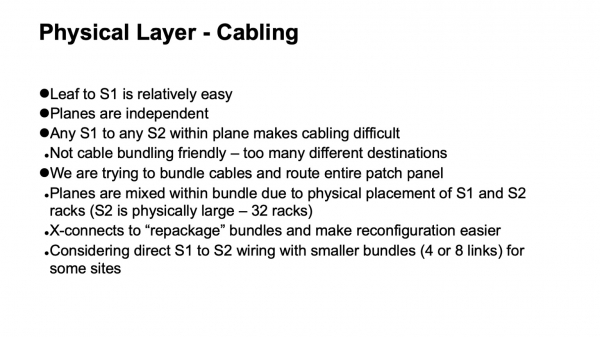
Neste spørsmålet handler om hvordan fysikken er organisert, men nå fra perspektivet til kabelinfrastrukturen. Det viser seg at det er organisert på en ganske underholdende måte. Kabler mellom leaf-switcher og første nivå spine-switcher — det er ikke så mange lenker der, alt er relativt enkelt å bygge opp. Men hvis vi ser på ett plan, det som skjer innvendig — der må alle første nivå spine-switcher kobles sammen med alle andre nivå spine-switcher.
I tillegg er det som regel noen ønsker angående hvordan dette skal se ut inne i datasenteret. For eksempel ønsket vi sterkt å samle kablene i bunter og trekke dem slik at en høydensitets patchpanel gikk helt til en annen patchpanel, for å unngå en dyrehage av lengder. Vi klarte å løse dette problemet. Hvis vi ser på den logiske topologien, så er det tydelig at planene er uavhengige, hver plan kan bygges for seg selv. Men når vi legger til en slik buntering og ønsker å trekke en patchpanel helt til en annen patchpanel, må vi blande forskjellige plan innenfor en bunde og introdusere en mellomliggende konstruksjon i form av optiske kryssforbindelser, for å ompakke dem fra hvordan de ble samlet på ett segment, til hvordan de vil bli samlet på et annet segment. Takket være dette får vi en hyggelig egenskap: all kompleks kobling forblir innenfor skapene. Når noe må være svært sammenfiltret, "brette ut planene", som det noen ganger kalles i Clos-nettverk, er alt konsentrert innenfor ett skap. Vi har ikke sterkt fragmenterte tilkoblinger, så langt som individuelle lenker, mellom skapene.
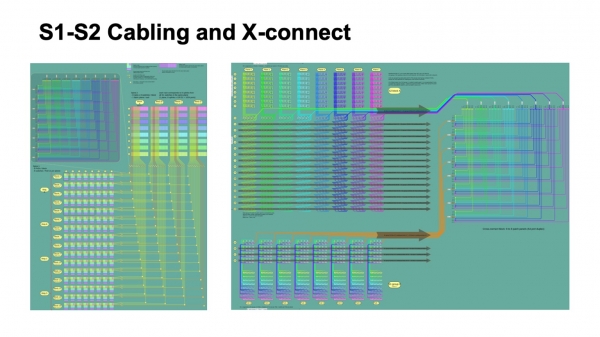
Slik ser det ut fra perspektivet av den logiske organiseringen av kabelinfrastrukturen. På bildet til venstre representerer de fargerike blokkene blokkene av første nivå spine-switcher, med åtte av dem, og de fire bunter av kabler som går fra dem, som krysser bunter fra andre nivå spine-switcher.
Små rutene representerer sammenkjøringer. Øverst til venstre er det en oversikt over hver sammenkjøring, som faktisk er en cross-connect-modul med 512 på 512 porter, som pakker kablene slik at de kommer helt inn i en rack, hvor det bare er ett spine-2-plan. Og til høyre er det en litt mer detaljert oversikt over dette bildet, relatert til flere Pods på spine-1-nivå, og hvordan dette pakkes i cross-connect, hvordan det kommer opp til spine-2-nivå.
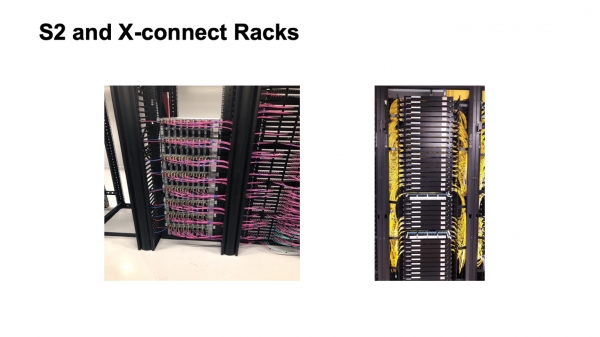
Slik ser det ut. En ikke helt sammenstilt spine-2-rack (til venstre) og en cross-connect-rack. Dessverre er det ikke så mye som er synlig der. Hele denne konstruksjonen rulles ut akkurat nå i en av våre store datSentere som utvides. Dette er et pågående arbeid, det vil se bedre ut, det vil bli bedre fylt.
Et viktig spørsmål: vi har valgt en logisk topologi og bygget opp den fysiske strukturen. Hva skjer med control plane? Det er godt kjent fra driftsopplevelsen at det er et visst antall prediksjoner om at link-state-protokoller er bra, de er behagelige å jobbe med, men dessverre skalerer de dårlig i en tett sammenkoblet topologi. Og det er en hovedfaktor som hindrer dette — det er hvordan flooding fungerer i link-state-protokoller. Hvis vi bare tar flooding-algoritmen og ser på hvordan nettverket vårt er strukturert, ser vi at det vil være veldig stor fanout på hvert steg, og det vil bare oversvømme control plane med oppdateringer. Slike topologier med den tradisjonelle flooding-algoritmen i link-state-protokoller fungerer ikke godt sammen.
Valget — å bruke BGP. Hvordan det skal forberedes, er beskrevet i RFC 7938 om bruk av BGP i store datSentere. Grunnleggende ideer er enkle: minimal antall prefikser per vert og generelt minimal antall prefikser i nettverket, bruk av aggregasjon hvis mulig, og dempe path hunting. Vi ønsker en veldig kontrollert spredning av oppdateringer, det som kalles valley free. Vi ønsker at oppdateringene, når de går gjennom nettverket, blir utbredt akkurat én gang. Hvis de stammer fra bunnen, går de opp, og sprer seg ikke mer enn én gang. Det skal ikke være zigzagging. Zigzagging er veldig dårlig.
For this, we use a fairly simple scheme to utilize the basic mechanisms of BGP. This means that we employ eBGP, operating on link local, and autonomous systems are assigned as follows: an autonomous system on ToR, an autonomous system for the entire block of spine-1 switches within a Pod, and a common autonomous system for the entire Top of Fabric. It's not difficult to see that even normal BGP behavior gives us the update propagation we desire.
Naturally, we have to design addressing and address aggregation in a way that is compatible with how routing is structured, ensuring stability of the control plane. L3 addressing in transit is tied to the topology, because without this, aggregation can't be achieved; individual addresses would penetrate the routing system. Another point is that aggregation, unfortunately, does not mix well with multi-path, because when we have multi-path and aggregation, everything is fine as long as the entire network is operational and there are no failures. Unfortunately, once failures occur in the network and the symmetry of the topology is lost, we may end up in a point from which the aggregate was announced, from where we cannot proceed to where we need to go. Therefore, it's best to aggregate where there is no further multi-path, in our case this is on ToR switches.
In fact, aggregation is possible, but with caution. If we can implement controlled de-aggregation when failures occur in the network. However, this is a quite complicated task; we even considered whether it could be done, whether additional automation could be implemented, and finite automata that would correctly interact with BGP to achieve the desired behavior. Unfortunately, handling corner cases is very non-obvious and complex, and attaching external equipment to BGP does not solve this task well.
Very interesting work has been done in this regard within the RIFT protocol, which will be discussed in the next presentation.
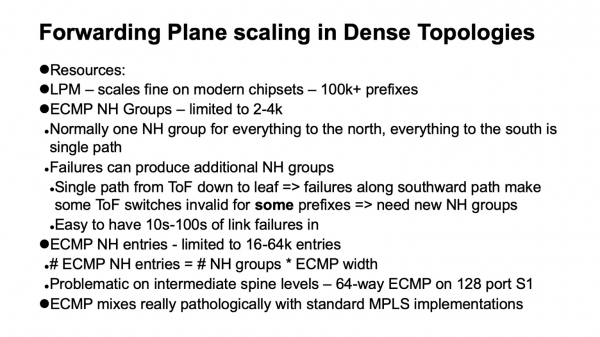
Another important aspect is how data planes scale in dense topologies where there are many alternative paths. In this context, several additional data structures are used: ECMP groups, which in turn describe groups of Next Hop.
I en normalt fungerende nettverk, uten feil, når vi går oppover i Clos-topologien, er det tilstrekkelig å bruke bare én gruppe, fordi alt som ikke er lokalt, beskrives av standardinnstillingen, og man kan gå oppover. Når vi går nedover mot sør, er imidlertid alle stier ikke ECMP, men single path-stier. Alt er bra. Problemet, og særegenheten til den klassiske Clos-topologien, er at hvis vi ser på toppen av fabrikken, er det én vei fra hvilket som helst element til ethvert element nedenfor. Hvis det oppstår feil langs denne veien, blir det spesifikke elementet på toppen av fabrikken ugyldig for de prefiksene som ligger bak den ødelagte veien. For de andre er det gyldig, og vi må analysere ECMP-gruppene og introdusere en ny status.
Hvordan ser skalerbarheten til data plane ut på moderne enheter? Hvis vi gjør LPM (longest prefix match), fungerer det ganske bra, over 100k prefikser. Når vi snakker om Next Hop-grupper, ser det verre ut, 2-4 tusen. Når vi snakker om tabellen som inneholder beskrivelsen av Next Hops (eller adjacencies), er det et sted mellom 16k og 64k. Og dette kan bli et problem. Og her kommer vi til et interessant avsnitt: hva skjedde med MPLS i datasentre? I utgangspunktet ønsket vi å implementere det.
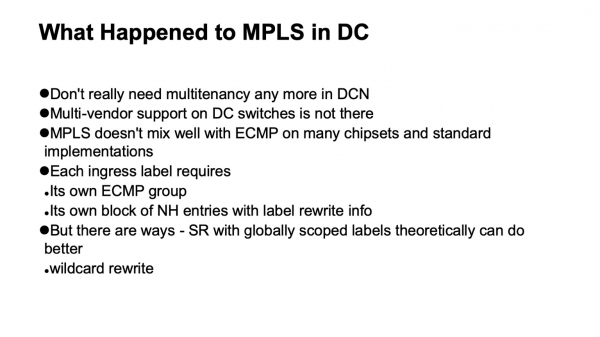
To ting skjedde. Vi implementerte mikrosegregering på vertsene, så vi trengte ikke å gjøre det på nettverket. Det var ikke veldig godt med støtte fra forskjellige leverandører, og spesielt med åpne implementeringer på white boxes med MPLS. I tillegg er MPLS, i det minste dens tradisjonelle implementeringer, dessverre svært dårlig kompatibel med ECMP. Og det er grunnen til dette.
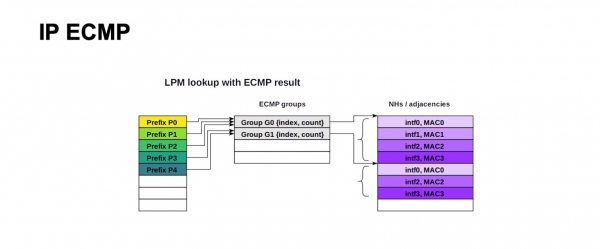
Slik ser strukturen for ECMP-forwarding for IP ut. Et stort antall prefikser kan bruke den samme gruppen og den samme blokken med Next Hops (eller adjacencies, dette kan kalles forskjellig i ulike dokumentasjoner for forskjellige enheter). Poenget er at dette beskrives som utgående port og hva som skal omskrives til MAC-adressen for å nå riktig Next Hop. For IP er det ganske enkelt, man kan bruke mange prefikser for den samme gruppen, den samme blokken med Next Hops.
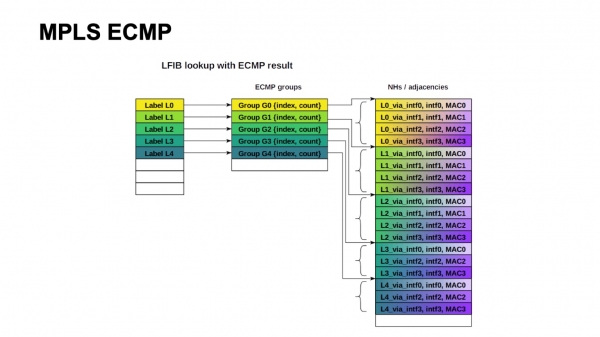
Den klassiske MPLS-arkitekturen innebærer — avhengig av utgående grensesnitt, kan etiketten skrives om til ulike verdier. Derfor må vi holde gruppen og blokken med Next Hops for hver inngående etikett. Og det, dessverre, skalerer ikke.
Det er ikke vanskelig å se at vi i vår konstruksjon trengte omtrent 4000 ToR-brytere, med maksimal bredde på 64 ECMP-stier, dersom vi går fra spine-1 til spine-2. Vi klarer akkurat å komme inn i én ECMP-gruppetabell, hvis bare én prefiks fra ToR går ut, og vi kommer overhodet ikke inn i tabellen for Next Hops.
Alt er ikke håpløst, fordi arkitekturer som Segment Routing innebærer globale merker. Formelt kunne man igjen presset alle disse blokkene med Next Hops sammen. For dette trengs en operasjon som ligner på wild card: ta et merke og skrive det til det samme uten spesifikke verdier. Men dessverre finnes det ikke så mye av dette i de tilgjengelige implementasjonene.
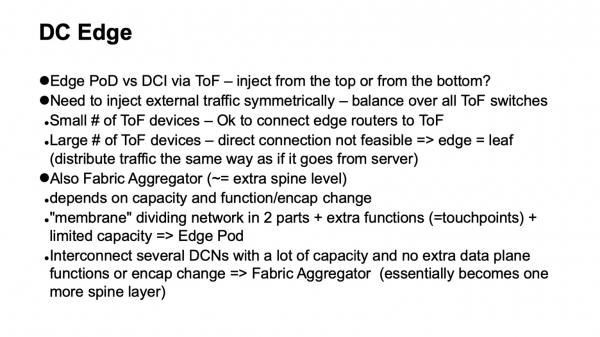
Og til slutt må vi bringe ekstern trafik inn i datasenteret. Hvordan gjør vi det? Tidligere ble trafikken ført inn i Clos-nettverk ovenfra. Det vil si at det var grense-rutere som koblet til alle enhetene på Top of fabric. Denne løsningen fungerer ganske bra for små og mellomstore størrelser. Dessverre, for å føre trafikk slik symmetrisk gjennom hele nettverket, må man komme til alle elementene på Top of fabric samtidig. Når det blir mer enn hundre, viser det seg at vi trenger en stor radikal også på grense-rutere. Generelt, dette koster penger, fordi grense-rutere er mer funksjonelle, og portene på dem vil være dyrere, noe som gir en ikke så pen konstruksjon.
Et annet alternativ er å føre slik trafik nedenfra. Det er ikke vanskelig å se at Clos-topologien er bygget slik at trafikken som kommer opp fra bunnen, dvs. fra ToR, fordeles jevnt på nivåene over hele Top of fabric på to iterasjoner, og laster hele nettverket. Derfor introduserer vi en spesialtype Pod, Edge Pod, som sikrer ekstern tilkobling.
Det finnes en annen mulighet. For eksempel, det gjør Facebook. De kaller det Fabric Aggregator eller HGRID. Det innføres et ekstra spine-nivå for å koble sammen flere datasentre. En slik struktur er mulig hvis vi ikke har ekstra funksjoner eller endring av innkapsling på skjæringene. Hvis de eksisterer, er det ekstra touch points, og det blir komplisert. Som regel oppstår det flere funksjoner og en slags membran som skiller de forskjellige delene av datasenteret. Det er ikke lurt å lage en stor membran, men hvis det er absolutt nødvendig, er det fornuftig å vurdere muligheten for å flytte den, gjøre den så bred som mulig og overføre den til vertene. Mange skyoperatører gjør det slik. De har overlays som starter fra vertene.
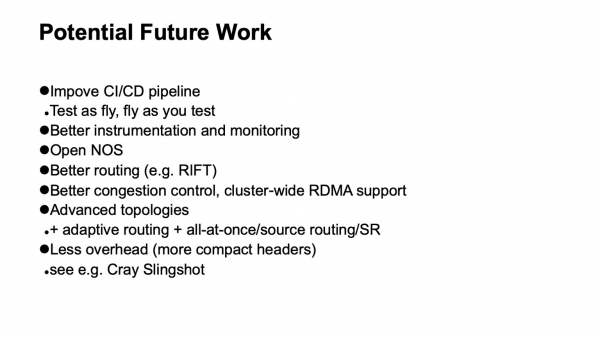
Hvilke utviklingsmuligheter ser vi? Først og fremst — forbedring av støtte for CI/CD-pipeline. Vi ønsker å fly slik vi tester, og teste slik vi flyr. Det går ikke særlig bra, fordi infrastrukturen er stor, og det er umulig å duplisere den for tester. Vi må finne ut hvordan vi kan innføre testelementer i den operative infrastrukturen uten å få den til å krasje.
Bedre verktøy og bedre overvåking er nesten alltid nyttig. Hele spørsmålet er balansen mellom innsats og utbytte. Hvis vi kan legge til med rimelige ressurser — er det veldig bra.
Åpne operativsystemer for nettverksenheter. De beste protokollene og de beste rutingsystemene, for eksempel RIFT. Forskning på anvendelse av de beste algoritmene for congestion control er også nødvendig, samt muligens innføring av støtte for RDMA i clusteret på noen punkter.
Hvis vi ser på et mer langsiktig perspektiv, er det behov for avanserte topologier og muligens nettverk som bruker mindre overhead. Fra nyere saker — det har vært publisert informasjon om fabrikkteknologi for HPC Cray Slingshot, som er basert på commodity Ethernet, men med muligheten for å bruke mye kortere overskrifter. Som et resultat reduseres overhead.
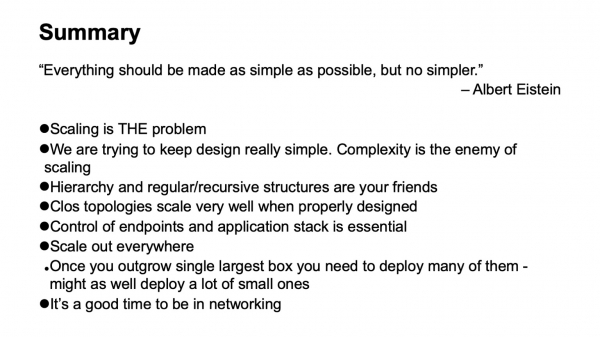
Alt bør gjøres så enkelt som mulig, men ikke enklere. Kompleksitet er fienden til skalerbarhet. Enkle og regelmessige strukturer er våre venner. Hvis du kan gjøre scale out et sted — gjør det. Og generelt er det spennende tider i nettverksteknologi. Det skjer mye interessant. Takk.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish