

I dag kreves høy tilgjengelighet av tjenester alltid og overalt, ikke bare i større, dyre prosjekter. Midlertidig utilgjengelige nettsteder med meldingen «Beklager, vedlikehold pågår» er fortsatt vanlige, men vanligvis gir de bare et nedsettende smil. Legg til dette livet i skyen, hvor det kun er ett API-kall som trengs for å starte en ekstra server, og man trenger ikke å tenke på den «fysiske» driften. Og det finnes ikke lenger noen unnskyldninger for hvorfor et kritisk system ikke ble laget pålitelig ved hjelp av klyngeteknologier og reserveløsninger.
Vi vil fortelle om hvilke løsninger vi vurderte for å sikre påliteligheten til databasene i tjenestene våre og hva vi kom frem til. Pluss en demo med langsiktige konklusjoner.
Legacy i arkitekturen for høy tilgjengelighet
Dette blir enda tydeligere når vi ser på utviklingen av forskjellige opensource-systemer. Gamle løsninger måtte legge til teknologier for høy tilgjengelighet ettersom etterspørselen økte. Kvaliteten på disse var forskjellig. Nye generasjonsløsninger har gjort høy tilgjengelighet til en grunnleggende del av arkitekturen. For eksempel posisjonerer MongoDB klyngen som det primære bruksområdet. Klyngen kan skaleres horisontalt, noe som er en sterk konkurransefordel for denne databasen.
La oss gå tilbake til PostgreSQL. Dette er et av de eldste og mest populære opensource-prosjektene, med den første utgivelsen som kom i 1995. Prosjektteamet ansett høy tilgjengelighet som en oppgave som ikke trengte å løses fra systemets side i lang tid. Derfor ble replikeringsteknologien for å lage datakopier først implementert i versjon 8.2 i 2006, men den var filbasert (log shipping). I 2010, med versjon 9.0, ble strømmereplikering introdusert, som er grunnlaget for å lage forskjellige klynger. Dette overrasker ofte mennesker som blir kjent med PostgreSQL etter Enterprise SQL eller moderne NoSQL — standardløsningen fra fellesskapet er bare et par master-replika med synkron eller asynkron replikering. I denne standardversjonen må bytte av master gjøres manuelt, og spørsmålet om klientbytte må også løses selv.
Hvordan vi bestemte oss for å lage en pålitelig PostgreSQL og hva vi valgte for dette
Like this, PostgreSQL wouldn't be as popular if it weren't for the vast number of projects and tools that help build a fault-tolerant solution that doesn't require constant attention. In the cloud. (MCS) since the launch of DBaaS, single PostgreSQL servers and pairs of master-replica with asynchronous replication have been available.
Naturally, we wanted to simplify life for everyone and make a PostgreSQL installation available that could serve as the foundation for highly available services, without the need to constantly monitor or wake up at night to switch over. In this segment, there are both tried-and-true solutions and a generation of new utilities utilizing the latest developments.
Today, the issue of high availability doesn't come down to redundancy (that's a given), but rather to consensus—the leader election algorithm. Most major failures occur not due to a lack of servers, but due to consensus issues: a new leader wasn't elected, or there were two leaders in different data centers, etc. An example is the MySQL cluster failure at Github—they wrote .
The mathematical foundation of this issue is very serious. On one hand, there is , which imposes theoretical limitations on the capabilities of building HA solutions, and on the other hand, mathematically proven consensus algorithms like og . Based on this, there are quite popular DCS (decentralized consensus systems) such as Zookeeper, etcd, Consul. Therefore, if a decision-making system operates on its own algorithm, which was developed independently, it should be approached with extreme caution. After analyzing a vast number of systems, we settled on Patroni—an open-source system primarily developed by Zalando.
Som et poetisk avbrekk vil jeg si at vi også vurderte multi-master-løsninger, det vil si klynger som kan skaleres horisontalt for skriving. Imidlertid, av to hovedgrunner, bestemte vi oss for ikke å lage en slik klynge. For det første har slike løsninger høy kompleksitet og dermed flere sårbare punkter. Det vil være vanskelig å lage en stabil løsning for alle tilfeller. For det andre, i et slikt tilfelle, slutter PostgreSQL å være ren (native), noen funksjoner vil ikke være tilgjengelige, og noen applikasjoner kan oppleve skjulte feil under drift.
Patroni
Så hvordan fungerer Patroni? Utviklerne valgte å ikke oppfinne hjulet på nytt og foreslo å bruke et av de etablerte DCS-løsningene som grunnlag. Alt som angår synkronisering av konfigurasjoner, valg av leder og kvorum overlates til den. Vi valgte etcd for dette formålet.
Deretter håndterer Patroni den riktige anvendelsen av alle innstillinger på PostgreSQL og konfigurasjonen av replikering, samt utførelsen av kommandoer for switchover og failover (det vil si - både planlagt og uplanlagt bytte av master). Spesielt i skyen MCS kan man lage en klynge bestående av en master, en synkron replik og én eller flere asynkrone replikker. Tilstedeværelsen av en synkron replik sikrer datalagring på minst 2 servere, og det er nettopp denne replikken som vil være den viktigste «kandidaten til master».
Siden etcd blir implementert på de samme serverne, anbefales det å ha 3 eller 5 servere for et optimalt kvorum. En slik klynge kan skaleres horisontalt for lesing (jeg har skrevet om skriving ovenfor). Likevel må det tas i betraktning at asynkrone replikker ofte henger etter, særlig under høy belastning.
Bruken av slike replikker for lesing (hot standby) er berettiget for rapporterings- eller analysetjenester og avlaster master-serveren.
Hvis du ønsker å lage en slik klynge selv, trenger du:
- å forberede 3 eller flere servere, konfigurere IP-adressering og brannmurregler mellom dem;
- å installere pakker for tjenestene etcd, Patroni, PostgreSQL;
- å konfigurere etcd-klyngen;
- å konfigurere patroni-tjenesten for å arbeide med PostgreSQL.
Det vil si at det totalt sett er nødvendig å lage riktig ti konfigurasjonsfiler og ikke gjøre feil noe sted. For dette er det absolutt nødvendig å bruke et konfigurasjonsverktøy, som Ansible, for eksempel. Samtidig er det fortsatt en mangel på en høyt tilgjengelig TCP-lastebalanserer. Å lage en er en separat oppgave.
For de som trenger en klarert klynge, men ikke ønsker å rote med alt dette, har vi forsøkt å forenkle livet og har laget en ferdig klynge på Patroni i vår sky, som kan prøves gratis. I tillegg til selve klyngen har vi laget:
- TCP-lastebalanserer; avhengig av forskjellige porter, peker den alltid på den nåværende masteren, en synkron eller asynkron replika, henholdsvis;
- API for å bytte aktiv master på Patroni.
De kan implementeres både via MCS-skyens API og gjennom web-konsollen.
Demo
For å teste mulighetene til PostgreSQL-klyngen i MCS-skyen, la oss se hvordan et live applikasjon vil oppføre seg ved problemer med databasen.
Følgende er koden til applikasjonen som vil loggføre kunstige hendelser og rapportere dette til skjermen. Ved feil vil den melde ifra om dette og fortsette å kjøre i en sløyfe til vi stopper den med Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Connection opened to", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Logged a value, overall count: {}".format(record[0]))
    except Exception as error:
        print ("Error while connecting to PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Connection closed")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Caught error:n", e)
                sleep(1)
    except KeyboardInterrupt:
        print("exit")
Applikasjonen trenger PostgreSQL for å fungere. La oss lage en klynge i MCS-skyen ved hjelp av API. I et vanlig terminalvindu, hvor OS_TOKEN-variabelen inneholder tokenet for å få tilgang til API (kan oppnås med kommandoen openstack token issue), skriver vi inn kommandoene:
Vi lager en klynge:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
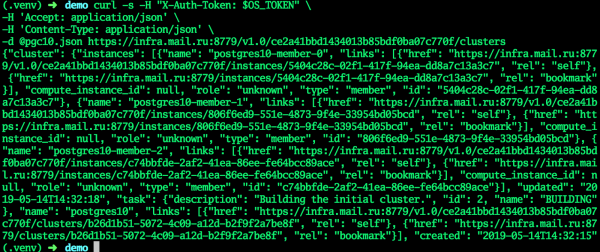
Når klyngen går inn i STATUS ACTIVE, vil alle feltene få oppdaterte verdier — klyngen er klar.
I GUI:
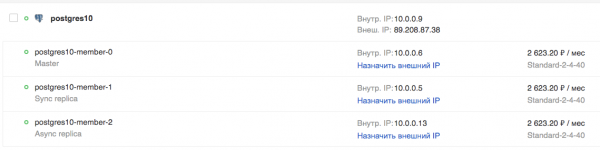
La oss prøve å koble til og opprette en tabell:
psql -h 89.208.87.38 -U admin -d myproddb
Passord for bruker admin:
psql (11.1, server 10.7)
Skriv "help" for hjelp.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 rader)

myproddb=>
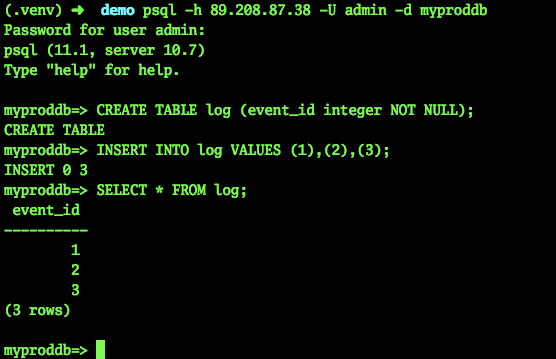
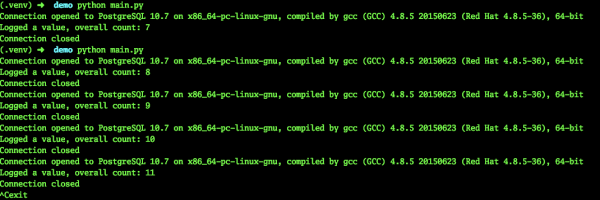
I applikasjonen angir vi de aktuelle innstillingene for å koble til PostgreSQL. Vi vil angi adressen til TCP-lasterfordeleren, slik at det ikke lenger er nødvendig å manuelt bytte til masteradressen. La oss starte den. Som vi ser, blir hendelser logget vellykket i databasen.
Planlagt bytte av master
Nå skal vi teste funksjonaliteten til applikasjonen vår under et planlagt bytte av master:
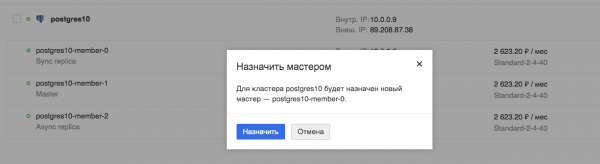
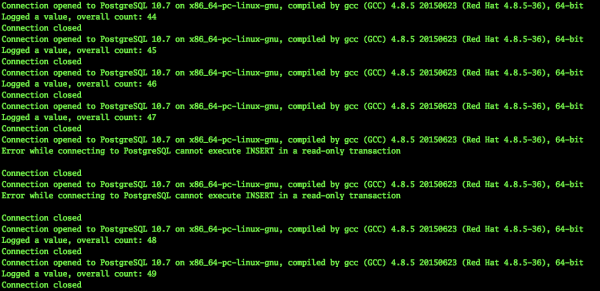
Vi overvåker applikasjonen. Vi ser at applikasjonen faktisk stopper opp, men det tar bare noen sekunder, i dette spesifikke tilfellet, maks 9.
Maskinens nedstengning
Nå skal vi prøve å simulere nedstengningen av den virtuelle maskinen som fungerer som nåværende master. Man kunne klart å slå av den virtuelle maskinen via Horizon-grensesnittet, men dette ville vært en normal nedstenging. Et slikt bytte vil bli behandlet av alle tjenester, inkludert Patroni.
Vi trenger derimot en uforutsigbar nedstenging. Derfor ba jeg våre administratorer om å slå av den virtuelle maskinen — nåværende master — på en unormal måte for testformål.
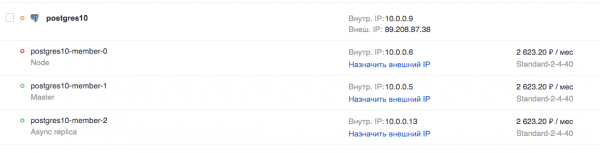
I mellomtiden fortsatte applikasjonen vår å kjøre. Selvsagt kan ikke en så akutt ombytting av master gå ubemerket hen.
2019-03-29 10:45:56.071234
Tilkobling åpnet til PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilert av gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Logget en verdi, totalt antall: 453
Tilkobling lukket
2019-03-29 10:45:59.205463
Tilkobling åpnet til PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilert av gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Logget en verdi, totalt antall: 454

Tilkobling lukket
2019-03-29 10:46:02.661440
Feil ved tilkobling til PostgreSQL-server, lukket tilkoblingen uventet
        Dette betyr sannsynligvis at serveren ble avsluttet unormalt
        før eller under behandling av forespørselen.

Oppdaget feil:
 lokal variabel 'connection' referert før tildeling
……………………………………………………….. - her er et antall feil
2019-03-29 10:46:30.930445
Feil ved tilkobling til PostgreSQL-server, lukket tilkoblingen uventet
        Dette betyr sannsynligvis at serveren ble avsluttet unormalt
        før eller under behandling av forespørselen.

Oppdaget feil:
 lokal variabel 'connection' referert før tildeling
2019-03-29 10:46:31.954399
Tilkobling åpnet til PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilert av gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Logget en verdi, totalt antall: 455
Tilkobling lukket
2019-03-29 10:46:35.409800
Tilkobling åpnet til PostgreSQL 10.7 på x86_64-pc-linux-gnu, kompilert av gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Logget en verdi, totalt antall: 456
Tilkobling lukket
^Cexit
Som det fremgår, klarte applikasjonen å fortsette driften på mindre enn 30 sekunder. Ja, noen av brukerne vil merke problemene. Men dette er en alvorlig serverfeil, og slike hendelser skjer ikke så ofte. I tillegg ville det være lite sannsynlig at en person (administrator) ville ha reagert så raskt, med mindre han satt klar i konsollen med et bytte-skript.
Utdata
Etter min mening gir en slik klynge enorm fordel for administratorene. I praksis vil alvorlige feil og nedetid på DB-servere ikke være merkbare for applikasjonen og dermed ikke for brukeren. Det vil ikke være nødvendig å reparere noe i all hast og bytte til midlertidige konfigurasjoner, servere osv. Og hvis en slik løsning benyttes i form av en klar tjeneste i skyen, vil det ikke være nødvendig å bruke tid på å klargjøre det. Man kan fokusere på mer interessante oppgaver.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish