

Vi lanserte nye tjenester, trafikken vokste, vi byttet servere, koblet til nye plattformer og ombygde datasentre – nå skal vi fortelle denne historien, som vi introduserte for deg for fem år siden.
Fem år er en karakteristisk tid for å oppsummere interimsresultater. Derfor har vi bestemt oss for å fortelle om utviklingen av infrastrukturen vår, som i løpet av femårsperioden har gått en utrolig interessant utviklingsvei, som vi er stolte av. De kvantitative endringene vi har gjennomført har blitt til kvalitetsforbedringer, nå kan infrastrukturen fungere i moduser som på midten av forrige tiår så ut som science fiction.
Vi støtter driften av de mest komplekse prosjektene med strenge krav til pålitelighet og belastning, inkludert PREMIER og Match TV. I sportsutsendelsene og ved premieren av populære serier kreves det trafikksendinger i terabiter/s, noe vi enkelt kan realisere, faktisk så ofte at arbeid med slike hastigheter har blitt en del av vår hverdag. For fem år siden var det tyngste prosjektet som kjørte på våre systemer Rutube, som siden den gang har utviklet seg, økt volum og trafikk, noe som måtte tas hensyn til ved planlegging av belastninger.
Vi har fortalt om hvordan vi utviklet 'jernet' i infrastrukturen vår () og utviklet systemet ansvarlig for videolevering (), men siden den gang har det gått mye tid, og vi har implementert mange andre løsninger, hvis resultater gjør at vi kan møte moderne krav og være fleksible nok til å omstille oss for nye oppgaver.
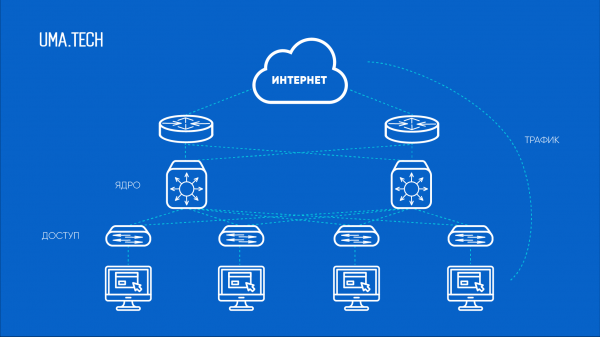
Kjerne nettverket blir kontinuerlig utviklet. Vi gikk over til Cisco-utstyr i 2015, noe vi nevnte i den forrige artikkelen. Da var det fortsatt de samme 10/40G, men av åpenbare grunner oppgraderte vi eksisterende chassis kort tid senere, og nå bruker vi aktivt både 25/100G.
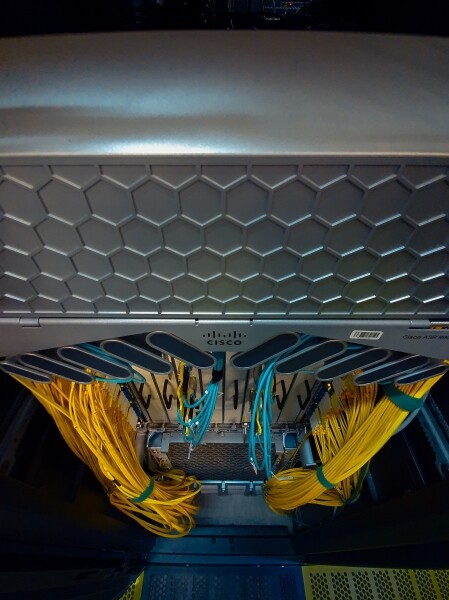
100G-lenker er ikke lenger en luksus (snarere er det en presserende nødvendighet i vårt segment) eller en sjeldenhet (flere og flere operatører tilbyr tilkoblinger med slike hastigheter). Men 10/40G er fortsatt relevant: gjennom disse lenkene fortsetter vi å koble operatører med lite trafikk, hvor det for øyeblikket ikke er økonomisk forsvarlig å bruke en mer kapabel port.
Det nettverkskjernen vi har utviklet, fortjener spesiell oppmerksomhet og vil bli temaet for en egen artikkel senere. Der vil vi gå dypere inn i de tekniske detaljene og se på logikken bak våre handlinger ved opprettelsen. Men nå fortsetter vi å skissere infrastrukturen mer oversiktlig, da deres oppmerksomhet, kjære lesere, ikke er ubegrenset.
Videoutstrømmingsservere evoluerer raskt, og vi legger ned betydelig innsats i dette. Tidligere brukte vi hovedsakelig 2U-servere med 4-5 nettverkskort, hvor hvert kort hadde to 10G-porter. Nå går det meste av trafikken fra 1U-servere, som har 2-3 kort med to 25G-porter hver. Kostnaden for 10G- og 25G-kortene har nesten jevnet seg ut, og de raskere løsningene tillater avspilling både på 10G og 25G. Resultatet har vært åpenbar besparelse: færre serverkomponenter og kabler for tilkobling – lavere kostnad (og høyere pålitelighet), komponentene tar mindre plass i racken – noe som har muliggjort plass til flere servere på en enhet av areal, og dermed er leiekostnadene senket.
Men viktigere er gevinsten i hastighet! Nå kan vi fra 1U levere mer enn 100G! Og dette i en situasjon hvor noen store russiske prosjekter anser 40G fra 2U for å være en «prestasjon». Vi skulle gjerne hatt deres problemer!
Vi må merke oss at generasjonen av nettverkskort som bare kan operere på 10G, fortsatt er i bruk. Dette utstyret fungerer stabilt og er godt kjent for oss, så vi kastet det ikke, men fant en ny anvendelse for det. Disse komponentene har vi installert i videolagringsservere, som åpenbart ikke er tilstrekkelige med en eller to 1G-grensesnitt; her viste 10G-kortene seg å være relevante.
Lagringssystemer de òg vokser. I løpet av de siste fem årene har de gått fra tolv-disk (12x HDD 2U) til seks-og-tredve-disk (36x HDD 4U). Slike massive "kropper" mange er redde for å bruke, da det ved feil på et slikt chassis kan oppstå trussel mot ytelsen – og kanskje til og med funksjonaliteten! – til hele systemet. Men vi vil ikke oppleve det: Vi har sørget for redundans på nivå med geo-replikerte data. Vi har fordelt chassisene på forskjellige datasentre – vi bruker totalt tre – og dette eliminerer risikoen for problemer både ved feil i chassisene og ved nedfall av plattformen.
Selvfølgelig har denne tilnærmingen gjort maskinvare-RAID overflødig, som vi har droppet. Ved å kvitte oss med redundansen har vi samtidig økt systemets pålitelighet, forenklet løsningen og fjernet et potensielt feilpunkt. La oss minne om at vårt lagringssystem er "hjemmelaget". Vi tok dette valget bevisst, og resultatet har vært helt tilfredsstillende.
Datasentre i løpet av de siste fem årene har vi byttet flere ganger. Siden publiseringen av den forrige artikkelen har vi bare ikke byttet ett datasenter – DataLine – de andre har måtte byttes etter hvert som infrastrukturen vår har utviklet seg. Alle flyttinger mellom plattformene har vært planlagte.
For to år siden migrerte vi innen MMTS-9, og gikk over til en plattform med kvalitetsrenovering, godt klimaanlegg, stabil strømforsyning og uten støv, som tidligere lå i tykke lag på alle overflater, og som også rikelig tettet til innmaten i utstyret vårt. Valget for kvalitets tjenester – og fravær av støv! – var grunnen til vår flytting.
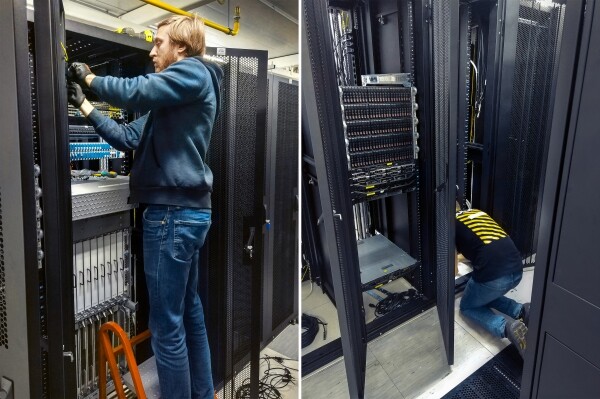
Nesten alltid er "én flytting lik to branner", men problemene ved migrering er hver gang forskjellige. Denne gangen ble hovedvanskeligheten med flyttingen innen ett datasenter "tilvejebragt" av optiske krysningspunkter – deres overflod mellom etasjene uten å bli samlet i en enhetlig kryssing fra telekommunikasjonsoperatørene. Prosessen med oppdatering og omlegging av krysningspunktene (hvor ingeniørene i MMTS-9 hjalp oss), var kanskje det mest komplekse stadiet i migreringen.
Den andre migrasjonen fant sted for ett år siden, i 2019, da vi flyttet fra et ikke så bra datasenter til O2xygen. Årsakene til flyttingen var lik de som ble drøftet tidligere, men vi fikk også et problem med hvor lite attraktivt det opprinnelige datasenteret var for teleoperatører – mange leverandører måtte vi «jakte» til dette punktet med egne ressurser.
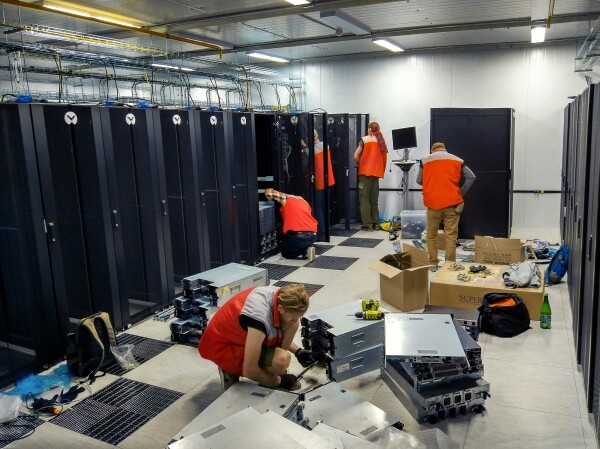
Migrasjonen av 13 stativer til en kvalitetsplassering i MMTS-9 har gjort det mulig å utvikle denne lokasjonen ikke bare som en operatørsentrisk (noen få stativer og «forbindelser» for operatørene), men også å benytte den som en av hovedlokasjonene. Dette har forenklet migrasjonen fra et ikke så bra datasenter – mesteparten av utstyret derfra flyttet vi til en annen plassering, og O2xygen fikk rollen som utviklende, og vi sendte dit 5 stativer med utstyr.
I dag er O2xygen allerede en fullverdig lokasjon, hvor de nødvendige operatørene har «kommet» og fortsetter å koble seg til nye. For operatørene har O2xygen også vist seg å være attraktivt med tanke på strategisk utvikling.
Den viktigste fasen av flyttingen gjennomfører vi alltid i løpet av en natt, og ved migrering innen MMTS-9 og til O2xygen holdt vi oss til denne regelen. Vi understreker atregelen om «flytting om natten» etterfølges strengt uavhengig av antallet stativer! Det har til og med vært et tilfelle hvor vi flyttet 20 stativer og gjennomførte dette også på én natt. Migrasjon er en relativt enkel prosess som krever nøyaktighet og rekkefølge, men det finnes også noen knep både i forberedelsesprosessen, under flyttingen, og når man implementerer på den nye lokasjonen. Vi er klare til å fortelle mer detaljert om migrasjon hvis du skulle være interessert.
Resultater Vi liker femårsplaner. Vi har fullført byggingen av en ny feilfri infrastruktur, fordelt på tre datasentre. Vi har kraftig økt tettheten av båndbredde – hvis vi nylig var glade for 40-80G med 2U, så er det nå normalt for oss å gi 100G med 1U. Nå oppfattes en terabit båndbredde som hverdagskost for oss. Vi er klar til å videreutvikle vår infrastruktur, som har vist seg å være fleksibel og skalerbar.
Spørsmål: Hva skal vi fortelle deg om i de kommende tekstene, kjære lesere? Om hvorfor vi begynte å lage egne datasystemer? Om nettverkskjernen og dens egenskaper? Om triks og detaljer rundt migrering mellom datasentre? Om optimalisering av løsninger for utlevering ved hjelp av komponentutvalg og finjustering av parametere? Om å skape robuste løsninger takket være redundans og horisontale skaleringsmuligheter innen datasenteret, som er implementert i strukturen av tre datasentre?
Forfatter: Pjotr Vinogradov — Teknisk direktør i Uma.Tech
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish