

Hei, hubbers. I dag starter undervisningen i den første gruppen av kurset . I forbindelse med dette ønsker vi å fortelle dere om hvordan det åpne webinaret om dette kurset gikk.
I snakket vi om hvilke utfordringer SQL-databaser har møtt i skyens og Kubernetes' æra. Samtidig så vi på hvordan SQL-databaser tilpasser seg og utvikler seg under innflytelse av disse utfordringene.
Webinaret ble holdt av , Google Cloud Practice Delivery Manager hos EPAM Systems.
Da trærne var små…
For å begynne, la oss huske hvordan valget av DBMS startet på slutten av forrige århundre. Det bør ikke være så vanskelig, for valget av DBMS i de tider begynte og sluttet med Oracle.
På slutten av 90-tallet og begynnelsen av 2000-tallet var det i realiteten ikke mye valg når det gjelder industrielle skalerbare databaser. Ja, det fantes IBM DB2, Sybase og noen andre databaser som dukket opp og forsvant, men stort sett var de ikke så synlige i forhold til Oracle. Følgelig var ingeniørenes ferdigheter på den tiden mer eller mindre knyttet til det eneste valget som fantes.
En Oracle DBA måtte kunne:
- installere Oracle Server fra distribusjon;
- konfigurere Oracle Server:
- init.ora;
- listener.ora;
— opprette:
- tabellerom;
- skjemaer;
- brukere;
— utføre sikkerhetskopiering og gjenoppretting;
— overvåke;
— bekjempe suboptimale forespørsel.
Samtidig ble det ikke spesielt krevd av Oracle DBA å:
- kunne velge den optimale DBMS eller annen teknologi for lagring og behandling av data;
- sikre høy tilgjengelighet og horisontal skalerbarhet (dette var ikke alltid et spørsmål for DBA);
- ha god kunnskap om fagfeltet, infrastrukturen, applikasjonsarkitekturen, OS;
- utføre dataopplasting og -utlasting, migrasjon av data mellom forskjellige DBMS.
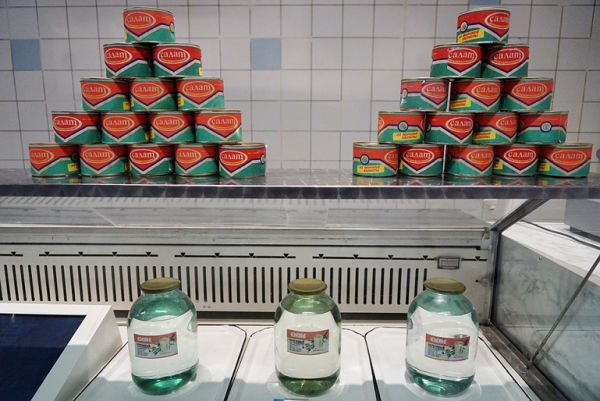
Generelt, når man snakker om valgmulighetene på den tiden, minner det om valget i en sovjetisk butikk på slutten av 80-tallet:
Vår tid
Siden den gang har trærne naturligvis vokst, verden har endret seg, og det har blitt slik:
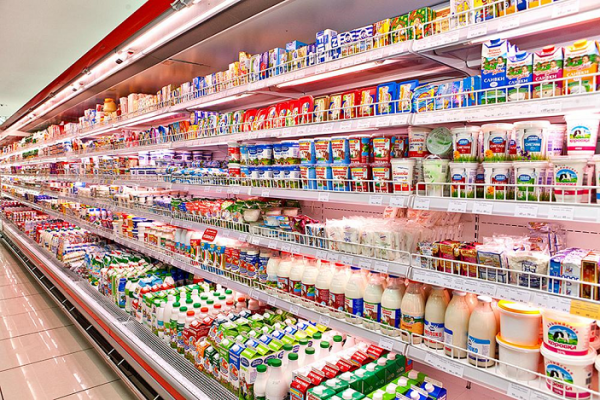
Markedet for DBMS har også endret seg, noe som er tydelig i den nyeste rapporten fra Gartner:
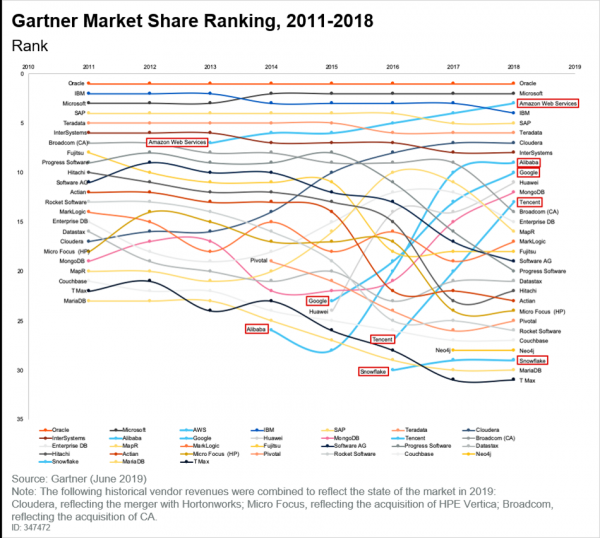
Og her må det nevnes at skyene har tatt sin plass, hvis popularitet vokser. Hvis man leser den samme rapporten fra Gartner, vil vi se følgende konklusjoner:
- Mange kunder er på vei til å flytte applikasjoner til skyen.
- Nye teknologier dukker først opp i skyen, og det er ikke sikkert at de noen gang vil flytte til en ikke-skybasert infrastruktur.
- Modellen for prising basert på pay-as-you-go har blitt vanlig. Alle ønsker å betale kun for det de bruker, og dette er ikke lenger en trend, men en konstatering av faktum.
Hva skjer nå?
I dag er vi alle i skyen. De spørsmålene vi har, handler om valg. Og valgene er enorme, selv om vi bare snakker om valget av DB-teknologier i on-premises-format. I tillegg har vi managed services og SaaS. Dermed blir valget mer og mer komplisert hvert år.
I tillegg til valgsituasjonen, finnes det begrensende faktorer:
- pris. Mange teknologier koster fortsatt penger;
- ferdigheter. Når vi snakker om gratis programvare, oppstår det et spørsmål om ferdigheter, fordi gratis programvare krever at folk som ruller ut og drifter det, har tilstrekkelig kompetanse;
- funksjonalitet. Ikke alle tjenester som er tilgjengelige i skyen og bygget, for eksempel på basis av Postgres, har de samme funksjonene som Postgres on-premises. Dette er en vesentlig faktor som må forstås. I tillegg får denne faktoren mer betydning enn kunnskap om spesifikke skjulte muligheter i en enkelt DBMS.
Hva man forventer av DA/DE nå:
- gode kunnskaper om fagfeltet og anvendt arkitektur;
- evnen til å velge riktig DB-teknologi med tanke på oppgaven som stilles;
- evnen til å velge optimal implementeringsmetode for den valgte teknologien i lys av eksisterende begrensninger;
- evnen til å utføre overføringer og migrering av data;
- evnen til å implementere og drifte de valgte løsningene.
Eksemplet nedenfor basert på GCP demonstrerer hvordan valget av en bestemt teknologi for databehandling fungerer avhengig av datamengde:
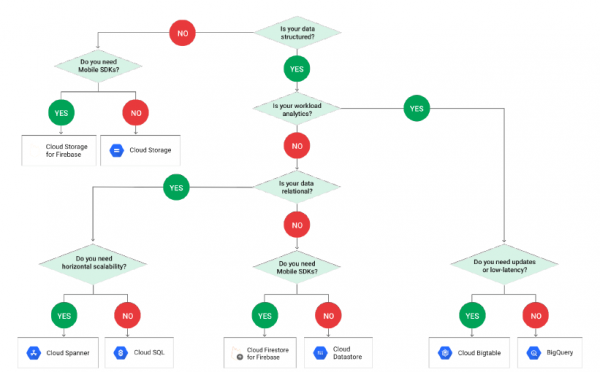
Vær oppmerksom på at PostgreSQL ikke er med i diagrammet, og det er fordi det skjuler seg under betegnelsen Cloud SQL. Og når vi går inn i Cloud SQL, må vi igjen ta et valg:
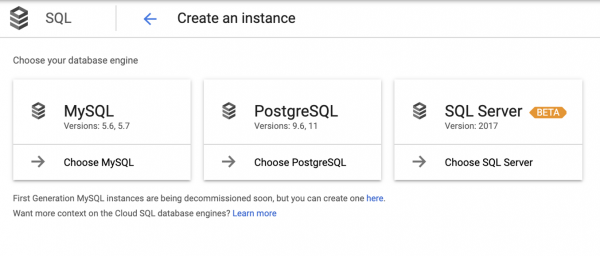
Det er verdt å merke seg at dette valget ikke alltid er klart, så applikasjonsutviklere ofte ledes av instinktet.
Totalt:
- Jo lenger framover vi ser, desto mer aktuelt blir spørsmålet om valg. Og selv når vi kun ser på GCP, managed services og SaaS, dukker det opp en omtale av RDBMS først i fjerde trinn (hvor Spanner er nært). I tillegg kommer valget av PostgreSQL først i femte trinn, mens MySQL og SQL Server også er til stede, så det er mye å velge fra, men man må ta et valg.
- Vi må ikke glemme begrensningene som kommer med fristelsene. Hovedsakelig ønsker alle Spanner, men det er dyrt. Så en typisk forespørsel ser omtrent slik ut: «Kan dere lage Spanner til oss, men til prisen for Cloud SQL, dere er jo profesjonelle!»
Hva skal man gjøre?
Uten å påstå å ha den endelige sannheten, la oss si følgende:
Vi må endre tilnærmingen til utdanning:
- å lære slik man gjorde før for DBA-er, gir ingen mening;
- kunnskap om ett enkelt produkt er nå allerede utilstrekkelig;
- og å ha kjennskap til titalls produkter på ett nivå er umulig.
Man må forstå ikke bare produktet, men også:
- bruksområdene for det;
- de ulike distribusjonsmetodene;
- fordelene og ulempene ved hver metode;
- beslektede og alternative produkter for å ta bevisste og optimale valg, ikke alltid til fordel for det kjente produktet.
Og man må også kunne migrere data og forstå grunnleggende prinsipper for integrasjon med ETL.
En reell situasjon
I det siste måtte jeg utvikle backend for en mobilapp. Da arbeidet med denne startet, var backend allerede utviklet og klar for implementering, og utviklerteamet hadde brukt omtrent to år på dette prosjektet. Følgende oppgaver ble satt:
- bygge CI/CD;
- gjøre arkitekturreview;
- sette alt dette i drift.
Selve applikasjonen var mikrotjenestebasert, og koden i Python/Django ble utviklet fra bunnen av direkte i GCP. Når det gjelder målgruppen, var det planlagt to regioner — USA og EU, og trafikken ble fordelt gjennom Global Load Balancer. Alle arbeidsbelastninger og beregningsbelastning kjørte i Google Kubernetes Engine.
Når det gjelder dataene, var det tre strukturer:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
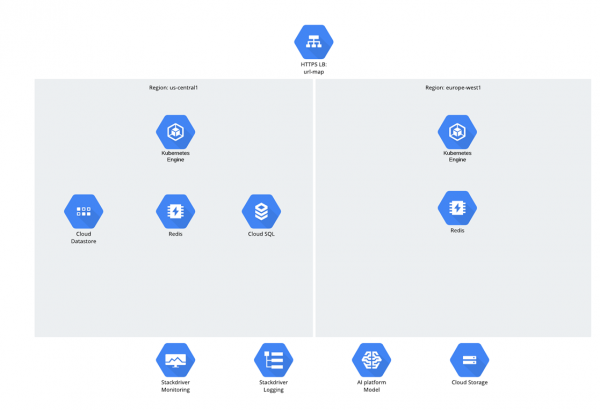
Det kan oppstå spørsmål om hvorfor Cloud SQL ble valgt? For å være ærlig, har slike spørsmål de siste årene skapt en viss pinlig pause — det virker som folk begynner å bli flaue over relasjonsdatabaser, men de fortsetter likevel å bruke dem aktivt ;-).
Når det gjelder vår situasjon, ble Cloud SQL valgt av følgende grunner:
- Som det ble nevnt, ble applikasjonen utviklet med Django, og den har en modell for å vise permanente data fra SQL-databasen som Python-objekter (Django ORM).
- Rammeverket støttet en begrenset liste over databasesystemer:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Dermed ble PostgreSQL valgt fra denne listen mer eller mindre intuitivt (men ikke Oracle, altså).
Hva som manglet:
- applikasjonen var bare distribuert i 2 regioner, og det var planer om en 3. (Asia);
- Databasen befant seg i den nordamerikanske regionen (Iowa);
- det var bekymringer fra kunden angående mulige forsinkelser med tilgang fra Europa og Asia, og avbrudd i tjenesten i tilfelle av en databasefeil.
Selv om Django kan håndtere flere databaser parallelt og skille dem ved lesing og skriving, var det ikke så mange skrivinger i applikasjonen (over 90 % er lesing). Generelt sett, hvis man kunne lage en read-replika av hoveddatabasen i Europa og Asia, ville det vært en kompromissløsning. Hva er så vanskelig med det?
Utfordringen var at kunden ikke ønsket å gi opp bruken av managed services og Cloud SQL. Mulighetene med Cloud SQL er for tiden begrensede. Cloud SQL støtter høy tilgjengelighet (HA) og lesereplika (RR), men den samme RR støttes bare i én region. Ved å opprette en database i den amerikanske regionen, er det ikke mulig å lage en read-replika i den europeiske regionen ved hjelp av Cloud SQL, selv om PostgreSQL selv ikke hindrer dette. Korrespondanse med Google-ansatte førte ikke til noe og endte med løfter som «Vi er klar over problemet og jobber med det, spørsmålet vil bli løst en gang».
Hvis vi oppsummerer mulighetene med Cloud SQL punktvis, vil det se omtrent slik ut:
1. Høy tilgjengelighet (HA):
- innen ett enkelt område;
- gjennom diskreplikering;
- bruker ikke PostgreSQL-mekanismer;
- mulig automatisk og manuell styring — failover/failback;
- ved omkobling er databasen utilgjengelig i flere minutter.
2. Lesereplika (RR):
- innen ett enkelt område;
- hot standby;
- PostgreSQL streaming replikering.
I tillegg, som vanlig, når man velger teknologi, støter man alltid på noe begrensninger;:
- kunden ønsket ikke å skape flere enheter og bruke IaaS, annet enn via GKE;
- kunden ønsket ikke å sette opp self service PostgreSQL/MySQL;
- Selv om Google Spanner ville vært et godt alternativ, hvis ikke for prisen, kan Django ORM ikke arbeide med det, men ellers er det en flott ting.
Gitt situasjonen, kom det et spørsmål fra kunden: «Kan dere lage noe lignende, så det er som Google Spanner, men fungerer også med Django ORM?»
Løsningsalternativ nr. 0
Det første som kom til tankene:
- holde seg innenfor CloudSQL;
- det vil ikke være noen form for innebygd replikering mellom regioner;
- prøve å koble til en kopi av eksisterende Cloud SQL by PostgreSQL;
- kjøre en PostgreSQL-instans et sted, men i det minste ikke røre ved masteren.
Dessverre viste det seg at det ikke var mulig, da det ikke er tilgang til verten (den er i et annet prosjekt) — pg_hba og så videre, og det er ikke tilgang med superbruker.
Løsningsalternativ nr. 1
Etter noen flere refleksjoner og med tanke på de tidligere forholdene, endret tankegangen seg litt:
- vi prøver fortsatt å holde oss innenfor CloudSQL, men bytter til MySQL, da Cloud SQL by MySQL har en ekstern master som:
— fungerer som en proxy for ekstern MySQL;
— ser ut som en MySQL-instans;
— er laget for migrering av data fra andre skyer eller on-premises.
Siden innstillingen for MySQL-replikering ikke krever tilgang til verten, fungerte alt i prinsippet, men det var veldig ustabilt og upraktisk. Og når vi gikk videre, ble det skummelt, fordi vi rullet ut hele strukturen med terraform, og plutselig viste det seg at ekstern master ikke støttes av terraform. Ja, Google har CLI, men det ble av en eller annen grunn også ustabilt - noen ganger ble det opprettet, noen ganger ikke. Kanskje fordi CLI ble utviklet for datamigrering fra utsiden, ikke for replikaer.
Egentlig ble det klart at Cloud SQL ikke passet i det hele tatt. Som de sier, gjorde vi alt vi kunne.
Løsningsalternativ nr. 2
Siden det ikke var mulig å holde seg innenfor Cloud SQL, prøvde vi å formulere kravene til en kompromissløsning. Kravene ble som følger:
- arbeid i Kubernetes, maksimal utnyttelse av ressurser og muligheter i Kubernetes (DCS, ...) og GCP (LB, ...);
- ingen ballast fra masse unødvendige ting i skyen som HA proxy;
- mulighet for å kjøre HA PostgreSQL eller MySQL i hovedregionen; i andre regioner — HA fra hovedregionens RR pluss en kopi av den (for pålitelighet);
- multi master (det var ikke så ønskelig å koble seg til, men det var ikke veldig prinsipielt)
.
Som et resultat av disse kravene, dukket det endelig opp en løsning i horisonten.passende database- og bindingsalternativer:
- MySQL Galera;
- CockroachDB;
- PostgreSQL-verktøy
:
— pgpool-II;
— Patroni.
MySQL Galera
MySQL Galera-teknologien er utviklet av Codership og er et plugin for InnoDB. Egenskaper:
- multi master;
- synchron replikasjon;
- lese fra hvilken som helst node;
- skrive til hvilken som helst node;
- innebygd HA-mekanisme;
- det er en Helm-chart fra Bitnami.
CockroachDB
Beskrivelsen gir inntrykk av noe helt fantastisk og er et open source-prosjekt skrevet i Go. Hovedaktøren er Cockroach Labs (grunnlagt av tidligere Google-ansatte). Denne relasjonsdatabasen er opprinnelig laget for å være distribuert (med horisontal skalerbarhet «ut av boksen») og feilbestandig. Forfatterne fra selskapet har satt seg som mål å «kombinere rikheten av SQLs funksjonalitet med horisontal tilgjengelighet som er vanlig i NoSQL-løsninger».
Som en hyggelig bonus — støtte for PostgreSQL-tilkoblingsprotokollen.
Pgpool
Dette er et tillegg over PostgreSQL, egentlig en ny enhet som håndterer alle forbindelser. Den har sin egen lastbalanserer og parser, og lisensieres under BSD-lisensen. Den gir omfattende muligheter, men kan virke litt skremmende, da det å ha en ny enhet kan føre til noen ekstra utfordringer.
Patroni
Dette var det siste jeg så på, og som viste seg å være verdt det. Patroni er et open source-verktøy som i hovedsak fungerer som en daemon i Python, som automatisk håndterer PostgreSQL-klynger med ulike typer replikasjon og automatisk rollebytte. Det viste seg å være veldig interessant, da det integreres godt med Kubernetes og ikke bringer til legging av nye enheter.
Hva som ble valgt til slutt
Valget var ikke enkelt:
- CockroachDB — brennende, men skummelt;
- MySQL Galera — også ganske bra, mye brukt, men MySQL;
- Pgpool — mange unødvendige enheter, så som så integrasjon med skyen og K8s;
- Patroni — utmerket integrasjon med K8s, ingen unødvendige enheter, god integrasjon med GCP LB.
Dermed falt valget på Patroni.
Konklusjoner
Det er på tide å oppsummere kort. Ja, verden av IT-infrastruktur har endret seg betydelig, og dette er bare begynnelsen. Hvis skyene tidligere bare var en annen type infrastruktur, er det nå annerledes. Dessuten dukker det stadig opp innovasjoner i skyene, og de vil fortsatt dukke opp, og kanskje bare i skyene, før de eventuelt blir overført til On-premises av oppstartsbedrifter.
Når det gjelder SQL, vil SQL eksistere. Det betyr at man må kunne PostgreSQL og MySQL, men det viktigste er å vite hvordan man bruker dem riktig.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish