

Det kommer oftere forespørseler fra kunder som sier: «Vi vil ha noe som Amazon RDS, men billigere»; «Vi vil ha noe som RDS, men overalt, i hvilken som helst infrastruktur». For å implementere en slik managed-løsning på Kubernetes, har vi vurdert den nåværende tilstanden til de mest populære operatørene for PostgreSQL (Stolon, operatørene fra Crunchy Data og Zalando) og gjort vårt valg.
Denne artikkelen er vår oppsummerte erfaring, både fra en teoretisk side (oversikt over løsninger) og fra en praktisk side (hva som ble valgt og hva vi har oppnådd). Men la oss først definere hvilke krav som stilles til en potensiell erstatning for RDS …
Hva er egentlig RDS
Når folk snakker om RDS, antar vi, mener de en administrert (managed) databaseservice som:
- er lett å sette opp;
- har muligheten til å jobbe med snapshots og gjenopprette fra dem (helst med støtte for );
- lar deg opprette master-slave-topologier;
- har et rikt utvalg av utvidelser;
- tilbyr revisjon og bruker-/tilgangsstyring.
Generelt sett kan tilnærmingene til å oppnå dette målet være ganske forskjellige, men metoden med en hypotetisk Ansible er ikke vår favoritt. (Kollegene fra 2GIS kom til en lignende konklusjon etter på å lage et «verktøy for rask distribusjon av et feilfri klynge basert på Postgres».)
Det er nettopp operatører – en vanlig tilnærming for å løse slike oppgaver i Kubernetes-økosystemet. Mer om dem, spesifikt for databaser som kjører innenfor Kubernetes, ble allerede beskrevet av teknisk direktør for «Flanta», , i .
NB: For raskt å lage enkle operatører anbefaler vi å ta en titt på vårt open source-verktøy . Ved å bruke det kan man gjøre dette uten kunnskap om Go, men med mer kjente metoder for systemadministratorer: i Bash, Python osv.
For PostgreSQL finnes det flere populære K8s-operatører:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
La oss se nærmere på dem.
Valget av operatør
I tillegg til de viktige funksjonene som allerede er nevnt, forventet vi – som infrastrukturingeniører innen Kubernetes – også følgende fra operatørene:
- deploy fra Git og med ;
- støtte for pod anti-affinity;
- installasjon av node affinity eller node selector;
- installasjon av tolerations;
- muligheter for tuning;
- forståelige teknologier og til og med kommandoer.
Utan att gå in på detaljer om varje punkt (fråga i kommentarerna om det finns några frågor kvar efter att ha läst hela artikeln), vill jag påpeka att dessa parametrar behövs för att ge en mer nyanserad beskrivning av noderna i klustret så att vi kan beställa dem för specifika applikationer. På så sätt kan vi uppnå en optimal balans mellan prestanda och kostnad.
Nu — till själva PostgreSQL-operatörerna.
1. Stolon
från det italienska företaget Sorint.lab i betraktades som en typ av referens bland operatörerna för DBMS. Detta är ett ganska gammalt projekt: dess första offentliga release ägde rum redan i november 2015(!), och GitHub-repositoriet kan stoltsera med nästan 3000 stjärnor och 40+ bidragsgivare.
Och verkligen, Stolon är ett utmärkt exempel på genomtänkt arkitektur:
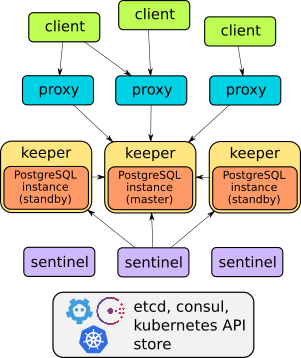
Med denna operatör kan man gå djupare i rapporten eller . Sammanfattningsvis kan man säga att den kan göra allt som beskrivs: failover, proxy för transparent åtkomst för kunder, backup… Dessutom tillhandahåller proxy åtkomst via en enda tjänstpunkt — till skillnad från de två andra lösningarna som beskrivs nedan (de har två tjänster för åtkomst till databasen).
Men Stolon , vilket gör att den inte kan distribueras så enkelt och snabbt — "som varma bakverk" — för att skapa DBMS-instanser i Kubernetes. Hantering görs via verktyget stolonctl, distribution via Helm-diagrammet, och användardefinitioner anges i ConfigMap.
Å ena sidan verkar det som om operatören inte riktigt är en operatör (eftersom den inte använder CRD). Men å andra sidan är detta ett flexibelt system som gör att man kan konfigurera resurser i K8s som man vill.
Sammanfattningsvis, personligen verkade det för oss inte optimalt att ha ett separat diagram för varje databas. Därför började vi söka alternativ.
2. Crunchy Data PostgreSQL Operator
, en ung amerikansk startup, verkade vara ett logiskt alternativ. Dess offentliga historia börjar med den första releasen i mars 2017, och sedan dess har GitHub-repositoriet fått lite mindre än 1300 stjärnor och 50+ bidragsgivare. Den senaste releasen från september har testats för arbete med Kubernetes 1.15—1.18, OpenShift 3.11+ och 4.4+, GKE och VMware Enterprise PKS 1.3+.
Arkitekturen av Crunchy Data PostgreSQL Operator uppfyller också de angivna kraven:
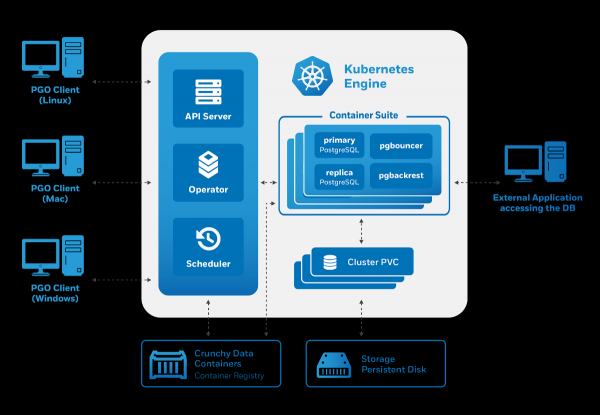
Administrasjon skjer via et verktøy pgo, men det genererer i sin tur Custom Resources for Kubernetes. Så operatøren gledet oss som potensielle brukere:
- det finnes administrasjon via CRD;
- brukervennlig administrasjon (også via CRD);
- integrasjon med andre komponenter — en spesialisert samling av containerbilder for PostgreSQL og verktøy for å jobbe med det (inkludert pgBackRest, pgAudit, utvidelser fra contrib osv.).
Men forsøk på å begynne å bruke operatøren fra Crunchy Data avdekket flere problemer:
- Det var ikke mulig å bruke tolerations — bare nodeSelector var tilgjengelig.
- De opprettede podene var en del av Deployment, til tross for at vi distribuerte en stateful-applikasjon. I motsetning til StatefulSet kan ikke Deployment opprette disker.
Den siste ulempen førte til morsomme situasjoner: på testmiljøet klarte vi å starte 3 replikater med én disk local storage, noe som resulterte i at operatøren rapporterte at 3 replikater kjørte (selv om det ikke var tilfelle).
En annen funksjon ved denne operatøren er dens ferdige integrasjon med ulike støttesystemer. For eksempel er det enkelt å installere pgAdmin og pgBounce, og i vurderes forhåndsinnstilte Grafana og Prometheus. I den nylige blir det spesielt nevnt at integrasjonen med prosjektet , noe som gjør at operatøren tilbyr visuell fremstilling av PgSQL-metrikker "out of the box".
Likevel førte det merkelige valget av genererte Kubernetes-ressurser til at vi måtte finne en annen løsning.
3. Zalando Postgres Operator
Zalando-produkter er godt kjent for oss: vi har erfaring med Zalenium og selvfølgelig har vi prøvd — deres populære HA-løsning for PostgreSQL. Om selskapets tilnærming til å lage fortalte en av forfatterne, Alexey Klyukin, i sendingen , og vi likte det.
Dette er den nyeste løsningen blant de som vurderes i artikkelen: den første utgivelsen fant sted i august 2018. Men til tross for det relativt lille antallet offisielle utgivelser, har prosjektet gjort store fremskritt og allerede overgått løsningen fra Crunchy Data med 1300+ stjerner på GitHub og det høyeste antallet bidragsytere (70+).
«Under panseret» bruker denne operatøren løsninger som er tidstestet:
- Patroni og for administrasjon,
- — for sikkerhetskopiering,
- — som en tilkoblingspool.
Slik er operatorarkitekturen fra Zalando presentert:
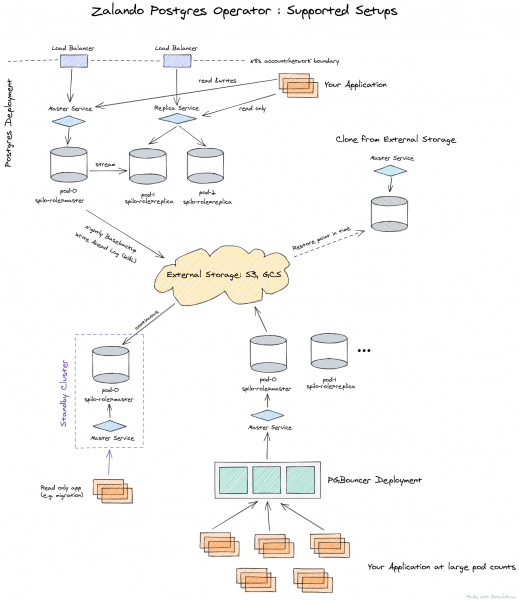
Operatoren administreres helt via Custom Resources, og oppretter automatisk en StatefulSet fra containere, som deretter kan tilpasses ved å legge til ulike sidecar-er i pod-en. Dette er et betydelig pluss sammenlignet med operatøren fra Crunchy Data.
Siden det var løsningen fra Zalando vi valgte blant tre vurderte alternativer, vil videre beskrivelse av dens funksjoner bli presentert nedenfor, sammen med praksisen for anvendelse.
Praksis med Postgres Operator fra Zalando
Deployeringen av operatøren skjer veldig enkelt: det er nok å laste ned den aktuelle utgaven fra GitHub og anvende YAML-filene fra direktorien . Som et alternativ kan man også bruke .
Etter installasjonen bør man ta seg tid til å konfigurere . Dette gjøres via ConfigMap postgres-operator i navnerommet hvor du installerte operatøren. Når lagringsplassene er konfigurert, kan du deployere den første PostgreSQL-klusteret.
For eksempel ser vår standarddeployering slik ut:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Denne manifestet deployerer et kluster med tre eksemplarer med sidecar i form av , som vi henter applikasjonsmetrikker fra. Som du ser, er det veldig enkelt, og om ønskelig kan man bruke bokstavelig talt et ubegrenset antall kluster.
Det er også verdt å merke seg webpanelet for administrasjon — . Det leveres sammen med operatøren og lar deg opprette og slette kluster, samt arbeide med sikkerhetskopier som operatøren lager.
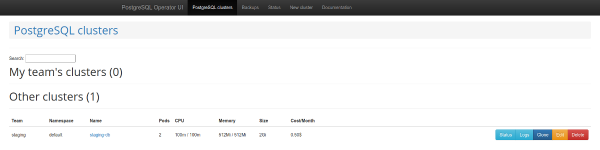
Liste over PostgreSQL-kluster
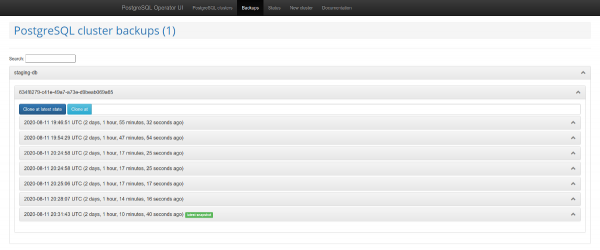
Administrering av sikkerhetskopier
En annen interessant funksjon er støtten for . Denne mekanismen oppretter automatisk roller i PostgreSQL, basert på den mottatte listen av brukernavn. Deretter lar API-et deg returnere listen over brukere, for hvilke roller blir opprettet automatisk.
Problemer og løsninger
Imidlertid avdekket bruken av operatøren snart flere betydelige ulemper:
- mangel på støtte for nodeSelector;
- umulighet å deaktivere sikkerhetskopier;
- når man bruker funksjonen for å opprette databaser, får man ikke standardrettigheter;
- det mangler periodisk dokumentasjon, eller den er utdaterte.
Heldigvis kan mange av dem løses. La oss begynne med slutten – problemer med dokumentasjon.
Det er sannsynlig at du vil oppleve at det ikke alltid er klart hvordan man spesifiserer sikkerhetskopiering og hvordan man kobler bakoverbøtte til Operator UI. Dette er nevnt kort i dokumentasjonen, mens en virkelig beskrivelse finnes i :
- du må lage et hemmelig;
- overføre det til operatøren som parameter
pod_environment_secret_namei CRD med innstillingene til operatøren eller i ConfigMap (avhengig av hvordan du har valgt å installere operatøren).
Imidlertid, som det viste seg, er dette for øyeblikket umulig. Det er derfor vi samlet med noen ekstra tredjepartsarbeider. Mer om den — se nedenfor.
Hvis du overfører parametere til operatøren for sikkerhetskopiering, nemlig — wal_s3_bucket og tilgangsnøkler i AWS S3, vil den sikkerhetskopiere alt: ikke bare databaser i produksjon, men også staging. Dette var ikke akseptabelt for oss.
I beskrivelsen av parametrene til Spilo, som er den grunnleggende Docker-innpakningen for PgSQL når man bruker operatøren, viste det seg: man kan overføre parameteren WAL_S3_BUCKET som tom, og dermed deaktivere sikkerhetskopier. Dessuten, til stor glede, ble det funnet en , som vi straks aksepterte i vårt fork. Nå er det nok å legge til enableWALArchiving: false i ressursen til PostgreSQL-klyngen.
Ja, det var mulig å gjøre det annerledes, ved å kjøre 2 operatører: en for staging (uten sikkerhetskopier), og den andre — for produksjon. Men slik klarte vi oss med én.
Ok, vi lærte å gi databasene tilgang til S3, og sikkerhetskopiene begynte å komme inn i lagringen. Hvordan får man sidene for sikkerhetskopier til å fungere i Operator UI?
I Operator UI må du legge til 3 variabler:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Etter dette blir håndteringen av sikkerhetskopier tilgjengelig, noe som i vårt tilfelle forenkler arbeidet med staging, ved å tillate levering av utsnitt fra produksjon uten ekstra skript.
Som en annen fordel ble det nevnt at arbeidet med Teams API og de brede mulighetene for opprettelse av databaser og roller ved hjelp av operatøren. Imidlertid hadde de opprettede rollene ikke standardrettigheter.Dermed kunne en bruger med læserettigheder ikke læse de nye tabeller.
Hvorfor er det sådan? Selvom det i koden er nødvendigt, GRANT, de anvendes langt fra altid. Der er 2 metoder: syncPreparedDatabases og syncDatabases. I syncPreparedDatabases — selvom der i sektionen preparedDatabases er en betingelse defaultRoles og defaultUsers til oprettelse af roller, anvendes standardrettighederne ikke automatisk. Vi er i gang med at forberede en patch, så disse rettigheder anvendes automatisk.
Og det sidste punkt i de forbedringer, der er relevante for os — , der tilføjer Node Affinity til den oprettede StatefulSet. Vore kunder foretrækker ofte at reducere omkostningerne ved at bruge spot-instanser, og på dem bør man ikke placere databaser. Dette problem kunne også løses gennem tolerations, men tilstedeværelsen af Node Affinity giver større sikkerhed.
Hvad kom der ud af det?
Som resultat af løsningen på de nævnte problemer har vi forgrenet Postgres Operator fra Zalando til , hvor det samles med så nyttige patches. For mere bekvemmelighed har vi også samlet .
En liste over PR'er, der er accepteret i forgreningen:
- ;
- ;
- ;
- .
Det ville være fantastisk, hvis fællesskabet støttede disse PR'er, så de kom ind i upstream med den næste version af operatoren (1.6).
Bonus! Succeshistorie om migrering af produktion
Hvis du bruger Patroni, kan man migrere aktiv produktion til operatøren med minimal nedetid.
Spilo gør det muligt at lave standby-klynger via S3-lagring med , hvor den binære log PgSQL først gemmes i S3 og derefter hentes af replikationen. Men hvad skal man gøre, hvis du ikke bruger Wal-E i en gammel infrastruktur? Løsningen på dette problem er allerede på Habr.
Logisk replikation af PostgreSQL kommer til hjælp. Men lad os ikke dykke ned i detaljer om, hvordan man opretter publikationer og abonnementer, fordi... vores plan mislykkedes.
Problemet er, at der var flere belastede tabeller i databasen med millioner af rækker, som desuden konstant blev tilføjet og slettet. med copy_data, hvor en ny replik kopierer alt indhold fra master, kunne simpelthen ikke følge med masteren. Indholdsoverførslen fungerede i en uge, men nåede aldrig masteren. Som følge heraf hjalp kollegerne fra Avito: man kan overføre data ved at bruge pg_dump. Jeg vil beskrive vores (lidt forbedrede) version af denne algoritme.
Ideen er at man kan oprette en deaktiveret abonnement knyttet til en bestemt replikationsslot og derefter korrigere transaktionsnummeret. Der var replikaer til rådighed for production. Dette er vigtigt, da replikaen vil hjælpe med at skabe en konsistent dump og fortsætte med at modtage ændringer fra masteren.
I de efterfølgende kommandoer, der beskriver migreringsprocessen, vil følgende betegnelser blive brugt for værtterne:
- master — kilde server;
- replica1 — stream-replika på den gamle production;
- replica2 — ny logisk replika.
Migreringsplan
1. Opretter et abonnement på alle tabeller i skemaet offentlig database dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Opretter en replikationsslot på masteren:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Stopper replikationen på den gamle replika:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Henter transaktionsnummeret fra masteren:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Tag dump fra den gamle replika. Vi vil gøre dette i flere tråde, hvilket hjælper med at fremskynde processen:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Laster dumpen op på den nye server:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Efter indlæsning af dump kan replikationen startes på stream-replikaen:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Opretter abonnement på den nye logiske replika:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Henter oid af abonnementet:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Antag, at der blev modtaget oid=1000. Anvender transaktionsnummeret på abonnementet:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Starter replikationen:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Kontrollerer status for abonnementet, replikationen bør fungere:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Når replikationen er startet og databaserne er synkroniseret, kan der foretages et skift.
13. Efter at have deaktiveret replikationen skal sekvenserne korrigeres. Dette er godt beskrevet .
Takket være denne plan blev skiftet gennemført med minimale forsinkelser.
Konklusjon
Kubernetes-operatørar gjer det enklare å utføre ulike oppgåver ved å redusere dei til å opprette K8s-ressursar. Men etter å ha oppnådd bemerkelsesverdig automatisering med dei, bør ein hugse at dette kan bringe med seg ein del uventa utfordringar, så det er viktig å velje operatørar med omhu.
Etter å ha vurdert dei tre mest populære Kubernetes-operatørane for PostgreSQL, valde vi prosjektet frå Zalando. Og vi måtte overvinne visse vanskar, men resultatet var verkeleg tilfredsstillande, så vi planlegg å utvide denne erfaringa til fleire andre PgSQL-installasjonar. Hvis du har erfaring med tilsvarande løysingar, vil vi gjerne sjå detaljar i kommentarane!
P.S.
Also read in our blog:
- «»;
- «»;
- «».
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish