

Overvåkning har blitt en svært viktig komponent i de voksende skytjenestene ettersom kompleksiteten i distribuerte systemer øker. Den er nødvendig for å forstå atferden deres. Skalerbare verktøy er nødvendige, som kan samle inn data fra alle tjenester — og gi spesialister et enkelt grensesnitt med ytelseanalyse, visning av feil, tilgjengelighet og logger.
Disse verktøyene må også være effektive og ytelsessterke. I denne artikkelen vil vi se på to populære teknologistakker: EFK (Elasticsearch) og PLG (Loki) og vi vil diskutere deres arkitekturer og forskjeller.
EFK-stakken
Kanskje har du allerede hørt om den populære ELK eller EFK. Stakken består av flere separate deler: Elasticsearch (objektdatabase), Logstash eller FluentD (innsamling og aggregering av logger) og Kibana for visualisering.
En typisk arbeidsflyt ser slik ut:
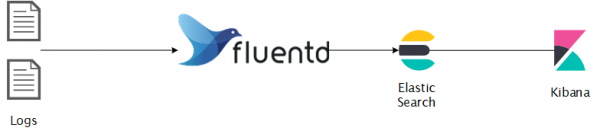
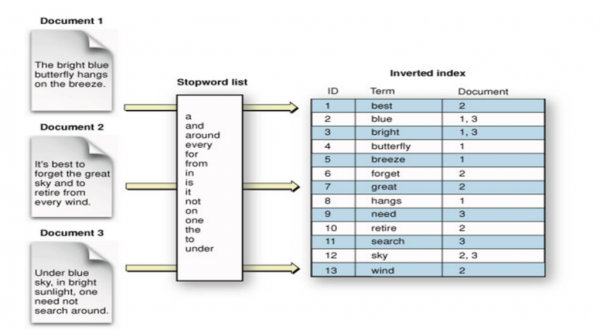
Elasticsearch — et distribuert objektdatabaser med sanntids søk og analyse. Et fremragende valg for delvis strukturerte data, som logger. Informasjonen lagres som JSON-dokumenter, indekseres i sanntid og distribueres på nodene i klyngen. Det brukes en invertert indeks, som inneholder alle unike ord og relaterte dokumenter for fulltekst-søk, som igjen er basert på søkemotoren Apache Lucene.
FluentD — er en datainnsamler som utfører datastandardisering ved innsamling og forbruk. Den prøver å organisere dataene i JSON så godt som mulig. Arkitekturen er utvidbar, det finnes mer enn , støttet av fellesskapet, for alle muligheter.
Kibana — et datavisualiseringsverktøy for Elasticsearch med ulike tilleggsfunksjoner, som tidsserieanalyse, grafer, maskinlæring og mer.
Elasticsearch-arkitektur
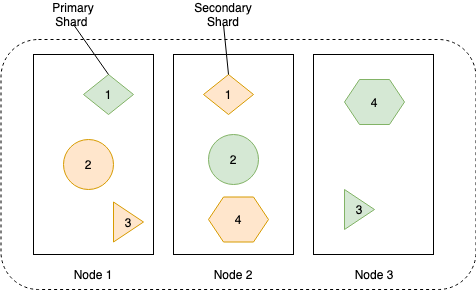
Dataene i Elasticsearch-klyngen lagres fordelt over alle nodene. Klyngen består av flere noder for å forbedre tilgjengelighet og robusthet. Enhver node kan utføre alle klyngens roller, men i større skalerbare distribusjoner tildeles noder vanligvis separate oppgaver.
Typer av klynge-noder:
- master node — administrerer klyngen, minst tre er nødvendig, én må alltid være aktiv;
- data node — lagrer indekserte data og utfører ulike oppgaver med dem;
- ingest node — organiserer rørledninger for datatransformasjon før indeksering;
- coordinating node — ruting av forespørselene, forkorting av søkerbehandlingsfasen, koordinering av massiv indeksering;
- alerting node — igangsetting av varslingoppgaver;
- machine learning node — behandling av maskinlæringsoppgaver.
Diagrammet nedenfor viser hvordan data lagres og replikeres mellom noder for å oppnå høyere datatilgjengelighet.
Dataene for hver replika lagres i den inverterte indeksen, diagrammet nedenfor viser hvordan dette skjer:
Installasjon
Du kan se detaljene , jeg skal bruke helm chart:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG-stakken
Ikke bli overrasket hvis du ikke finner dette akronymet, da det er bedre kjent som Grafana Loki. Uansett blir denne stakken mer populær da den bruker gjennomtenkte tekniske løsninger. Du har kanskje allerede hørt om Grafana, det populære visualiseringsverktøyet. Dets skapere, inspirert av Prometheus, utviklet Loki, et horisontalt skalerbart høyytelsessystem for loggaggregasjon. Loki indekserer kun metadata, men ikke selve loggene; denne tekniske løsningen har gjort det enkelt å bruke og økonomisk fordelaktig.
Promtail — en agent for å sende logger fra operativsystemet til Loki-klyngen. Grafana — visualiseringsverktøy basert på data fra Loki.
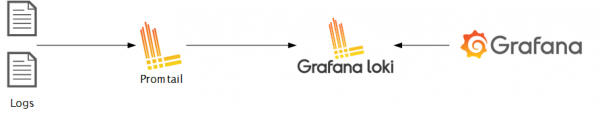
Loki er basert på de samme prinsippene som Prometheus, så det er godt egnet for lagring og analyse av Kubernetes-logger.
Arkitekturen av Loki
Loki kan kjøres både som en enkelt prosess og som flere prosesser, noe som muliggjør horisontal skalering.
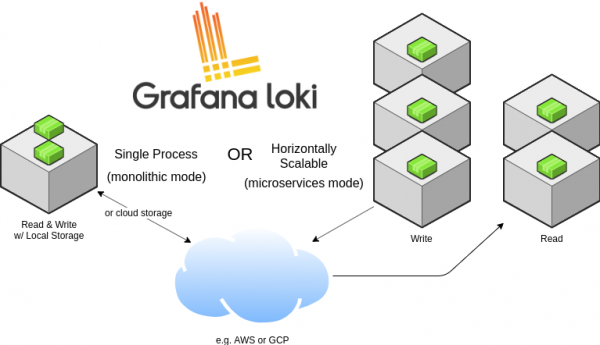
Det kan også fungere både som en monolittisk applikasjon og som en mikrotjeneste. Å kjøre det som en enkelt prosess kan være nyttig for lokal utvikling eller lite overvåking. For industriell implementering og skalerbar belastning anbefales det å bruke mikrotjenestemodellen. Skrive- og leseveiene for data er adskilt, slik at det kan tilpasses og skaleres etter behov.
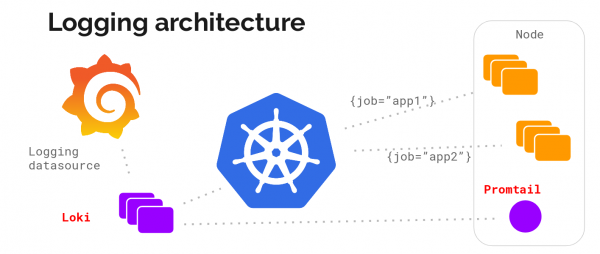
La oss ta en titt på arkitekturen til systemet for loggsamling uten detaljer:
Og her er beskrivelsen (mikrotjenestearkitektur):
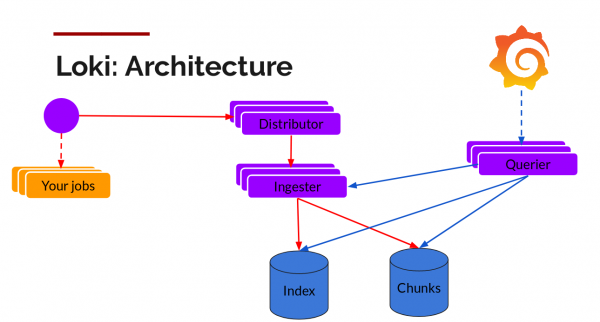
Komponenter:
Promtail — en agent som installeres på noder (i form av et sett med tjenester), tar logger fra oppgaver og henter metadata fra Kubernetes API for å merke loggene. Deretter sender den loggen til hovedtjenesten Loki. For merking av metadata benyttes de samme reglene som i Prometheus.
Distributor — en distribusjonstjeneste som fungerer som en buffer. Den pakker innkommende data for å håndtere millioner av poster, og komprimerer dem i blokker etter hvert som de kommer inn. Flere datamottakere opererer samtidig, men loggene som tilhører en strøm av innkommende data må bare finnes i én av dem for alle dens blokker. Dette organiseres som en ring av mottakere og sekvensiell hashing. For feiltoleranse og redundans gjøres dette n ganger (3, med mindre det konfigureres).
Ingester — en datamottaker. Data blokkene kommer komprimert med tillegg av logger. Når en blokk er stor nok, blir blokkene stukket inn i databasen. Metadata går inn i indeksen, mens dataene fra blokk med loggene går inn i Chunks (dette er vanligvis objektlagring). Etter innsendingen oppretter mottakeren en ny blokk hvor nye poster skal legges til.
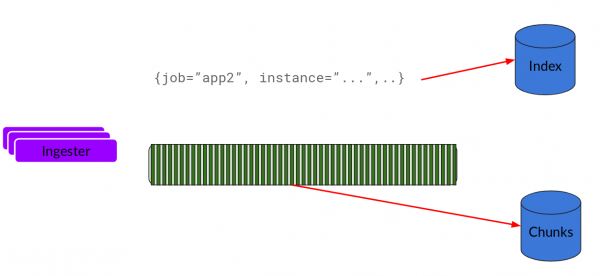
Index — en database, DynamoDB, Cassandra, Google BigTable og lignende.
Chunks — komprimerte loggblokker, som vanligvis lagres i objektlagring, for eksempel S3.
Querier — leseveien som gjør alt det tunge arbeidet. Den ser på tidsintervallet og etiketter, og søker deretter i indeksen etter treff. Den leser deretter datablokker og filtrerer dem for å få resultatet.
La oss nå se alt i aksjon.
Installasjon
For å installere i Kubernetes er det enklest å bruke helm. Vi antar at du allerede har installert og konfigurert det ( translator's note)
Legg til depotet og installer stakken.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
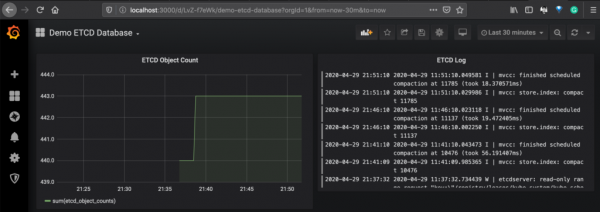
Nedenfor er et eksempel på et dashbord som viser data fra Prometheus for metrikker Etcd og Loki for logger fra Etcd-podene.
La oss nå diskutere arkitekturen til begge systemene, samt sammenligne deres funksjoner med hverandre.
Sammenligning
Spørringsspråk
I Elasticsearch bruker Query DSL og Lucene query language, som gir mulighet for fulltekstsøk. Dette er en veletablert, kraftig søkemotor med bred støtte for operatorer. Med den kan man søke i konteksten og sortere etter relevans.
På den andre siden av ringen — LogQL, brukt i Loki, arvtakeren til PromQL (Prometheus query language). Den bruker logg-etiketter for å filtrere og velge logger. Det er mulig å bruke noen operatorer og aritmetikk, som beskrevet , men når det gjelder muligheter, er den bak Elastic language.
Siden forespørslene i Loki er knyttet til etiketter — er de enkle å korrelere med metrikker, noe som gjør det lettere å organisere operativ overvåking.
Skalerbarhet
Begge stakkene er horisontalt skalerbare, men med Loki er det enklere, ettersom den har adskilte lese- og skriveveier for data, og har også en mikroservicarkitektur. Loki kan tilpasses dine behov og kan brukes til svært store mengder loggdata.
Multi-tenancy
Multi-tenancy i klyngen er et felles tema for å redusere OPEX, og begge stakkene tilbyr multi-tenancy. For Elasticsearch er det flere å separere kunder på: en egen indeks for hver kunde, klientbasert ruting, unike kunde-felt, søkefiltre. I Loki er det i form av HTTP-headeren X-Scope-OrgID.
Kostnad
Loki er økonomisk effektivt fordi det ikke indekserer data, bare metadata. Dermed oppnås og minne (cache), siden objektlagring er billigere enn blokklagring, som brukes i Elasticsearch-klynger.
Konklusjon
EFK-stakken kan brukes til ulike formål, og den gir maksimal fleksibilitet og et flerfunksjonelt Kibana-grensesnitt for analyse, visualisering og forespørsel. Den kan i tillegg forbedres med maskinlæringsegenskaper.
Loki-stakken er nyttig i Kubernetes-økosystemet på grunn av metadatasøkefunksjonen. Man kan enkelt matche data for overvåking basert på tidsserier i Grafana og logger.
Når det gjelder kostnader og langtidlagring av logger, er Loki et utmerket valg for å gå over til sky-løsninger.
Det finnes flere alternativer på markedet — noen kan være bedre for deg. For eksempel har GKE integrasjonen med Stackdriver, som gir en utmerket løsning for overvåking. Vi har ikke inkludert dem i vår analyse i denne artikkelen.
Lenker:
Artikkelen er oversatt og utarbeidet for Habr av ansatte i — intensivkurs, videokurs og bedriftsopplæring fra erfarne fagfolk (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish