

Innledning
For some time now, I have been tasked with developing a fault-tolerant cluster for , operating across several data centers interconnected by fiber optics within a single city, and capable of withstanding the failure (for instance, power outage) of one data center. As the software responsible for fault tolerance, I chose , because it is the official solution from RedHat for creating fault-tolerant clusters. Its advantages include that RedHat provides support for it and that it is a universal (modular) solution. With it, we will be able to ensure fault tolerance not only for PostgreSQL but also for other services, either by using standard modules or by creating them for specific needs.
A reasonable question arose regarding this solution: how fault-tolerant will the fault-tolerant cluster be? To investigate this, I developed a test bench that simulates various failures on the nodes of the cluster, waits for recovery, restores the failed node, and continues testing in a cycle. Initially, this project was named hapgsql, but over time I grew weary of a name with only one vowel. Therefore, I began to name the fault-tolerant databases (and the float IPs pointing to them) krogan (a character from a video game, whose vital organs are all duplicated), while the nodes, clusters, and the project itself are named tuchanka (the planet where krogan live).
The management has now allowed . The README will soon be translated into English (because it is expected that the primary users will be developers of Pacemaker and PostgreSQL), and I decided to format the old Russian version of the README (partially) as this article.
Clusters are deployed on virtual machines . A total of 12 virtual machines (36GiB in total) will be deployed, forming 4 fault-tolerant clusters (different options). The first two clusters consist of two PostgreSQL servers located in different data centers and a shared witness med quorum device (hosted on an inexpensive virtual machine in the third data center), which resolves uncertainty 50%/50%, casting its vote for one of the sides. The third cluster involves three data centers: one master, two slaves, without quorum device. Den fjerde klyngen består av fire PostgreSQL-servere, to per datasenter: én master, de andre replikater, og bruker også witness med quorum device. Den fjerde kan håndtere svikt av to servere eller ett datasenter. Dette alternativet kan, om nødvendig, skaleres opp med flere replikater.
Tjeneste for presis tid er også omkonfigurert for feiltoleranse, men bruker metoden til ntpd (orphan mode). Den generelle serveren witness fungerer som en sentral NTP-server, som distribuerer sitt tid til alle klynger, og dermed synkroniserer alle servere med hverandre. Hvis witness blir ute av drift eller isolert, vil en av serverne i klyngen begynne å dele sin tid (innen klyngen). Den hjelpsomme cachende HTTP-proxy er også løftet på witness, ved hjelp av dette får de andre virtuelle maskinene tilgang til Yum-repositorier. I virkeligheten vil slike tjenester som presis tid og proxy sannsynligvis bli plassert på dedikerte servere, mens i oppsettet er de plassert på witness bare for å spare antall virtuelle maskiner og plass.
Versjoner
v0. Kjøres med CentOS 7 og PostgreSQL 11 på VirtualBox 6.1.
Struktur av klynger
Alle klynger er designet for å være plassert i flere datasentre, koblet sammen i ett flatt nettverk og skal tåle svikt eller nettverksisolering av ett datasenter. Derfor is not possible bruke for beskyttelse mot split-brain standardteknologien Pacemaker, som kalles STONITH (Shoot The Other Node In The Head) eller fencing. Essensen er: hvis noder i klyngen begynner å mistenke at det skjer noe galt med en av nodene, at den ikke svarer eller oppfører seg unormalt, så frakobler de den tvangsmessig via «eksterne» enheter, som for eksempel en kontrollert IPMI-kort eller UPS. Men dette vil fungere bare i tilfeller der ved en enkelt svikt av serveren, IPMI eller UPS fortsetter å fungere. Her planlegges beskyttelse mot en mye mer katastrofal svikt, når hele datasenteret svikter (for eksempel ved strømbrudd). Ved en slik svikt vil alle stonith-enheter (IPMI, UPS og så videre) også slutte å fungere.
I stedet ligger ideen om kvorum til grunn for systemet. Alle noder har en stemme, og bare de som ser mer enn halvparten av alle noder kan fungere. Dette antallet «halvparten +1» kalles kvorummet. Hvis kvorum ikke oppnås, avgjør noden at den befinner seg i nettverksisolasjon og må koble fra sine ressurser, det vil si at det er en slags beskyttelse mot split-brain. Hvis programvaren som svarer for slik atferd, ikke fungerer, må watchdog, for eksempel basert på IPMI, aktiveres.
Hvis antallet noder er jevnt (klyngen i to datasentre), kan det oppstå det som kalles usikkerhet 50%/50% (fifty-fifty), når nettverksisolasjonen deler klyngen nøyaktig på midten. Derfor blir det lagt til quorum device — en uvanlig demon som kan kjøres på den billigste virtuelle maskinen i det tredje datasenteret. Den gir stemmen sin til en av segmentene (som den oppfatter) og løser dermed usikkerheten på 50%/50%. Serveren der quorum-enheten skal kjøres, kalte jeg witness (terminologi fra repmgr, jeg likte den).
Ressurser kan flyttes fra sted til sted, for eksempel fra defekte servere til fungerende, eller på kommando fra systemadministratorer. For at kundene skal vite hvor de aktuelle ressursene er (hvor skal de koble seg til?), brukes flytende IP (float IP). Dette er IP-er som Pacemaker kan flytte mellom nodene (alt er i et flatt nettverk). Hver av dem symboliserer en ressurs (tjeneste) og vil være der man må koble seg til for å få tilgang til denne tjenesten (i vårt tilfelle databasen).
Tuchanka1 (plattform med tetning)
Struktur
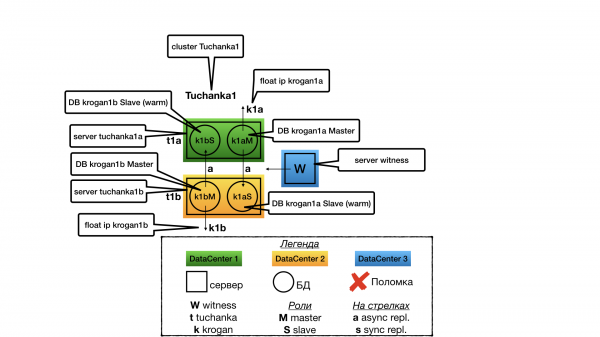
Ideen var at vi har mange små databaser med lav belastning, for hvilke det ikke er økonomisk å opprettholde en dedikert slave-server i hot standby for read-only transaksjoner (det er unødvendig ressursbruk).
I hvert datasenter er det én server. Hver server har to PostgreSQL-instanser (i PostgreSQL-terminologi kalles de klynger, men for å unngå forvirring vil jeg kalle dem instanser (på lignende måte som andre databaser), og klynger vil jeg kun bruke om Pacemaker-klynger). Én instans fungerer i master-modus, og det er bare den som tilbyr tjenester (det er bare til den det lenkes float IP). Den andre instansen fungerer som slave for det andre datasenteret, og vil kun tilby tjenester hvis dens master svikter. Siden det meste av tiden kun én instans av de to (master) tilbyr tjenester (utfører forespørselene), optimaliseres alle serverressurser mot master (minne tildeles til cache shared_buffers osv.), men sørger for at den andre instansen også har tilstrekkelige ressurser (selv om det er for suboptimal drift via filsystemcache) i tilfelle et av datasentrene svikter. Slaven tilbyr ingen tjenester (utfører ikke lese-forespørselene) under normal drift av klyngen, for å unngå ressurskonflikter med master på samme maskin.
I tilfelle med to noder er feiltoleranse kun mulig med asynkron replikering, ettersom ved synkron replikering vil feil i slaven føre til at master stopper.
Feil i witness
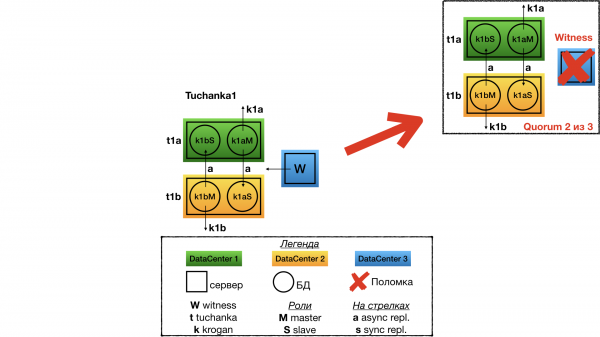
Feil i witness (quorum device) vil jeg kun vurdere for klyngen Tuchanka1, det vil være den samme historien for alle andre. Ved feil i witness vil ingenting endres i klyngeoppsettelsen, alt vil fortsette å fungere som før. Men kvorum vil bli lik 2 av 3, og derfor vil enhver annen neste feil være fatal for klyngen. Det må uansett fikses straks.
Feil i Tuchanka1
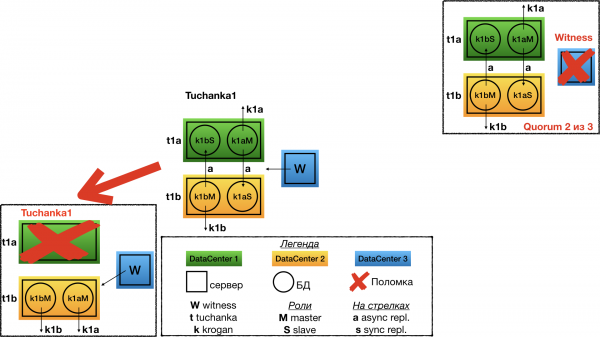
Feil i ett av datasentrene for Tuchanka1. I dette tilfellet witness gir stemmen sin til den andre noden i det andre datasenteret. Der blir den tidligere slaven til master, slik at begge mestere kjører på én server og begge deres float IP-er peker til dem.
Tuchanka2 (klassisk)
Struktur
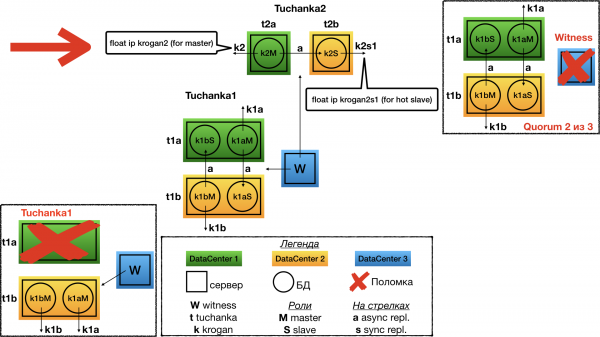
Klassisk oppsett med to noder. Én kjører som master, den andre som slave. Begge kan utføre forespørseler (slaven kun lese), så begge har float IP: krogan2 — for master, krogan2s1 — for slaven. Feiltoleranse vil være for både master og slave.
I tilfelle med to noder er feiltoleranse kun mulig med asynkron replikering, fordi ved synkron replikering vil feil i slaven føre til at master stopper.
Feil i Tuchanka2
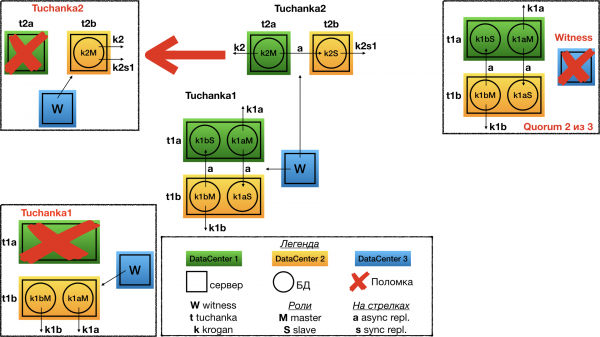
Ved feil i ett av datasentrene witness stemmer for den andre. Den eneste fungerende datasenteret vil heve mesteren, og begge float IP-er vil peke mot den: mesteren og slave. Selvfølgelig må instansen være konfigurert slik at den har nok ressurser (grenser for tilkobling osv.) til å samtidig motta alle tilkoblinger og forespørselene fra master- og slave float IP. Det vil si at den må ha en tilstrekkelig margin på grensene under normal drift.
Tuchanka4 (mange slaver)
Struktur
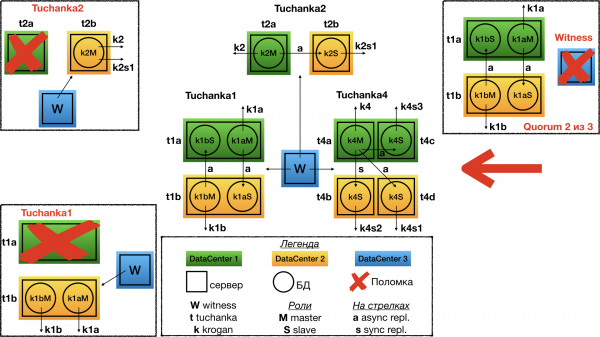
Det er allerede en annen ekstremitet. Det finnes databaser som mottar mange forespørselene for lesing (et typisk tilfelle med høytrafikk-nettsteder). Tuchanka4 er en situasjon hvor det kan være tre eller flere slaver for å håndtere slike forespørselene, men ikke for mange. Med veldig mange slaver må det oppfinnes et hierarkisk system for replikering. I minimumstilfellet (i bildet) er det to servere i hvert datasenter, og på hver av dem er det en instans av PostgreSQL.
En annen funksjon ved dette systemet er at det allerede er mulig å organisere en synkron replikering. Den er konfigurert for å replikere, om mulig, til et annet datasenter, og ikke til en replika i samme datasenter som mesteren. Både på mesteren og på hver slave peker float IP. Ideelt sett må det gjøres lastbalansering av forespørselet mellom slavene ved hjelp av noe sql proxy, for eksempel, på klientsiden. Ulike typer kunder kan kreve forskjellig typ sql proxy, og bare utviklerne av klientene vet hvem som trenger hva. Denne funksjonaliteten kan implementeres både som en ekstern demon og som en klientbibliotek (tilkoblingspool), osv. Alt dette går utover temaet for feiltolerante databaser (feiltoleranse SQL proxy kan implementeres uavhengig av klientens feiltoleranse).
Feil Tuchanka4
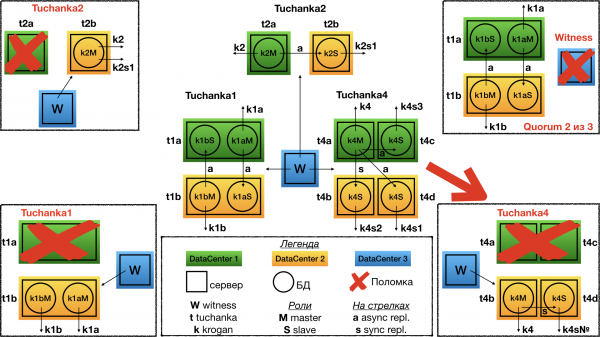
Ved feil med ett datasenter (dvs. to servere) stemmer vitnet for den andre. Resultatet er at to servere fungerer i det andre datasenteret: på den ene kjører mesteren, og den peker mot master float IP (for å motta lesing-skriving forespørselene); og på den andre serveren kjører en slave med synkron replikering, og den peker mot en av slave float IP (for read only-forespørselen).
Det første som må nevnes: ikke alle slave float IP-er vil være aktive, kun én. Og for at den skal fungere korrekt, må det være kommandoer som sikrer det. sql proxy vider alle forespørselene til den eneste gjenværende float IP; hvis ikke sql proxy , kan du liste opp alle float IP-ene til slavene med komma i URL-en for tilkobling. I så fall vil libpq tilkoblingen være til den første fungerende IP-en, slik det er gjort i automatisk testingssystem. Det kan hende at det ikke vil fungere på andre biblioteker, for eksempel JDBC, og det vil være nødvendig sql proxy. Det er gjort fordi float IP-ene til slavene har restriksjonen om at de ikke kan aktiveres samtidig på én server, slik at de blir jevnt fordelt over slave-serverne hvis det er flere som jobber.
For det andre: selv i tilfelle av datasenterfeil vil synkron replikering bli bevart. Og selv om det skjer en sekundær feil, det vil si at en av de to serverne i det gjenværende datasenteret svikter, vil klyngen, selv om den slutter å tilby tjenester, fortsatt beholde informasjon om alle bekreftede transaksjoner som den har gitt bekreftelse på for kommittering (det vil ikke være noen tap av informasjon ved sekundærfeil).
Tuchanka3 (3 datasentre)
Struktur
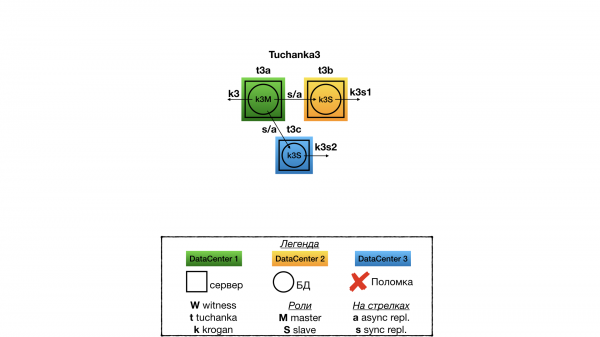
Dette er en klynge for situasjonen der det finnes tre fullt fungerende datasentre, hvor hver av dem har en fullt fungerende databaseserver. I dette tilfellet quorum device er ikke nødvendig. I ett datasenter fungerer master, mens i de to andre er det slaver. Replikeringen er synkron, av typen ANY (slave1, slave2), noe som innebærer at klienten vil motta bekreftelse på kommittering når noen av slavene først svarer at de har mottatt kommitteringen. Ressursene peker på én float IP for master og to for slavene. I motsetning til Tuchanka4 er alle tre float IP-ene feiltolerante. For å balansere read-only SQL-forespørslene kan man bruke sql proxy (med separat feiltoleranse), eller man kan tildele én slave float IP til halvparten av klientene og en annen til den andre halvparten.
Feil Tuchanka3
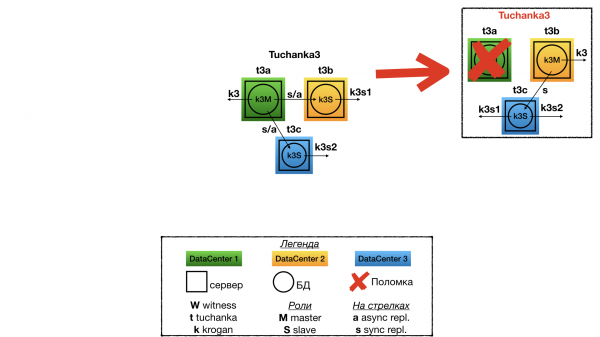
Ved feil på ett av datasentrene er det fortsatt to igjen. I ett er master og masterens float IP aktivert, mens i det andre er det slaver og begge slavernes float IP-er (instansen må ha dobbelt så mange ressurser tilgjengelig for å håndtere alle tilkoblinger fra begge slavernes float IP-er). Det er synkron replikering mellom masterne og slaven. Klyngen vil også bevare informasjon om bekreftede og kommitterte transaksjoner (det vil ikke være tap av informasjon) i tilfelle to datasentre blir ødelagt (så lenge de ikke blir ødelagt samtidig).
Eg detaljert beskrivelse av filstrukturen og distribusjonen bestemte jeg meg for ikke å inkludere. De som ønsker å eksperimentere, kan lese alt dette i README. Jeg gir bare en beskrivelse av automatisk testing.
Automatisk testingssystem
For å teste klusterets feilresistens med simulering av forskjellige feil er det laget et automatisk testingssystem. Det kjøres av et skript test/failure. Skriptet kan ta som parametere nummer på klusterne som skal testes. For eksempel, denne kommandoen:
test/failure 2 3vil teste bare det andre og tredje klusteret. Hvis ingen parametere er angitt, vil alle klusterne bli testet. Alle klusterne testes parallelt, og resultatet vises i tmux-panelet. Tmux bruker en dedikert tmux-server, så skriptet kan kjøres fra standard tmux, og det vil bli en nestet tmux. Jeg anbefaler å bruke terminalen i et stort vindu med liten skrift. Før testing starter, tilbakestilles alle virtuelle maskiner til et snapshot fra tidspunktet da skriptet ble avsluttet. setup.
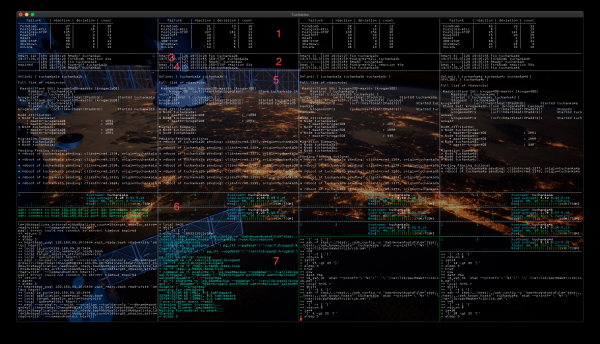
Terminalen er delt inn i kolonner tilsvarende antall testede klustre; som standard (på skjermbildet) er det fire. Innholdet i kolonnene vil jeg utbrodere med eksemplet Tuchanka2. Panelene på skjermbildet er nummerert:
- Her vises statistikk for testene. Kolonner:
- failure — navnet på testen (funksjonen i skriptet) som simulerer en feil.
- reaction — det aritmetiske gjennomsnittlige tiden i sekunder som klusteret gjenopprettet sin drift. Måles fra skriptets start som simulerer feilen og til øyeblikket da klusteret gjenoppretter sin drift og er i stand til å fortsette å tilby tjenester. Hvis tiden er veldig kort, for eksempel seks sekunder (slik som i kluster med flere slaver (Tuchanka3 og Tuchanka4)), betyr det at feilen oppstod på en asynkron slave og ikke påvirket driften; det var ingen tilstandsbytter i klusteret.
- deviation — viser variasjon (presisjon) av verdien reaction metoden "standardavvik".
- count — hvor mange ganger denne testen har blitt utført.
- En kort logg gir en oversikt over hva klusteret jobber med akkurat nå. Den viser nummeret på iterasjonen (testen), tidsstempelet og navnet på operasjonen. En for lang utførelse (> 5 minutter) indikerer et problem.
- heart (hjertet) — gjeldende tid. For visuell vurdering av ytelse mesteren i tabellen hans skrives hele tiden gjeldende tid med bruk av mesters float IP. Ved suksess vises resultatet i dette panelet.
- beat (puls) — «gjeldende tid», som tidligere ble registrert av skriptet heart i mesteren, nå leses fra slaven gjennom hans float IP. Tillater visuell vurdering av ytelsen til slaven og replikasjonen. I Tuchanka1 finnes det ingen slaver med float IP (ingen slaver som tilbyr tjenester), men her er det to instanser (DB), så her vil det ikke bli vist beat, men heart den andre instansen.
- Overvåking av klyngens tilstand ved hjelp av verktøyet
pcs mon. Viser strukturen, ressursfordelingen over nodene og annen nyttig informasjon. - Her vises systemovervåkning fra hver virtuell maskin i klyngen. Det kan være flere slike paneler — så mange virtuelle maskiner som det er i klyngen. To grafer CPU Load (i de virtuelle maskinene med to prosessorer), navnet på den virtuelle maskinen, System Load (kalt Load Average, fordi det er gjennomsnittlig over 5, 10 og 15 minutter), prosessdata, og minnefordeling.
- Sporing av skriptet som utfører testing. Ved feil — plutselig avbrudd av arbeidet eller en uendelig venteloop — kan man her se årsaken til slik oppførsel.
Testing utføres i to trinn. Først går skriptet gjennom alle testtyper, tilfeldig velger en virtuell maskin som testen skal anvendes på. Deretter utføres en uendelig testloop, hvor virtuelle maskiner og feil velges tilfeldig hver gang. Plutselig avslutning av testskriptet (nederste panel) eller en uendelig venteloop (mer enn 5 minutters kjøretid for en operasjon, synlig i sporing) indikerer at en av testene på denne klyngen har feilet.
Hver test består av følgende operasjoner:
- Igangsetting av funksjonen som simulerer en feil.
- Klar? — venting på gjenoppretting av klyngens arbeidsevne (når alle tjenester er tilgjengelige).
- Venter på gjenoppretting av klyngen (reaction).
- Fix — klyngen «fikses». Etter dette skal den komme tilbake til full drift og klar for neste feil.
Her er listen over tester med beskrivelse av hva de gjør:
- ForkBomb: skaper "Out of memory" ved hjelp av en fork-bombe.
- OutOfSpace: fyller opp harddisken. Men testen er i så måte symbolsk, med den ubetydelige belastningen som oppstår under testing; ved overfylling av harddisken skjer det vanligvis ikke en feil i PostgreSQL.
- Postgres-KILL: dreper PostgreSQL ved hjelp av kommandoen
killall -KILL postgres. - Postgres-STOP: setter PostgreSQL i ventemodus ved hjelp av kommandoen
killall -STOP postgres. - PowerOff: «deaktiverer» virtualmaskinen med kommandoen
VBoxManage controlvm "virtuell_maskin" poweroff. - Reset: omstarter virtualmaskinen med kommandoen
VBoxManage controlvm "virtuell_maskin" reset. - SBD-STOP: setter SBD-demonen i ventemodus med kommandoen
killall -STOP sbd. - ShutDown: sender en kommando til virtualmaskinen via SSH
systemctl poweroff, systemet avslutter korrekt. - UnLink: nettverksisolering, kommando
VBoxManage controlvm "virtuell_maskin" setlinkstate1 off.
Avslutning av testen, enten med den standard kommandoen tmux "kill-window" Ctrl-b &, eller med kommandoen "detach-client" Ctrl-b d: når dette skjer, avsluttes testen, tmux lukkes, og virtualmaskinene slås av.
Problemer identifisert under testing
For øyeblikket watchdog-demonen sbd håndterer stopp av overvåkede demoner, men ikke deres hengelås. Som en konsekvens håndteres ikke feil riktig, noe som fører til hengelås av demoner Corosync og Pacemaker, men uten å faktisk fryse sbd. For å sjekke Corosync er allerede , akseptert inn i grenen master. De lovet (i PR#83) at det også ville være noe lignende for Pacemaker, jeg håper at til RedHat 8 vil det bli gjort. Men slike «feil» er teoretiske, lett imiterbare kunstig, for eksempel
killall -STOP corosync, men de forekommer aldri i virkeligheten.Det Pacemaker i versjonen for CentOS 7 er sync_timeout feilaktig stilt til quorum device, som resulterer i , som mesteren skulle ha flyttet til. Dette ble løst ved å øke feilaktig stilt til quorum device under distribusjon (i skriptet
setup/setup1). Denne endringen ble ikke akseptert av utviklerne Pacemaker, i stedet lovte de å omarbeide infrastrukturen slik at den tidsavbruddet ble beregnet automatisk (i en uspesifisert fremtid).Når du konfigurerer databasen, hvis det er angitt at
LC_MESSAGES(tekstmeldinger) kan bruke Unicode, for eksempelru_RU.UTF-8, så ved oppstart postgres i et miljø der locale ikke er UTF-8, for eksempel i et tomt miljø (her pacemaker+pgsqlms(paf) starter postgres), then . Utviklerne av PostgreSQL ble aldri enige om hva de skulle gjøre i dette tilfellet. Dette kan omgås, man må setteLC_MESSAGES=en_US.UTF-8Når du konfigurerer (oppretter) en DB-instans.Hvis wal_receiver_timeout er satt (standard 60s), så ved testing av PostgreSQL-STOP på masteren i klusterne tuchanka3 og tuchanka4 . Replikasjonen der er synkron, så når den stoppe, stopper både arbeidsenhet og ny master. Problemet løses ved å sette wal_receiver_timeout=0 under PostgreSQL-oppsettet.
Jeg har sjelden sett replikasjonsfrysing i PostgreSQL under ForkBomb-testen (minneoverbelastning). . Jeg har bare sett dette i klusterne tuchanka3 og tuchanka4, hvor, siden replikasjonen er synkron, fryser masteren. Problemet går vanligvis over av seg selv etter en viss tid (omtrent to timer). Det kreves ytterligere undersøkelse for å fikse dette. Symptomene ligner på en tidligere feil, som forårsakes av en annen grunn, men med samme konsekvenser.
Krogan-bildet er hentet fra med tillatelse fra forfatteren:
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish