

Vi begynte å tenke på opprettelsen av et overvåkingssystem i løpet av dannelsen av produktteamene. Det ble klart at vårt ansvar — driften — ikke er en del av disse teamene. Hvorfor er det slik?
Saken er den at alle våre team er bygget rundt separate informasjonssystemer, mikrotjenester og grensesnitt, så de ser ikke den generelle helsetilstanden til hele systemet. For eksempel kan de være uvitende om hvordan en liten del av backend påvirker frontend. Deres interesseområde er begrenset til systemene de har integrert sine systemer med. Hvis et team og dets tjeneste A knapt har noe å gjøre med tjeneste B, så er den tjenesten stort sett usynlig for teamet.
Vårt team, derimot, jobber med systemer som er sterkt integrert med hverandre: det finnes mange forbindelser mellom dem, og dette utgjør en ganske stor infrastruktur. Arbeidet til nettbutikken er avhengig av alle disse systemene (som vi forresten har et stort antall av).
Så det viser seg at vår avdeling ikke tilhører noe spesifikt team, men ligger litt utenfor. I denne historien er vår oppgave å forstå helheten av hvordan informasjonssystemene fungerer, deres funksjonalitet, integrasjoner, programvare, nettverk, maskinvare, og hvordan alt henger sammen.
Plattformen som driver våre nettbutikker ser slik ut:
- front
- middle-office
- back-office
Så mye vi skulle ønske, finnes det ikke noe som heter at alle systemer fungerer jevnt og feilfritt. Det kommer igjen an på antall systemer og integrasjoner — med et slikt volum som vi har, er visse hendelser uunngåelige, til tross for kvaliteten på testingen. Dette gjelder både innenfor et enkelt system og i forhold til deres integrasjon. Det er nødvendig å overvåke tilstanden til hele plattformen helhetlig, og ikke bare en viss del av den.
I idealtilfellet bør overvåkningen av helsetilstanden til hele plattformen automatiseres. Vi kom til overvåkning som en uunngåelig del av denne prosessen. I utgangspunktet ble det bygget bare for frontend-delen, mens egne overvåkingssystemer for lagene ble og blir brukt av nettverksfolk, programvareadministratorer og maskinvare. Alle disse menneskene overvåket bare på sitt nivå, ingen hadde noe helhetlig forståelse.
For example, if a virtual machine fails, in most cases only the administrator responsible for the hardware and the virtual machine is aware of this. The frontend team sees the fact of the application's failure, but they have no data about the failure of the virtual machine. The administrator may know who the client is and have a rough idea of what is currently running on that virtual machine, provided it is a large project. For smaller projects, they are likely unaware. In any case, the administrator needs to approach the owner and inquire about what was on that machine, what needs to be restored, and what should be changed. If something serious was broken, a frantic search would begin — because no one had a holistic view of the system.
Ultimately, such fragmented stories affect the entire frontend, the users, and our core business function — online sales. As we are not part of the teams, but rather manage all ecommerce applications within the online store, we took on the task of creating a comprehensive monitoring system for the ecommerce platform.
System Structure and Stack
We started by identifying several layers of monitoring for our systems, across which we would need to collect metrics. All of this needed to be integrated, which we accomplished in the first phase. Now at this stage, we are refining the collection of metrics across all our layers to establish correlations and understand how systems affect one another.
The lack of comprehensive monitoring at the initial stages of application launches (since we started building it when most systems were already in operation) resulted in a significant technical debt regarding the configuration of monitoring for the entire platform. We could not afford to focus on configuring monitoring for a single information system in detail, as the other systems would be without monitoring for some time. To solve this challenge, we identified a list of the most necessary metrics for assessing the state of the information system across layers and began to implement it.
Therefore, we decided to tackle the elephant in parts.
Our system consists of:
- hardware;
- operating system;
- software;
- UI-deler i overvåkingsapplikasjonen;
- forretningsmetrikker;
- integrasjonsapplikasjoner;
- informasjonssikkerhet;
- nettverk;
- trafikkbalanserer.
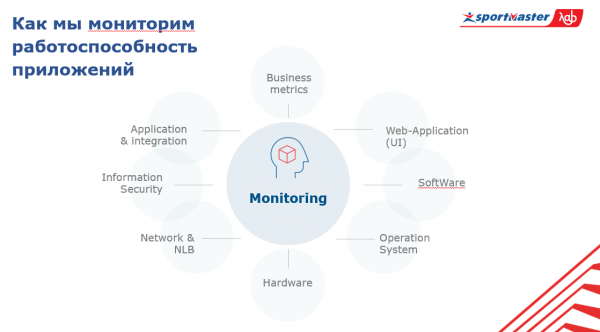
I sentrum av dette systemet er selve overvåkingen. For å forstå tilstanden til hele systemet, er det nødvendig å vite hva som skjer med applikasjonene på alle disse lagene og i lys av det store antallet applikasjoner.
Så, la oss snakke om stakken.
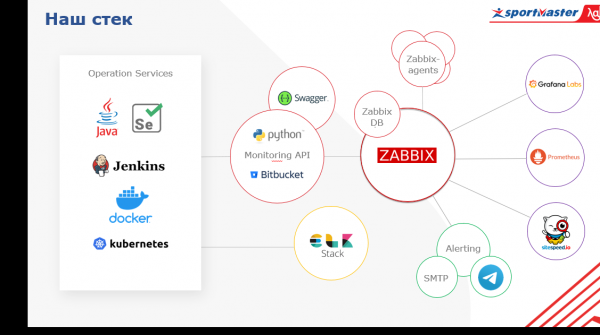
Vi bruker programvare med åpen kildekode. I sentrum har vi Zabbix, som vi primært bruker som et alarmsystem. Alle vet at det passer perfekt for overvåkning av infrastruktur. Hva menes med dette? Det er nettopp de lavnivåmetrikker som finnes hos hver bedrift som har sitt eget datasenter (og Sportmaster har sine datasentre) — servertemperatur, minnestatus, RAID-status, metrikker for nettverksenheter.
Vi har integrert Zabbix med meldingssystemene Telegram og Microsoft Teams, som er mye brukt i teamene. Zabbix dekker laget av den faktiske nettverket, maskinvaren og delvis programvaren, men det er ikke en panacea. Vi beriker disse dataene fra noen andre tjenester. For eksempel, på maskinvare-nivå kobler vi oss direkte via API til vårt virtualiseringssystem og henter data.
Hva mer. I tillegg til Zabbix bruker vi Prometheus, som tillater oss å overvåke metrikker i applikasjonen av dynamiske omgivelser. Det vil si at vi kan motta applikasjonsmetrikker via HTTP-endepunkt og ikke bekymre oss for hvilke metrikker vi skal laste opp og hvilke vi ikke skal. Basert på disse dataene kan vi lage analytiske forespørsel.
Datakilder for de andre lagene, for eksempel forretningsmetrikker, er delt inn i tre komponenter.
For det første, ekstern forretningssystemer, Google Analytics, vi samler metrikker fra logger. Fra dem får vi data om aktive brukere, konverteringer og alt annet relatert til forretningen. For det andre, det er brukermonitoreringssystemet. Dette bør beskrives mer detaljert.
En gang startet vi med manuell testing, og det utviklet seg til automatiserte tester for funksjonalitet og integrasjoner. Derfra laget vi overvåkingen, og beholdt bare hovedfunksjonaliteten, og knyttet oss til marker som er så stabile som mulig og ikke endres ofte over tid.
Den nye teamstrukturen innebærer at all aktivitet knyttet til applikasjoner er konsolidert innen produktteamene, så vi har sluttet med ren testing. I stedet har vi utviklet UI-overvåking, skrevet i Java, Selenium og Jenkins (som brukes som system for kjøring og rapportgenerering).
Vi hadde mange tester, men til slutt bestemte vi oss for å fokusere på hovedveien, den overordnede metrikken. Og hvis vi har mange spesifikke tester, vil det bli vanskelig å opprettholde datakvaliteten. Hver påfølgende utgivelse vil i stor grad bryte hele systemet, og vi vil bare ende opp med å fikse det. Derfor har vi fokusert på helt grunnleggende ting som sjelden endres, og bare overvåker dem.
Til slutt, for det tredje, er kilden til dataene et sentralisert loggingssystem. Vi bruker Elastic Stack for logger, og deretter kan vi trekke disse dataene inn i vårt overvåkingssystem for forretningsmetrikker. I tillegg til dette fungerer vår egen Monitoring API-tjeneste, skrevet i Python, som forespør API-er fra forskjellige tjenester og henter data fra dem inn i Zabbix.
En annen uunnværlig komponent i overvåking er visualisering. Vår visualisering er bygget på Grafana. Blandt andre visualiseringssystemer utmerker den seg ved at den på dashbordet kan visualisere metrikker fra forskjellige datakilder. Vi kan samle de overordnede metrikene til nettbutikken, for eksempel antall bestillinger gjort den siste timen, fra databasene, ytelsesmeter fra operativsystemet som nettbutikken kjører på, fra Zabbix, og metrikker fra applikasjonsinstansene fra Prometheus. Alt dette vil være på ett dashbord. Klart og tilgjengelig.
Jeg vil nevne sikkerhet – vi jobber nå med å forbedre systemet som vi senere skal integrere med det globale overvåkingssystemet. Etter min mening er de viktigste utfordringene som e-handel møter innen informasjonssikkerhet knyttet til roboter, parsere og brute force-angrep. Dette må overvåkes, fordi det kan kritisk påvirke både ytelsen til applikasjonene våre og omdømmet vårt fra et forretningsperspektiv. Og med den valgte stakken dekker vi disse oppgavene.
En viktig punkt är att applikationsnivån samlas in av Prometheus. Den är också integrerad med Zabbix. Dessutom har vi sitespeed, en tjänst som gör att vi kan se parametrar som laddningstiden för vår sida, flaskhalsar, rendering av sidan, laddning av skript och mer, och den är också integrerad via API. Så våra mätningar samlas i Zabbix, och vi skickar även larm därifrån. Alla larm går för närvarande till de huvudsakliga sätten att skicka (framför allt e-post och Telegram, och vi har nyligen kopplat in MS Teams). Vi planerar att förbättra larmhanteringen så att smarta bots fungerar som en tjänst och tillhandahåller information om övervakning till alla intresserade produktteam.
För oss är det viktigt med mätningar inte bara av enskilda informationssystem, utan även övergripande mätningar av hela infrastrukturen som applikationerna använder: kluster fysiska servrar, där virtuell maskiner körs, trafikbalanserare, Network Load Balancer, själva nätverket, utnyttjande av kommunikationskanaler. Dessutom mätningar från våra egna datacenter (vi har flera och infrastrukturen är av betydande storlek).
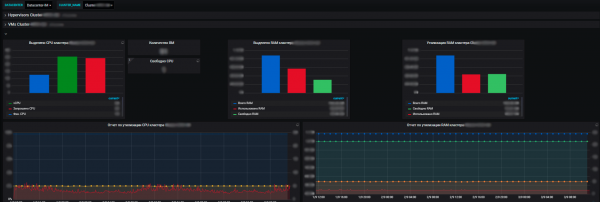
Fördelarna med vårt övervakningssystem är att vi kan se tillståndet för alla system, bedöma deras påverkan på varandra och på gemensamma resurser. Slutligen gör det oss i stånd att planera resurser, vilket också ingår i vårt ansvarsområde. Vi hanterar serverresurser — ett pool inom e-handel, sätter in och tar ur drift ny utrustning, köper ny utrustning, genomför revision av resursutnyttjande och mer. Varje år planerar teamen nya projekt, utvecklar sina system, och det är viktigt för oss att säkra resurserna.
Och med hjälp av mätningar ser vi trenden för resursförbrukning av våra informationssystem. Och baserat på detta kan vi planera något. På virtualiseringsnivå samlar vi in data och ser information om tillgängligt antal resurser uppdelat per datacenter. Och inom datacentret syns både utnyttjande och faktisk fördelning samt resursanvändning. Detta gäller både standalone-servrar och virtuella maskiner samt kluster av fysiska servrar där alla dessa virtuella maskiner smidigt körs.
Fremtiden
Nå er kjernen i systemet vårt stort sett klar, men det gjenstår fortsatt en del punkter vi må jobbe med. Minst av alt er det laget for informasjonssikkerhet, men det er også viktig å komme til nettverket, utvikle varsling og løse spørsmålet om korrelasjon. Vi har mange lag og systemer, og på hvert lag finnes det mange metrikk.
Oppgaven vår er i siste instans å lage de riktige varslingene. For eksempel, hvis det oppstår et problem med maskinvaren, igjen med den virtuelle maskinen, og der var det en viktig applikasjon som ikke var reservert. Vi finner ut at den virtuelle maskinen har krasjet. Deretter vil forretningsmetrikker varsles: brukere er forsvunnet, det er ingen konverteringer, UI i grensesnittet er utilgjengelig, programvare og tjenester har også krasjet.
Med et slikt oppsett vil vi få spam fra varsler, og det passer ikke inn i formatet for et riktig overvåkningssystem. Spørsmålet om korrelasjon oppstår. Derfor bør vårt overvåkningssystem ideelt sett si: «Folkens, maskinvaren deres har krasjet, og sammen med den, denne applikasjonen og disse metrikene», med ett varsel i stedet for å drukne oss i hundre varsler. Det bør informere om hovedårsaken som bidrar til rask løsning av problemet gjennom lokaliseringsmetoden.
Varslingssystemet vårt og håndteringen av varsler er bygget rundt en døgnåpen supporttjeneste. Alle varsler vi anser som nødvendige og som er inkludert i sjekklisten, sendes dit. Hver varsling må alltid ha en beskrivelse: hva som har skjedd, hva det egentlig betyr, og hva det påvirker. Og en lenke til dashbordet samt instruksjoner om hva som må gjøres i dette tilfellet.
Dette er alt som gjelder kravene til bygging av varslinger. Situasjonen kan deretter utvikle seg i to retninger – enten er det et problem som må løses, eller det har oppstått en feil i overvåkningssystemet. Men uansett må man gå inn og undersøke.
I gjennomsnitt får vi nå omtrent hundre varsler per dag, dette med forbehold om at korrelasjonen av varsler ennå ikke er riktig innstilt. Og hvis tekniske arbeider må utføres, og vi tvinger noe til å bli stengt, vil antallet øke betraktelig.
I tillegg til overvåking av systemene vi bruker og innsamling av metrikker som er viktige for oss, lar overvåkningssystemet oss samle data for produktteamene. De kan påvirke hvilke metrikker som overvåkes i våre informasjonssystemer.
Vår kollega kan komme og be om å legge til en metrikk som viser seg å være nyttig for både oss og teamet. Eller teamet kan for eksempel mangle de grunnleggende metrikene vi har, og de trenger å overvåke noe spesifikt. I Grafana oppretter vi et område for hvert team og gir administrativ tilgang. Hvis teamet trenger dashbord, og de ikke kan eller ikke vet hvordan de skal lage det selv, hjelper vi dem.
Siden vi er utenfor strømmen av verdiskaping til teamet, deres utgivelser og planlegging, kommer vi gradvis til å oppnå sømløse utgivelser av alle systemene, som kan rulles ut daglig uten å måtte koordinere med oss. Det er viktig for oss å overvåke disse utgivelsene, fordi de potensielt kan påvirke appens funksjonalitet og forårsake feil, noe som er kritisk. For styring av utgivelser bruker vi Bamboo, hvorfra vi får data via API, og vi kan se hvilke utgivelser som har blitt gjort i hvilke informasjonssystemer og deres status. Og det viktigste — når de skjer. Vi plasserer markeringspunkter om utgivelser på de viktigste kritiske metrikene, noe som visuelt er ganske indikativt i tilfelle problemer.
På denne måten kan vi se sammenhengen mellom nye utgivelser og oppståtte problemer. Hovedideen er å forstå hvordan systemet fungerer på alle nivåer, raskt lokalisere problemet og også raskt løse det. For ofte tar det mer tid å finne årsaken enn å løse problemet.
Og i denne retningen vil vi i fremtiden fokusere på proaktivitet. Ideelt sett ønsker vi å vite om en kommende problemstilling på forhånd, heller enn i etterkant, slik at vi kan forebygge det, ikke bare løse det. Noen ganger skjer det falske alarmer fra overvåkningssystemet, enten på grunn av menneskelig feil eller endringer i applikasjonen. Vi jobber med dette, finjusterer, og prøver å informere brukerne som bruker systemet sammen med oss, før vi gjør noen endringer, eller vi gjennomfører disse aktivitetene i vedlikeholdsvinduet.
Så systemet er i gang og fungerer godt siden tidlig vår... og viser en ganske reell fortjeneste. Selvfølgelig er dette ikke den endelige versjonen, vi vil implementere mange flere nyttige funksjoner. Men akkurat nå, med så mange integrasjoner og applikasjoner, er det faktisk umulig å unngå automatisert overvåking.
Hvis du også overvåker store prosjekter med betydelig antall integrasjoner – skriv i kommentarene hvilken sølvkule du har funnet for dette.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish