

Vi utviklet DevOps så godt vi kunne. Vi var 8 personer, og Vanya var den beste på Windows. Plutselig forlot Vanya oss, og jeg fikk ansvaret for å sette i gang et nytt prosjekt som leverer Windows-utvikling. Når jeg la ut hele Windows-utviklingsstakken på bordet, innså jeg at situasjonen var smertefull…
Slik begynner historien Aleksandr Sinchinov på . Da den ledende spesialisten på Windows forlot selskapet, stilte Aleksandr seg spørsmålet om hva han skulle gjøre nå. Gå over til Linux, selvfølgelig! Aleksandr vil fortelle hvordan han klarte å lage et presedens og overføre en del av Windows-utviklingen til Linux, med et eksempel fra et prosjekt med 100 000 sluttbrukere.
Hvordan enkelt og uanstrengt levere prosjektet i RPM ved å bruke TFS, Puppet, Linux .NET Core? Hvordan opprettholde versjonering av databasene i prosjektet, når utviklerne hører om Postgres og Flyway for første gang, med fristen om to dager? Hvordan integrere med Docker? Hvordan motivere .NET-utviklere til å gi opp Windows og smoothies til fordel for Puppet og Linux? Hvordan løse ideologiske konflikter når man ikke har verken styrke, lyst eller ressurser til å drifte Windows i produksjon? Om dette, samt Web Deploy, testing, CI, praksis for bruk av TFS i eksisterende prosjekter, og selvfølgelig om ødelagte krykker og fungerende løsninger, i transkripsjonen av Aleksandr sin presentasjon.
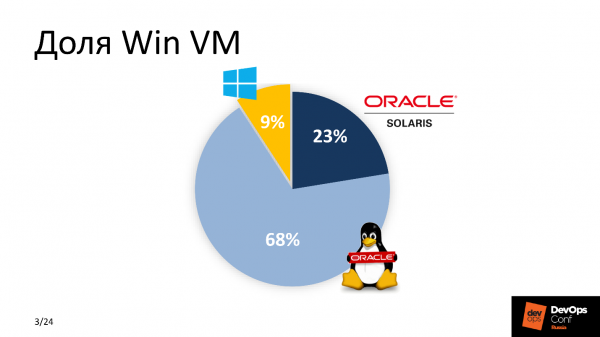
Så, Vanya har dratt, oppgaven er min, utviklerne venter utålmodig med gaffel. Da jeg endelig forsto at jeg ikke kunne få Vanya tilbake, begynte jeg å jobbe. Først vurderte jeg prosentandelen av Win VM i vår park. Regnestykket gikk ikke i Windows' favør.
Siden vi aktivt utvikler DevOps, innså jeg at jeg måtte endre tilnærmingen til å ta i bruk den nye applikasjonen. Løsningen var enkel – om mulig overføre alt til Linux. Google hjalp meg – på den tiden var .Net allerede portet til Linux, og jeg innså at dette var løsningen!
Hvorfor .NET Core i kombinasjon med Linux?
Det var flere grunner til dette. Mellom "å betale penger" og "ikke betale" vil de fleste velge det andre – som jeg. Lisensen for MSDB koster omtrent 1 000 $, og vedlikeholdet av parken med Windows virtuelle maskiner beløper seg til hundrevis av dollar. For en stor bedrift er dette store kostnader. Derfor besparelse — den første grunnen. Ikke den viktigste, men en av de betydelige.
Windows virtuelle maskiner krever mer ressurser enn sine brødre fra Linux – de er tunge. Gitt med størrelsen på det store selskapet har vi valgt Linux.
Systemet integreres enkelt i eksisterende CI. Vi anser oss som progressive DevOps, bruker Bamboo, Jenkins og GitLab CI, så det meste av arbeidet vårt går på Linux.
Den siste grunnen er komfortabel støtte. Vi måtte senke inngangsbarrieren for «supportere» – folk som forstår den tekniske delen, sørger for kontinuitet og drifter tjenester fra andre linje. De var allerede kjent med Linux-stakken, så det er mye lettere for dem å forstå det nye produktet, støtte og vedlikeholde det, enn å bruke ekstra ressurser på å sette seg inn i tilsvarende funksjonalitet for Windows-plattformen.
Krav
Først og fremst – komforten i den nye løsningen for utviklere. Ikke alle var klare for endringene, spesielt etter at ordet Linux ble nevnt. Utviklerne ønsker sin kjære Visual Studio, TFS med autotester for bygg og smoothies. Hvordan levering til produksjon skjer, bryr de seg ikke om. Derfor bestemte vi oss for å ikke endre den vanlige prosessen og la alt stå uendret for Windows-utviklingen.
Det nye prosjektet må integreres i eksisterende CI. Railsene var allerede på plass, og alt arbeid måtte utføres med tanke på systemet for konfigurasjonsadministrasjon, vedtatte leveringsstandarder og overvåkningssystemer.
Enkelhet i støtte og drift, som et krav for minimal inngangsbarriere for alle nye deltakere fra forskjellige avdelinger og supportavdelingen.
Fristen var i går.
Win-utviklingsgruppen
Hva jobbet Windows-teamet med?
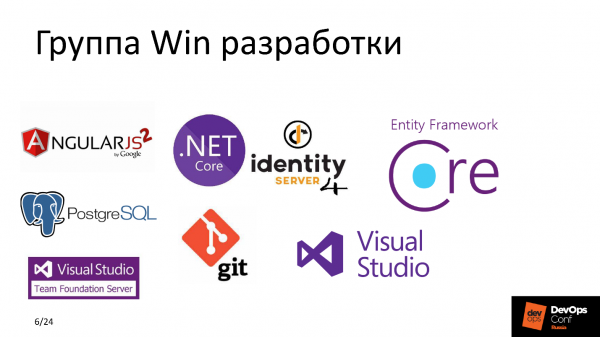
Nå kan jeg trygt si at IdentityServer4 er et fantastisk gratis alternativ til ADFS med lignende muligheter, eller hva Entity Framework Core er et paradis for utviklere, der man kan slippe å skrive SQL-skript og heller beskrive databasforespørslene med OOP-termer. Men på den tiden, under diskusjonen av handlingsplanen, så jeg på denne stakken som babylonsk kileskrift og kjente bare PostgreSQL og Git.
På den tiden brukte vi aktivt Puppet som konfigurasjonsadministrasjonssystem. I de fleste av våre prosjekter brukte vi GitLab CI, Elastic, balanserte høyt belastede tjenester med hjelp av HAProxy, holdt oversikt over alt med hjelp av Zabbix, pakken Grafana og Prometheus, Jaeger, og alt dette kjørte på maskiner HP med ESXi på VMware.Alle kjenner det – sjangerens klassiker.
La oss se og prøve å forstå hva som skjedde før vi begynte med alle disse intervensjonene.
Hva som skjedde
TFS er et ganske kraftig system som ikke bare leverer koden fra utvikler til den endelige produksjonsmaskinen, men også har et sett for veldig fleksibel integrering med forskjellige tjenester - for å sikre CI på tvers av plattformer.
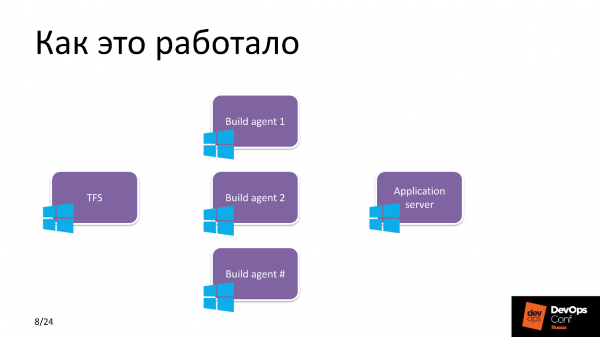
Tidligere var det ren vinduer. TFS brukte flere byggagenter, hvor mange prosjekter ble bygget. I hver agent var det 3-4 arbeidere for å parallellisere oppgavene og optimalisere prosessen. Deretter, i henhold til utgivelsesplanene, leverte TFS den nybakte byggingen til Windows-applikasjonsserveren.
Hva vi ønsket å oppnå
For levering og utvikling bruker vi TFS, mens vi kjører applikasjonen på Linux-applikasjonsserveren, og mellom dem er det en form for magi. Denne Magic Box er essensen av det kommende arbeidet. Før vi tar det fra hverandre, vil jeg ta et skritt til siden og si noen ord om applikasjonen.
Prosjekt
Applikasjonen gir funksjonalitet for å håndtere forhåndsbetalte kort.
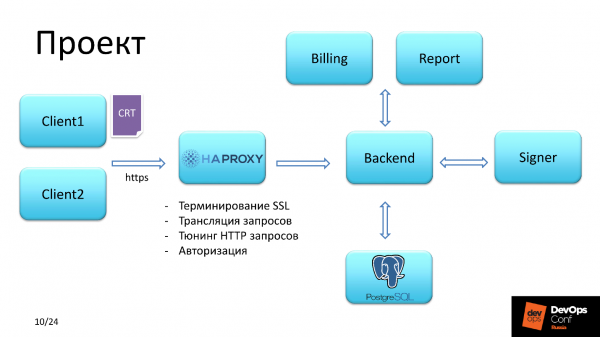
Client
Det var to typer brukere. Den første fikk tilgang ved å autentisere via SSL SHA-2 sertifikat. Den andre hadde tilgang med brukernavn og passord.
HAProxy
Deretter kom klientforespørselen inn i HAProxy, som løste følgende oppgaver:
- første autentisering;
- terminering av SSL;
- justere HTTP-forespørslene;
- oversette forespørslene.
Sjekken av klientsertifikatet foregikk i henhold til kjeden. Vi er authority og vi kan tillate oss dette, siden vi selv utsteder sertifikater til tjenestekundene.
Vær oppmerksom på det tredje punktet, vi kommer tilbake til det senere.
Backend
Backend var planlagt å være på Linux. Backend interagerer med databasen, laster inn den nødvendige listen over privilegier, og deretter, avhengig av hvilke privilegier den autentiserte brukeren har, gir tilgang til signering av finansdokumenter og sending av dem til utførelse, eller generering av en rapport.
Sparing med HAProxy
I tillegg til to kontekster, som alle klientene gikk gjennom, fantes det også en kontekst identity. IdentityServer4 som gjør det mulig å autentisere, dette er et gratis og kraftig alternativ til ADFS — Active Directory Federation Services.
Forespørselen til identity ble behandlet i flere trinn. Det første trinnet - klienten ble sendt til backend, som utvekslet data med denne serveren og kontrollerte om det fantes en token for klienten. Hvis den ikke ble funnet, ble forespørselen sendt tilbake til konteksten den kom fra, men allerede med en omdirigering, og med omdirigeringen gikk den til identity.
Det andre steget - forespørselen kom til på påloggingssiden i IdentityServer, der klienten registrerte seg, og i IdentityServer-databasen dukket endelig den etterlengtede token opp.
Det tredje steget - klienten ble omdirigert tilbake til konteksten den kom fra.
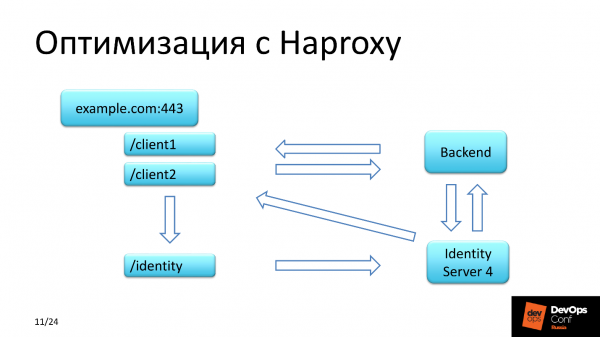
IdentityServer4 har en spesiell funksjon: svaret på den omvendte forespørselen returneres via HTTP. Uansett hvor mye vi prøvde å konfigurere serveren, hvor mye vi studerte dokumentasjonen, fikk vi hver gang den opprinnelige forespørselen fra klienten med en URL som kom via HTTPS, mens IdentityServer returnerte den samme konteksten, men med HTTP. Vi var i sjokk! Og vi dirigerte alt dette gjennom identity-konteksten til HAProxy, og i headerne måtte vi endre protokollen fra HTTP til HTTPS.
Hva er forbedringen og hvor har vi spart?
Vi sparte penger ved å bruke en gratis løsning for autentisering av gruppebrukere, ressurser, siden vi ikke plasserte IdentityServer4 som en egen node i et eget segment, men brukte det sammen med backend på den samme serveren som applikasjonens backend kjører.
Hvordan det skal fungere
Så, som jeg lovet - Magic Box. Vi forstår allerede at vi garantert beveger oss mot Linux. La oss formulere konkrete oppgaver som krevde løsning.
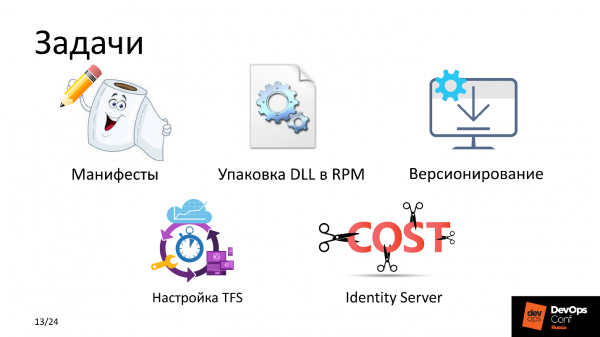
Puppet-manifester. For å levere og administrere konfigurasjonen av tjenesten og applikasjonen, måtte vi skrive gode oppskrifter. En rull med blyant viser tydelig hvor raskt og kvalitetsmessig dette ble gjort.
Leveringsmetode. Standarden er RPM. Alle forstår at man ikke kan klare seg uten det i Linux, men prosjektet etter byggingen besto av et sett med kjørbare DLL-filer. Det var omtrent 150, prosjektet er ganske tungt. Den eneste harmoniske løsningen er å pakke denne binærfilen i RPM og deretter utvikle applikasjonen fra den.
Versjonering. Vi måtte ofte publisere, og vi måtte bestemme hvordan vi skulle lage pakkenavn. Dette er et spørsmål på integrasjonsnivå med TFS. Bygg-agenten vår var på Linux. Når TFS sender en oppgave til prosessoren - worker - på Bygg-agenten, sender den også en batch med variabler som går inn i miljøet til prosessoren. I disse miljøvariablene sendes byggnavn, versjonsnavn og andre variabler. Mer om dette finner du i delen «bygge RPM-pakken».
TFS-oppsett bestod av oppsett av Pipeline. Tidligere bygde vi alle Windows-prosjekter på Windows-agenter, men nå får vi en Linux-agent - Bygg-agenten, som må inkluderes i byggegruppen, berikes med noen artefakter, fortelle hvilket type prosjekter som skal bygges på denne Bygg-agenten, og på en eller annen måte modifisere Pipeline.
IdentityServer. ADFS er ikke vår vei, vi står for Open Source.
La oss se på komponentene.
Magic Box
Består av fire deler.
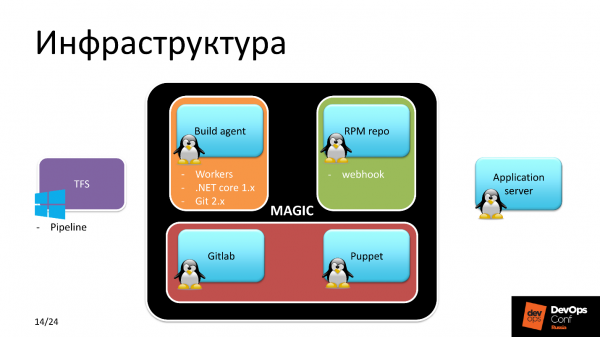
Linux Bygg-agent. Linux, fordi vi pakker for det – logisk. Denne delen ble utført i tre trinn.
- Sett opp workerne og ikke én, da det var planlagt distribuert arbeid med prosjektet.
- Installer .NET Core 1.x. Hvorfor nettopp 1.x, når 2.0 er tilgjengelig i standardrepoet? Fordi, da vi begynte utviklingen, var stabil versjon 1.09, og prosjektet ble besluttet å lages under det.
- Git 2.x.
RPM-repositorium. RPM-pakker måtte oppbevares et sted. Det ble antatt at vi skulle bruke det samme bedrifts-RPM-repositoriet som er tilgjengelig for alle Linux-verter. Slik gikk vi frem. På repository-serveren er det satt opp webhook som lastet ned den nødvendige RPM-pakken fra det angitte stedet. Versjonen av pakken ble rapportert til webhooken av Bygg-agenten.
GitLab. Merk! GitLab her brukes ikke av utviklerne, men av driftsavdelingen for versjonskontroll av applikasjonen, versjoner av pakker, overvåking av tilstanden til alle Linux-maskinene, og det lagrer oppskriften - alle Puppet-manifestene.
Puppet — løser alle kontroversielle saker og leverer nøyaktig den konfigurasjonen vi ønsker, fra Gitlab.
La oss begynne å dykke inn. Hvordan skjer leveransen av DLL til RPM?
Levering av DDL til RPM
La oss si at vi har en rockestjerne i .NET-utvikling. Han bruker Visual Studio og oppretter en release-gren. Deretter laster han opp denne til Git, og Git her er en TFS-forekomst, det vil si det er applikasjonens repository som utvikleren jobber med.
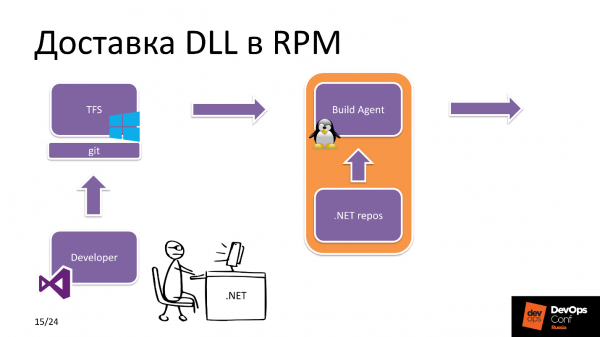
Etter at TFS ser at en ny commit er kommet inn. Hvilket program? I TFS-innstillingene er det en etikett som viser hvilke ressurser hver Build-agent har. I dette tilfellet ser den at vi samler et .NET Core-prosjekt og velger Linux Build-agent fra poolen.
Build-agenten henter kildene, laster ned nødvendige avhengigheter fra .NET-repositoriet, npm osv., og etter byggingen av selve applikasjonen og den påfølgende pakking, sender den RPM-pakken til RPM-repositoriet.
På den andre siden skjer følgende. En ingeniør fra driftsavdelingen jobber direkte med utrullingen av prosjektet: endrer versioner av pakkene i Hiera i repositoriet hvor oppskriften på applikasjonen lagres, hvoretter Puppet trigget Yum, henter den nye pakken fra repositoriet, og den nye versjonen av applikasjonen er klar til bruk.
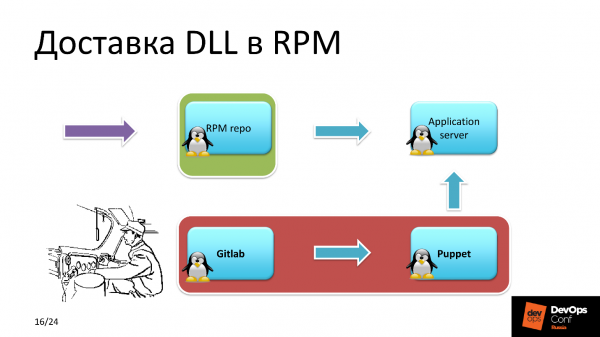
På papiret er alt enkelt, men hva skjer inne i selve Build-agenten?
Pakkingen av DLL RPM
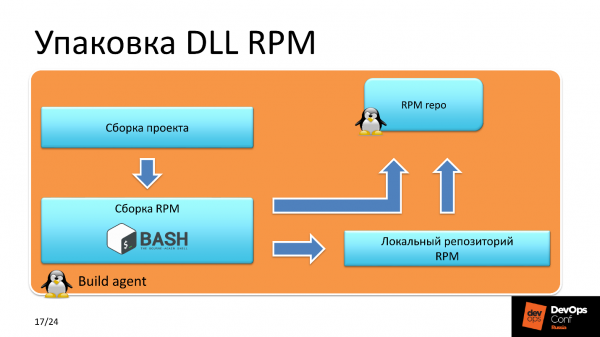
Kildene til prosjektet og byggeoppgaven fra TFS er mottatt. Build-agenten setter i gang byggingen av selve prosjektet fra kildene.Det ferdige prosjektet er tilgjengelig i form av mange DLL-filer, som er pakket inn i en zip-arkiv for å redusere belastningen på filsystemet.
ZIP-arkivet blir plassert i katalogen for byggingen av RPM-pakken. Deretter initialiserer Bash-skriptet miljøvariabler, finner versjonen av Build, versjonen av prosjektet, stien til byggkatalogen og starter RPM-build. Når byggingen er ferdig, publiseres pakken i det lokale repositoriet, som ligger på Build-agenten.
Deretter sendes en JSON-forespørsel fra Build-agenten til serveren i RPM-repositoriet med spesifisering av versjonsnavn og bygget. Webhook-en, som jeg nevnte tidligere, henter denne pakken fra det lokale repositoriet på Build-agenten og gjør den nye byggingen tilgjengelig for installasjon. Hvorfor er nettopp denne leveringsordningen for pakken til RPM-repositoriet? Hvorfor kan ikke den bygde pakken sendes direkte til repositoriet? Poenget er at dette er et vilkår for å sikre sikkerhet. Et slikt scenario begrenser muligheten for uautorisert opplasting av RPM-pakker av utenforstående til serveren, som er tilgjengelig for alle Linux-maskiner.
Versjonering av DB
På konsiliet med utviklingen ble det klart at guttene foretrakk MS SQL, men i de fleste non-Windows prosjektene brukte vi allerede PostgreSQL. Siden vi allerede hadde bestemt oss for å avstå fra alt betalt, begynte vi å bruke PostgreSQL også her.
На консилиуме с разработкой выяснилось, что ребятам ближе MS SQL, но в большинстве non-Windows проектов мы уже вовсю использовали PostgreSQL. Так как мы уже решили отказаться от всего платного, то стали использовать PostgreSQL и здесь.
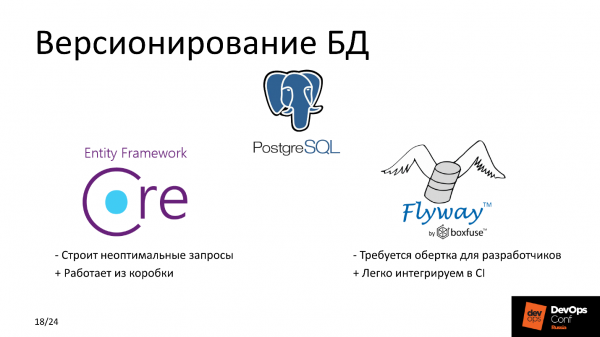
I denne delen ønsker jeg å fortelle hvordan vi implementerte versjonering av databasen og hvordan vi valgte mellom Flyway og Entity Framework Core. La oss se på deres fordeler og ulemper.
Ulemper
Flyway går kun i én retning, vi kan ikke rulle tilbake — det er en betydelig ulempe. Vi kan sammenligne med Entity Framework Core ut fra andre kriterier — fra utviklerens bekvemmelighet. Dere husker at vi satte dette i fokus, og det viktigste kriteriet var å ikke endre noe for Windows-utvikling.
For Flyway trengte vi en form for omslag, slik at folket ikke måtte skrive SQL-spørsmål. De har mye mer erfaring med å jobbe i objektrelaterte termer. Vi skrev instruksjoner for arbeid med databasenheter, SQL-spørsmålet ble dannet og utført. Den nye databasen er klar, den har blitt kjørt — alt er bra, alt fungerer.
Entity Framework Core har en ulempe — ved høy belastning bygger den suboptimale SQL-spørsmål, og databasen kan oppleve betydelig nedgang. Men siden vi ikke har en høybelastet tjeneste, vi teller ikke belastningen i hundrevis av RPS, vi tok disse risikoene og overlot problemet til fremtidige oss.
Fordeler
Entity Framework Core fungerer ut av boksen og er praktisk for utvikling, mens Flyway enkelt integreres i eksisterende CI. Men vi gjør det for utviklerens bekvemmelighet :)
Rulleprosedyren
Puppet ser at det kommer en endring i versjonen av pakkene, deriblant den som håndterer migrasjonen. Den installerer først pakken som inneholder migreringsskriptene og funksjonaliteten knyttet til databasen. Etter dette restartes applikasjonen som jobber med databasen. Deretter installeres de gjenværende komponentene. Rekkefølgen for pakkens installasjon og oppstart av applikasjoner er beskrevet i Puppet-manifestet.
Applikasjoner bruker sensitive data, som tokens og passord til databasen, dette hentes inn i konfigurasjonen fra Puppet master, der de lagres i kryptert form.
TFS-problemer
Etter at vi hadde bestemt oss og forstod at alt faktisk fungerte, tok jeg en titt på hva som foregikk med byggene i TFS generelt for Win-utviklingsavdelingen på andre prosjekter — om vi bygger/releaser raskt eller ikke, og oppdaget betydelige problemer med hastigheten.
Et av de viktigste prosjektene bygges på 12-15 minutter — det er lenge, slik kan vi ikke ha det. Rask analyse viste en fryktelig nedgang i I/O, og det på massive.
Ved å analysere komponent for komponent, identifiserte jeg tre brennpunkter. Det første — «Kaspersky antivirus», som skanner kildekoden på alle Windows build-agenter. Den andre – Windows Indexer. Den ble ikke deaktivert, og på build-agentene indekserte alt i sanntid under distribusjonsprosessen.
Den tredje – Npm install. Det viste seg at vi i de fleste Pipelines brukte akkurat dette skriptet. Hva er galt med det? Prosedyren Npm install kjøres når avhengighetstreet genereres i package-lock.json, hvor versjoner av pakkene som skal brukes til bygging av prosjektet, registreres. Ulempen er at Npm install henter de nyeste versjonene av pakkene fra internett hver gang, og det tar tid i tilfelle av et stort prosjekt.
Utviklere eksperimenterer noen ganger på den lokale maskinen for å sjekke om en del av prosjektet eller hele prosjektet fungerer. Noen ganger ble resultatene gode lokalt, men under bygging og implementering – fungerte ingenting. Vi begynte å undersøke hva problemet var – aha, forskjellige versjoner av pakkene med avhengigheter.
Solution
- Kildene i unntakene AV.
- Deaktivering av indeksering.
- Overgang til npm ci.
Fordelene med npm ci er at vi bygger avhengighetstreet en gang, og får muligheten til å gi utvikleren en oppdatert liste over pakker, som han kan eksperimentere med så mye han vil lokalt. Dette sparker tid for utviklerne som skriver kode.
Konfigurasjon
Nå litt om konfigurasjonen av depotet. Historisk sett har vi brukt Nexus for å administrere repositories, inkludert Internal REPO. I dette interne depotet leveres alle komponentene vi bruker til interne formål, for eksempel egne overvåkingsløsninger.
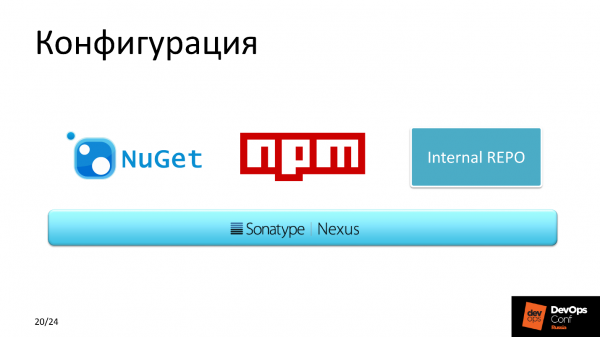
Vi bruker også NuGet, da det cacher bedre sammenlignet med andre pakkebehandlere.
Resultatet
Etter at vi optimaliserte build-agentene, reduserte gjennomsnittlig byggingstid fra 12 minutter til 7.
Hvis vi regner med alle maskinene vi kunne ha brukt for Windows, men som ble overført til Linux i dette prosjektet, har vi spart rundt $10 000. Og dette er bare for lisensene, og hvis vi tar hensyn til vedlikehold – mer.
Planer
For neste kvartal har vi planlagt arbeid med optimalisering av kodelevering.
Overgang til prebuild Docker-image. TFS er en flott greie med mange plugins som lar deg integrere i Pipeline, inkludert bygging på trigger, for eksempel av Docker-image. Den triggeren vil vi lage på det samme package-lock.json. Hvis komponentene som brukes til å bygge prosjektet på en eller annen måte endres, blir det bygget et nytt Docker-bilde. Dette brukes deretter til å sikre en container med den bygde applikasjonen. Dette er ikke tilfelle nå, men vi planlegger å gå over til en mikrotjenestearkitektur i Kubernetes, som aktivt utvikles i vårt selskap og lenge har støttet produksjonsløsninger.
Sammendrag
Jeg oppfordrer alle til å kaste Windows, men ikke fordi jeg ikke kan bruke den. Årsaken er at en stor del av Open Source-løsningene er Linux-stabel. Du vil spare mye på ressursene. Etter min mening er fremtiden med løsninger på Open Source på Linux med et sterkt fellesskap.
Profilen til taleren Alexander Sinchikov .
er en konferanse om integrering av utvikling, testing og drift for profesjonelle av profesjonelle. Det er derfor prosjektet Alexander snakket om, er realisert og fungerer, og på dagen for presentasjonen ble det gjennomført to vellykkede lanseringer. På 27. og 28. mai vil det være enda flere slike caser fra praktikere. Det er fortsatt mulig å hoppe på den siste vognen og eller ta deg tid til å billetter. Vi sees i Skolkovo!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish