

Frem til nylig har omkring 50 TB med data blitt behandlet i sanntid i Odnoklassniki, lagret i SQL Server. For så mye data er det nesten umulig å sikre rask og pålitelig, samt feiltolerant tilgang til datasenteret ved hjelp av SQL-databaser. Vanligvis brukes en av NoSQL-lagringene i slike tilfeller, men ikke alt kan flyttes til NoSQL: enkelte entiteter krever garantier for ACID-transaksjoner.
Dette førte oss til å bruke et NewSQL-lagringssystem, altså en database som tilbyr feiltoleranse, skalerbarhet og ytelsen til NoSQL-systemer, samtidig som den opprettholder de kjente ACID-garantiene fra klassiske systemer. Det finnes få fungerende industrielle systemer av denne nye klassen, så vi implementerte et lignende system selv og tok det i drift.
Hvordan dette fungerer og hva vi fikk til – les mer under.
I dag er den månedlige publikum på «Odnoklassniki» over 70 millioner unike besøkende. Vi sosiale mediene i verden, og blant de tyve nettstedene der brukerne tilbringer mest tid. Infrastrukturene til «OK» håndterer svært høye belastninger: over en million HTTP-forespørsel/s på frontene. Deler av serverparken, som består av mer enn 8000 enheter, er plassert nært hverandre - i fire datasilos i Moskva, noe som muliggjør en nettverksforsinkelse på mindre enn 1 ms mellom dem.
Vi har brukt Cassandra siden 2010, fra versjon 0.6. I dag er flere titalls klynger i drift. Den raskeste klyngen behandler over 4 millioner operasjoner per sekund, og den største lagrer 260 TB.
Imidlertid er alt dette vanlige NoSQL-klynger som brukes til lagring av data. Vi ønsket imidlertid å erstatte det primære konsistente lageret, Microsoft SQL Server, som har blitt brukt siden «Odnoklassniki» ble grunnlagt. Lagringssystemet besto av mer enn 300 SQL Server Standard Edition-maskiner, som inneholdt 50 TB med data – forretningsentiteter. Disse dataene modifiseres innenfor ACID-transaksjoner og krever .
For distribusjon av data mellom nodene i SQL Server brukte vi både vertikal og horisontal (sharding). Historisk har vi brukt et enkelt datashardingskjema: hver entitet ble tildelt en token — en funksjon av entitetens ID. Entiteter med samme token ble plassert på en SQL-server. Master-detail-forhold ble implementert slik at tokenene for hoved- og underpost alltid stemte overens og befant seg på samme server. I sosiale nettverk genereres nesten alle poster på vegne av brukeren — dermed lagres alle brukerdata innenfor et funksjonelt subsystem på én server. Det vil si at i forretningstransaksjoner deltok nesten alltid tabeller fra én SQL-server, noe som gjorde det mulig å sikre datakonsistens ved hjelp av lokale ACID-transaksjoner, uten behov for å bruke distribuerte ACID-transaksjoner.
Takket være sharding og for å øke hastigheten på SQL:
- Vi bruker ikke fremmednøkkelbegrensninger, siden entitetens ID kan befinne seg på en annen server ved sharding.
- Vi bruker ikke lagrede prosedyrer og triggere på grunn av ekstra belastning på database-CPU-en.
- Vi bruker ikke JOINs på grunn av alt det ovennevnte og mange tilfeldige disklesinger.
- Utenfor transaksjoner for å redusere dødlås bruker vi isolasjonsnivået Read Uncommitted.
- Vi utfører kun korte transaksjoner (i gjennomsnitt kortere enn 100 ms).
- Vi bruker ikke flerader UPDATE og DELETE på grunn av mange dødlåser — vi oppdaterer kun én post om gangen.
- Forespørslene utføres alltid kun etter indekser — en forespørsel med et fullt tabellvisningsplan betyr overbelastning av databasen og dens svikt.
Disse trinnene har gjort det mulig å presse nesten maksimal ytelse ut av SQL-serverne. Imidlertid ble problemene stadig flere. La oss se på dem.
Problemer med SQL
- Siden vi brukte egenutviklet sharding, ble tilførsel av nye shards utført manuelt av administratorene. I hele denne perioden betjente ikke skalerbare datakopier forespørslene.
- Etter hvert som antallet poster i tabellen øker, reduseres hastigheten for innsetting og modifikasjon; når man legger til indekser til eksisterende tabeller, synker hastigheten drastisk, og opprettelse og gjenoppretting av indekser skjer med nedetid.
- Tilstedeværelsen av et lite antall Windows-servere for SQL Server i produksjon kompliserer håndteringen av infrastrukturen.
Men det største problemet er —
Feiltoleranse
En klassisk SQL-server har dårlig feiloverføringsevne. La oss si at du bare har én database-server, og den feiler hvert tredje år. I løpet av denne tiden fungerer ikke nettstedet i 20 minutter, noe som er akseptabelt. Men hvis du har 64 servere, vil nettstedet ikke fungere hver tredje uke. Og hvis du har 200 servere, vil nettstedet ikke fungere hver uke. Dette er et problem.
Hva kan gjøres for å forbedre feiloverføringsevnen til en SQL-server? Wikipedia foreslår at vi bygger : der det finnes en duplikat i tilfelle en av komponentene feiler.
Dette krever en park av kostbart utstyr: omfattende duplisering, fiberoptikk, felles lagring, og det å inkludere reserver fungerer usikkert: rundt 10 % av oppstartene ender med feil i den reserve noden i rækken bakerst.
Men den største ulempen med en slik høytilgjengelig klynge er null tilgjengelighet ved svikt i datasenteret den er plassert i. «Odnoklassniki» har fire datasentre, og vi må sikre drift under total havari i ett av dem.
For dette kunne man bruke replikering, innebygd i SQL Server. Denne løsningen er betydelig dyrere på grunn av programvarekostnaden og sliter med godt kjente problemer med replikering – uforutsigbare forsinkelser i transaksjoner ved synkron replikering og forsinkelser i anvendelsen av replikeringene (og dermed tapte modifikasjoner) ved asynkron. Det underforståtte gjør dette alternativet helt ubrukelig for oss.
Alle disse problemene krevde en radikal løsning, og vi begynte en detaljert analyse av dem. Her må vi bli kjent med hva SQL Server først og fremst gjør – transaksjoner.
En enkel transaksjon
La oss se på den enkleste transaksjonen, fra et praktisk SQL-programmerers perspektiv: legge til et bilde i et album. Album og bilder lagres i ulike tabeller. Et album har en teller for offentlige bilder. Da deles en slik transaksjon opp i følgende trinn:
- Vi låser albumet med en nøkkel.
- Vi oppretter en post i bildets tabell.
- Hvis bildet har offentlig status, øker vi tellingen av offentlige bilder i albumet, oppdaterer posten og forplikter transaksjonen.
Eller i form av pseudokode:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vi ser at det mest vanlige scenariet for forretningstransaksjoner er å lese data fra databasen inn i applikasjonsserverens minne, gjøre noen endringer og lagre de nye verdiene tilbake i databasen. Vanligvis i en slik transaksjon oppdaterer vi flere entiteter, flere tabeller.
Når transaksjonen utføres, kan det skje konkurrerende modifikasjoner av de samme dataene fra et annet system. For eksempel kan Antispam vurdere en bruker som mistenkelig, og derfor skal alle bilder til den brukeren ikke lenger være offentlige, de må sendes til moderering, noe som betyr at photo.status må endres til en annen verdi og de tilhørende tellerne må justeres. Det er åpenbart at hvis denne operasjonen skjer uten garantier for atomisk anvendelse og isolasjon av konkurrerende modifikasjoner, som i , vil ikke resultatet bli det som er nødvendig - enten vil foto-telleren vise en feil verdi, eller ikke alle bilder vil bli sendt til moderering.
Det er skrevet mye liknende kode, som manipulerer forskjellige forretningsenheter innenfor en enkelt transaksjon, gjennom tiden til Eksperimentene. Basert på erfaringene fra migrering til NoSQL med vet vi at de største utfordringene (og tidskostnadene) kommer fra behovet for å utvikle kode som opprettholder datakonsistens. Derfor var det viktigste kravet til det nye lagringssystemet å sikre ekte ACID-transaksjoner for applikasjonslogikken.
Andre, minst like viktige, krav var:
- Ved sentersvikt må både lesing og skriving til det nye lagringssystemet være tilgjengelig.
- Opprettholde den nåværende hastigheten for utvikling. Det vil si at arbeidet med det nye lagringssystemet ikke skal kreve mye mer kode, og det skal ikke være behov for å skrive noe nytt i lagringssystemet, utvikle algoritmer for konfliktløsning, opprettholde sekundære indekser osv.
- Hastigheten på det nye lagringssystemet må være tilstrekkelig høy, både ved datauthenting og ved behandling av transaksjoner, noe som effektivt betyr at akademisk strenge, universelle, men langsomme løsninger, som for eksempel .
- Automatisk skalering i sanntid.
- Bruken av vanlige, billige servere, uten behov for å kjøpe eksotisk maskinvare.
- Muligheten for utvikling av lagringssystemet av selskapets utviklere. Med andre ord, prioriteten ble gitt til egne eller åpne løsninger, helst på Java.
Løsninger, løsninger
Ved å analysere mulige løsninger kom vi til to mulige valg av arkitektur:
Den første er å ta en hvilken som helst SQL-server og implementere nødvendig feilresistens, skaleringsmekanisme, feilresistent klynge, konfliktløsing og distribuerte, pålitelige og hurtige ACID-transaksjoner. Vi vurderte dette alternativet som ganske uvanlig og arbeidskrevende.
Det andre alternativet er å ta et ferdig NoSQL-lager med implementert skalerbarhet, feilresistent klynge, konfliktløsing og implementere transaksjoner og SQL selv. Ved første øyekast virker selv oppgaven med å implementere SQL, for ikke å snakke om ACID-transaksjoner, som en oppgave for flere år. Men så skjønte vi at settet av SQL-muligheter som vi bruker i praksis, er langt fra ANSI SQL så langt som er langt fra ANSI SQL. Ved å se nærmere på CQL, innså vi at det er nært det vi trenger.
Cassandra og CQL
Så hva er det interessante med Cassandra, hvilke muligheter har den?
For det første kan du opprette tabeller som støtter ulike datatyper, og du kan gjøre SELECT eller UPDATE basert på primærnøkkelen.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
For å sikre datakonsistens mellom replikaene, bruker Cassandra I det enkleste tilfellet betyr dette at når man setter opp tre repliker av samme rad på forskjellige noder i klyngen, anses skriveoperasjonen som vellykket hvis flertallet av nodene (dvs. to av tre) har bekreftet suksessen med denne skriveoperasjonen. Raddataene anses som konsistente hvis flertallet av nodene ble forespurt under lesingen og bekreftet dem. Dermed garanterer tilstedeværelsen av tre repliker fullstendig og umiddelbar datakonsistens ved feil av en node. Denne tilnærmingen har gjort det mulig for oss å implementere et enda mer pålitelig system: alltid sende forespørslene til alle tre repliker, og vente på svar fra de to raskeste. Det forsinkede svaret fra den tredje replikaen blir i slike tilfeller forkastet. Den forsinkede noden kan ha alvorlige problemer — forsinkelser, søppelinnsamling i JVM, direkte minnefrigivelse i linux-kjernen, maskinvarefeil, nettverksavbrudd. Men dette påvirker ikke klientoperasjonen eller dataene på noen måte.
Tilnærmingen der vi henvender oss til tre noder og får svar fra to, kalles : forespørselen til de ekstra replikaene sendes før de faktisk 'faller av'.
En annen fordel med Cassandra er Batchlog — en mekanisme som garanterer enten fullstendig anvendelse eller fullstendig annullering av pakken med endringer du gjør. Dette lar oss løse A i ACID — atomisitet rett ut av boksen.
Det som er nærmest transaksjoner i Cassandra er det som kalles, men de er langt fra 'ekte' ACID-transaksjoner: i realiteten er dette muligheten til å gjøre på dataene til kun én oppføring, ved hjelp av konsensus via den tunge protokollen Paxos. Derfor er hastigheten på slike transaksjoner ikke høy.
Hva vi manglet i Cassandra
Så vi måtte implementere ekte ACID-transaksjoner i Cassandra. Med dem kunne vi lett realisere to andre praktiske funksjoner fra klassiske DBMS: konsistente raske indekser, som ville gjøre det mulig for oss å hente data ikke bare etter primærnøkkelen, og en vanlig generator av monotont autoinkrementerende ID-er.
C*One
Så ble en ny DBMS født, C*Onesom består av tre typer servernoder:
- Lager — (nesten) standard Cassandra-servere ansvarlige for lagring av data på lokale disker. Etter hvert som belastningen og datamengden øker, kan antallet enkelt skaleres opp til titalls og hundrevis.
- Transaksjonskoordinatorer — sørger for gjennomføring av transaksjoner.
- Kunder — applikasjonsservere som utfører forretningsoperasjoner og initierer transaksjoner. Det kan være tusenvis av slike kunder.
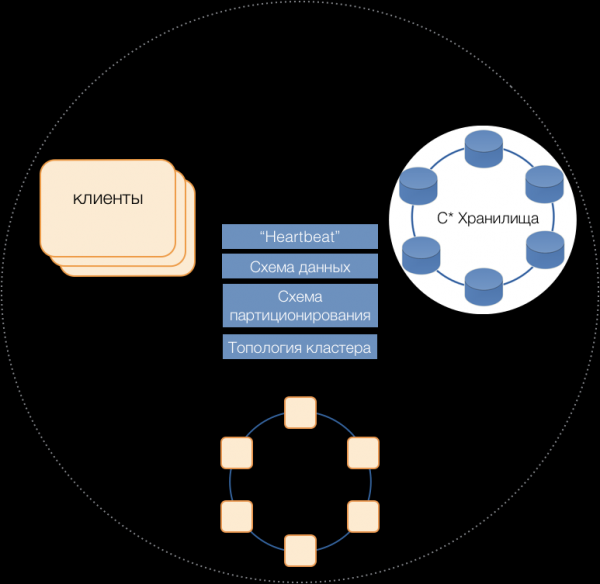
Servere av alle typer er en del av et felles klynge, bruker den interne meldingsprotokollen Cassandra for å kommunisere med hverandre og for å dele klyngeinformasjon. Gjennom Heartbeat får serverne informasjon om gjensidige fiaskoer, opprettholder en felles dataskjema — tabeller, deres struktur og replikasjon; partisjoneringsskjema, topologi av klyngen, osv.
Kunder
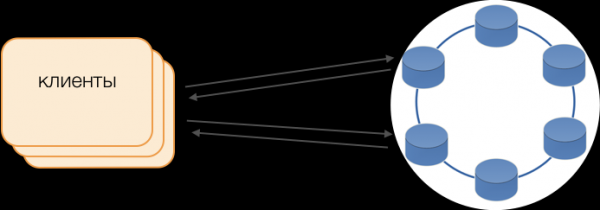
I stedet for standarddrivere brukes Fat Client-modus. En slik node lagrer ikke data, men kan fungere som koordinator for forespørselene, det vil si at klienten selv utfører koordinatorfunksjonen for forespørslene sine: spør replikene i lagringssystemet og løser konflikter. Dette er ikke bare mer pålitelig og raskere enn den standarddriveren som krever kommunikasjon med en ekstern koordinator, men det muliggjør også administrasjon av forespørselsoverføring. Utenfor en åpen transaksjon hos klienten sendes forespørslene til lagringene. Hvis klienten derimot har åpnet en transaksjon, sendes alle forespørslene innenfor transaksjonen til transaksjonskoordinatoren.
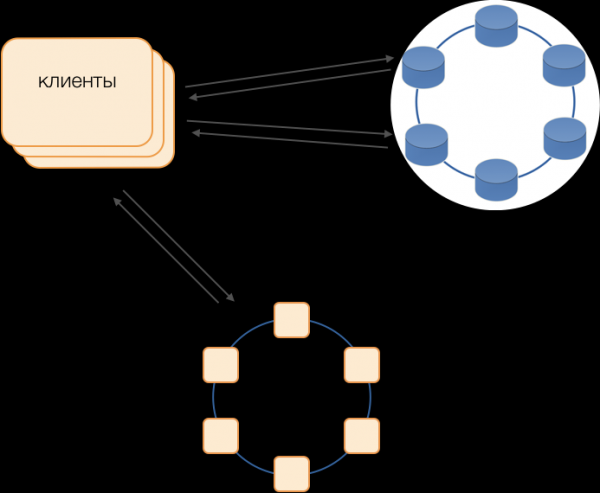
Transaksjonskoordinator C*One
Koordinator — det vi har implementert for C*One fra bunnen av. Han er ansvarlig for administrasjon av transaksjoner, låser og rekkefølge av anvendelse av transaksjoner.
For hver håndtert transaksjon genererer koordinatoren et tidsstempel: hvert påfølgende er større enn det for den foregående transaksjonen. Siden konfliktløsningen i Cassandra-systemet er basert på tidsstempler (blant to konfliktfylte poster anses den som aktuell med det senere tidsstempelet), vil konflikten alltid bli løst til fordel for den påfølgende transaksjonen. Dermed har vi implementert — en billig måte å løse konflikter i et distribuert system.
Låser
For å sikre isolasjon valgte vi den enkleste metoden — pessimistiske låser basert på primærnøkkelen til oppføringen. Med andre ord, i transaksjonen må posten først låses, deretter leses, modifiseres og lagres. Først etter en vellykket commit kan posten låses opp, slik at konkurrrerende transaksjoner kan bruke den.
Implementering av en slik låsing er enkel i et ufordelt miljø. I et fordelt system er det to hovedveier: enten implementere en distribuert låsing i klyngen, eller fordele transaksjoner slik at transaksjoner som involverer en enkelt post alltid håndteres av den samme koordinatoren.
Siden dataene i vårt tilfelle allerede er fordelt på grupper av lokale transaksjoner i SQL, ble det besluttet å tildele koordinatorene grupper av lokale transaksjoner: én koordinator håndterer alle transaksjoner med en token fra 0 til 9, den andre - fra 10 til 19, og så videre. Resultatet er at hver av koordinatorinstansene blir mester for sin gruppe av transaksjoner.
Da kan låsene implementeres i form av en enkel HashMap i minnet til koordinatoren.
Koordinatorfeil
Siden én koordinator utelukkende betjener en gruppe transaksjoner, er det avgjørende å raskt fastslå om den har sviktet, slik at gjenopptakelsen av transaksjonen kan skje innen tidsfristen. For å oppnå dette raskt og pålitelig, har vi anvendt en fullstendig koblet kvorum heartbeat-protokoll:
Hver datasenter har minst to koordinatornoder. Regelmessig sender hver koordinator heartbeat-meldinger til de andre koordinatorene for å informere dem om at den fungerer, samt hvilke heartbeat-meldinger fra andre koordinatorer i klyngen den sist mottok.
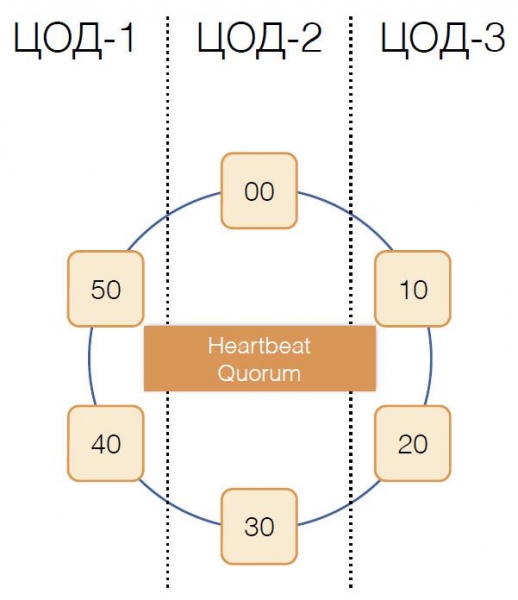
Ved å motta lignende informasjon fra de andre koordinatorene i sine heartbeat-meldinger, bestemmer hver koordinator hvilke noder i klyngen som fungerer, og hvilke som ikke gjør det, basert på kvorumprinsippet: hvis node X har fått bekreftelse fra flertallet av nodene i klyngen om at meldinger fra node Y er mottatt normalt, fungerer Y. Og omvendt, så snart flertallet rapporterer om tap av meldinger fra node Y, har Y sviktet. Det er interessant at hvis kvorum informerer node X om at den ikke har fått meldinger fra den, vil node X selv anse seg som sviktet.
Heartbeat-meldinger sendes med høy frekvens, omtrent 20 ganger i sekundet, med en periode på 50 ms. I Java er det vanskelig å garantere applikasjonens respons innen 50 ms på grunn av sammenlignbare pauser forårsaket av søppelsamleren. Vi klarte å oppnå en slik respons tid ved å bruke G1-søppelsamler, som gjør det mulig å spesifisere mål for varigheten av GC-pauser. Imidlertid, av og til, sjeldent, overskrider pausesøppelsamlerens tid 50 ms, noe som kan føre til falsk feiloppdagelse. For å unngå dette, varsler ikke koordinatoren om feil på en ekstern node ved tap av den første heartbeat-meldingen fra den, men kun hvis flere meldinger går tapt på rad. På den måten klarte vi å oppnå oppdagelse av feil på koordinatoren innen 200 ms.
Men det er ikke nok å raskt forstå hvilken node som har sluttet å fungere. Det må gjøres noe med det.
Redundans
Den klassiske ordningen innebærer i tilfelle av feil hos master å starte valg av en ny med hjelp av en av algoritmene. Imidlertid har slike algoritmer godt kjente problemer med konvergens over tid og varigheten av selve valgprosessen. Slike ekstra forsinkelser klarte vi å unngå ved å bruke en erstatningsordning for koordinatorer i et fullt sammenkoblet nettverk:
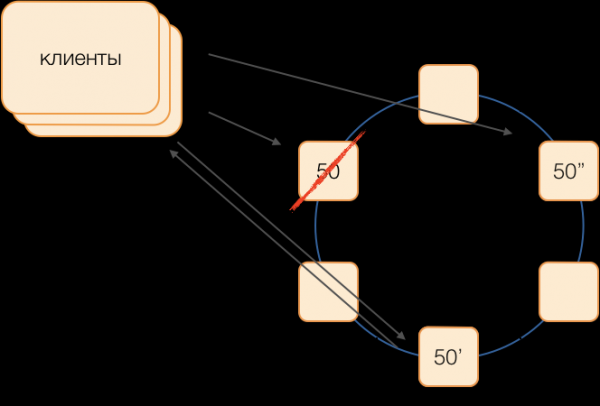
La oss si at vi vil utføre en transaksjon i gruppe 50. Vi definerer på forhånd erstatningsordningen, det vil si hvilke noder som skal utføre transaksjoner for gruppe 50 i tilfelle hovedkoordinatoren feiler. Målet vårt er å opprettholde systemets funksjonalitet ved et datacenters svikt. Vi definerer at det første reserve vil være en node fra et annet datacenter, og det andre reserve vil være en node fra det tredje. Denne ordningen velges en gang og endres ikke så lenge klustertopologien ikke endres, det vil si så lenge det ikke legges til nye noder i den (noe som skjer svært sjeldent). Rangeringen for valg av en ny aktiv master ved feil hos den gamle vil alltid være slik: den aktive masteren blir det første reserve, og hvis det også har sluttet å fungere – det andre reserve.
Denne ordningen er mer pålitelig enn den universelle algoritmen, ettersom det er tilstrekkelig å fastslå faktum om feilen til den gamle for å aktivere den nye masteren.
Men klientene forstår ikke hvilken av mesterne som jobber akkurat nå? På 50 ms er det umulig å sende informasjon til tusenvis av kunder. Det kan oppstå en situasjon der kunden sender en forespørsel om å åpne en transaksjon, uten å vite at den mesteren allerede ikke fungerer, og forespørselen vil henge på time-out. For å unngå dette, sender kundene spekulativt forespørselen om å åpne transaksjonen til gruppens mester og begge hans reservemestrene, men det vil bare være den aktive mesteren som svarer på denne forespørselen i øyeblikket. All videre kommunikasjon i forbindelse med transaksjonen vil kunden ha bare med den aktive mesteren.
Reserve-mestrene plasserer forespørslene de mottar om andre mestres transaksjoner i køen for ikke-fødte transaksjoner, hvor de oppbevares en stund. Hvis den aktive mesteren dør, så behandler den nye mesteren forespørslene om å åpne transaksjoner fra sin egen kø og svarer kunden. Hvis kunden allerede har klart å åpne en transaksjon med den gamle mesteren, så ignoreres det andre svaret (og denne transaksjonen vil åpenbart ikke fullføres og må gjentas av kunden).
Hvordan fungerer en transaksjon
La oss si at kunden har sendt en forespørsel til koordinatoren om å åpne en transaksjon for en bestemt enhet med en viss primærnøkkel. Koordinatoren låser denne enheten og plasserer den i blokkeringstabellen i minnet. Om nødvendig leser koordinatoren denne enheten fra lagringen og lagrer de mottatte dataene i transaksjonens tilstand i koordinatorens minne.
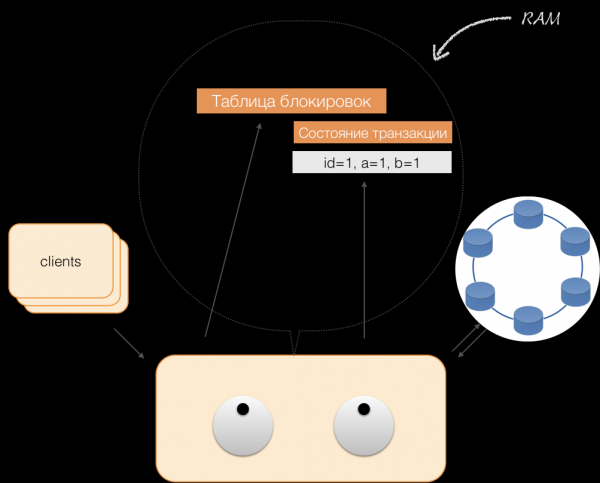
Når kunden ønsker å endre dataene i transaksjonen, sender han en forespørsel til koordinatoren om å modifisere enheten, som da plasserer de nye dataene i tabellen for transaksjonsstatus i minnet. På dette punktet er oppførselen fullført – ingen skriving til lagringen finner sted.
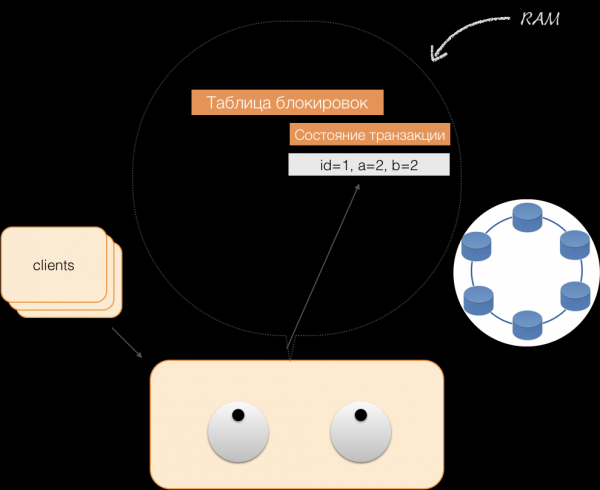
Når kunden anmoder om egne endrede data innenfor en aktiv transaksjon, handler koordinatoren slik:
- hvis ID allerede finnes i transaksjonen, tas dataene fra minnet;
- hvis ID ikke finnes i minnet, leses de manglende dataene fra nodene i lagringen, kombineres med de allerede tilgjengelige i minnet, og resultatet returneres til kunden.
Dermed kan kunden lese sine egne endringer, mens andre kunder ikke ser disse endringene, fordi de bare lagres i koordinatorens minne; i nodene i Cassandra finnes de ikke ennå.
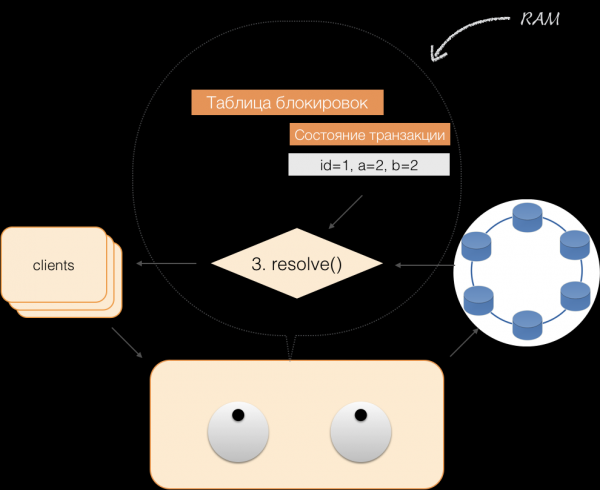
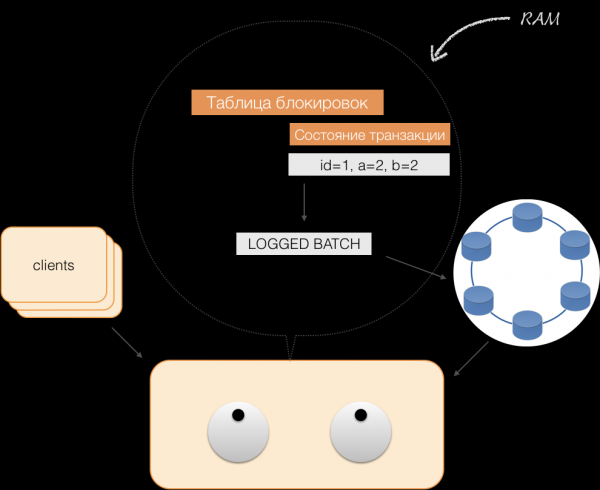
Når en klient sender en commit, blir tilstanden som har vært i minnet hos tjenesten, lagret av koordinatoren i logged batch, og i form av logged batch sendes den til Cassandra-lagerne. Lagringene gjør alt nødvendig for at denne pakken skal bli atomisk (fullstendig) anvendt, og returnerer et svar til koordinatoren, som deretter frigjør låser og bekrefter transaksjonens suksess til klienten.
Og for å rulle tilbake trenger koordinatoren bare å frigjøre minnet som ble brukt til transaksjonens tilstand.
Som et resultat av de ovennevnte forbedringene har vi implementert ACID-prinsippene:
- Atomisitet. Dette er en garanti for at ingen transaksjoner vil bli delvis bekreftet i systemet; enten blir alle deloperasjoner utført, eller ingen av dem. I vårt tilfelle overholdes dette prinsippet ved hjelp av logged batch i Cassandra.
- Konsistens. Hver vellykket transaksjon registrerer per definisjon bare gyldige resultater. Hvis det etter åpning av en transaksjon og utførelse av deler av operasjonene oppdages at resultatet er ugyldig, utføres en rulling tilbake.
- Isolasjon. Når en transaksjon utføres, må parallelle transaksjoner ikke påvirke dens resultat. Konkurrerende transaksjoner er isolert ved hjelp av pessimistiske låser på koordinatoren. For leseoperasjoner utenfor transaksjonen overholdes isolasjonsprinsippet på nivået Read Committed.
- Motstandskraft. Uavhengig av problemer på lavere nivåer — strømbrudd eller maskinvarefeil — må endringene gjort av en vellykket avsluttet transaksjon forbli lagret etter at funksjonen er gjenopptatt.
Lesing etter indekser
La oss ta en enkel tabell:
CREATE TABLE photos (
id bigint primary key,
eier bigint,
modifisert timestamp,
…)
Den har en ID (primærnøkkel), eier og endringsdato. Vi må gjøre en veldig enkel forespørsel — velge data etter eier med endringsdato "de siste 24 timer".
SELECT *
WHERE owner=?
AND modified>?
For at en slik forespørsel skal kjøre raskt, må vi i en klassisk SQL-database bygge et indeks på kolonnene (owner, modified). Dette kan vi gjøre ganske enkelt, siden vi nå har garantier for ACID!
Indekser i C*One
Det finnes en original tabell med bilder, hvor ID-en til posten er primærnøkkelen.
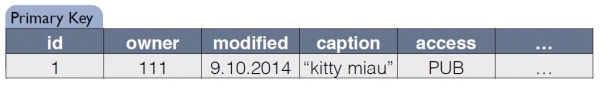
For indeksen lager C*One en ny tabell som er en kopi av originalen. Nøkkelen samsvarer med indeksuttrykket, samtidig som den også inkluderer den primære nøkkelen fra originaltabellen:
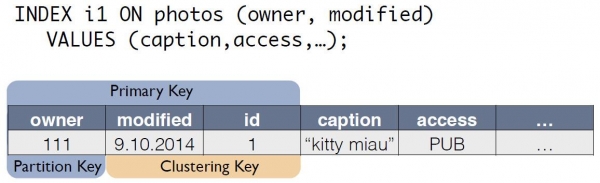
Nå kan spørringen "eier for de siste 24 timene" skrives om som select fra en annen tabell:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Konsistensen til den opprinnelige tabellen photos og indekstabellen i1 opprettholdes automatisk av koordinatoren. Ut fra bare dataskjemaet, når det gjøres endringer, genererer og husker koordinatoren endringer ikke bare i hovedtabellen, men også endringer i kopiene. Ingen ekstra handlinger med indeks-tabellen utføres, logger leses ikke, låsing brukes ikke. Det vil si at tillegg av indekser nesten ikke bruker ressurser og har praktisk talt ingen innvirkning på hastigheten av modifikasjoner.
Med ACID klarte vi å implementere indekser "som i SQL". De har konsistens, kan skaleres, jobber raskt, kan være sammensatte og integrert i CQL-spørrespråket. For å støtte indekser er det ikke nødvendig med endringer i anvendt kode. Alt er enkelt, som i SQL. Og det viktigste, indeksene påvirker ikke hastigheten på utførelsen av modifikasjoner i transaksjons tabellen.
Hva fikk vi?
Vi utviklet C*One for tre år siden og satte det i produksjon.
Hva fikk vi ut av dette? La oss vurdere det ved hjelp av delsystemet for behandling og lagring av bilder, en av de viktigste datatypene i sosiale nettverk. Det handler ikke om selve bildene, men om all slags metadata. Nå er det omtrent 20 milliarder slike poster i "Odnoklassniki", systemet håndterer 80 000 lesespørringer i sekundet, opptil 8 000 ACID-transaksjoner i sekundet knyttet til datamodifikasjoner.
Da vi brukte SQL med replication factor = 1 (men i RAID 10), ble metadataene om bildene lagret på en høyt tilgjengelig klynge bestående av 32 maskiner med Microsoft SQL Server (pluss 11 backup-maskiner). Det ble også avsatt 10 servere for å lagre sikkerhetskopier. Totalt 50 kostbare maskiner. Systemet fungerte med nominell belastning, uten margin.
Etter migrering til det nye systemet fikk vi replication factor = 3 — en kopi i hvert datasenter. Systemet består av 63 Cassandra-lagringsnoder og 6 koordinatormaskiner, totalt 69 servere. Disse maskinene er imidlertid betydelig billigere, den totale kostnaden er omtrent 30 % av kostnaden ved SQL-systemet. Samtidig holdes belastningen på nivået 30 %.
Med innføringen av C*One har både forsinkelser redusert: i SQL tok skriveoperasjonen omtrent 4,5 ms. I C*One — omtrent 1,6 ms. Gjennomsnittlig transaksjonstid er mindre enn 40 ms, commiten utføres på 2 ms, lese- og skrivevarigheten er i gjennomsnitt 2 ms. 99. percentil er bare 3-3,1 ms, antall tidsavbrudd har redusert med 100 ganger — alt takket være det brede bruken av spekulasjoner.
Per nå er det meste av SQL Server-nodene tatt ut av drift, nye produkter utvikles kun ved bruk av C*One. Vi har tilpasset C*One for drift i vårt sky. , noe som har gjort det mulig å akselerere opprettelsen av nye klynger, forenkle konfigurasjonen og automatisere driften. Uten kildekoden ville dette vært betydelig mer komplisert og klønete.
Akkurat nå jobber vi med å flytte andre datalagre til skyen — men det er en helt annen historie.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish