

Oppdateringsprosessen for Kubernetes-klyngen din
Når du bruker en Kubernetes-klynge, kan det bli nødvendig å oppdatere de aktive nodene på et senere tidspunkt. Dette kan inkludere oppdateringer av pakker, kjerneoppdateringer eller distribusjon av nye bildeservere. I Kubernetes-termer kalles dette .
Dette innlegget er en del av en serie på 4 innlegg:
- Dette innlegget.
- Korrekt nedstenging av pods i en Kubernetes-klynge
- Forsinket nedstenging av en pod ved fjerning
- Hvordan unngå nedetid i Kubernetes-klyngen ved hjelp av PodDisruptionBudgets
(merk. overs. oversettelser av de andre artiklene i serien kan forventes snart)
I denne artikkelen vil vi beskrive alle verktøyene som Kubernetes tilbyr for å oppnå null nedetid for nodene som kjører i klyngen din.
Definere problemet
I begynnelsen vil vi bruke en naiv tilnærming for å identifisere problemer og vurdere potensielle risikoer ved denne tilnærmingen, og samle kunnskap for å løse hvert av problemene vi møter gjennom hele serien. Som et resultat vil vi få en konfigurasjon som bruker livssyklus-hooks, readiness probes og Pod disruption budgets for å oppnå vår null nedetid.
For å begynne vår reise, la oss ta et konkret eksempel. Anta at vi har en Kubernetes-klynge med to noder, der det kjører en applikasjon med to pods, som er bak Service:
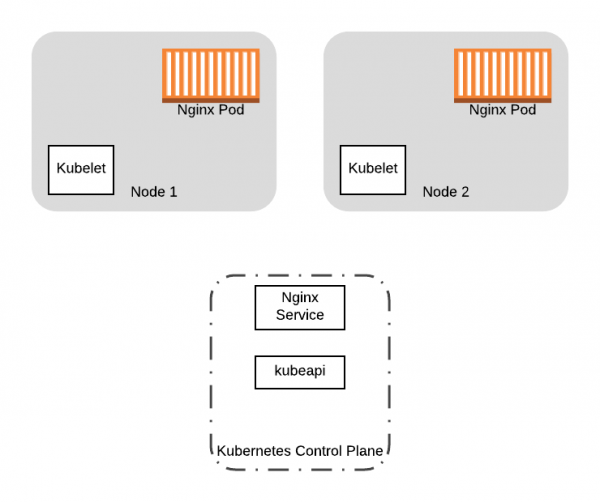
La oss starte med to pods med Nginx og en tjeneste som kjører på de to nodene i Kubernetes-klyngen vår.
Vi ønsker å oppdatere kjernen på de to arbeidsnodene i klyngen vår. Hvordan skal vi gjøre dette? En enkel løsning ville vært å laste opp nye noder med oppdatert konfigurasjon, og så slå av de gamle nodene samtidig som de nye startes opp. Selv om dette vil fungere, vil det være flere problemer med en slik tilnærming:
- Når du slår av de gamle nodene, vil de kjørende pods også bli slått av. Hva om pods må ryddes for å kunne ta en korrekt frakobling? Virtuell maskinvare kan hende ikke venter på at ryddeprosessen skal fullføres.
- Hva om du slår av alle nodene samtidig? Du vil oppleve betydelig nedetid mens pods flyttes til de nye nodene.
Vi trenger en korrekt måte å migrere pod-er fra gamle noder, samtidig som vi må være sikre på at ingen av arbeidsprosessene våre kjører mens vi gjør endringer for noden. Eller når vi gjør en full erstatning av klyngen, som i eksemplet (dvs. vi erstatter VM-bilder), ønsker vi å flytte aktive applikasjoner fra gamle noder til nye. I begge tilfeller ønsker vi å forhindre planlegging av nye pod-er på gamle noder, og deretter fjerne alle aktive pod-er fra dem. For å oppnå disse målene kan vi bruke kommandoen kubectl drain.
Omlokalisering av alle pod-er fra noden
Drain-operasjonen tillater omskifting av alle pod-er fra noden. I løpet av drain-prosessen blir noden merket som unschedulable (flagg i kubectl. Spesifiser nøkkelen og verdien, og bruk deretter en taint som). Dette forhindrer forekomsten av nye pod-er på den. Deretter begynner drain å fjerne pod-er fra noden, og avslutter kjørende containere som for tiden er aktive på noden ved å sende signal TERM til containerne i pod-en.
Selv om kubectl drain det takler fjerningen av pod-er godt, er det to andre faktorer som kan føre til at drain-operasjonen mislykkes:
- Applikasjonen din må kunne avslutte korrekt ved signal
TERMsending. Når pod-er fjernes, sender Kubernetes et signalTERMtil containerne og venter på at de skal stoppe i en angitt tidsperiode, hvoretter, hvis de ikke stopper, avsluttes de tvangsvis. Uansett, hvis containeren din ikke reagerer på signalet som den skal, kan du fortsatt slå av pod-ene usystematisk hvis de for øyeblikket er aktive (f.eks. en transaksjon i DB pågår). - Du mister alle pod-er som inneholder applikasjonen din. Den kan være utilgjengelig på tidspunktet for oppstart av nye containere på de nye nodene, eller hvis pod-ene dine er rullet ut uten controllere, kan de kanskje ikke restarte i det hele tatt.
Unngå driftsstans
For å minimere nedetid fra frivillig forstyrrelse, som for eksempel fra drain-operasjonen for noden, gir Kubernetes følgende alternativer for feilbehandling:
I de andre delene av syklusen vil vi bruke disse Kubernetes-funksjonene for å dempe konsekvensene av pod-flytting. For å gjøre hovedpoenget lettere å følge, vil vi bruke vårt ovenstående eksempel med følgende ressurskonfigurasjon:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Denne konfigurasjonen er et minimumseksempel Deployment, som styrer nginx-poder i klyngen. I tillegg beskriver konfigurasjonen ressursen Service, som kan brukes til å få tilgang til nginx-poder i klyngen.
Gjennom hele syklusen vil vi iterativt utvide denne konfigurasjonen, slik at den til slutt inkluderer alle mulighetene Kubernetes gir for å redusere nedetid.
For å få en fullt implementert og testet versjon av oppdateringer for Kubernetes-klyngen for null nedetid på AWS og andre ressurser, besøk .
Les også andre artikler i bloggen vår:
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish