

Innledning til operativsystemer
Hei, Habr! Jeg ønsker å presentere for deg en serie med oversatte artikler fra en litteratur som jeg synes er interessant — OSTEP. I dette materialet blir arbeidet til UNIX-lignende operativsystemer behandlet temmelig grundig, nemlig arbeidet med prosesser, forskjellige planleggere, minne og andre lignende komponenter som utgjør et moderne OS. Den originale teksten til alt materialet kan du se her . Vennligst merk at oversettelsen er gjort uprofesjonelt (temmelig fritt), men jeg håper jeg har bevart den generelle meningen.
Laboratoriearbeid knyttet til emnet kan finnes her:
Andre deler:
Og du kan også sjekke kanalen min på =)
Planlegging: Multi-Level Feedback Queue
I denne forelesningen skal vi snakke om problemene med å utvikle en av de mest kjente tilnærmingene til
planlegging, som kalles Multi-Level Feedback Queue (MLFQ). Den første beskrivelsen av MLFQ-planleggeren ble gitt i 1962 av Fernando J. Corbató i et system kalt
Compatible Time-Sharing System (CTSS). Disse arbeidene (inkludert senere arbeider om
Multics) ble senere nominert til Turing Award. Planleggeren ble
senere forbedret og fikk en form som kan sees i
noen moderne systemer.
MLFQ-algoritmen prøver å løse to grunnleggende overlappende problemer.
For det første, den prøver å optimalisere omdreiningstiden, som, som vi så i forrige forelesning, optimaliseres ved å kjøre de mest
korte oppgavene først i køen. Imidlertid vet ikke operativsystemet hvor lenge en bestemt prosess vil kjøre, og dette
er nødvendig kunnskap for SJF- og STCF-algoritmene. For det andre, MLFQ prøver
å gjøre systemet responsivt for brukerne (for eksempel de som sitter og
stirrer på skjermen i påvente av at oppgaven skal fullføres) og dermed minimere tiden
for respons. Dessverre reduserer algoritmer som RR responstid, men har en svært
dårlig effekt på omdreiningstid-metrikken. Her er vårt problem: Hvordan designe
en planlegger som vil møte våre krav og samtidig ikke vite noe om
karakteren til prosessen, generelt? Hvordan kan planleggeren lære karakteristikkene til oppgavene,
som den kjører og dermed ta bedre avgjørelser om planlegging?
Essensen av problemet: Hvordan planlegge oppgaveinnsetting uten perfekt kunnskap?
Hvordan utvikle en planlegger som både minimerer responstiden
for interaktive oppgaver og samtidig minimerer omdreiningstiden uten forhånds
kunnskap om oppgavens kjøretid?
Merk: Lærer av tidligere hendelser
MLFQ-køen er et utmerket eksempel på et system som lærer av
tidligere hendelser for å forutsi fremtiden. Slike tilnærminger finnes ofte
i operativsystemer (og mange andre områder i datavitenskap, inkludert grener av
prediksjon innen maskinvare og cache-algoritmer). Slike tilnærminger
er effektive når oppgavene har atferdsfaser og dermed er forutsigbare.
Men med slik teknologi må man være forsiktig, fordi prediksjonene lett
kan vise seg å være feil og føre systemet til å ta dårligere beslutninger enn
det ville vært uten noen kunnskap i det hele tatt.
MLFQ: Grunnleggende Regler
La oss se på de grunnleggende reglene for MLFQ-algoritmen. Og selv om det finnes flere
implementeringer av denne algoritmen, er de grunnleggende tilnærmingene like.
I den implementeringen vi skal se på, vil MLFQ ha flere
separate køer, hver med ulik prioritet. Til enhver tid,
vil oppgaven som er klar til å kjøre befinne seg i en av køene. MLFQ bruker prioriteringer
for å avgjøre hvilken oppgave som skal kjøres, det vil si at oppgaven med høyere
prioritet (oppgaven fra køen med høyest prioritet) vil bli kjørt først.
Uten tvil kan det være mer enn én oppgave i en bestemt kø, slik
at de vil ha lik prioritet. I så fall vil RR-mekanismen
bli brukt for å planlegge kjøring blant disse oppgavene.
Dermed kommer vi til to grunnleggende regler for MLFQ:
Regel 1: Hvis prioritet(A) > Prioritet(B), vil oppgave A bli kjørt (B vil ikke)
- Regel 2: Hvis prioritet(A) = Prioritet(B), A og B kjøres ved bruk av RR
- Basert på det ovenstående, er nøkkelkomponentene for MLFQ-planlegging
prioriteringer. I stedet for å gi en fast prioritet til hver
oppgave, endrer MLFQ prioriteten avhengig av oppført atferd.
For eksempel, hvis en oppgave kontinuerlig gir fra seg arbeid til CPU mens den venter på input fra tastaturet,
vil MLFQ holde prosessens prioritet på et høyt nivå, fordi det er slik
en interaktiv prosess skal fungere. Hvis derimot oppgaven stadig og
intensivt bruker CPU-en over lang tid, vil MLFQ senke dens
prioritet. Dermed vil MLFQ lære oppførselen til prosessene mens de arbeider
og bruke denne oppførselen.
La oss tegne et eksempel på hvordan køene kunne sett ut på et gitt
tidspunkt, og det ville se noe slik ut:
I dette skjemaet er to prosesser A og B i køen med høyest prioritet. Prosess
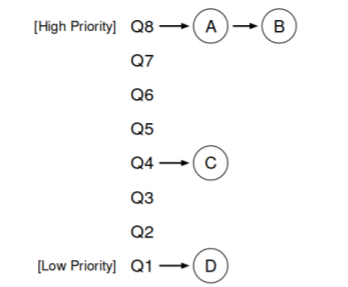
C er et sted i midten, og prosess D er på bunnen av køen. I henhold til beskrivelsene ovenfor
vil MLFQ-planleggeren bare utføre oppgaver med høyest prioritet.
med beskrivingene av MLFQ-algoritmen vil planleggeren utføre oppgaver bare med den høyeste prioriteten
prioritetet i henhold til RR, mens oppgavene C og D ikke vil bli prioritert.
Selvfølgelig vil et statisk øyeblikksbilde ikke gi et fullstendig bilde av hvordan MLFQ fungerer.
Det er viktig å forstå hvordan bildet endres over tid.
Forsøk 1: Hvordan endre prioritet
På dette tidspunktet er det nødvendig å avgjøre hvordan MLFQ vil endre prioriteringsnivået
for oppgaver (og dermed plasseringen av oppgaven i køen) gjennom dens livssyklus. For
dette må man ha arbeidsflyten i bakhodet: et visst antall
interaktive oppgaver med kort arbeidstid (og dermed hyppig frigjøring av
CPU) og noen få lange oppgaver som bruker CPU hele sin arbeidstid, der
respons tiden for slike oppgaver ikke er viktig. Dermed kan man gjøre et første forsøk på
å implementere MLFQ-algoritmen med følgende regler:
- Rule3: Når en oppgave kommer inn i systemet, plasseres den i køen med høyest
- prioritet.
- Rule4a: Hvis oppgaven bruker hele sitt tildelte tidsvindu, reduseres dens
- prioritet.
- Rule4b: Hvis oppgaven frigjør CPU før tidsvinduet er utløpt,
- forblir den med sin opprinnelige prioritet.
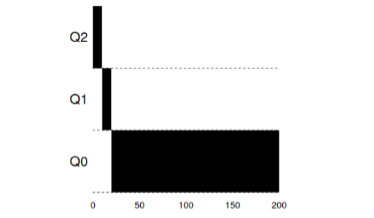
Eksempel 1: En enkelt langvarig oppgave
Som vist i dette eksempelet, blir oppgaven plassert med høyest
prioritet når den kommer inn. Etter et tidsvindu på 10 ms reduseres prosessen i prioritet
av planleggeren. Etter det neste tidsvinduet blir oppgaven endelig redusert til
den laveste prioriteten i systemet, der den blir værende.
Eksempel 2: Ankomst av en kort oppgave
Nå skal vi se et eksempel på hvordan MLFQ vil forsøke å nærme seg SJF. I dette
eksempelet er det to oppgaver: A, som er en langvarig oppgave som kontinuerlig
opptar CPU, og B, som er en kort interaktiv oppgave. Anta at
A allerede har vært i gang en stund da oppgaven B kommer inn.
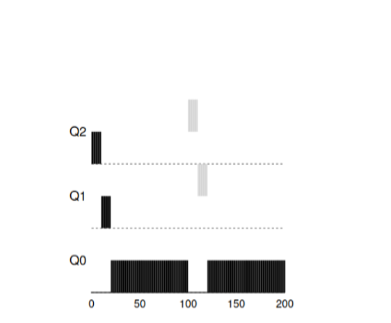
I denne grafen vises resultatene av scenariet. Oppgave A, som enhver oppgave,
som bruker CPU, havnet på bunnen. Oppgave B ankommer ved tid T=100 og vil
bli plassert i køen med høyest prioritet. Siden den bruker mindre tid, vil
den fullføre før den når den siste køen.
Fra dette eksempelet er hovedmålet med algoritmen tydelig: siden algoritmen ikke
kan vite om en oppgave er lang eller kort, antar den først at oppgaven
kort og gir den høyeste prioritet. Hvis dette virkelig er en kort oppgave, så
vil den bli utført raskt, ellers, hvis det er en lang oppgave, vil den bevege seg sakte
i prioritet nedover og snart bevise at det faktisk er en lang oppgave som ikke
krever respons.
Eksempel 3: Hva med inngang-og-utgang?
La oss nå se på et eksempel med inngang-og-utgang. Som påpekt i regel 4b,
hvis prosessen frigjør prosessoren uten å bruke hele prosessortiden sin,
vil den forbli på samme priortet nivå. Intensjonen med denne regelen er ganske enkel
— hvis en interaktiv oppgave utfører mange inngang-og-utgang operasjoner, for eksempel, venter
på brukerens tastetrykk eller museklikk, vil en slik oppgave frigjøre prosessoren
før den tildelte tidsvinduet. Vi ville ikke ønske å senke prioriteten til en slik oppgave,
og dermed vil den forbli på samme nivå.
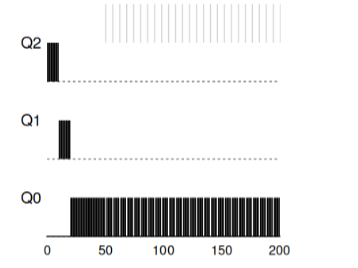
Dette eksemplet viser hvordan algoritmen vil fungere med slike prosesser — interaktiv oppgave B, som bare trenger CPU i 1 ms før den utfører
inngang-og-utgang prosessen, og den lange oppgaven A, som bruker all sin tid på CPU.
MLFQ holder oppgave B med høyest prioritet, siden den stadig frigjør
CPU. Hvis B er en interaktiv oppgave, så har algoritmen i så fall oppnådd
sitt mål om å kjøre interaktive oppgaver raskt.
Problemer med den nåværende MLFQ algoritmen
I de tidligere eksemplene har vi bygget en grunnleggende variant av MLFQ. Og det ser ut til at den
gjør jobben sin godt og rettferdig, fordeler prosessortiden rettferdig mellom
lange oppgaver og lar korte oppgaver eller oppgaver som hyppig bruker
inngang-og-utgang bli behandlet raskt. Dessverre inneholder denne tilnærmingen flere
alvorlige problemer.
For det første, sultproblemet: hvis systemet har mange interaktive
oppgaver, vil de konsumere all prosessortid, og dermed vil ingen lange
oppgaver få muligheten til å kjøre (de sulter).
For det andre, smarte brukere kan skrive programmene sine slik at de
lurer planleggeren. Løven ligger i å gjøre noe som tvinger
planleggeren til å gi prosessen mer prosessortid. Algoritmen som
beskrevet ovenfor er helt sårbar for slike angrep: før tiden nesten
går ut, må en inn- og utgangsoperasjon (til en eller annen, uansett hvilken fil)
utføres,
og slik frigjør CPU-en. Denne oppførselen vil tillate å forbli i den samme
køen og igjen få en større del av prosessorens tid. Hvis man gjør
dette riktig (for eksempel, kjøre 99% av tiden før man frigjør CPU-en),
kan en slik oppgave rett og slett monopoliserer prosessoren.
Til slutt kan programmet endre oppførselen sin over tid. De oppgavene,
som brukte CPU-en, kan bli interaktive. I vårt eksempel vil slike
oppgaver ikke få tilstrekkelig behandling fra planleggeren, så de ville fått en annen
(opprinnelige) interaktive oppgaver.
Spørsmål til salen: hvilke angrep på planleggeren kunne vært gjennomført i dagens verden?
Forsøk 2: Heve prioriteten
La oss prøve å endre reglene og se om vi kan unngå problemer med
sulting. Hva kan vi gjøre for å garantere at oppgaver relatert til
CPU får sin tid (selv om det ikke er lenge).
Som en enkel løsning på problemet kan man foreslå å periodisk
heve prioriteten for alle slike oppgaver i systemet. Det finnes mange måter
å oppnå dette, la oss prøve å implementere noe enkelt som et eksempel: å omgjøre
- alle oppgaver til høyest prioritert med en gang, her er den nye regelen:Rule5
: Etter en viss periode S, flytt alle oppgaver i systemet til den høyeste køen.
Vår nye regel løser to problemer samtidig. For det første er prosesser
garantert ikke sultne: oppgaver som er i den øverste køen vil dele
prosessortid i henhold til RR-algoritmen, og på den måten vil alle prosesser få
prosessortid. For det andre, hvis en prosess, som tidligere brukte
bare prosessoren, blir interaktiv, vil den forbli i køen med høyest
prioritet etter å ha fått heve prioriteten til høyest.
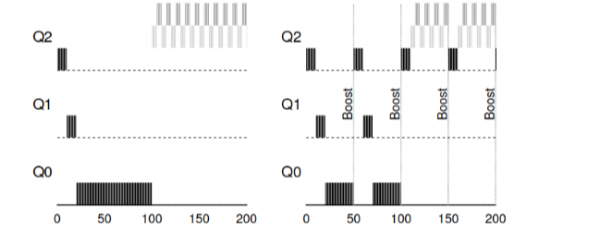
CPU og to interaktive, korte prosesser. Til venstre på bildet vises oppførselen uten prioritetshøyning, og dermed begynner den lange oppgaven å sultne etter at to interaktive oppgaver ankommer systemet. Til høyre vises det at hver 50 ms skjer prioritetshøyning, og dermed får alle prosesser garantert prosessortid og vil kjøres periodisk. 50 ms er valgt som et eksempel, i virkeligheten er dette tallet noe høyere.
Det er åpenbart at tillegget av periodisk heving S fører til
det naturlige spørsmålet: hvilket tall bør settes? En av de anerkjente
systemingeniørene John Ousterhout kalte slike størrelser i systemer som voo-doo
konstanter, ettersom de på en eller annen måte krevde svart magi for korrekt
innstilling. Og dessverre har S en slik lukt. Hvis verdien settes for
høy, vil lange oppgaver begynne å sultne. Og hvis verdien settes for lav,
vil de interaktive oppgavene ikke få tilstrekkelig prosessortid.
Forsøk 3: Bedre regnskap
Nå har vi et annet problem som må løses: hvordan ikke
la vår planlegger bli lurt? Årsaken til denne muligheten er
reglene 4a, 4b, som lar oppgaven beholde prioriteten ved å la CPU
bli frigjort før tildelt tid er ute. Hvordan takler man dette?
Løsningen i dette tilfellet kan være bedre regnskap for CPU-tid på hvert
nivå i MLFQ. I stedet for å glemme tiden programmet brukte
CPU i den tildelte perioden, bør man ta hensyn til og lagre den. Etter at
prosessen har forbrukt sin tildelte tid, bør den senkes til neste
prioritetsnivå. Nå spiller det ingen rolle hvordan prosessen bruker tiden sin — som
kontinuerlig beregning på CPU eller som mange kall. Dermed
bør regel 4 omskrives til følgende:
- Rule4: Etter at en oppgave har brukt sin tildelte tid i den nåværende køen (uavhengig av hvor mange ganger den har frigjort CPU), senkes prioriteten for en slik oppgave (den beveger seg nedover i køen).
La oss se på et eksempel:
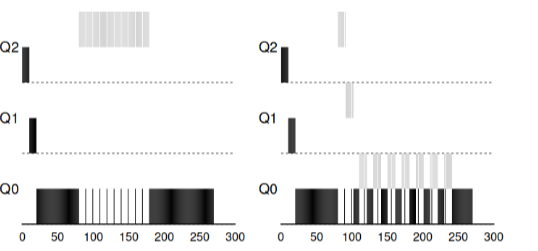 »
Bildet viser hva som skjer hvis man prøver å lure planleggeren, som
hvis det var med de tidligere reglene 4a, 4b ville resultatet til venstre ha blitt. Med den nye
regelen — resultatet til høyre. Før beskyttelse kunne enhver prosess forårsake I/O før fullføring og
dominerende CPU-en, etter aktivering av beskyttelsen, uavhengig av I/O-atferd,
vil han fortsatt bli sendt ned i køen og dermed ikke kunne urettferdig
tilgang til CPU-ressursene.
Forbedrer MLFQ og andre problemer
Med de ovennevnte forbedringene oppstår nye problemer: et av de viktigste
spørsmålene er hvordan man skal parametrisere en slik planlegger? Det vil si, hvor mange
køer skal det være? Hva skal størrelsen på arbeidsvinduet være innenfor køen? Hvor
ofte skal man heve prioriteten til programmet for å unngå sulting og
ta hensyn til endringer i programmets atferd? Det finnes ingen enkel
svar på disse spørsmålene, og kun eksperimentering med belastningene og påfølgende konfigurasjon
av planleggeren kan føre til en tilnærmet tilfredsstillende balanse.
For eksempel tillater de fleste implementasjoner av MLFQ tildeling av ulike
tidsintervaller til forskjellige køer. Høyt prioriterte køer får vanligvis
korte intervaller. Disse køene består av interaktive oppgaver,
som bytter ganske følsomt og bør ta 10 millisekunder eller mindre.
Motsatt består lavprioriterte køer av lange oppgaver som bruker
CPU. I dette tilfellet passer lange tidsintervaller mye godt (100 ms).
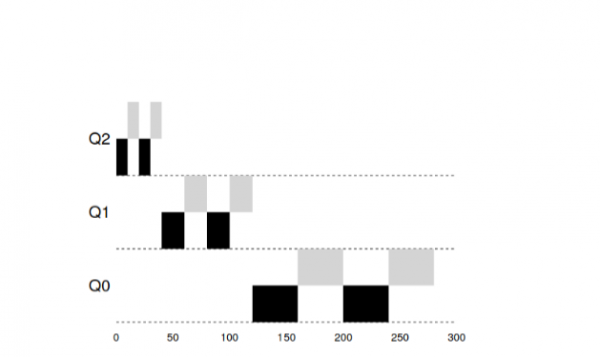
I dette eksemplet er det to oppgaver som har jobbet i den høyt prioriterte køen i 20
ms, delt opp i vinduer på 10 ms. 40 ms i den middels prioriterte køen (vindu på 20 ms) og i den lavprioriterte
køen ble tidsvinduet 40 ms, hvor oppgavene fullførte arbeidet sitt.
Implementeringen av MLFQ i OS Solaris er en klasse av planleggere som deler opp tiden.
Planleggeren tilbyr et sett med tabeller som nøyaktig definerer hvordan
prosessenes prioritet skal endres over levetiden, hva som skal være størrelsen på
det tildelte vinduet og hvor ofte oppgavene skal heve prioritetene. Systemadministratoren
kan interagere med denne tabellen og få planleggeren til å oppføre seg
annerledes. Som standard har denne tabellen 60 køer med gradvis økende
vindusstørrelse fra 20 ms (høy prioritet) til flere hundre ms (lav prioritet), og
og med boost av alle oppgaver hver sekund.
Andre MLFQ-planleggere bruker ikke tabeller eller spesifikke
regler som beskrevet i denne læren; tvert imot beregner de prioriteter ved å bruke
matematisk formel. For eksempel bruker planleggeren i FreeBSD en formel for
å beregne gjeldende prioritet for en oppgave, basert på hvor mye prosessor
den har brukt. I tillegg forfaller CPU-bruken over tid, og dermed skjer
øking av prioritet noe annerledes enn beskrevet ovenfor. Dette er såkalt
decay-algoritmer. Fra versjon 7.1 bruker FreeBSD ULE-planleggeren.
Til slutt har mange planleggere andre egenskaper. For eksempel reserverer noen
planleggere de høyere nivåene for operativsystemets arbeid, og slik
kan ingen brukerprosess oppnå den høyeste prioriteten i
systemet. Noen systemer tillater å gi råd for å hjelpe
planleggeren til å sette prioriteringer korrekt. For eksempel kan man nice
bruke kommandoen til å øke eller senke prioriteten til en oppgave, og dermed
øke eller redusere sjansene til programmet for prosessor-tid.
MLFQ: Oppsummering
Vi har beskrevet en tilnærming til planlegging som kalles MLFQ. Navnet
er basert på prinsippet om hvordan den fungerer — den har flere køer og bruker
tilbakemelding for å bestemme prioriteten til oppgaven.
De endelige reglene vil være som følger:
- Rule1: Hvis prioritet(A) > Prioritet(B), vil oppgave A bli kjørt (B vil ikke bli)
- Rule2: Hvis prioritet(A) = Prioritet(B), kjøres A og B med RR
- Rule3: Når en oppgave kommer inn i systemet, plasseres den i køen med høyest prioritet.
- Rule4: Etter at en oppgave har brukt sin tildelte tid i den nåværende køen (uavhengig av hvor mange ganger den har frigjort CPU), senkes prioriteten for en slik oppgave (den beveger seg nedover i køen).
- alle oppgaver til høyest prioritert med en gang, her er den nye regelen:Rule5
MLFQ er interessant av følgende grunn — i stedet for å kreve forkunnskap om
oppgavens natur på forhånd, studerer algoritmen oppgavens tidligere atferd og setter
prioriteter deretter. Slik prøver den å få til en balanse — oppnå ytelse for små oppgaver (SJF, STCF) og ærlig kjøre lange,
CPU-tunge oppgaver. Derfor bruker mange systemer, inkludert BSD og deres avledninger,
Solaris, Windows, Mac en form for MLFQ-algoritme som grunnleggende
planlegger.
Additional materials:
- (computing)
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish