

Foredraget handler om praktiske spørsmål knyttet til utviklingen av en operator i Kubernetes, design av dens arkitektur og grunnleggende prinsipper for funksjon.
I den første delen av foredraget vil vi se på:
- hva en operator i Kubernetes er og hvorfor den er nødvendig;
- hvordan operatoren forenkler administrasjonen av komplekse systemer;
- hva en operator kan gjøre og hva den ikke kan gjøre.
Deretter går vi videre til diskusjonen om den indre strukturen til operatoren. Vi vil se på arkitekturen og funksjonen til operatoren steg for steg. Vi vil gå nøye gjennom:
- interaksjon mellom operatoren og Kubernetes;
- hvilke funksjoner operatoren tar på seg, og hva den delegerer til Kubernetes.
Vi vil se på forvaltning av shards og replikater av databaser i Kubernetes.
Videre vil vi diskutere dataoppbevaringsspørsmål:
- hvordan jobbe med Persistent Storage fra operatorens perspektiv;
- feller ved bruk av Local Storage.
I den avsluttende delen av foredraget vil vi se på praktiske eksempler på anvendelse av med Amazon eller Google Cloud Service. Foredraget er bygget på utviklingen og erfaringen med å drive en operator for ClickHouse.
Video:
Mitt navn er Владислав Клименко. I dag skulle jeg gjerne fortelle om vår erfaring med utvikling og drift av operatøren, som er en spesialisert operator for administrasjon av databaseklynger. Vi tar utgangspunkt i for å administrere en ClickHouse-klynge.
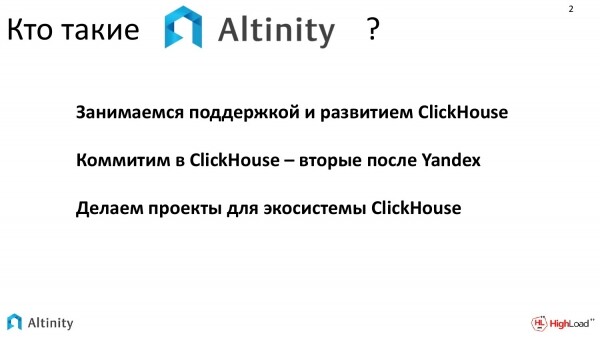
Hvorfor har vi muligheten til å snakke om operatoren og ClickHouse?
- Vi jobber med støtte og utvikling av ClickHouse.
- For tiden prøver vi gradvis å bidra så mye vi kan til utviklingen av ClickHouse. Vi er nummer to etter Yandex i volumet av endringer vi har gjort i ClickHouse.
- Vi prøver å lage ekstra prosjekter for ClickHouse-økosystemet.
Om et slikt prosjekt vil jeg gjerne fortelle. Det handler om ClickHouse-operatoren for Kubernetes.
I mitt foredrag vil jeg berøre to temaer:
- Det første temaet er hvordan vår operator fungerer for å administrere ClickHouse databaser i Kubernetes.
- Det andre temaet er hvordan enhver operator fungerer, det vil si hvordan den interagerer med Kubernetes.
Disse to spørsmålene vil krysse hverandre gjennom hele mitt foredrag.
Hvem vil være interessert i å høre det jeg prøver å fortelle?
- Det vil være mest interessant for de som drifter operatører.
- Eller de som ønsker å lage sin egen for å forstå hvordan det fungerer internt, hvordan operatoren interagerer med Kubernetes og hvilke feller som kan oppstå.
For a better understanding of what we will discuss today, it would be helpful to know how Kubernetes works and have a basic background in cloud technologies.
What is ClickHouse? It is a column-oriented database designed for online analytical processing of queries. And it is completely open source.
And we need to know just two things. First, we must understand that this is a database, so what I will explain will apply to practically any database. And second, ClickHouse scales very well, providing almost linear scalability. Therefore, a cluster's state is a natural state for ClickHouse. Our main interest is to discuss how to maintain the ClickHouse cluster in Kubernetes.
Why is it needed there? Why can't we continue to operate it independently? The answers are partly technical and partly organizational.
- In practice, we increasingly encounter situations where, in large companies, almost all components are already in Kubernetes. Databases remain outside.
- And the question is being asked more and more often: "Can this be brought inside?" Therefore, large companies strive for maximum standardization of management in order to quickly be able to manage their data stores.
- This is especially helpful if we need maximum repeatability in a new location, i.e., maximum portability.
How simple or complex is it? Of course, it can be done manually. But it's not that simple, because we have the added complexity of managing Kubernetes itself, along with the specifics of ClickHouse. It results in such aggregation.
And all together, this creates a sufficiently large set of technologies that become quite challenging to manage, because Kubernetes brings its daily operational issues, while ClickHouse brings its own daily operational challenges. Especially if we have multiple ClickHouse instances that we need to constantly manage.
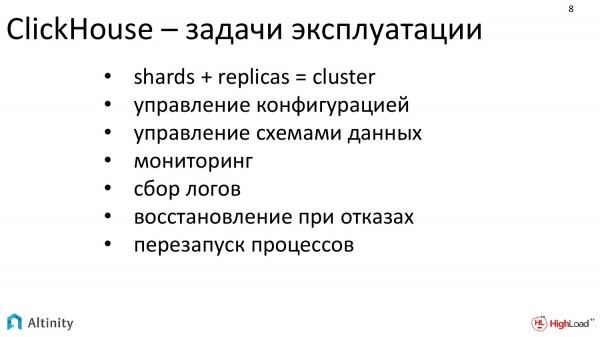
ClickHouse, with dynamic configuration, presents quite a number of issues that create a constant workload for DevOps:
- When we want to change something in ClickHouse, for example, adding a replica or shard, we need to conduct configuration management.
- Så må du endre dataskjemaet, fordi ClickHouse har en spesifikk måte å sharde data på. Det er nødvendig å organisere dataskjemaet og konfigurasjonene.
- Monitoring må settes opp.
- Loggsamling for nye shard-er, for nye replikaer.
- Ta seg av gjenoppretting.
- Og omstart.
Dette er rutinearbeid som man veldig gjerne vil forenkle i driften.
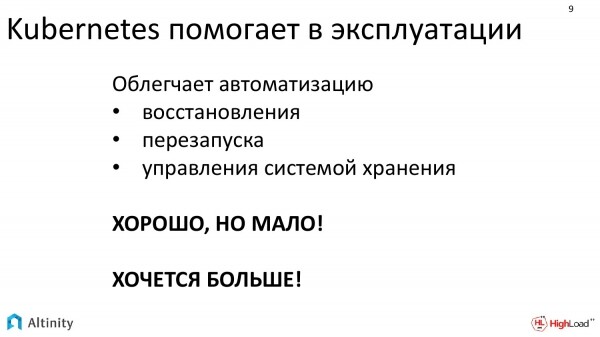
Kubernetes hjelper godt med driften, men på grunnleggende systemnivå.
Kubernetes letter og automatiserer blant annet slike ting som:
- Gjenoppretting.
- Omstart.
- Håndtering av lagringssystemet.
Det er bra, det er riktig retning, men det har overhodet ikke noen forståelse for hvordan man skal drifte en databasklynge.
Man ønsker mer, man vil at hele databasen skal fungere i Kubernetes.
Man ønsker å ha noe som ligner en stor, magisk rød knapp, som man kan trykke på, og så rulles det ut og opprettholdes en klynge gjennom hele livssyklusen med daglige oppgaver som må løses. ClickHouse-klynge i Kubernetes.
Og vi har forsøkt å lage en løsning som ville gjøre arbeidet enklere. Dette er ClickHouse-operatoren for Kubernetes fra Altinity.
En operator er et program hvis hovedoppgave er å administrere andre programmer, altså en forvalter.
Og det inneholder atferdsmønstre. Man kan kalle dette kodifiserte kunnskaper om fagfeltet.
Og dens hovedoppgave er å gjøre livet lettere for DevOps og redusere mikrostyring, slik at han (DevOps) kan tenke i høynivåtermer, det vil si at han (DevOps) ikke trenger å gjøre mikrostyring og manuelt konfigurere alle detaljer.
Og nettopp operatoren er en robotassistent som tar tak i mikrouppgaver og hjelper DevOps.
Hvorfor trenger man en operator? Den viser seg spesielt godt i to spørsmål:
- Når en spesialist som jobber med ClickHouse har utilstrekkelig erfaring, men man allerede må drifte ClickHouse, letter operatoren driften og gjør det mulig å administrere en ClickHouse-klynge med en relativt kompleks konfigurasjon, uten å gå for mye i detalj om hvordan alt fungerer innad. Man gir bare høynivåoppgaver, og så fungerer det.
- Og den andre oppgaven hvor han utmerker seg best, er når det er nødvendig å automatisere mange standardoppgaver. Han fjerner mikroadministrative oppgaver fra systemadministratorene.
Dette er mest nyttig for de som nettopp begynner sin vei, eller for de som trenger å jobbe mye med automatisering.
Hva er forskjellen mellom tilnærmingen basert på operatører og andre systemer? Det finnes jo Helm. Det hjelper også med å sette opp ClickHouse, man kan lage helm charts som til og med kan sette opp et helt ClickHouse-kluster. Hva er da forskjellen mellom operatøren og for eksempel Helm?
Hovedforskjellen er at Helm er en pakkebehandling, mens operatøren går videre. Det handler om å følge hele livssyklusen. Det er ikke bare installasjon, men daglige oppgaver som inkluderer skalering, sharding, det vil si alt som må gjøres i løpet av livssyklusen (hvis nødvendig, også sletting) – alt dette håndterer operatøren. Han prøver å automatisere og vedlikeholde hele livssyklusen til programvaren. Dette er hans fundamentale skille fra andre løsninger som er tilgjengelige.
Det var innledningen, la oss gå videre.
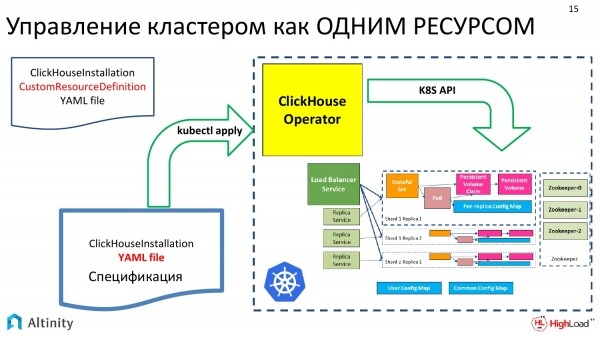
Hvordan bygger vi vår operatør? Vi prøver å tilnærme oss spørsmålet om hvordan vi kan administrere et ClickHouse-kluster som en enkelt ressurs.
Her har vi i venstre del av bildet inngangsdataene. Dette er YAML med spesifikasjonen for klusteret, som på klassisk måte blir overført til Kubernetes via kubectl. Der tar operatøren tak i dette, gjør sin magi. Og ut ved de får vi et slikt skjema. Dette er implementeringen av ClickHouse i Kubernetes.
Og videre skal vi sakte se på hvordan operatøren fungerer, hvilke standardoppgaver man kan løse. Vi vil bare se på standardoppgaver, fordi vi har begrenset tid. Og ikke alt hva operatøren kan løse vil bli diskutert.
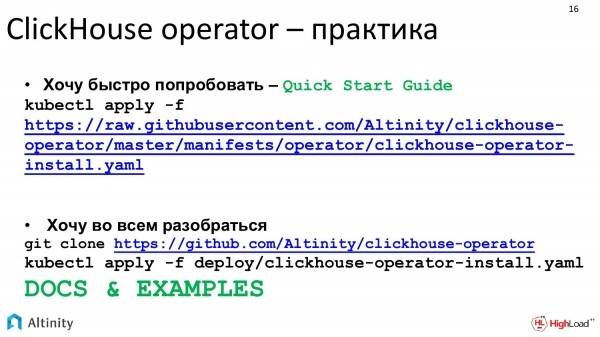
La oss ta utgangspunkt i praksis. Prosjektet vårt er helt open source, så man kan se på GitHub hvordan det fungerer. Og man kan ta utgangspunkt i at, hvis man bare ønsker å starte, kan man begynne med Quick Start Guide.
Hvis man ønsker å forstå det i detalj, prøver vi å opprettholde dokumentasjonen i en mer eller mindre anstendig tilstand.
La oss begynne med en praktisk oppgave. Den første oppgaven, som vi alle ønsker å starte med, er å kjøre det første eksemplet på en eller annen måte. Hvordan kan vi starte ClickHouse ved hjelp av operatøren, selv uten å vite hvordan det fungerer? Vi skriver et manifest, ettersom all kommunikasjon med k8s skjer gjennom manifestene.
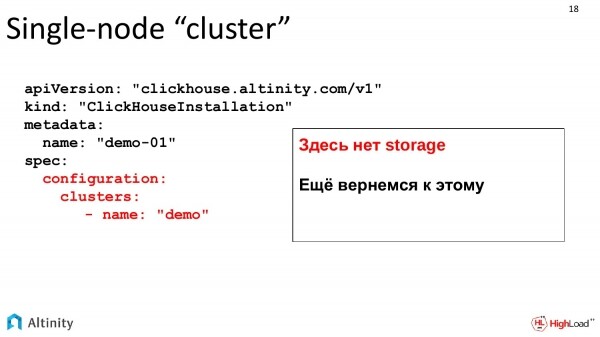
Her er et slikt komplisert manifest. Det som er uthevet i rødt, er det vi må fokusere på. Vi ber operatøren om å lage en klynge med navnet demo.
Så langt er dette grunnleggende eksempler. Storage er ennå ikke beskrevet, men vi kommer tilbake til storage senere. For nå vil vi observere utviklingen av klyngen i dynamikk.
Vi har laget dette manifestet. Vi mater det inn til operatøren vår. Han jobbet, gjorde sin magi.
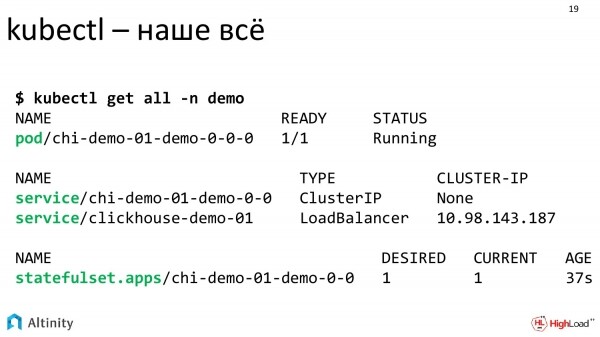
Vi ser på konsollen. Tre komponenter vekker interesse – det er Pod, to tjenester, StatefulSet.
Operatøren har jobbet og vi kan se hva han har opprettet.
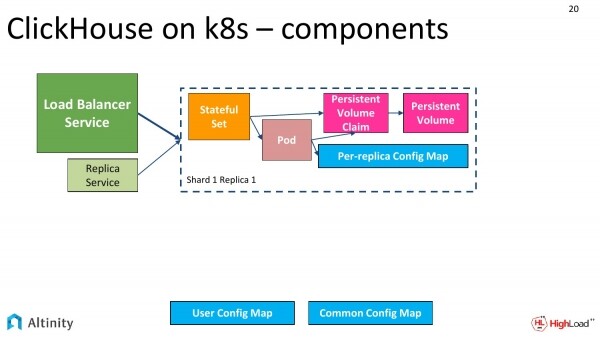
Han lager omtrent et slikt skjema. Vi har StatefulSet, Pod, ConfigMap for hver replikk, ConfigMap for hele klyngen. Tjenestene er nødvendigvis som inngangspunkter til klyngen.
Tjenester – det er den sentrale Load Balancer-tjenesten, og det kan også være en for hver replikk, for hver shard.
Slik ser vår grunnleggende klynge ut. Den består av én enkelt node.
La oss gå videre, vi skal komplisere det. Klyngen må sharding.
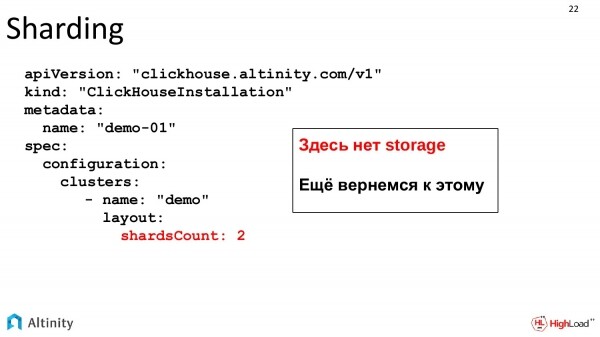
Våre oppgaver vokser, dynamikken begynner. Vi ønsker å legge til en shard. Vi følger med på utviklingen. Vi endrer spesifikasjonen vår. Vi angir at vi ønsker to shards.
Dette er den samme filen som dynamisk utvikler seg med systemets vekst. Storage er ikke nevnt, det vil bli behandlet senere, dette er et eget tema.
Vi mater YAML-operatøren og ser hva som skjer.
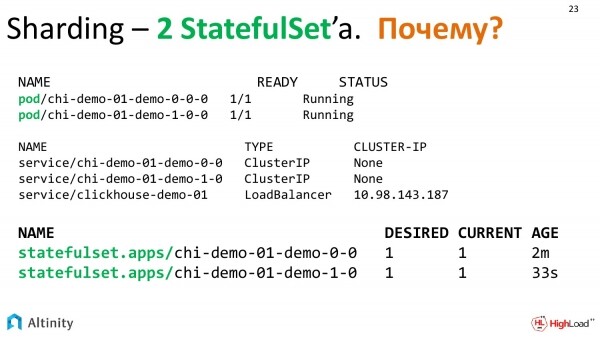
Operatøren tenkte og lagde følgende enheter. Vi har allerede to Pods, tre tjenester og, plutselig, to StatefulSets. Hvorfor to StatefulSets?
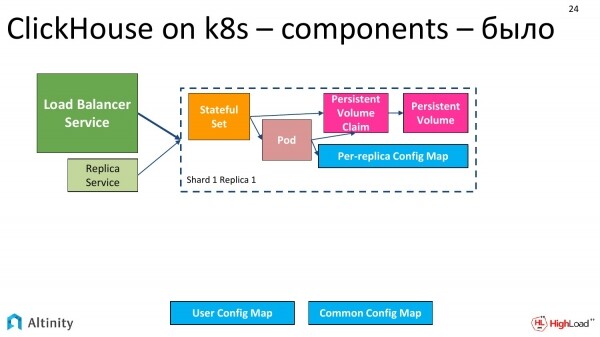
På skjemaet var det slik – dette er vår opprinnelige tilstand, når vi hadde én pod.
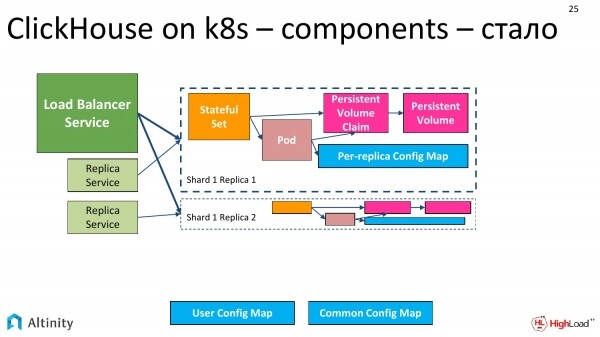
Det har blitt slik. Så langt er alt enkelt, det er duplisert.
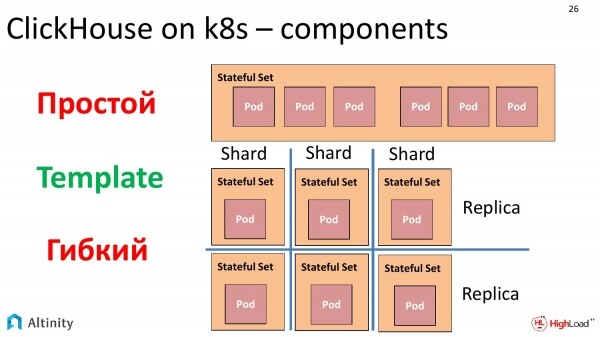
Og hvorfor har StatefulSet blitt to? Her må vi avbryte og diskutere hvordan pod-er styres i Kubernetes.
Det finnes et objekt kalt StatefulSet, som lar deg lage en gruppe Pod-er fra en mal. Her er den nøkkelfaktoren – det er malen. Og i ett StatefulSet kan du kjøre mange Pod-er med én mal. Og den nøkkelfrasen her er 'mange Pod-er fra én mal'.
Det var en stor fristelse å lage hele klyngen i én StatefulSet. Dette vil fungere, det er det ingen problemer med. Men det er ett problem. Hvis vi ønsker å sette sammen en heterogen klynge, altså fra flere versjoner av ClickHouse, så begynner vi å få spørsmål. Ja, StatefulSet kan gjøre rolling update, ja, der kan man rulle ut en ny versjon og forklare at man må prøve ikke mer enn så mange noder samtidig.
Men hvis vi ekstrapolerer oppgaven og sier at vi vil lage en helt heterogen klynge, og at vi ikke vil gjøre en oppgradering fra gammel til ny versjon ved hjelp av rolling update, men rett og slett vil skape en heterogen klynge både når det gjelder forskjellige versjoner av ClickHouse og når det gjelder ulik lagring. For eksempel ønsker vi å lage noen replikater på separate disker, på langsomme, generelt sett, bygg helt en heterogen klynge. Og fordi StatefulSet lager en standardisert løsning fra én mal, er det derfor ikke mulig å gjøre det.
Etter litt ettertanke ble det besluttet at vi gjør det slik. Hver replika har sin egen StatefulSet. Det er noen ulemper med denne løsningen, men i praksis inkapsler dette alt operatøren. Og det er mange fordeler. Vi kan bygge helt den klyngen vi ønsker, for eksempel helt heterogen. Derfor, i en klynge der vi har to shards med én replika hver, vil vi ha 2 StatefulSet-er og 2 Pods nettopp fordi vi har valgt en sådan tilnærming av de nevnte grunnene for muligheten til å bygge en heterogen klynge.
La oss gå tilbake til praktiske oppgaver. I vår klynge må vi konfigurere brukere, altså må vi gjøre noe konfigurasjon av ClickHouse i Kubernetes. Operatøren gir alle muligheter for dette.
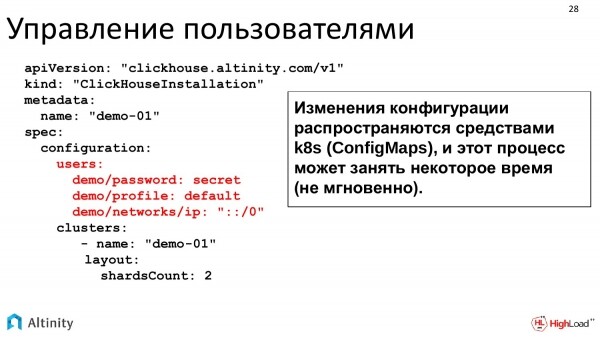
Vi kan skrive direkte i YAML hva vi ønsker. Alle konfigurasjonsalternativer mappes direkte fra denne YAML til ClickHouse-konfigurasjoner, som deretter distribueres over hele klyngen.
Vi kan også skrive slik. Dette er et eksempel. Passordet kan gjøres kryptert. Absolutt alle konfigurasjonsalternativer for ClickHouse støttes. Her er det bare et eksempel.
Konfigurasjonen for klyngen distribueres som ConfigMap. I praksis skjer oppdatering av ConfigMap ikke umiddelbart, så hvis det er en stor klynge, tar det litt tid å pushe konfigurasjonen. Men alt dette er veldig praktisk i drift.
Vi kompliserer oppgaven. Klyngen utvikler seg. Vi ønsker å replikere data. Det vil si at vi allerede har to shards, med en replika hver, og brukerne er satt opp. Vi vokser og ønsker å jobbe med replikering.
Hva trenger vi for replikering?
Vi trenger ZooKeeper. I ClickHouse er replikering bygget med bruk av ZooKeeper. ZooKeeper er nødvendig for at de ulike replikaene av ClickHouse skal ha en konsensus om hvilke datablokker som finnes på hvilken ClickHouse.
Du kan bruke hvilken som helst ZooKeeper. Hvis det finnes en ekstern ZooKeeper hos bedriften, kan den brukes. Hvis ikke, kan man installere fra vårt repository. Det finnes en installer som gjør dette enklere.
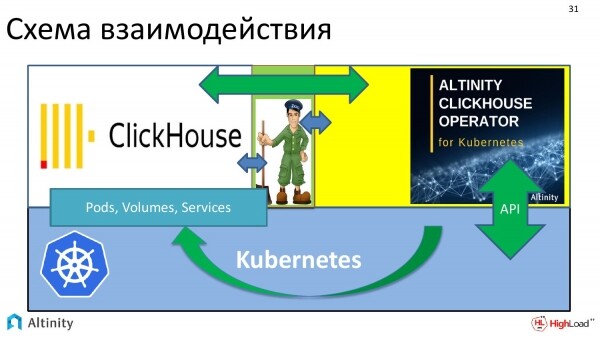
Og interaksjonsskjemaet for hele systemet ser slik ut. Vi har Kubernetes som plattform. På den kjører ClickHouse-operatøren. ZooKeeper er her representert. Operatøren samhandler med både ClickHouse og ZooKeeper. Det vil si at det blir en interaksjon.
Og alt dette er nødvendig for at ClickHouse skal replikere data vellykket i k8s.
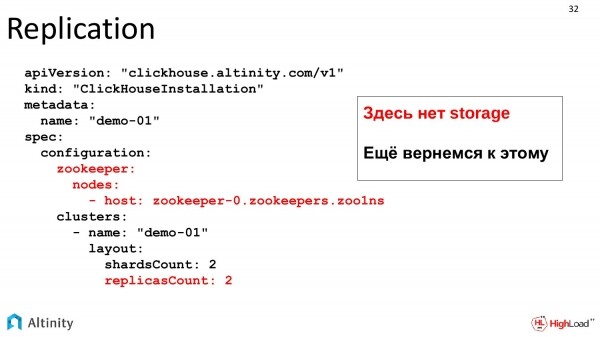
La oss nå se på selve oppgaven, hvordan manifestet for replikering vil se ut.
Vi legger til to seksjoner i manifestet vårt. Den første er hvor vi skal hente ZooKeeper, som kan være både internt i Kubernetes og ekstern. Dette er bare en beskrivelse. Og vi ber om replikene. Det vil si at vi ønsker to replikas. Totalt skal vi ha 4 pod'er. Når det gjelder lagring, husker vi, det kommer litt senere. Lagring er en egen sang.
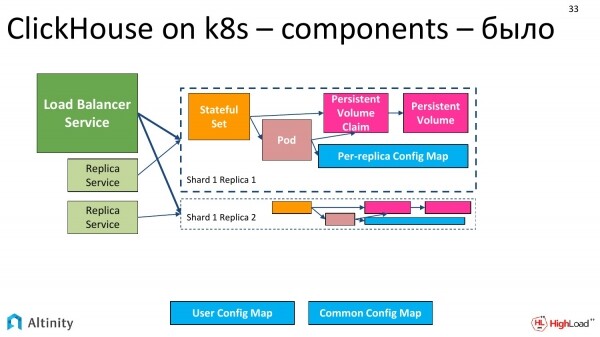
Det var slik.
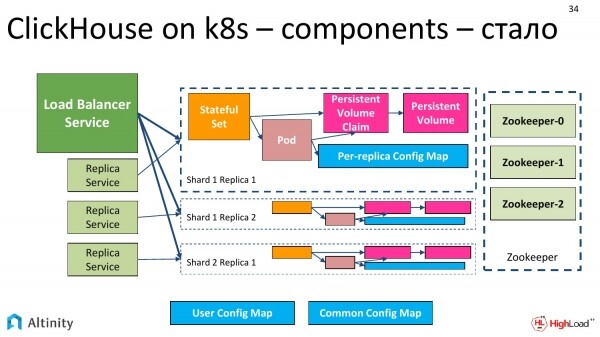
Det blir slik. Replikaene legges til. Den fjerde fikk ikke plass, men vi tror at det kan være mange der. Og ZooKeeper legges til på siden. Skjematikkene blir mer kompliserte.
Og tiden har kommet for å legge til neste oppgave. Vi skal legge til Persistent Storage.
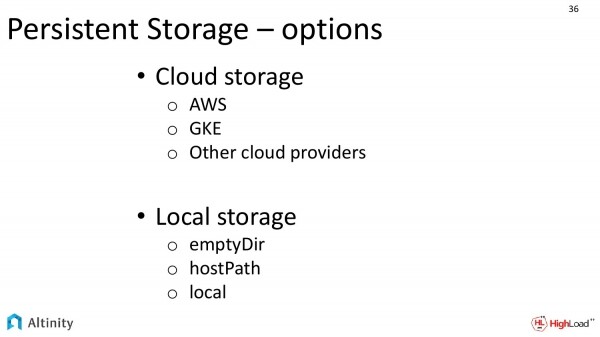 Når det gjelder Persistent Storage, har vi ulike implementasjonsalternativer.
I tilfelle vi kjører i en cloud-leverandør, for eksempel Amazon eller Google, er det fristende å bruke skytjenester for lagring. Det er veldig praktisk, det er bra.
Og det finnes et annet alternativ. Dette er for lokal lagring, når vi har lokale disker på hver node. Dette alternativet er mye mer komplekst å implementere, men samtidig mer effektivt.
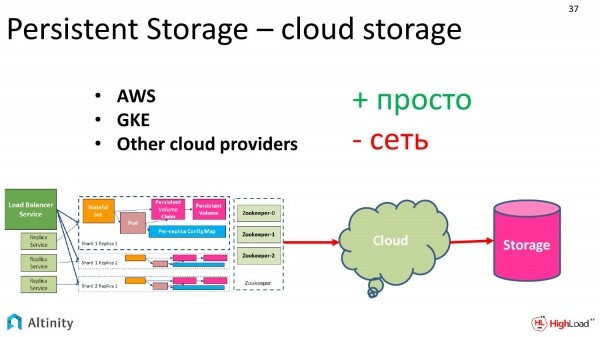
La oss se på hva vi har med hensyn til cloud-lagring.
Det er fordeler. Det er veldig enkelt å konfigurere. Vi ber bare sky-leverandøren om å gi oss lagring av en bestemt kapasitet, av en bestemt klasse. Klassene er beskrevet av leverandørene selv.
Og det er en ulempe. For noen er dette en uvesentlig ulempe. Selvfølgelig vil det være noen performance-overbelastninger. Det er veldig praktisk å jobbe med, pålitelig, men det finnes noen potensielle ytelsesproblemer.
Og siden ClickHouse fokuserer nettopp på ytelse, kan man til og med si at det trekker ut alt som er mulig, derfor prøver mange kunder å få maksimalt ut av ytelsen.
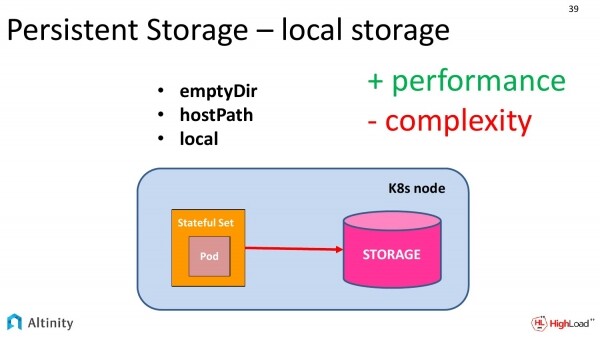
Og for å få maksimalt ut av det, trenger vi local storage.
Kubernetes tilbyr tre abstraksjoner for bruk av local storage i Kubernetes. Disse er:
- EmptyDir
- HostPath.
- Local
La oss se på hvordan de skiller seg fra hverandre, og hva de har til felles.
For det første, i alle tre tilnærmingene har vi storage – lokale disker som ligger på den samme fysiske k8s noden. Men de har noen forskjeller.
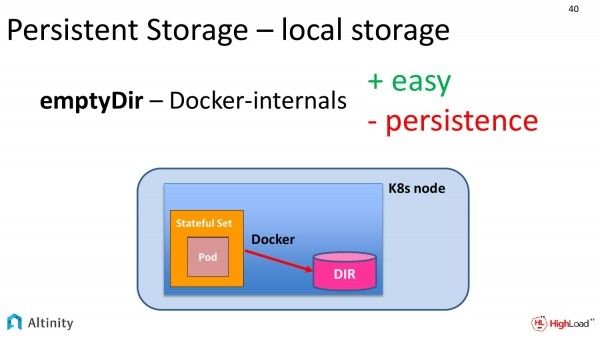
La oss begynne med det enkleste, det vil si med emptyDir. Hva er dette i praksis? Det er at vi ber systemet for containere (oftest er det Docker) om å gi oss tilgang til en mappe på den lokale disken.
I praksis oppretter Docker et sted der borte med sine egne stier en midlertidig mappe, navn gitt som en lang hash. Og den gir tilgangsgrensesnitt til den.
Hvordan vil dette fungere med ytelsen? Dette vil fungere med hastigheten til den lokale disken, dvs. det er full tilgang til sin egen harddisk.
Men dette har en ulempe. Persistensen er ganske tvilsom. Ved den første bevegelsen av Docker med containerne går persistensen tapt. Hvis Kubernetes av en eller annen grunn ønsker å flytte denne Pod-en til en annen disk, vil dataene gå tapt.
Denne tilnærmingen er bra for tester, fordi den viser grei hastighet, men for noe seriøst er ikke dette alternativet passende.
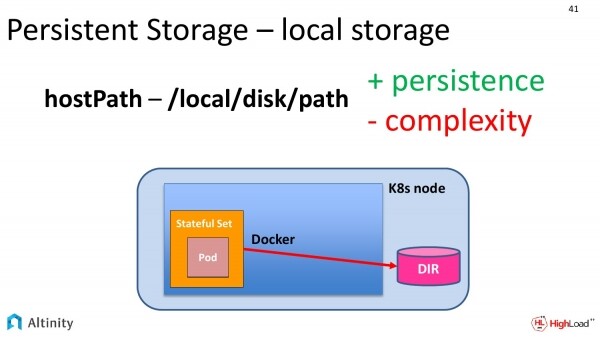
Derfor er det en annen tilnærming. Dette er hostPath. Hvis vi ser på det forrige lyset og dette, kan vi se én eneste forskjell. Mappen vår har gått fra Docker direkte til Kubernetes-noden. Her er det litt enklere. Vi skriver rett ut hvilken sti vi ønsker å bruke på det lokale filsystemet for å lagre våre data.
Fordelene med denne metoden er reelle. Dette er allerede ekte persistering, og dessuten klassisk. Vi vil ha data lagret på disken et bestemt sted.
Det finnes også ulemper. Dette er kompleksiteten ved administrasjon. Vår Kubernetes kan ønske å flytte en Pod til en annen fysisk node. Og da kommer DevOps inn i bildet. Han må forklare systemet korrekt at disse pod'ene bare kan flyttes til noder der du har noe montert på disse stiene, og ikke mer enn en node av gangen. Dette er ganske komplisert.
Spesielt for disse formålene har vi laget maler for å skjule all denne kompleksiteten. Man kunne enkelt si: «Jeg ønsker at det skal være én instans av ClickHouse på hver fysisk node og på denne stien».
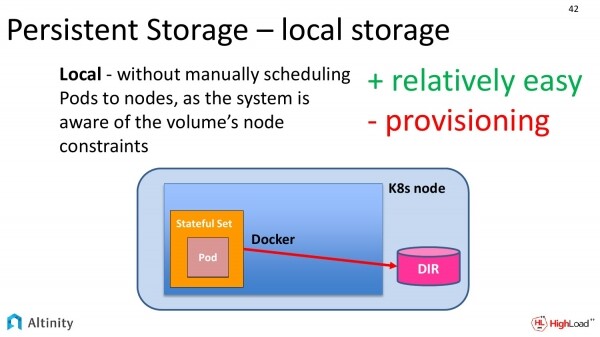
Men dette behovet gjelder ikke bare oss, derfor forstår gutta i Kubernetes også at folk ønsker tilgang til fysiske disker, så de tilbyr et tredje nivå.
Det kalles lokal. Forskjellen fra forrige lysbilde er praktisk talt ingen. Tidligere måtte man gjøre det manuelt, at pod'ene ikke kan flyttes fra node til node fordi de må være festet til en bestemt sti til en lokal fysisk disk, men nå er all denne kunnskapen innkapslet i Kubernetes selv. Og det blir mye enklere å konfigurere.
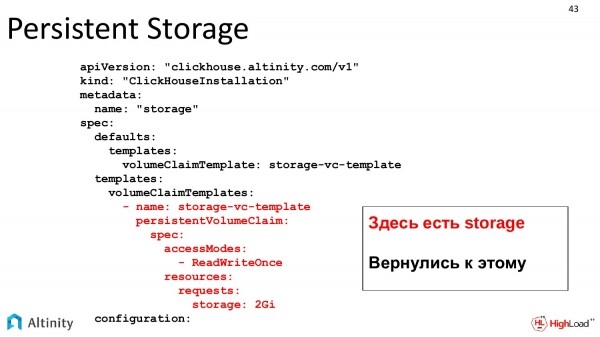
La oss gå tilbake til vår praktiske oppgave. La oss gå tilbake til YAML-malen. Her har vi fått en ekte lagring. Vi har kommet tilbake til dette. Vi definerer en klassisk VolumeClaim-mal som i k8s. Og beskriver hvilken lagring vi ønsker.
Etter dette vil k8s be om lagring. Den vil tildele oss det i StatefulSet. Og til slutt vil det bli tilgjengelig for ClickHouse.
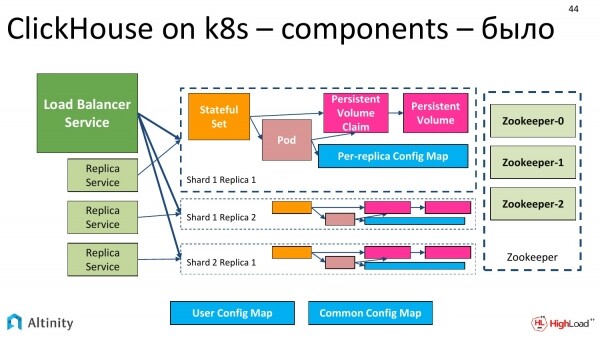
Vi hadde et slikt skjema. Vår Persistent Storage var rød, noe som antydet at det burde gjøres noe med det.
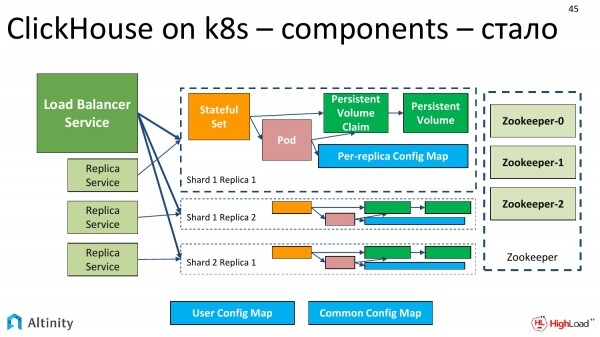
Og det blir grønt. Nå er skjemaet for ClickHouse-klyngen på k8s helt ferdigstilt. Vi har shard, replikaer, ZooKeeper, og det er ekte Persistent, som er implementert på en eller annen måte. Skjemaet er allerede helt operativt.
Vi fortsetter å leve videre. Klyngen vår utvikler seg. Og Alexey jobber hardt og slipper en ny versjon av ClickHouse.
Det oppstår en praktisk oppgave – å teste den nye versjonen av ClickHouse på vår klynge. Og selvfølgelig ønsker vi ikke å rulle den ut helt, vi ønsker å sette en ny versjon i et hjørne, og kanskje ikke bare én ny versjon, men to samtidig, fordi de lanseres ganske ofte.
Hva kan vi si om dette?
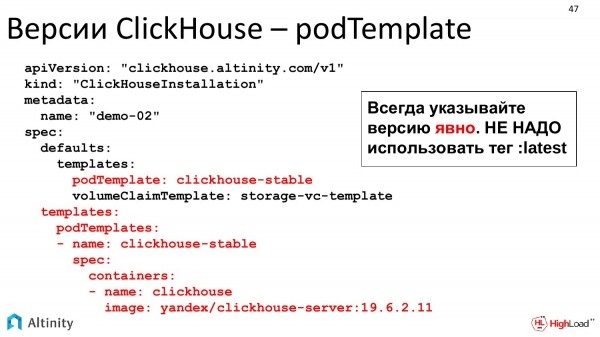
Her har vi nettopp en slik mulighet. Dette er maler for pod’er. Man kan spesifisere, vår operator lar oss fullt ut bygge et heterogent kluster. Dvs. konfigurere, fra alle replikene sammen, til hver enkelt replik som hvilken versjon av ClickHouse vi ønsker, hvilken versjon av lagring vi ønsker. Vi kan fullstendig konfigurere klusteret i den konfigurasjonen vi trenger.
Vi skal dykke litt dypere. Før dette snakket vi om hvordan ClickHouse-operatoren fungerer spesifikt for ClickHouse.
Nå vil jeg gjerne si noen ord om hvordan hvilken som helst operator fungerer, samt hvordan den interagerer med K8s.
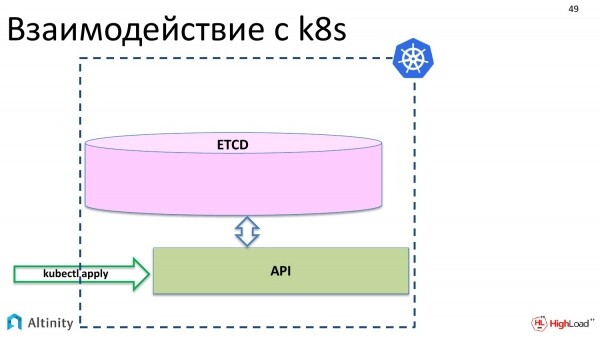
La oss først se på interaksjonen med K8s. Hva skjer når vi kjører kubectl apply? Våre objekter dukker opp i etcd via API.
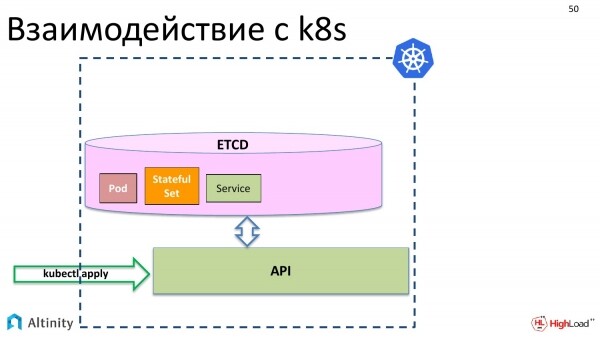
For eksempel de grunnleggende Kubernetes-objektene: pod, StatefulSet, service og så videre.
Samtidig skjer det ingen fysiske endringer ennå. Disse objektene må materialiseres i klusteret.
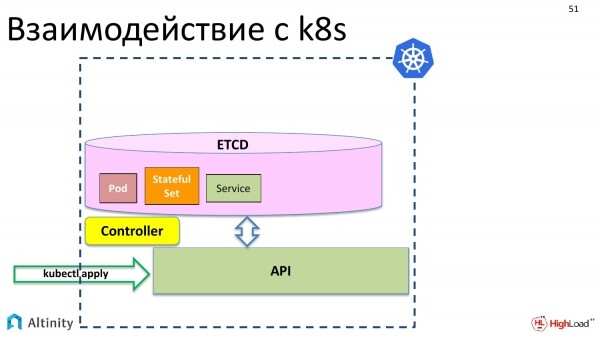
For dette dukker det opp en kontroller. Kontrolleren er en spesialkomponent i k8s, som kan materialisere disse beskrivelsene. Den vet hva som må gjøres fysisk. Den vet hvordan man starter containere, hva som må settes opp for at serveren skal fungere.
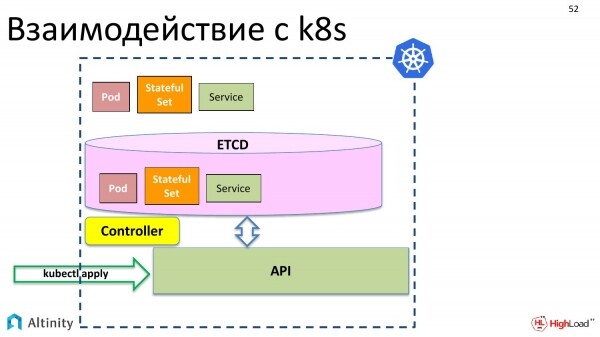
Og den materialiserer våre objekter i K8s.
Men vi ønsker å operere ikke bare med pod’er, StatefulSet’er, vi ønsker å opprette ClickHouseInstallation, altså et objekt av typen ClickHouse, så vi kan operere med det som en helhet. Foreløpig finnes det ikke en slik mulighet.
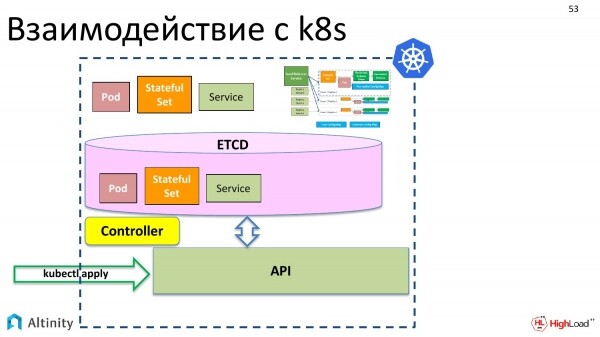
Men K8s har en annen nyttig funksjon. Vi ønsker at det skal oppstå en slik kompleks enhet, der vårt kluster er samlet fra pod’er og StatefulSet’er.
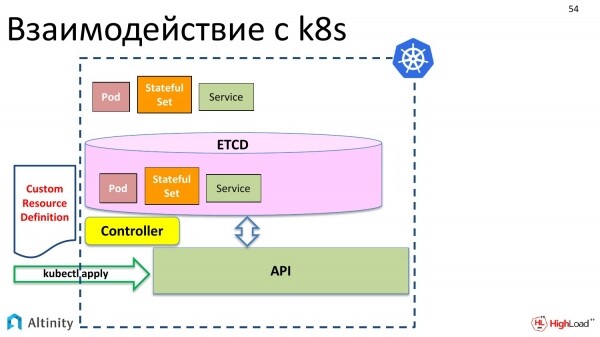
Hva må vi gjøre for dette? Først og fremst kommer Custom Resource Definition inn på scenen. Hva er dette? Dette er en beskrivelse for K8s, som sier at du vil ha en annen datatyper, at vi ønsker å legge til en tilpasset ressurs til pod, StatefulSet, som vil være kompleks innvendig. Dette er beskrivelsen av dataskrukturen.
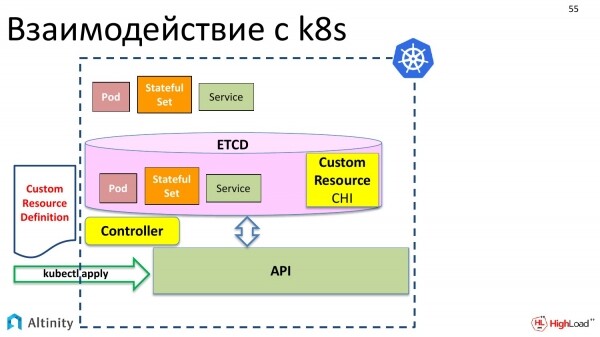
Vi sender det også dit via kubectl apply. Kubernetes tok det med glede.
Og nå har vi i lagringen, for objektet i etcd, muligheten til å registrere den tilpassede ressursen med navnet ClickHouseInstallation.
Men inntil videre skjer det ikke noe mer. Det vil si, hvis vi nå lager en YAML-fil som vi har diskutert med beskrivelse av shards, replikaer, og sier «kubectl apply», så vil Kubernetes godta den, lagre den i etcd og si: «Flott, men hva skal jeg gjøre med den? Jeg vet ikke hvordan jeg skal håndtere ClickHouseInstallation».
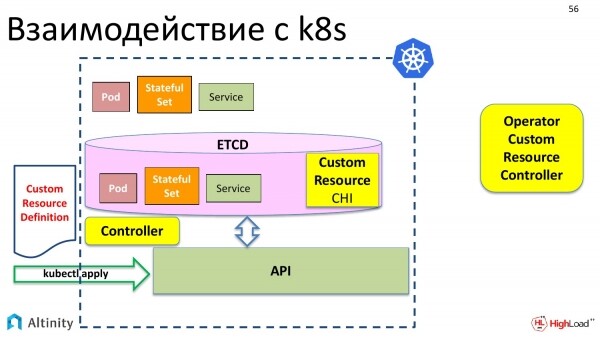
Derfor trenger vi noen som kan hjelpe Kubernetes med å håndtere en ny type data. Til venstre har vi den innebygde Kubernetes-kontrolleren som arbeider med innebygde datatyper. Og til høyre må vi ha en egendefinert kontroller som kan arbeide med egendefinerte datatyper.
Og den kalles også en operator. Jeg har spesifikt plassert den utenfor Kubernetes her, fordi den kan kjøre også utenfor K8s. Ofte kjører selvfølgelig alle operatorene i Kubernetes, men ingenting hindrer den fra å stå utenfor, så derfor er den spesifikt plassert utenfor.
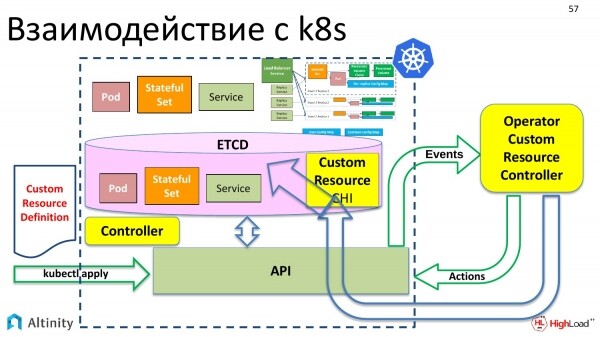
Den egendefinerte kontrolleren, som er operatøren, interagerer med Kubernetes via API. Den vet allerede hvordan den skal interagere med API-en. Og den vet allerede hvordan man kan materialisere den komplekse strukturen fra den egendefinerte ressursen som vi ønsker. Det er nettopp dette operatøren gjør.
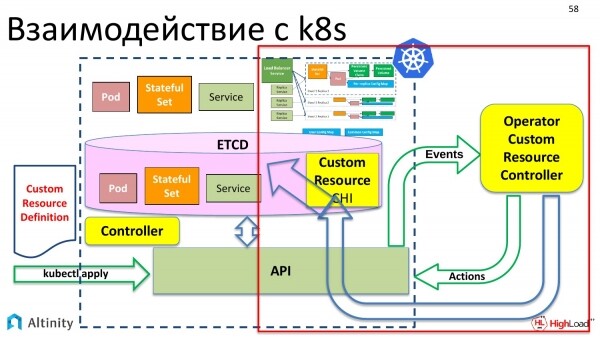
Hvordan fungerer operatøren? La oss se til høyre for å finne ut hvordan den gjør dette. Vi vil finne ut hvordan operatøren materialiserer alt dette, og hvordan interaksjonen med K8s fortsetter.
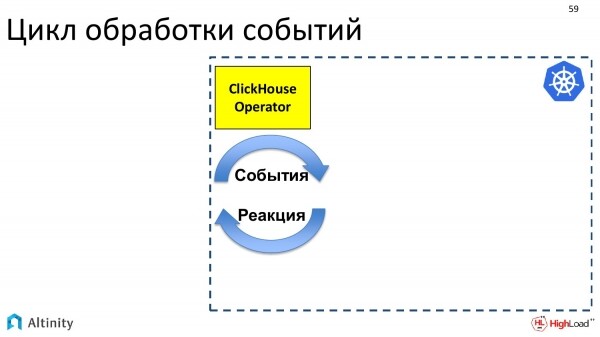
En operatør er et program. Den er hendelsesdrevet. Operatøren abonnerer på hendelser ved hjelp av Kubernetes API. I Kubernetes API finnes det tilgangspunkter hvor man kan abonnere på hendelser. Og hvis noe endres i K8s, så sender Kubernetes hendelser til alle som ønsker det, det vil si, de som abonnerte på dette API-punktet vil motta varsler.
Operatøren abonnerer på hendelser og må reagere på dem. Dens oppgave er å reagere på de nye hendelsene som dukker opp.
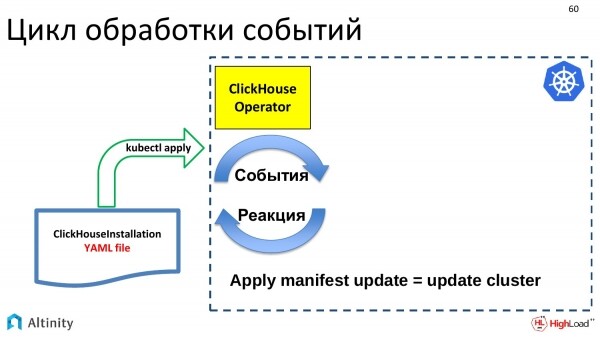
Hendelsene genereres av oppdateringer. Vår YAML-fil med beskrivelsen av ClickHouseInstallation kommer inn. Den går gjennom kubectl apply til etcd. Der trer det inn en hendelse, og denne hendelsen kommer til ClickHouse-operatøren. Operatøren mottar denne beskrivelsen. Og den må gjøre noe. Hvis det kommer en oppdatering på ClickHouseInstallation-objektet, så må klusteret oppdateres. Og operatørens oppgave er å oppdatere klusteret.
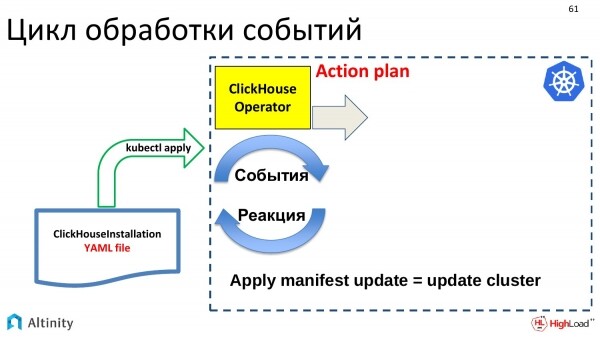
Hva gjør han? For det første må vi lage en handlingsplan for hva vi skal gjøre med denne oppdateringen. Oppdateringer kan være veldig små, dvs. små i YAML-implementeringen, men kan føre til store endringer i klusteret. Derfor lager operatøren en plan, og så følger han den.
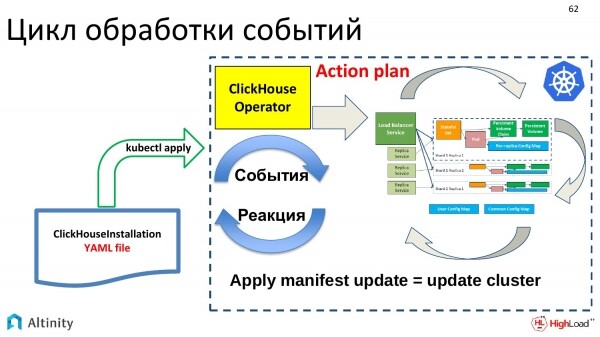
Han begynner i henhold til denne planen å lage strukturen internt for å materialisere podder, tjenester, dvs. gjøre det som er hans hovedoppgave. Det er som å bygge et ClickHouse-kluster i Kubernetes.
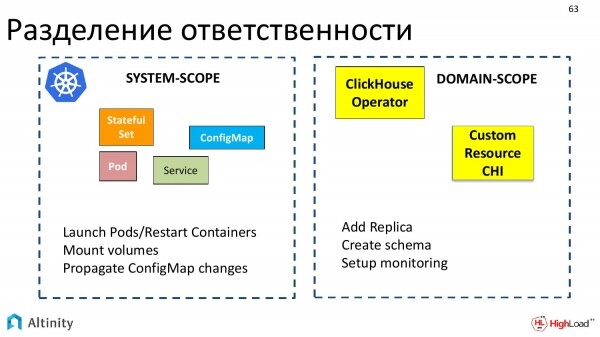
La oss nå se på noe interessant. Dette er ansvarsdelingen mellom Kubernetes og operatøren, dvs. hva Kubernetes gjør, hva operatøren gjør og hvordan de samhandler.
Kubernetes håndterer systemrelaterte ting, dvs. den grunnleggende sett med objekter som kan tolkes som systemomfang. Kubernetes vet hvordan man kjører podder, hvordan man restart containerne, hvordan man monterer volumer, hvordan man arbeider med ConfigMap, dvs. alt som kan kalles systemet.
Operatører opererer innenfor spesifikke domener. Hver operatør er laget for sitt spesifikke domene. Vi har laget for ClickHouse.
Og operatøren samhandler nettopp i termer av det spesifikke domenet, som å legge til en replika, lage et skjema, sette opp overvåkning. Det blir en slik inndeling.
La oss se på et praktisk eksempel på hvordan denne ansvarsdelingen skjer når vi utfører oppgaven med å legge til en replika.
Operatøren får i oppgave – å legge til en replika. Hva gjør operatøren? Operatøren beregner at det må lages en ny StatefulSet, hvor vi må beskrive bestemte maler, volumkrav.
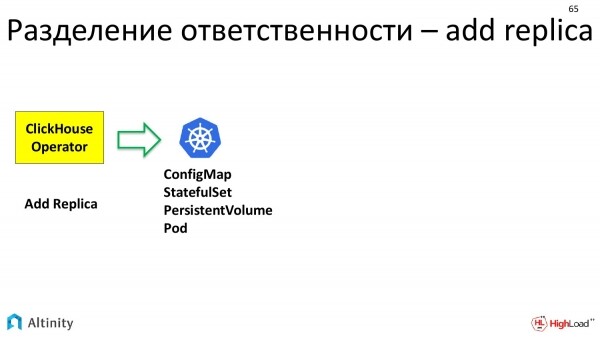
Han forbereder alt dette og sender det videre til K8s. Han sier at han trenger ConfigMap, StatefulSet, Volum. Kubernetes utfører oppgaven. Han materialiserer de grunnleggende enhetene som han opererer med.
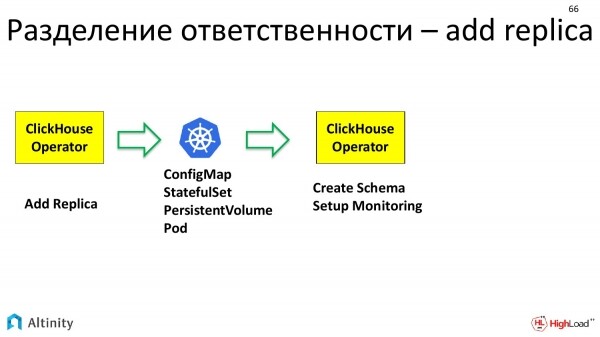
Og så kommer ClickHouse-operatøren inn i bildet igjen. Han har allerede en fysisk pod, hvor det kan gjøres noe. Og ClickHouse-operatøren jobber igjen i termer av det spesifikke domenet. For å aktivere en replika i klusteret må ClickHouse, for det første, konfigurere datamodellen som finnes i dette klusteret. Og for det andre, må denne replikas overvåking settes opp slik at den kan spores godt. Det er operatøren som konfigurerer dette.
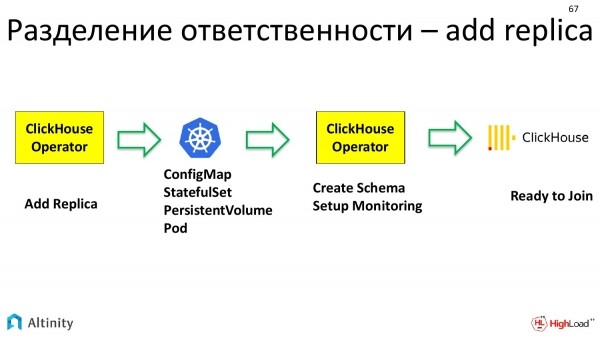
Og først etter dette kommer ClickHouse inn i bildet, det vil si en annen mer avansert enhet. Dette er allerede en database. Den har sin egen instans, en ny konfigurasjon av replikasjonen, klar til å bli med i klyngen.
Dermed blir kjeden av utførelse og ansvarsfordeling ved tillegging av replikas ganske lang.
La oss fortsette med våre praktiske oppgaver. Hvis klyngen allerede eksisterer, kan vi utføre migrering av konfigurasjonen.
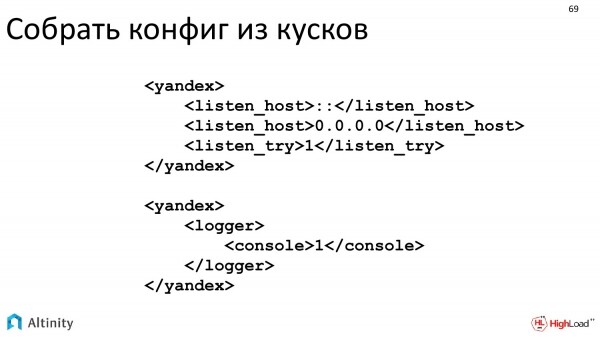
Vi har gjort det slik at vi kan legge inn data i den eksisterende XML-filen som ClickHouse forstår.
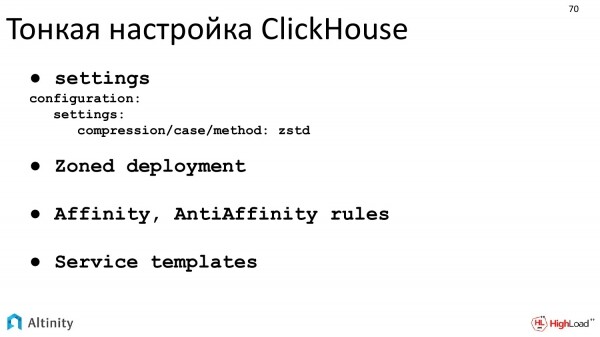
Det er mulig å gjøre en finjustering av ClickHouse. Nettopp zoned deployment – det er hva jeg snakket om da jeg forklarte hostPath, lokal lagring. Det handler om hvordan man gjør zoned deployment riktig.
Neste praktiske oppgave er overvåking.
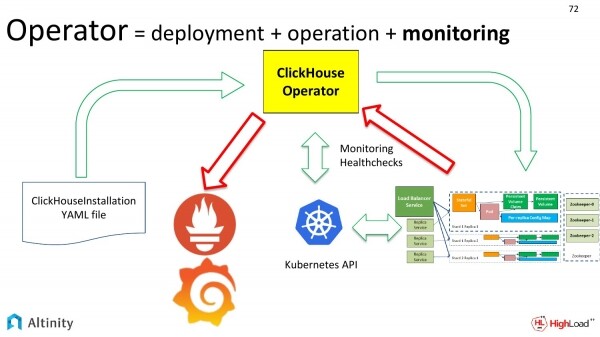
Hvis klyngen vår endres, må overvåkingen justeres regelmessig.
La oss se på diagrammet. Vi har allerede vurdert de grønne pilene. Nå la oss se på de røde pilene. Dette viser hvordan vi ønsker å overvåke klyngen vår. Hvordan metrikker fra ClickHouse-klyngen kommer inn i Prometheus og deretter til Grafana.
Hva er utfordringen med overvåking? Hvorfor betraktes det som en prestasjon? Utfordringen ligger nettopp i dynamikken. Når vi har én klynge som er statisk, kan vi sette opp overvåkingen én gang og så glemme den.
Men hvis vi har mange klynger, eller hvis noe stadig endres, er prosessen dynamisk. Og å stadig måtte justere overvåkingen er en ressurs- og tidskrevende oppgave, det vil si selv det krever litt latskap. Dette må automatiseres. Utfordringen ligger nettopp i prosessens dynamikk. Og operatøren automatiserer dette veldig godt.
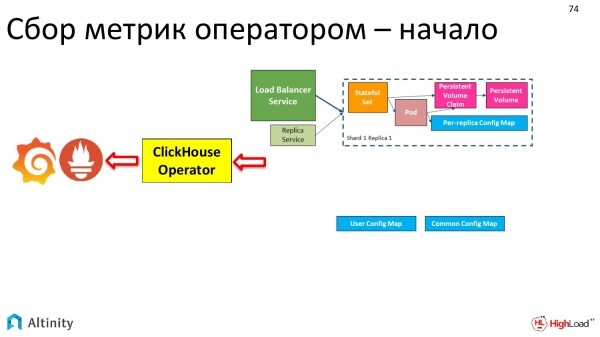
Hvordan har klyngen vår utviklet seg? I begynnelsen var den slik.
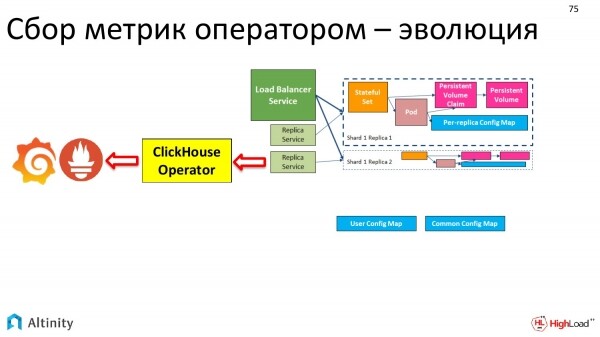
Så var den slik.
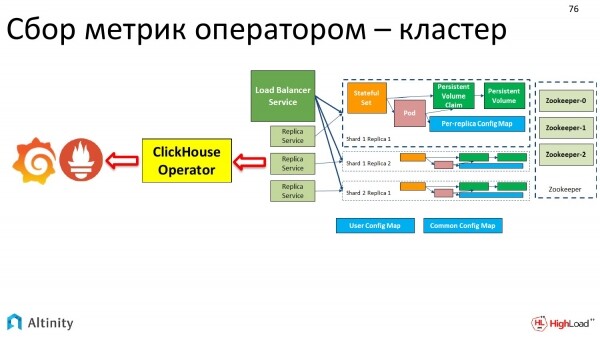
Til slutt ble den slik.
Og overvåkingen gjøres automatisk av operatøren. En inngangspunkt.
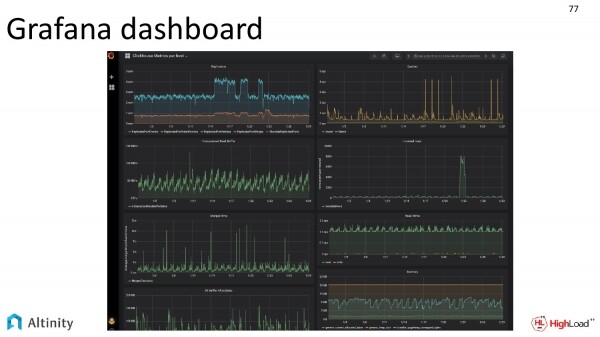
Og vi ser bare på utgangen i Grafana-dashbordet, hvordan livet i klyngen vår pulserer.
For øvrig blir Grafana-dashbordet også distribuert med operatøren vår rett fra kildekoden. Det er mulig å koble til og bruke. Dette skjermbildet fikk jeg fra vår DevOps.
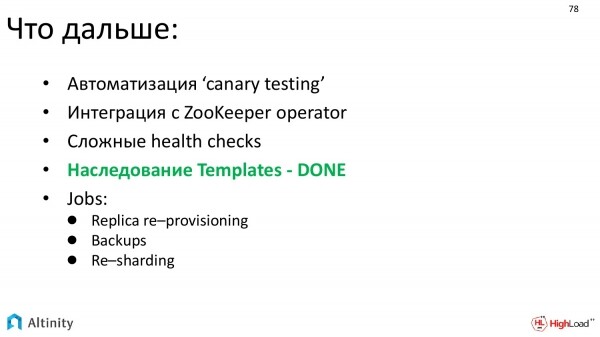
Hvor ønsker vi å gå videre? Det er:
- Å utvikle automatisering av testing. Hovedoppgaven er automatisk testing av nye versjoner.
- Vi ønsker også å automatisere integrasjonen med ZooKeeper. Planene inkluderer integrasjon med ZooKeeper-operatoren. Det vil si at det er skrevet en operator for ZooKeeper, og det er logisk at de to operatørene bør begynne å integreres for å bygge en mer brukervennlig løsning.
- Vi ønsker å gjøre mer avanserte livssykluskontroller.
- Jeg har markert grønt det som er i anmarsj: arven fra Templates – FERTIG, det vil si at med neste utgivelse av operatøren vil vi allerede ha arving av maler. Dette er et kraftig verktøy som lar oss bygge komplekse konfigurasjoner fra biter.
- Og vi ønsker automatisering av komplekse oppgaver. Den viktigste av disse er Re-sharding.
La oss oppsummere så langt.
Hva får vi ut av dette? Og er det verdt innsatsen eller ikke? Skulle vi i det hele tatt prøve å integrere databasen i Kubernetes og bruke operatøren generelt og Alitnity-operatøren spesielt?
Utgangen blir:
- Betydelig forenkling og automatisering av konfigurasjon, distribusjon og vedlikehold.
- Umiddelbart innebygd overvåking.
- Og klare, kodifiserte maler for komplekse situasjoner. Det er ikke lenger nødvendig å legge til en replika manuelt. Dette gjøres av operatøren.
Det er bare ett spørsmål igjen. Vi har allerede databasen i Kubernetes, virtualisering. Hvordan står det til med ytelsen til en slik løsning, spesielt med tanke på at ClickHouse er optimalisert for ytelse?
Svaret er – alt er i orden! Jeg vil ikke gå inn på detaljene, dette er et eget tema for en presentasjon.
Men det finnes et prosjekt som heter TSBS. Hva er hovedoppgaven? Det er en ytelsestesting av databaser. Det er et forsøk på å sammenligne varme med varme, myk med myk.
Hvordan fungerer det? Det genereres et datasett. Deretter kjøres dette datasettet gjennom et identisk sett med tester på forskjellige databaser. Hver database løser en oppgave på sitt eget måte. Deretter kan man sammenligne resultatene.
Det støtter allerede mange databaser. Jeg har markert tre hovedtyper. Disse er:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
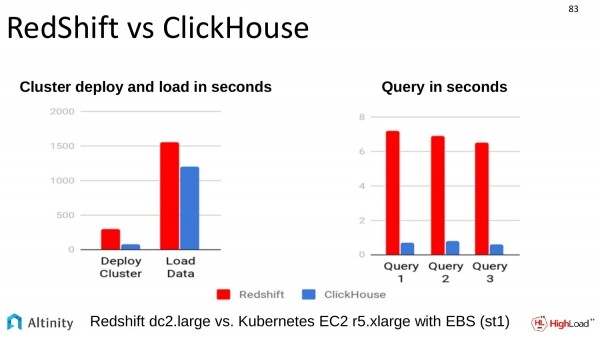
Det ble også gjort en sammenligning med en annen lignende løsning. Sammenligningen med RedShift. Sammenligningen ble gjort på Amazon. ClickHouse overgår også alle i denne sammenhengen.
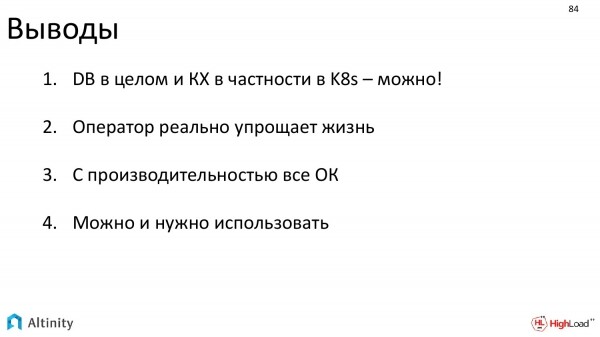
Hvilke konklusjoner kan vi trekke fra det jeg har fortalt?
- DB i Kubernetes er mulig. Kanskje alle kan være det, men generelt ser det ut til at det er mulig. ClickHouse i Kubernetes er absolutt mulig med hjelp fra vår operator.
- Operatoren hjelper med å automatisere prosesser og gjør livet enklere.
- Ytelsen er normal.
- Og vi mener at dette kan og bør brukes.
Open source – bli med!
Som jeg allerede har sagt, er operatoren et helt open source produkt, så det ville vært veldig bra om så mange som mulig bruker det. Bli med! Vi venter på dere alle!
Takk til alle!
Spørsmål
Takk for presentasjonen! Jeg heter Anton. Jeg er fra SEMrush. Jeg er interessert i logging. Vi hører om overvåking, men ingenting om logging når vi snakker om hele klyngen. Vi har for eksempel satt opp en klynge på eget utstyr. Og vi bruker sentralisert logging, samler med standardverktøy i en felles logg, og deretter henter vi ut interessante data.
Godt spørsmål, altså logging står på todo-listen. Vår operator automatiserer ikke dette for øyeblikket. Den er fortsatt under utvikling, prosjektet er fortsatt relativt ungt. Vi forstår nødvendigheten av logging. Dette er også et veldig viktig tema. Og det er kanskje ikke mindre viktig enn overvåking. Men det første på listen for implementering var overvåking. Logging vil komme. Vi gjør selvfølgelig vårt beste for å automatisere alle aspekter av klyngens livssyklus. Så svaret er – i øyeblikket kan ikke operatoren dette, men det er på planen, og vi vil gjøre det. Hvis noen har lyst til å bidra, så send inn en pull request, vær så snill.
Hei! Takk for presentasjonen! Jeg har et standardspørsmål knyttet til Persistent Volumes. Når vi oppretter en konfigurasjon med denne operatoren, hvordan bestemmer operatoren hvilken node vi har montert en disk eller mappe på? Må vi på forhånd forklare at vi ønsker å plassere vår ClickHouse nettopp på de nodene der det finnes disk?
Så vidt jeg forstår, er dette spørsmålet en fortsettelse av lokal lagring, spesielt delen som gjelder hostPath. Det er som å forklare hele systemet at pod'en må kjøre på en spesifikk node hvor vi har en fysisk tilkoblet disk som er montert på en spesifikk sti. Dette er en hel seksjon som jeg berørte veldig overfladisk fordi svaret er ganske omfattende.
Kort sagt ser det slik ut. Vi må selvfølgelig gjøre provisioning av disse volumene. Per nå finnes det ingen dynamisk provisioning i local storage, så DevOps må selv opprette diskene, disse volumene. De må forklare Kubernetes provisioning at du vil ha Persistent volumes av en bestemt klasse, som ligger på bestemte noder. Deretter må de forklare Kubernetes at pod'er som krever en bestemt klasse local storage, kun skal planlegges på de bestemte nodene basert på labels. For dette formålet har operatøren muligheten til å tildele en bestemt label og en per host-instans. Dermed vil pod'ene bli rutet av Kubernetes for å kjøre kun på noder som oppfyller kravene, labels, for å si det enkelt. Administratorene tildeler labels og gjør provisioning av diskene manuelt. Og så kan det skaleres.
Og nettopp det tredje alternativet for local storage hjelper litt med dette. Som jeg allerede har påpekt, er det et tidkrevende arbeid med konfigurasjon som ved sluttresultatet hjelper å oppnå maksimal ytelse.
Jeg har et annet spørsmål relatert til dette. Kubernetes var tenkt slik at vi ikke bryr oss om vi mister en node eller ikke. Hva gjør vi i dette tilfellet hvis vi mister noden der shard'en vår ligger?
Ja, Kubernetes ble opprinnelig posisjonert på den måten at vi behandler våre pod'er som storfe, mens her blir hver disk noe som ligner på et kjæledyr. Det er et problem at vi ikke bare kan kaste dem bort. Utviklingen av Kubernetes går i retning av at vi ikke kan forholde oss helt filosofisk til dette, som til helt avhendte ressurser.
Nå et praktisk spørsmål. Hva gjør du hvis du har mistet en node der disken var? Dette problemet løses allerede på et høyere nivå. I tilfellet med ClickHouse har vi replikater som fungerer på et høyere nivå, dvs. på ClickHouse-nivå.
Hva blir så disposisjonen? Det er DevOps som har ansvaret for at dataene ikke går tapt. Han må korrekt konfigurere replikasjonen og sørge for at replikasjonen utføres. Dataene må være duplisert i replikene på ClickHouse-nivå. Dette er ikke en oppgave som operatøren løser. Og det er ikke en oppgave som Kubernetes selv løser. Det er på ClickHouse-nivå.
Hva skal man gjøre hvis den fysiske noden din faller av? Det viser seg at du må sette opp en ny, riktig provisjonere en disk, og påføre etiketter. Etter dette vil den oppfylle kravene om at Kubernetes kan starte en instans av en pod på den. Kubernetes vil starte den. Antall pod-er dine er jo ikke tilstrekkelig i henhold til spesifikasjonene. Den vil gå gjennom syklusen som jeg viste. Og på det øverste nivået for ClickHouse vil det forstå at vår replika er kommet inn, den er fortsatt tom, og vi må begynne å overføre data til den. Det vil si at denne prosessen fortsatt er lite automatisert.
Takk for foredraget! Når det skjer uventede hendelser, faller operatøren og starter på nytt, mens hendelser inntreffer, hvordan håndterer dere dette?
Hva skjer hvis operatøren faller og starter på nytt, ikke sant?
Ja. Og i dette øyeblikket kom det hendelser.
Oppgaven om hva man skal gjøre i dette tilfellet deles delvis mellom operatøren og Kubernetes. Kubernetes har muligheten til å spille av den skjede hendelsen. Den spiller av. Og det er oppgaven til operatøren å sørge for at når hendelsene blir spilt på nytt, så er disse hendelsene idempotente. Og at en gjentatt inntreden av den samme hendelsen ikke bryter systemet vårt. Og vår operatør håndterer denne oppgaven.
Hei! Takk for foredraget! Dmitrij Zavyalov, selskapet Smedova. Er det planlagt å legge til muligheten for å konfigurere med haproxy i operatøren? Det ville vært interessant med en annen balansehåndterer enn standarden, slik at den er smart og forstår hva ClickHouse faktisk er.
Snakker du om Ingress?
Ja, å erstatte Ingress med haproxy. I haproxy kan man spesifisere topologien til klyngen, hvor replikene befinner seg.
Foreløpig har vi ikke tenkt på dette. Hvis dette er nødvendig for deg og du kan forklare hvorfor det er nødvendig, kan det realiseres, spesielt hvis du ønsker å delta. Vi vurderer det gjerne. Kort svar – nei, vi har ikke denne funksjonaliteten for øyeblikket. Takk for innspill, vi vil se på det. Og hvis du også forklarer bruksområdet og hvorfor det er nødvendig i praksis, for eksempel ved å opprette issues på GitHub, vil det være flott.
Det er allerede gjort.
Bra. Vi er åpne for alle forslag. Og haproxy legges til todo-listen. Todo-listen vokser, ikke minker ennå. Men det er bra, det betyr at produktet er etterspurt.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish