

I Linux finnes det en rekke verktøy for feilsøking av kjernen og applikasjoner. De fleste av dem påvirker applikasjonsytelsen negativt og kan ikke brukes i produksjon.
For et par år siden ble — eBPF. Det gir mulighet for sporing av kjernen og brukerapplikasjoner med lav overhead og uten behov for å kompilere programmer på nytt eller laste inn tredjepartsmoduler i kjernen.
I dag eksisterer det allerede flere applikasjonsverktøy som bruker eBPF, og i denne artikkelen skal vi se på hvordan man skriver et eget profileringsverktøy basert på biblioteken . Artikkelen er basert på virkelige hendelser. Vi vil gå fra oppdagelse av problemet til løsning, for å vise hvordan eksisterende verktøy kan brukes i spesifikke situasjoner.
Ceph Er Langsom
En ny vert ble lagt til i Ceph-klyngen. Etter å ha migrert en del data til den, la vi merke til at skriveforespørslene var betydelig langsommere enn på andre servere.
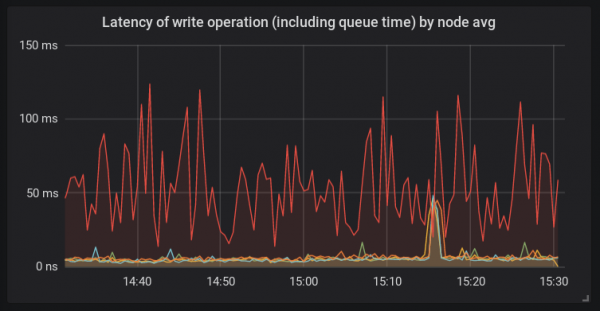
I motsetning til andre plattformer, ble det på denne verten brukt bcache og en ny linux-kjerne 4.15. Denne vertens konfigurasjon har vært brukt her for første gang. På det tidspunktet var det åpenbart at rotårsaken teoretisk kunne være hva som helst.
Undersøke Vert
La oss starte med å se på hva som skjer inne i ceph-osd-prosessen. For dette formålet skal vi bruke og (mer om dette kan leses ):
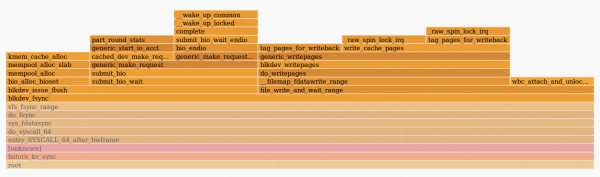
Bildet viser oss at funksjonen fdatasync() brukte mye tid på å sende en forespørsel til funksjonen generic_make_request(). Dette betyr at årsaken til problemene sannsynligvis er et sted utenfor selve osd-demonen. Det kan være enten kjernen eller diskene. Iostat-utdataene viste høy ventetid i behandlingen av forespørslene til bcache-diskene.
Ved sjekk av verten oppdaget vi at systemd-udevd-demonen bruker mye CPU-tid — omtrent 20% på flere kjerner. Denne merkelige oppførselen må undersøkes. Siden Systemd-udevd arbeider med ueventer, bestemte vi oss for å se på dem via udevadm monitor. Det viste seg at det ble generert et stort antall change-hendelser for hver blokk enhet i systemet. Dette er ganske uvanlig, så vi må se nærmere på hva som genererer alle disse hendelsene.
Bruke BCC Toolkit
Som vi allerede har funnet ut, bruker kjernen (og demon ceph i systemkallet) mye tid på generic_make_request(). La oss prøve å måle hastigheten på denne funksjonen. I finnes det en flott verktøy — funclatency. Vi vil spore demon etter PID-en hans med intervaller mellom utsendelser av informasjon på 1 sekund og skrive ut resultatet i millisekunder.
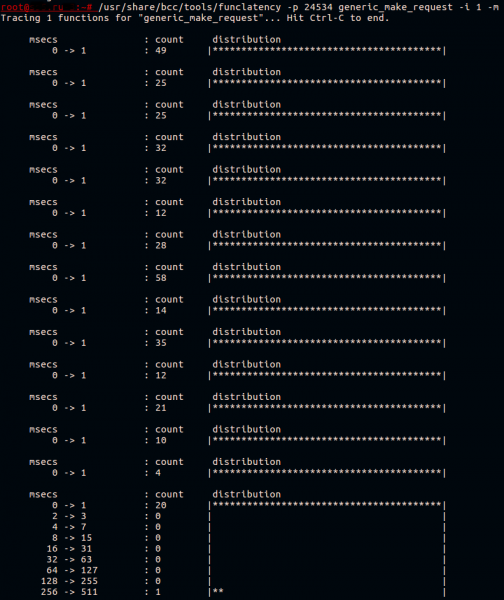
Vanligvis fungerer denne funksjonen raskt. Alt den gjør, er å sende forespørselen til enhetenes driverkø.
Bcache er en kompleks enhet som faktisk består av tre disker:
- backing device (cache-disken), i dette tilfellet en treg HDD;
- caching device (cache-enheten), her er det en del av NVMe-enheten;
- et virtuelt enhet bcache som applikasjonen jobber med.
Vi vet at overføring av forespørselen er treg, men for hvilken av disse enhetene? La oss finne ut av dette litt senere.
Akkurat nå vet vi at uevent-er sannsynligvis forårsaker problemer. Å finne ut hva som faktisk utløser dem, er ikke så enkelt. La oss anta at det er noen programvare som kjøres periodisk. Vi skal se hva slags programvare som kjører på systemet ved hjelp av skriptet execsnoop fra samme . La oss kjøre det og sende utdataene til en fil.
For eksempel slik:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Vi vil ikke gi den fullstendige utskriften av execsnoop her, men en linje som interesserer oss så slik ut:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Tredje kolonne er PPID (parent PID) for prosessen. Prosessen med PID 5802 viste seg å være én av trådene i overvåkingssystemet vårt. Ved kontroll av konfigurasjonen til overvåkingssystemet ble feilaktig angitte parametere funnet. Temperaturen til HBA-adapteren ble målt hvert 30. sekund, noe som var langt oftere enn nødvendig. Etter å ha endret måleintervallet til et lengre, oppdaget vi at forsinkelsen i forespørselshåndteringen på denne verten ikke lenger skilt seg ut fra de andre vertene.
Men det er fortsatt uklart hvorfor bcache-enheten så vanskelig. Vi forberedte en testplattform med identisk konfigurasjon og prøvde å gjenskape problemet ved å kjøre fio på bcache, samtidig som vi periodisk kjørte udevadm trigger for å generere uevents.
Skriving av BCC-baserte verktøy
La oss prøve å skrive et enkelt verktøy for å spore og vise de tregeste kallene generic_make_request(). Vi er også interessert i navnet på disken som denne funksjonen ble kalt for.
Planen er enkel:
- Vi registrerer kprobe En funksjon har blitt generic_make_request():
- Vi lagrar namnet på disken i minnet, tillgängligt via funktionsargumentet;
- Vi lagrar tidsstämpeln.
- Vi registrerer kretprobe vid återgång från generic_make_request():
- Vi får den aktuella tidsstämpeln;
- Vi letar efter den sparade tidsstämpeln och jämför den med den aktuella;
- Om resultatet är större än det angivna, hittar vi det sparade disknamnet och skriver ut det på terminalen.
Kprobes og kretprobes använder stoppunktsmekanismen för att ändra funktioners kod i farten. Du kan läsa en og artikel om detta. Om man tittar på koden av olika verktyg i , så kan man märka att de har en identisk struktur. Så vi kommer att hoppa över parsing av skriptets argument och gå direkt till själva BPF-programmet.
Texten eBPF inuti python-skriptet ser ut på följande sätt:
bpf_text = ''' # Här kommer BPF-programkoden '''
För datautbyte mellan funktioner använder eBPF-program . Så gör vi också. Som nyckel använder vi PID för processen, och som värde definierar vi strukturen:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Här registrerar vi en hash-tabell som kallas p, med nyckeltyp (i C ville vi definert et slikt array som och värdestyp struct data_t. Tabellen kommer att vara tillgänglig i vår BPF-programkontext. Makrot BPF_PERF_OUTPUT registrerar en annan tabell, kallad events, som används för till användarrummet.
Vid mätning av fördröjningar mellan funktionsanrop och återgång från dem, eller mellan anrop av olika funktioner, måste man ta hänsyn till att de erhållna uppgifterna måste tillhöra en och samma kontext. Med andra ord, det är viktigt att tänka på möjlig parallellkörning av funktioner. Vi har möjlighet att mäta fördröjningen mellan funktionsanrop i kontexten av en process och återgång från denna funktion i kontexten av en annan process, men det är troligen meningslöst. Ett bra exempel här kan vara , där nyckeln till hash-tabellen ställs in på pekaren till struct request, som representerar en begäran till disken.
Därefter behöver vi skriva kod som körs vid anrop av den undersökta funktionen:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Her vil den første argumentet til den påkalte funksjonen bli satt inn som det andre argumentet. . Etter dette får vi PID-en til prosessen vi jobber i, samt gjeldende tidsstempel i nanosekunder. Vi skriver alt dette i en nylig allokert struct data_t data. Navnet på disken henter vi fra strukturen bio, som sendes ved påkallelsen generic_make_request(), og lagrer det i samme struktur data. Det siste trinnet innebærer å legge til en oppføring i hash-tabellen nevnt tidligere.
Den neste funksjonen vil bli kalt ved retur fra generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts) / 1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Denne funksjonen ligner på den forrige: vi finner PID-en til prosessen og tidsstempelet, men allokerer ikke minne for en ny data-struktur. I stedet søker vi i hash-tabellen etter eksisterende struktur med nøkkelen lik gjeldende PID. Hvis strukturen finnes, finner vi navnet på den kjørende prosessen og legger det til.
Den binære skiftoperasjonen vi bruker her, er nødvendig for å få tråd-GID, det vil si PID-en til hovedprosessen som startet tråden, i konteksten vi jobber i. Den påkalte funksjonen returnerer både GID-en til tråden og dens PID i en enkelt 64-biters verdi.
Når vi skriver ut til terminalen, er vi ikke interessert i tråden, men i hovedprosessen. Etter å ha sammenlignet den oppnådde latensen med den angitte terskelen, overfører vi strukturen vår data til brukerrommet gjennom tabellen events, hvoretter vi sletter oppføringen fra p.
I Python-skriptet som vil laste denne koden, må vi erstatte MIN_US og FACTOR med latensgrenser og tidsenheter som vi vil overføre gjennom argumentene:
bpf_text = bpf_text.replace('MIN_US', str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR', 'data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR', '')
	label = "usec"
Nå må vi forberede BPF-programmet gjennom og registrere prøver:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request", fn_name="start")
b.attach_kretprobe(event="generic_make_request", fn_name="stop")
Vi må også definere struct data_t i skriptet vårt, ellers vil ingenting kunne leses:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Det siste steget er å skrive data til terminalen:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Selve skriptet er tilgjengelig på . La oss prøve å kjøre det på en testplattform der fio kjører, som skriver til bcache, og kalle udevadm monitor:
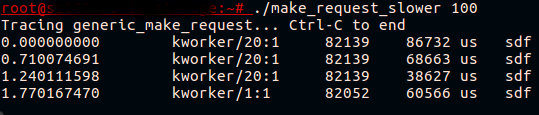
Endelig! Nå ser vi at det som så ut som et bcache-enhet som stoppa, faktisk var et stoppende kall generic_make_request() for den cachede disken.
Grav deg inn i kjernen
Hva sinker egentlig overføringen av forespørselen? Vi ser at forsinkelsen oppstår selv før selve regnskapet for forespørselen begynner, det vil si at registreringen av den spesifikke forespørselen for videre statistikk ( /proc/diskstats eller iostat) ikke har startet ennå. Dette kan enkelt sjekkes ved å kjøre iostat under reproduseringen av problemet, eller , som baseres på begynnelsen og slutten av regnskapet for forespørslene. Ingen av disse verktøyene vil vise problemer for forespørslene til den cachede disken.
Hvis vi ser på funksjonen generic_make_request(), vil vi se at før regnskapet for forespørselen starter, blir det kalt to andre funksjoner. Den første er generic_make_request_checks(), som utfører legitimitetskontroller av forespørselen i forhold til diskinnstillingene. Den andre er , som har et interessant kall :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
I den venter kjernen på å avfroste køen. La oss måle forsinkelsen blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Tracing 1 functions for "blk_queue_enter"... Hit Ctrl-C to end.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Det ser ut som om vi er nær en løsning. Funksjonene som brukes til "frysning/avfrysning" av køen er og . De blir brukt når det er nødvendig å endre innstillingene for køen av forespørselene, noe som potensielt kan være farlig for forespørslene i denne køen. Ved anrop blk_mq_freeze_queue() funksjonen inkrementeres telleren q->mq_freeze_depth. Etter dette venter kjernen på å tømme køen i .
Tiden som brukes på å tømme denne køen tilsvarer diskens forsinkelse, ettersom kjernen venter på at alle de forespurte operasjonene skal være fullført. Så snart køen er tom, påføres innstillingene. Deretter kalles , som dekrementerer telleren freeze_depth.
Nå vet vi nok til å rette opp situasjonen. Kommandoen udevadm trigger resulterer i at innstillingene for blokk enhetene blir anvendt. Disse innstillingene er beskrevet i udev-reglene. Vi kan finne ut hvilke innstillinger som «fryser» køen ved å prøve å endre dem gjennom sysfs eller se på kildekoden til kjernen. Vi kan også prøve verktøyet BCC , som vil vise kjernestacktrace og brukerrom for hvert anrop til blk_freeze_queue, for eksempel:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev-reglene endres sjelden og dette skjer som regel under kontroll. Så vi ser at selv anvendelsen av allerede angitte verdier forårsaker et tilfeldig tap i forespørselens forsinkelse fra applikasjonen til disken. Selvfølgelig er det ikke en god praksis å generere udev-hendelser når det ikke er noen endringer i diskens konfigurasjon (for eksempel når enheten ikke kobles til/kobles fra). Likevel kan vi hjelpe kjernen til ikke å utføre unødvendig arbeid og unngå å «fryse» forespørselens kø, hvis ikke nødvendig. fikser situasjonen.
Konklusjon
eBPF er et meget fleksibelt og kraftfullt verktøy. I artikkelen har vi sett på ett praktisk case og demonstrert en liten del av det som er mulig å gjøre. Hvis du er interessert i å utvikle BCC-verktøy, bør du sjekke ut , som godt beskriver grunnleggende bruk.
Det finnes også andre interessante verktøy for feilsøking og profilering basert på eBPF. Et av dem er , som lar deg skrive kraftfulle én-linjere og små programmer i et awk-lignende språk. Et annet er , som lar deg samle inn lavnivå, høyoppløselige målinger direkte til din prometheus-server, med mulighet for å få stilige visualiseringer og til og med varsler.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish