

Frykt for operasjoner, buffers som bringer...
La oss se på noen universelle tilnærminger for optimalisering av spørringer i PostgreSQL med et lite eksempel. Om du vil bruke dem eller ikke – det er opp til deg, men det er verdt å kjenne til dem.
I noen senere versjoner av PG kan situasjonen endre seg med en mer 'intelligent' planner, men for 9.4/9.6 ser det omtrent likt ut som eksemplene her.
Jeg tar en helt reell forespørsel:
SELECT
  TRUE
FROM
  "Dokument" d
INNER JOIN
  "DokumentUtvidelse" doc_ex
    USING("@Dokument")
INNER JOIN
  "Dokumenttype" t_doc ON
    t_doc."@Dokumenttype" = d."Dokumenttype"
WHERE
  (d."Låntaker3" = 19091 or d."Ansatt" = 19091) AND
  d."$Utkast" IS NULL AND
  d."Slettet" IS NOT TRUE AND
  doc_ex."Tilstand"[1] IS TRUE AND
  t_doc."Dokumenttype" = 'Planarbeid'
LIMIT 1;
om tabell- og felt navnMan kan se på «russiske» navne på felt og tabeller på forskjellige måter, men det er en smaksak. Siden ikke har utenlandske utviklere, og PostgreSQL lar oss gi navn selv i hieroglyfer, hvis de er innesluttet i anførselstegn, så foretrekker vi å navngi objekter klart og entydig for å unngå misforståelser.
La oss se på den resulterende planen:
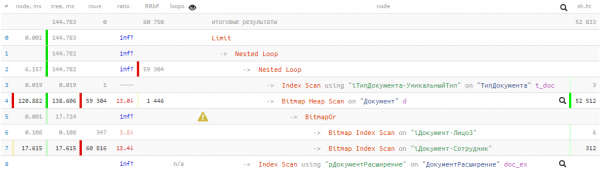
144ms og nesten 53K buffers — det vil si over 400MB data! Og vi er heldige hvis alle de er i cachen på tidspunktet for vår forespørsel, ellers vil den ta flere ganger lengre tid ved lesing fra disk.
Algoritmen er viktigst!
For å optimalisere en hvilken som helst forespørsel, må man først forstå hva den egentlig skal gjøre.
Vi lar utviklingen av selve databasedesignet ligge utenfor rammen av denne artikkelen og blir enige om at vi kan relativt 'billig' skrive om forespørselen og/eller påføre databasen nødvendige indekser.
Så, forespørselen:
— sjekker for eksistensen av minst ett dokument
— i den nødvendige tilstanden og av den spesifikke typen
— hvor forfatteren eller utføreren er den ansatte vi trenger
JOIN + LIMIT 1
Ofte er det enklere for utvikleren å skrive en forespørsel hvor de først gjør en sammenkobling av mange tabeller, og deretter ender opp med én enkelt post fra den mengden. Men enklere for utvikleren betyr ikke nødvendigvis mer effektivt for databasen.
I vårt tilfelle var det bare 3 tabeller – men hvilken effekt det ga...
La oss først bli kvitt sammenkoblingen med tabellen "Dokumenttype", og samtidig signalisere til databasen at typen av posten er unik (det vet vi, men planleggeren har ikke fått det med seg):
MED T SOM (
  SELECT
    "@Dokumenttype"
  FROM
    "Dokumenttype"
  WHERE
    "Dokumenttype" = 'Arbeidsplan'
  LIMIT 1
)
...
WHERE
  d."Dokumenttype" = (TABLE T)
...
Ja, hvis tabellen/CTE består av ett enkelt felt med ett enkelt registrering, kan man i PG skrive det slik, i stedet for
d."Dokumenttype" = (SELECT "@Dokumenttype" FROM T LIMIT 1)«Ferdig» beregning i PostgreSQL-spørsmål
BitmapOr vs UNION
I noen tilfeller kan Bitmap Heap Scan bli veldig kostbart for oss — for eksempel i vår situasjon, hvor mange oppføringer faller under det nødvendige kriteriet. Dette fikk vi på grunn av OR-betingelsen, som ble til BitmapOr-operasjonen i planen.
La oss gå tilbake til den opprinnelige oppgaven — vi må finne en oppføring som samsvarer med hvilket som helst av betingelsene — det er altså ikke nødvendig å søke gjennom alle 59K oppføringer for begge betingelsene. Det finnes en måte å håndtere en betingelse på, og gå videre til den andre først når det ikke ble funnet noe på den første. Vi får hjelp av en slik konstruksjon:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
«Ekstern» LIMIT 1 garanterer at søket stopper ved å finne den første oppføringen. Og hvis den finnes allerede i den første blokken, vil det andre ikke bli utført (never executed i planen).
«Skjule bak CASE» komplekse betingelser
I den opprinnelige forespørselen er det et ekstremt ubehagelig punkt — sjekken for tilstanden i den tilknyttede tabellen «Dokumentutvidelse». Uansett sannheten i de andre betingelsene i uttrykket (for eksempel, d.«Slettet» IS NOT TRUE), blir denne koblingen alltid utført og «koster ressurser». Mer eller mindre ressurser blir brukt — avhenger av størrelsen på denne tabellen.
Men vi kan endre forespørselen slik at søket etter den tilknyttede oppføringen kun skjer når det faktisk er nødvendig:
SELECT
  ...
FROM
  "Dokument" d
WHERE
  ...
/*index cond*/ AND
  CASE
    WHEN "$Utkast" IS NULL AND "Slettet" IS NOT TRUE THEN (
      SELECT
        "Tilstand"[1] IS TRUE
      FROM
        "Dokumentutvidelse"
      WHERE
        "@Dokument" = d."@Dokument"
    )
  END
Siden vi ikke trenger noen av feltene fra den tilknyttede tabellen, kan vi gjøre JOIN om til en betingelse i en underforespørsel.
La oss la indekserte felt være «utenfor» CASE, enkle betingelser på oppføringen legger vi inn i WHEN-blokken — og nå utføres «tunge» forespørselen kun når vi går inn i THEN.
Etternavnet mitt er «Totalt»
Vi samler den resulterende forespørselen med alle de ovenfor beskrevne mekanismene:
MED T SOM (
  SELECT
    "@DokumentType"
  FROM
    "DokumentType"
  WHERE
    "DokumentType" = 'Arbeidsplan'
)
  (
    SELECT
      TRUE
    FROM
      "Dokument" d
    WHERE
      ("Person3", "DokumentType") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Utkast" IS NULL AND "Slettet" IS NOT TRUE THEN (
          SELECT
            "Tilstand"[1] IS TRUE
          FROM
            "DokumentUtvidelse"
          WHERE
            "@Dokument" = d."@Dokument"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Dokument" d
    WHERE
      ("DokumentType", "Ansatt") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Utkast" IS NULL AND "Slettet" IS NOT TRUE THEN (
          SELECT
            "Tilstand"[1] IS TRUE
          FROM
            "DokumentUtvidelse"
          WHERE
            "@Dokument" = d."@Dokument"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Tilpasser [til] indekser
Det trenede øyet la merke til at de indekserte forholdene i UNION-underdelene varierer litt — dette fordi vi allerede har passende indekser på tabellen. Og hvis de ikke hadde vært der — så ville det vært nødvendig å opprette dem: Dokument(Person3, DokumentType) og Dokument(DokumentType, Ansatt).
om rekkefølgen av feltene i ROW-forholdFra planleggerens synspunkt kan man selvsagt skrive også (A, B) = (constA, constB), og (B, A) = (constB, constA). Men når man skriver i rekkefølgen av feltene i indeksen, så er en slik forespørsel bare lettere å feilsøke senere.
Hva er planen?
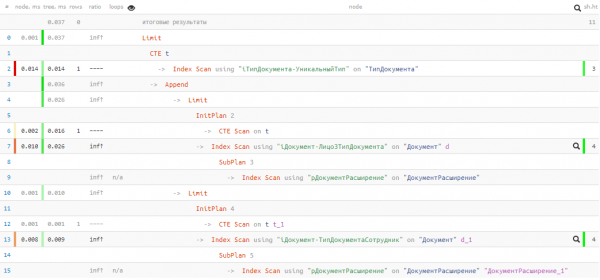
Dessverre fikk vi ikke hell, og i den første UNION-blokken ble det ikke funnet noe, så den andre ble likevel kjørt. Men selv da — bare 0.037ms og 11 buffere!
Vi har akselerert forespørselen og redusert "dataoverføringen" i minnet flere tusen ganger, ved å bruke ganske enkle metoder — et godt resultat med lite kopiering og liming. 🙂
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish