

Kjære lesere, god dag!
Utviklingen av IT-plattformer for å samle og analysere data vil før eller siden bli aktuelt for enhver bedrift som baserer seg på en intellektuelt krevende tjenestemodell eller skapelsen av teknisk komplekse produkter. Å bygge analytiske plattformer er en komplisert og tidkrevende oppgave. Men enhver oppgave kan forenkles. I denne artikkelen ønsker jeg å dele erfaringer med bruk av low-code-verktøy som hjelper til med å lage analytiske løsninger. Denne erfaringen ble oppnådd gjennom implementeringen av en rekke prosjekter innen Big Data Solutions i selskapet «Neoflex». Big Data Solutions avdelingen i «Neoflex» har siden 2005 jobbet med spørsmål knyttet til bygging av datalagre og dataviker, løst oppgaver knyttet til optimalisering av hastigheten på informasjonsbehandling og arbeidet med metodologi for datakvalitetsstyring.
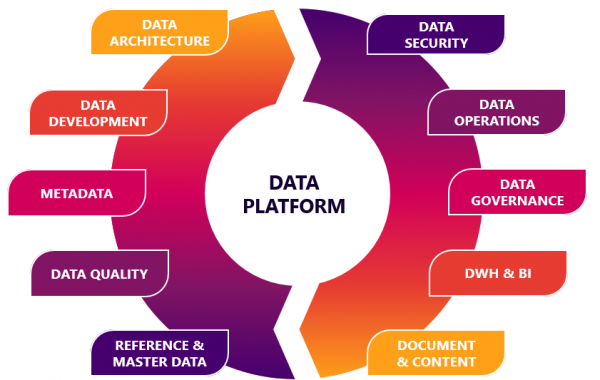
Å unngå bevisst akkumulering av svakt og/eller sterkt strukturerte data vil være umulig for noen. Kanskje selv for små bedrifter. For når en lovende entreprenør skal skalere opp driften, vil han bli møtt med spørsmål om å utvikle et lojalitetsprogram, vil ønske å analysere effektiviteten av salgssteder, tenke på målrettet reklame og bekymre seg for etterspørselen etter tilleggsprodukter. I første omgang kan oppgaven løses "omedelbart". Men når virksomheten vokser, vil overgangen til en analytisk plattform bli uunngåelig.
Men når kan dataanalytiske oppgaver bli til oppgaver av klasse «Rocket Science»? Kanskje i det øyeblikket vi snakker om virkelig store data.
For å forenkle «Rocket Science»-oppgaven, kan man spise en elefant bit for bit.
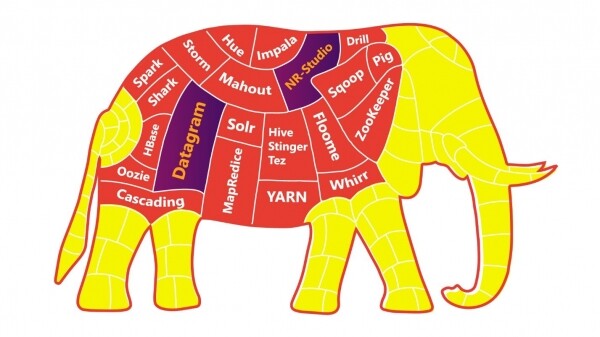
Jo større diskrete og autonome dine applikasjoner/tjenester/mikrotjenester er, jo lettere vil det være for deg, kollegene dine og hele virksomheten å fordøye elefanten.
Denne posten ble bekreftet av nesten alle våre kunder, som omorganiserte landskapet basert på ingeniørpraksis fra DevOps-team.
Men selv med en «separert, elefant-diett» har vi gode sjanser for «overmetting» av IT-landskapet. I dette øyeblikket er det verdt å stoppe opp, trekke pusten og se mot low-code engineering platform.
Mange utviklere frykter utsiktene til å havne i en karrierestopp ved å gå bort fra direkte koding til å «dra» på grensesnitt i low-code systemer. Men fremkomsten av maskiner førte ikke til ingeniørers forsvinning, men hevet arbeidet deres til et nytt nivå!
La oss finne ut hvorfor.
Dataanalyse innen logistikk, telekommunikasjonsbransjen, medieforskning og finanssektoren er alltid knyttet til følgende spørsmål:
- Hastigheten på automatisert analyse;
- Muligheten for å gjennomføre eksperimenter uten å påvirke hovedstrømmen av databehandling;
- Troverdighet av de forberedte dataene;
- Sporing av endringer og versjonering;
- Data provenance, Data lineage, CDC;
- Rask levering av nye funksjoner til produksjonsmiljøet;
- Og det berømte: kostnadene ved utvikling og vedlikehold.
Det vil si at ingeniører har et stort antall høynivåoppgaver som bare kan utføres med tilstrekkelig effektivitet når de har renset tankene fra lavnivå utviklingsoppgaver.
Forutsetningene for at utviklere går over til et nytt nivå har vært evolusjonen og digitaliseringen av virksomheter. Verdien av utvikleren endres også: det er en betydelig mangel på utviklere som kan dykke inn i essensen av konseptene for automatisert virksomhet.
La oss lage en analogi med lavnivå og høynivå programmeringsspråk. Overgangen fra lavnivåspråk til høynivåspråk er overgangen fra å skrive «direkte direktiver på maskinspråk» til å skrive «direktiver på menneskespråk». Dette betyr å legge til et lag av abstraksjon. I så fall er overgangen til low-code plattformer fra høynivå programmeringsspråk en overgang fra «direktiver på menneskespråk» til «direktiver på forretningsspråk». Skulle det finnes utviklere som blir triste av denne realiteten, så kan det hende de allerede har vært triste siden JavaScript ble introdusert, hvor sorteringsfunksjoner for arrayer benyttes. Og disse funksjonene har selvfølgelig en programvareimplementering bak seg med andre midler fra samme høynivå programmering.
Derfor er low-code bare en ny nivå av abstraksjon.
Praktisk erfaring med bruk av low-code.
Tema low-code er ganske omfattende, men nå vil jeg gjerne snakke om praktisk tilnærming av "lågekodekonsepter" med et eksempel fra et av våre prosjekter.
Avdelingen Big Data Solutions i selskapet "Neoflex" spesialiserer seg i stor grad på finanssektoren, og bygger datalager og datavann og automatiserer ulike rapporteringer. I denne nisjen har bruken av low-code lenge blitt en standard. Blant de ulike low-code-verktøyene kan man nevne verktøy for organisering av ETL-prosesser: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Eller Oracle Apex, som fungerer som en plattform for rask utvikling av brukergrensesnitt for tilgang til og redigering av data. Imidlertid innebærer bruken av lavkodeutviklingsverktøy ikke alltid konstruksjonen av nisjeprogrammer på en kommersiell teknologistabel med en tydelig avhengighet av leverandøren.
Med low-code-plattformer kan man også organisere orkestrering av datastreamer, opprette data science-plattformer eller for eksempel moduler for datakvalitetskontroll.
Et av de praktiske eksemplene på erfaringen med bruk av lavkodeutviklingsverktøy er samarbeidet mellom "Neoflex" og selskapet Mediascope, en av lederne innen det russiske medieforskningsmarkedet. En av forretningsoppgavene til dette selskapet er produksjon av data som gjør at annonsører, nettplattformer, TV-kanaler, radiostasjoner, reklamebyråer og merker kan ta beslutninger om kjøp av reklame og planlegge markedsføringskommunikasjonene sine.
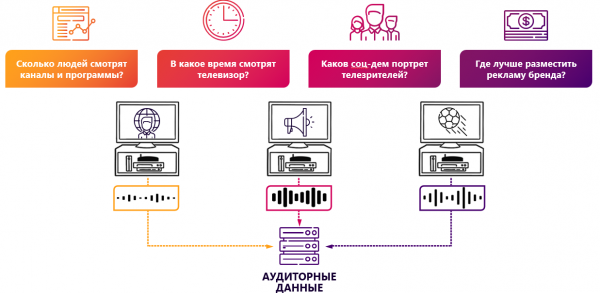
Medieforskning er en teknologisk kompleks virksomhet. Gjenkjenning av videoinnhold, innsamling av data fra enheter som analyserer seing, måling av aktivitet på nettressurser – alt dette innebærer at selskapet må ha stor IT-støtte og enorm erfaring i å bygge analytiske løsninger. Men den eksponentielle veksten i mengden informasjon, samt antall og mangfold av kildene, tvinger data-IT-industrien til å stadig utvikle seg. Den enkleste løsningen for skalering av den allerede fungerende analytiske plattformen Mediascope kunne vært å ansette flere IT-ansatte. Men en langt mer effektiv løsning er å akselerere utviklingsprosessen. Ett av stegene som kan føre i denne retningen, kan være bruken av low-code-plattformer.
Ved prosjektstart hadde selskapet allerede en fungerende produktløsning. Imidlertid kunne løsningen basert på MSSQL ikke fullt ut oppfylle forventningene om skalerbarhet med akseptable kostnader for tilpassinger.
Oppgaven vi stod overfor var virkelig ambisiøs – Neoflex og Mediascope skulle lage en industriell løsning på mindre enn ett år, med krav om å lansere MVP i løpet av første kvartal fra startdato.
Som grunnlag for byggingen av den nye dataplattformen, basert på low-code-beregninger, ble teknologi-stakken Hadoop valgt. Standard for datalagring ble HDFS med bruk av filer i parquet-format. For tilgang til dataene i plattformen ble Hive brukt, hvor alle tilgjengelige datamodeller presenteres som eksterne tabeller. Datainnhenting i lagringen ble realisert ved hjelp av Kafka og Apache NiFi.
Low-code-verktøyet i dette konseptet ble brukt for å optimalisere den mest arbeidsintensive oppgaven ved byggingen av en analyseplattform – databeløpningen.
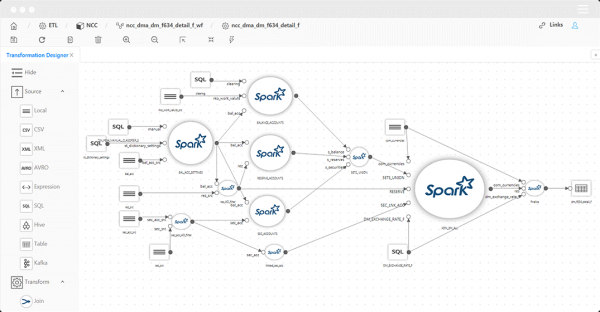
Hovedmekanismen for datamapping ble valgt som low-code-verktøyet Datagram. Neoflex Datagram er et verktøy for utvikling av transformasjoner og datastreams.
Ved å bruke dette verktøyet, kan man klare seg uten å skrive Scala-kode «manuelt». Scala-kode genereres automatisk ved hjelp av tilnærmingen Model Driven Architecture.
En åpenbar fordel med denne tilnærmingen er akselerasjonen av utviklingsprosessen. Men i tillegg til hastighet er det også følgende fordeler:
- Visning av innhold og struktur av kilder/mottakere;
- Sporing av opprinnelsen til objekter i datastreamen ned til enkeltfelt (lineage);
- Delvis utføring av transformasjoner med visning av mellomresultater;
- Visning av kildekoden og justering før utførelse;
- Automatisk validering av transformasjoner;
- Automatisk lastet ned data 1 til 1.
Inngangsterskottet for low-code-løsninger for generering av transformasjoner er ganske lavt: utvikleren må ha kunnskap om SQL og erfaring med ETL-verktøy. Det er verdt å merke seg at code-driven-transformasjonsgeneratorer ikke er ETL-verktøy i bred forstand. Low-code-verktøy kan mangle sitt eget miljø for å kjøre koden. Det vil si at den genererte koden vil bli kjørt i det miljøet som allerede eksisterte i klyngen før installasjonen av low-code-løsningen. Dette er nok en fordel for low-code, ettersom en "klassisk" utviklingsteam kan arbeide parallelt og implementere funksjonalitet, for eksempel i ren Scala-kode. Innføringen av forbedringer fra begge team i produksjon vil være enkel og "sømløs".
Det er verdt å nevne at i tillegg til low-code finnes det også no-code-løsninger. I sin natur er de ulike. Low-code lar i større grad utvikleren gripe inn i den genererte koden. I tilfelle av Datagram er det mulig å se og redigere den genererte Scala-koden, mens no-code kanskje ikke tilbyr denne muligheten. Denne forskjellen er betydelig både når det gjelder fleksibilitet i løsningen og komfort og motivasjon for dataingeniører i arbeidet.
Løsningens arkitektur
La oss prøve å undersøke hvordan low-code-verktøyet hjelper med å løse oppgaven med å optimalisere hastigheten på utviklingen av funksjoner for databehandling. Først bør vi se på den funksjonelle arkitekturen til systemet. I dette tilfellet er et eksempel modellen for dataproduksjon for medieforskning.
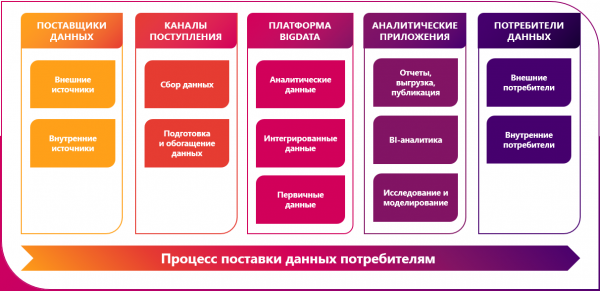
Datakildene i vårt tilfelle er svært varierte og mangfoldige:
- Pipiemetre (TV-metre) er programvare- og maskinvarer som leser brukeratferd hos respondentene i TV-panelet – hvem, når og hvilken TV-kanal som ble sett i husholdningen som deltar i undersøkelsen. Den leverte informasjonen er en strøm av intervaller for TV-seing koblet til mediepakken og medieproduktet. Dataene på lastetrinnet til Data Lake kan berikes med demografiske attributter, kobling til geostrat, tidssone og annen informasjon som er nødvendig for å analysere TV-seing av et bestemt medieprodukt. Målingene kan brukes til å analysere eller planlegge reklamekampanjer, vurdere publikumets aktivitet og preferanser, samt lage sendeskjemaer;
- Dataene kan komme fra systemer for overvåking av strømmende TV-sendinger og måling av seing av innhold på videoressurser på internett;
- Målingsverktøy i web-miljøet, både site-centric og user-centric tellere. Dataleverandører for Data Lake kan også være en nettleserutvidelse som research bar og en mobilapplikasjon med innebygde VPN.
- Data kan også komme fra plattformer som konsoliderer resultater fra utfylte nettundersøkelser og resultatene fra telefonintervjuer i selskapets spørreundersøkelser;
- Ytterligere berikelse av data lake kan skje ved å laste opp informasjon fra loggene til samarbeidspartnerne.
Implementeringen av as is-lasting fra kildesystemene til primær staging av rådata kan organiseres på ulike måter. Ved å bruke low-code for disse formålene er automatisk generering av lasterutiner basert på metadata mulig. Det er ikke nødvendig å gå ned til utviklingsnivå for mappene fra kilde til mål. For å realisere den automatiske lastingen må vi koble til kilden og deretter definere listen over enhetene som skal lastes inn i grensesnittet for lasting. Opprettelse av katalogstrukturen i HDFS vil skje automatisk og vil være i samsvar med datalagringsstrukturen i kildesystemet.
Men i konteksten av dette prosjektet har vi besluttet å ikke bruke mulighetene til low-code-plattformen, ettersom selskapet Mediascope allerede har begynt arbeidet med å lage en tilsvarende tjeneste basert på Nifi + Kafka.
Det er viktig å merke seg at disse verktøyene ikke er utskiftbare, men snarere komplementære. Nifi og Kafka kan operere i både direkte (Nifi -> Kafka) og omvendt (Kafka -> Nifi) forbindelse. Den første varianten ble brukt for medieforskningsplattformen.
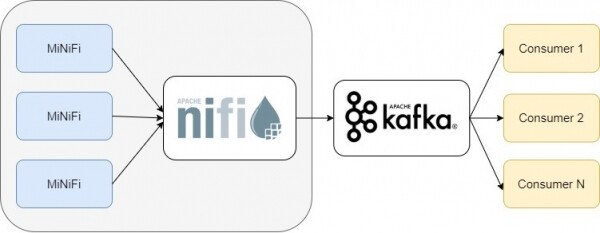
I vårt tilfelle måtte Nifi behandle forskjellige datatyper fra kildesystemer og sende dem til Kafka-broker. Retningen på meldingene til en bestemt Kafka-topikk ble gjort ved hjelp av Nifi-prosessorer PublishKafka. Orkestrering og vedlikehold av disse pipeline'ene skjer i en visuell grensesnitt. Nifi-verktøyet og bruken av Nifi + Kafka kan også beskrives som en lavkode-tilnærming til utvikling, som har lav inngangsbarriere til Big Data-teknologier og akselererer utviklingsprosessen for applikasjoner.
Neste trinn i prosjektimplementeringen var å bringe detaljert data til et ensartet semantisk lagformat. Hvis en enhet har historiske attributter, skjer beregningen i sammenheng med den aktuelle partisjonen. Hvis enheten derimot ikke er historisk, kan enten en totalberegning av objektets innhold utføres, eller man kan helt avstå fra en beregning (på grunn av mangel på endringer). I denne fasen genereres nøkler for alle enheter. Nøklene lagres i de relevante master-objektkatalogene i Hbase, som inneholder korrespondansen mellom nøklene i analyseplattformen og nøklene fra kildesystemene. Konsolideringen av atomære enheter følger med berikelsen av resultatene fra den foreløpige beregningen av analytiske data. Frameworket for databehandlingen var Spark. Den beskrevne funksjonaliteten for å bringe data til en enhetlig semantikk ble også implementert basert på kartleggingene fra lavkodeverktøyet Datagram.
I den målrettede arkitekturen var det nødvendig å sikre SQL-tilgang til dataene for forretningsbrukere. For dette alternativet ble Hive brukt. Registreringen av objekter i Hive skjer automatisk når alternativet «Registr Hive Table» er aktivert i lavkodeverktøyet.
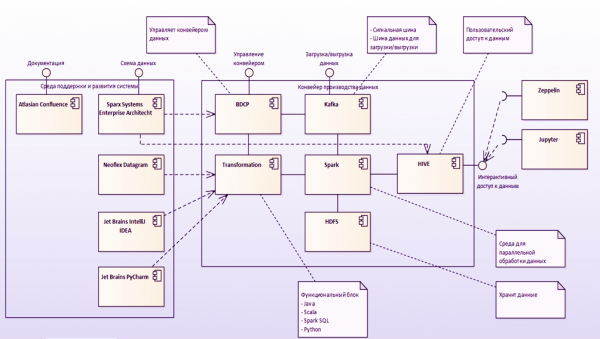
Styring av beregningsflyten
Datagram har et grensesnitt for å designe arbeidsflyter. Kjøring av kartlegginger kan gjøres ved hjelp av Oozie-planleggeren. I utviklergrensesnittet for arbeidsflyter kan man opprette skjemaer for parallell, sekvensiell eller betinget utførelse av datatransformasjoner. Det er støtte for shell scripts og java-programmer. Det er også mulig å bruke serveren Apache Livy. Apache Livy brukes til å kjøre applikasjoner direkte fra utviklingsmiljøet.
Hvis selskapet allerede har sin egen prosessorkestrator, kan REST API brukes for å integrere kartlegginger i den eksisterende arbeidsflyten. For eksempel har vi hatt ganske god erfaring med å integrere kartlegginger skrevet i Scala inn i orkerstratorer skrevet i PLSQL og Kotlin. REST API for lavkodeverktøyet innebærer operasjoner som generering av kjørbar fil basert på kartleggingsdesign, kall av kartlegging, kall av sekvenser av kartlegginger, og selvfølgelig overføring av URL-parametere for kjøring av kartlegginger.
Sammen med Oozie er det også mulig å organisere beregningsflyt gjennom Airflow. Jeg vil ikke bruke lang tid på å sammenligne Oozie og Airflow, men vil bare si at i konteksten av mediaforskningsprosjektet falt valget på Airflow. De viktigste argumentene denne gangen var et mer aktivt fellesskap som utvikler produktet, og et mer utviklet grensesnitt + API.
Airflow er også bra fordi det bruker det mange elsker, Python, for å beskrive beregningsprosesser. Generelt er det ikke så mange åpne kildekodeverktøy for arbeidsflytstyring. Kjøring og overvåking av prosessutførelse (inkludert med Gantt-diagram) gir bare flere poeng til Airflow.
Formatet på konfigurasjonsfilen for kjøring av kartlegginger i lavkode-løsningen ble spark-submit. Dette skjedde av to grunner. For det første tillater spark-submit å kjøre en jar-fil direkte fra konsollen. For det andre kan den inneholde all nødvendig informasjon for å konfigurere arbeidsflyten (som forenkler skriving av skripter som danner Dag).
Det mest vanlige elementet i Airflow-arbeidsflyten i vårt tilfelle ble SparkSubmitOperator.
SparkSubmitOperator gjør det mulig å kjøre jar-filer — pakkede kartlegginger fra Datagram med forhåndsdefinerte inngangsparametere.
Det er verdt å merke seg at hver Airflow-oppgave kjører i en egen tråd og ikke kjenner til andre oppgaver. Derfor skjer samhandling mellom oppgavene ved hjelp av kontrolloperatører, som DummyOperator eller BranchPythonOperator.
Kombinasjonen av bruken av low-code-løsningen Datagram med universaliseringen av konfigurasjonsfilene (som danner Dag) har ført til en betydelig akselerasjon og forenkling av utviklingsprosessen for datainnlasting.
Beregning av datavisninger
Kanskje det mest intellektuelt krevende stadiet i produksjonen av analytiske data er trinnet med å bygge datavisninger. I konteksten av en av databehandlingsstrømmene til et forskningsselskap skjer det på dette stadiet en tilpasning til standardoversettelsen, med hensyn til tidssoner knyttet til sendenettverket. Det kan også være en tilpasning til det lokale sendingesystemet (lokale nyheter og reklame). I tillegg utføres det på dette stadiet en oppdeling av intervaller for kontinuerlig visning av medieprodukter basert på analyse av visningsintervaller. Her skjer også "vektlegging" av seertallene basert på informasjon om deres betydning (beregning av korrigeringskoeffisienten).
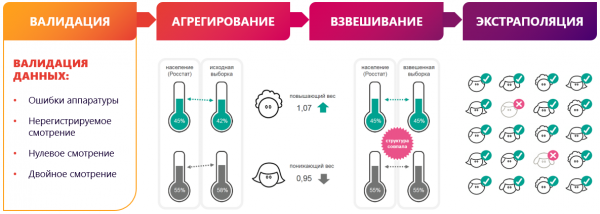
Et av trinnene i forberedelsen av datavisningene er validering av data. Valideringsalgoritmen er knyttet til anvendelsen av en rekke matematiske science-modeller. Imidlertid gjør bruken av en low-code-plattform det mulig å dele opp den komplekse algoritmen i en rekke visuelle kartlegginger som kan leses. Hver av kartleggingene utfører en spesifikk oppgave. Som følge av dette er det mulig med mellomliggende feilsøking, logging og visualisering av trinnene i datatilberedningen.
Det ble besluttet å diskriminere valideringsalgoritmen i følgende undertrinn:
- Bygging av regresjonsavhengigheter for seertallene til TV-nettverket i regionen mot seertallene for alle nettverk i regionen over en 60-dagers periode.
- Beregning av studentiserte rester (avviket mellom faktiske verdier og de predikerte verdiene fra regresjonsmodellen) for alle regresjonspunkter og for den beregnede dagen.
- Utvelgelse av anomale par av region-TV-nettverk, der den studentiserte resten for den beregnede dagen overskrider normen (angitt av operasjonsinnstillingen).
- Gjenberegning av justert studentisert rester for anomaløse par region-teleklynge for hver respondent som så nettverket i regionen, med bestemmelse av bidraget fra denne respondenten (mengde endring i studentisert reste) ved ekskludering av denne respondentens visning fra utvalget.
- Søke etter kandidater som, når de ekskluderes, får det studentiserte restetallet på beregningsdagen til å normalisere seg.
Det ovenstående eksempelet er en bekreftelse på hypotesen om at en dataingeniør allerede har for mye å tenke på… Og hvis dette virkelig er en 'ingeniør' og ikke bare en 'koder', så bør frykten for profesjonell nedgradering ved bruk av low-code verktøy være helt borte.
Hva mer kan low-code gjøre?
Området for anvendelse av low-code verktøyet for batch- og strømming av databehandling uten behov for manuell koding i Scala er ikke begrenset.
Bruken av low-code i utviklingen av datalake-er har blitt en viss standard for oss. Man kan kanskje si at løsninger på Hadoop-stakken følger utviklingsveien til klassiske DWH basert på RDBMS. Low-code verktøy på Hadoop-stakken kan håndtere både databehandlingsoppgaver og oppgaver knyttet til bygging av endelige BI-grensesnitt. Det er verdt å merke seg at BI kan forstås ikke bare som representasjon av data, men også som redigering av dem av forretningsbrukere. Denne funksjonaliteten brukes ofte av oss ved bygging av analytiske plattformer for finanssektoren.
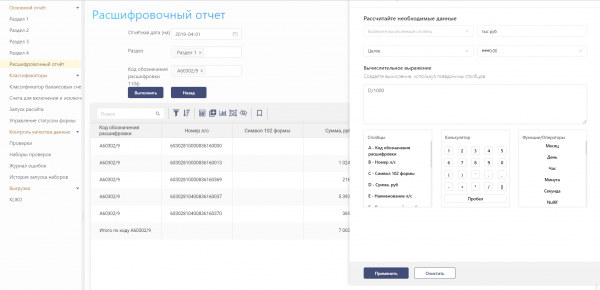
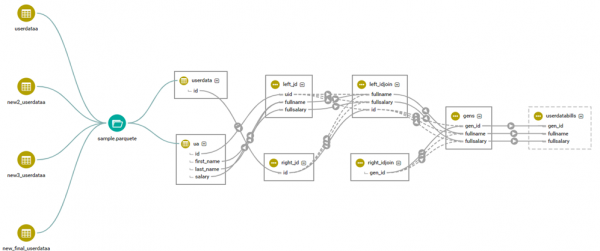
Blant annet gjør low-code og spesielt Datagram det mulig å spore opprinnelsen til datastreamobjekter med atomaritet ned til individuelle felt (lineage). For dette er det implementert kobling til Apache Atlas og Cloudera Navigator i low-code-verktøyet. I essensen må utvikleren registrere et sett med objekter i Atlas-ordbøker og referere til de registrerte objektene når man bygger kartlegginger. Mekanismen for sporing av datatilhørighet eller analyse av objekters avhengigheter sparer betydelig tid når det er behov for å gjøre endringer i beregningsalgoritmene. For eksempel, ved utarbeidelse av finansielle rapporter, gjør dette grepet det lettere å håndtere endringer i lovgivningen. Jo bedre vi forstår mellomformelle avhengigheter når det gjelder objekter i detaljerte lag, desto færre «brå» feil vil vi møte, og vi reduserer antall rework.
Data Kvalitet & Low-code
En annen oppgave implementert av low-code-verktøyet i prosjektet til Mediascope, var oppgaven innen Data Kvalitet. En spesiell faktor ved implementeringen av datakontrolleren for forskningsselskapet var fraværet av påvirkning på funksjonaliteten og hastigheten til den viktigste databehandlingsstrømmen. For å muliggjøre orkestrering av uavhengige datakontrollstrømmer ble den velkjente Apache Airflow benyttet. Så snart hvert trinn i dataproduksjonen var klart, ble den separate delen av DQ-linjen parallelt startet.
Det anses som god praksis å overvåke datakvaliteten fra øyeblikket de blir generert i den analytiske plattformen. Med informasjon om metadatene kan vi allerede fra det øyeblikket informasjonen kommer inn i primærlaget, kontrollere overholdelse av grunnleggende betingelser — not null, constraints, foreign keys. Denne funksjonaliteten er basert på automatisk genererte kartlegginger av datakvalitetfamilien i Datagram. Kodegenereringen i dette tilfellet er også basert på metadata-modellen. I prosjektet til Mediascope ble koblingen gjort med metadataene fra produktet Enterprise Architect.
Takket være koblingen mellom low-code-verktøyet og Enterprise Architect ble følgende kontroller generert automatisk:
- Kontroll av tilstedeværelse av "null"-verdier i felt med modifikatoren "not null";
- Kontroll av tilstedeværelse av duplikater av primærnøkkelen;
- Kontroll av enhetens fremmednøkkel;
- Kontroll av unikhet av rader basert på et sett med felt.
For mer komplekse kontroller av tilgjengelighet og validitet av data, ble det laget en mapping med Scala Expression, som tar inn ekstern Spark SQL-kode for kontroller, utarbeidet av analytikere i Zeppelin.
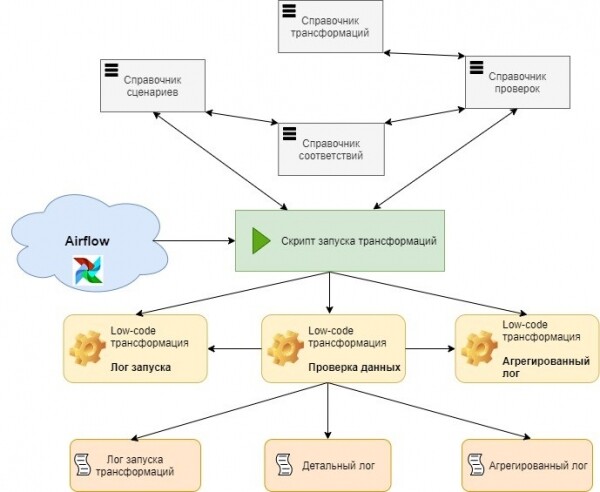
Selvfølgelig må man gradvis gå frem mot autogenerering av kontroller. I forbindelse med det beskrevne prosjektet ble følgende trinn forut for dette:
- DQ, implementert i Zeppelin-notater;
- DQ, integrert i mapping;
- DQ i form av separate massive mappings, som inneholder et helt sett av kontroller per enkelt enhet;
- Universelle parameteriserte DQ-mappings, som tar inn informasjon om metadata og forretningskontroller.
Kanskje den største fordelen ved å opprette en tjeneste for parameteriserte kontroller er redusering av tiden det tar å levere funksjonalitet til produksjonsmiljøet. Nye kvalitetskontroller kan omgå den klassiske mønsteret for levering av kode indirekte gjennom utviklings- og testmiljøer:
- Alle kontroller av metadata genereres automatisk ved endring av modell i EA;
- Kontroller av datatilgjengelighet (bestemmelse av om noen data er tilgjengelige på et bestemt tidspunkt) kan genereres basert på en referanse som lagrer den forventede timingen for når en ny datasats vil dukke opp i forhold til objektene;
- Forretningskontroller for datavaliditet opprettes av analytikere i Zeppelin-notater, og sendes direkte til innstillingstabellene til DQ-modulen i produksjonsmiljøet.
Risikoen for direkte levering av skript til produksjon er i utgangspunktet fraværende. Selv ved en syntaksfeil er det maksimalt hva vi kan være utsatt for – en kontroll vil ikke bli utført, ettersom data beregningsstrømmen og kvalitetskontrollstrømmen er atskilt fra hverandre.
I bunn og grunn er DQ-tjenesten kontinuerlig aktivert i produksjonsmiljøet og klar til å begynne sitt arbeid ved ankomsten av en ny datasats.
In conclusion
Fordeler ved bruk av low-code er åpenbare. Utviklere trenger ikke å utvikle applikasjonen fra bunnen av. Den avlastede programmereren gir resultater raskere. Hastigheten frigjør i sin tur ekstra ressurser til å håndtere optimaliseringsspørsmål. Følgelig kan man i dette tilfellet forvente et mer kvalitetsfylt og raskt resultat.
Selvfølgelig er low-code ikke en panacea, og mirakler skjer ikke av seg selv:
- Low-code-industrien går gjennom en «modnings»-fase, og det fins foreløpig ingen enhetlige industrielle standarder;
- Mange low-code-løsninger er ikke gratis, og anskaffelsen bør være et bevisst valg, gjort med full tillit til den økonomiske gevinsten fra bruken;
- Mange low-code-løsninger spiller ikke alltid godt sammen med GIT / SVN. Eller de er vanskelig å bruke når den genererte koden skjules;
- Ved utvidelse av arkitekturen kan det være nødvendig å tilpasse low-code-løsningen – noe som igjen fremkaller effekten av «tilknytning og avhengighet» til leverandøren av low-code-løsningen.
- Nødvendig sikkerhetsnivå er mulig, men svært arbeidskrevende og komplisert å implementere i low-code-systemer. Low-code-plattformer bør ikke velges bare ut fra mulige gevinster. Ved valg bør man stille spørsmål om funksjonaliteten for tilgangsstyring og delegasjon/eskalering av identitetsdata på tvers av hele IT-landskapet i organisasjonen.
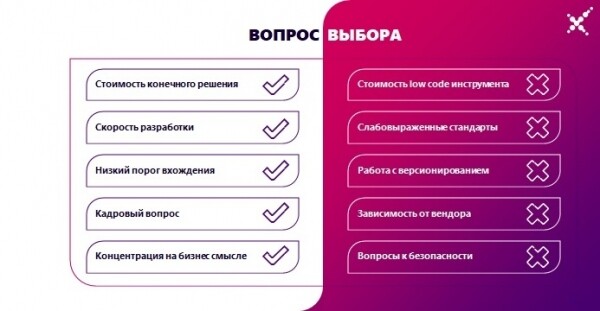
Men hvis du er klar over alle ulempene med det valgte systemet, og fordelene ved bruken likevel dominerer, så kan du gå over til low-code uten frykt. Dessuten er overgangen til det uunngåelig – akkurat som enhver evolusjon.
Hvis én utvikler på en lavkodeplattform kan utføre arbeidet sitt raskere enn to utviklere uten lavkode, gir dette selskapet en fordel på alle måter. Inngangsbarrieren til lavkode-løsninger er lavere enn for tradisjonell teknologi, noe som har en positiv innvirkning på problemet med kompetansemangel. Bruken av lavkodeverktøy kan akselerere samarbeidet mellom funksjonelle team og raskere ta beslutninger om gyldigheten av den valgte veien for data science-forskning. Lavkodeplattformer kan være årsaken til digital transformasjon av organisasjonen, ettersom de produserte løsningene kan være lett tilgjengelige for ikke-tekniske spesialister (spesielt for forretningsbrukere).
Hvis du har stramme frister, tung forretningslogikk, mangel på teknologisk ekspertise, og trenger å akselerere time to market, er lavkode en av måtene å møte dine behov på.
Det er ikke riktig å undervurdere betydningen av tradisjonelle utviklingsverktøy, men i mange tilfeller er bruken av lavkode-løsninger den beste måten å øke effektiviteten i oppgavene.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish