

Denne historien handler om hvordan vi bruker containere i produksjonsmiljø, spesielt under Kubernetes. Artikkelen omhandler innsamling av metrikker og logger fra containere, samt bygging av bilder.
Vi er fra fintech-selskapet Exness, som utvikler tjenester for online trading og fintech-produkter for B2B og B2C. I vårt FoU-team er det mange ulike grupper, med over 100 ansatte i utviklingsavdelingen.
Vi representerer teamet som er ansvarlig for plattformen for innsamling og kjøring av kode fra våre utviklere. Spesielt er vi ansvarlige for innsamling, lagring og tilgjengeliggjøring av metrikker, logger og hendelser fra applikasjonene. For øyeblikket opererer vi med omtrent tre tusen Docker-containere i produksjonsmiljøet, støtter vårt big data-lager på 50 TB, og tilbyr arkitekturløsninger som bygges rundt vår infrastruktur: Kubernetes, Rancher og ulike offentlige skytjenesteleverandører.
Vår motivasjon
Hva brenner? Ingen kan svare. Hvor er brannen? Å forstå er vanskelig. Når begynte det å brenne? Det kan avdekkes, men ikke med en gang.
Hvorfor står noen containere stille mens andre har falt? Hvilken container er ansvarlig for dette? Utenpå ser containerne like ut, men inni har hver sin Neo.
Våre utviklere er kompetente folk. De lager gode tjenester som gir selskapet fortjeneste. Men det skjer feil, når containerne med applikasjoner er uorganiserte. En container bruker for mye CPU, en annen nettverk, en tredje inn- og utdataoperasjoner, og en fjerde vet man ikke hva gjør med soklene. Alt dette faller, og skipet synker.
Agenter
For å forstå hva som skjer inne i containerne, har vi bestemt oss for å installere agenter direkte i containerne.
Disse agentene er støttende programmer som holder containerne i en tilstand der de ikke ødelegger hverandre. Agentene er standardisert, og dette gjør det mulig å standardisere tilnærmingen til vedlikehold av containerne.
I vårt tilfelle må agentene gi logger i et standardformat, merket og med throttling. De må også gi oss standardiserte metrikker som er utvidbare med hensyn til forretningsapplikasjoner.
Under agenter forstås også verktøy for drift og vedlikehold, som kan fungere i ulike orkestreringssystemer og støtte forskjellige bilder (Debian, Alpine, Centos, osv.).
Endelig må agentene støtte en enkel CI/CD som inkluderer Docker-filer. Ellers vil skipet gå i stykker fordi containerne begynner å leveres på "skakke" skinner.
Byggeprosessen og oppsettet av målbildet
For å ha alt standardisert og kontrollerbart, må vi følge en eller annen standard byggeprosess. Derfor har vi besluttet å bygge containere med containere – slik er rekursjonen.
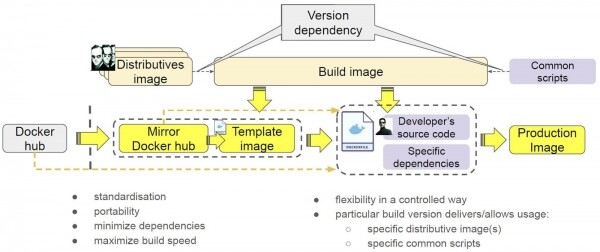
Her er containerne presentert som solide konturer. Samtidig bestemte vi oss for å legge distribusjoner i dem, slik at "livet ikke skulle virke for enkelt". Hvorfor dette ble gjort, vil vi forklare nedenfor.
Resultatet ble et verktøy for bygging – en container av en spesifikk versjon som refererer til bestemte versjoner av distribusjoner og spesifikke versjoner av skripter.
Hvordan bruker vi dette? Vi har Docker Hub, der containeren ligger. Vi speiler den inn i vårt eget system for å bli kvitt eksterne avhengigheter. Det ble en container merket med gult. Vi lager en mal for å installere alle nødvendige distribusjoner og skripter i containeren. Etter dette bygger vi et driftklart bilde: utviklerne legger inn koden sin og noen spesifikke avhengigheter.
Hva er fordelene med denne tilnærmingen?
- For det første, full versjonskontroll av byggeverktøyene – bygget container, versjoner av skriptene og distribusjonene.
- For det andre har vi oppnådd standardisering: vi lager maler, mellomprodukter og driftklare bilder på en ensartet måte.
- For det tredje gir containerne oss portabilitet. I dag bruker vi Gitlab, og i morgen går vi over til TeamCity eller Jenkins og vil fortsatt kunne kjøre containerne våre på samme måte.
- For det fjerde, minimalisering av avhengigheter. Vi la bevisst distribusjoner i containeren, for det gjør at vi ikke må laste dem ned hver gang fra Internett.
- For det femte har byggehastigheten økt – tilgjengeligheten av lokale kopier av bilder gjør at vi ikke bruker tid på nedlasting, siden det finnes et lokalt bilde.
Med andre ord har vi oppnådd en kontrollerbar og fleksibel byggeprosess. Vi bruker de samme verktøyene for å bygge alle containere med full versjonering.
Hvordan fungerer vår byggeprosedyr?
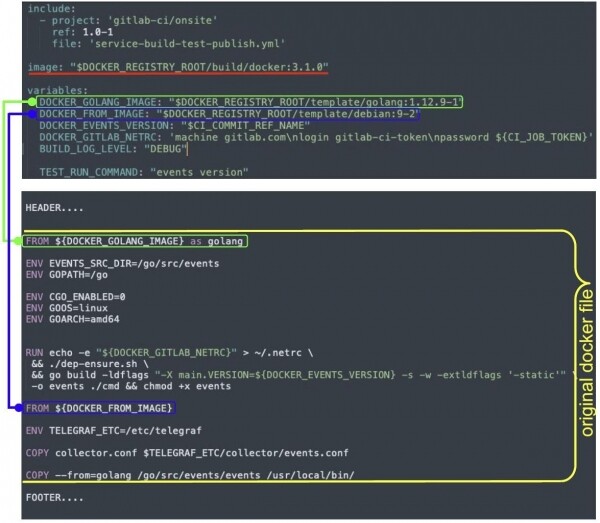
Oppsettet startes med én kommando, prosessen kjøres i bildet (markert med rødt). Utvikleren har en Docker-fil (markert med gult), som vi rendrer ved å erstatte variabler med verdier. I tillegg legger vi til headere og footere — dette er våre agenter.
Headeren legger til distribusjoner fra de respektive bildene. Footer sørger for å installere våre tjenester internt, konfigurerer oppstart av arbeidsmengde, logging og andre agenter, erstatter entrypoint osv.
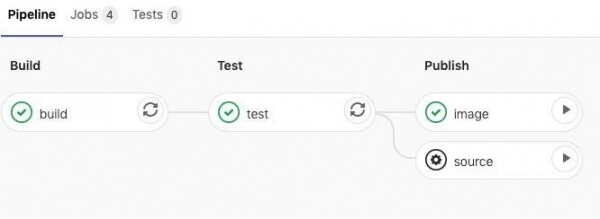
Vi tenkte lenge på om vi skulle bruke en supervisor. Til slutt bestemte vi oss for at vi hadde behov for det. Vi valgte S6. Supervisoren sikrer at vi kan håndtere containeren: den lar oss koble til den hvis hovedprosessen feiler og gir manuell kontroll over containeren uten at vi må opprette den på nytt. Logger og metrikker er prosesser som kjøres inne i containeren. Dette må også kontrolleres på en eller annen måte, og det gjør vi med hjelp av supervisoren. Til slutt tar S6 seg av housekeeping, signalbehandling og andre oppgaver.
Siden vi bruker forskjellige orkestreringssystemer, må containeren etter oppsett og oppstart forstå hvilken miljø den er i og handle deretter. For eksempel:
Dette lar oss samle ett bilde og kjøre det i forskjellige orkestreringssystemer, og det vil bli startet med hensyn til spesifikasjonene til dette orkestreringssystemet.
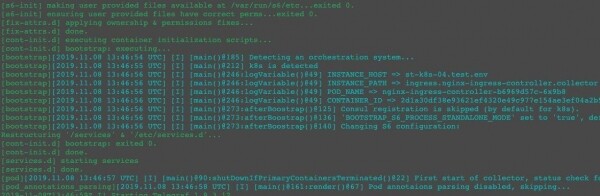
For den samme containeren får vi forskjellige prosesstrær i Docker og Kubernetes:
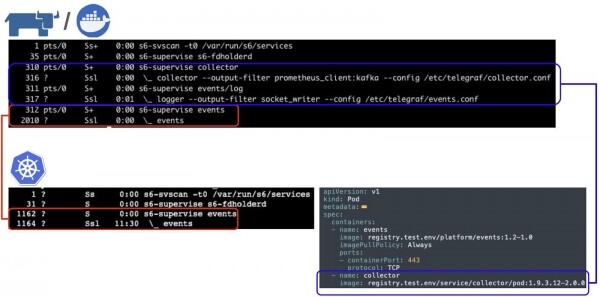
Nytten kjøres under supervisoren S6. Vær oppmerksom på collector og events — dette er våre agenter som tar seg av logger og metrikker. I Kubernetes finnes de ikke, men i Docker gjør de det. Hvorfor?
Hvis vi ser på spesifikasjonen for «pod» (her og videre – Kubernetes pod), ser vi at containeren events kjører i en pod, som har en egen container collector som utfører funksjonen med å samle metrikker og logger. Vi kan bruke mulighetene til Kubernetes: kjøre containere i én pod, i et felles prosess- og/eller nettverksområde. Faktisk kan vi implementere våre egne agenter og utføre noen funksjoner. Og hvis denne samme containeren kjører i Docker, vil den få de samme mulighetene, som vil være i stand til å levere logger og metrikker, siden agentene vil kjøre internt.
Metrikker og logger
Levering av metrikker og logger er en komplisert oppgave. Løsningen på den er knyttet til flere aspekter.
Infrastrukturen er designet for å kjøre nyttelast, ikke for massedistribusjon av logger. Dette betyr at prosessen skal utføres med minimale ressurser for containerne. Vi ønsker å hjelpe utviklerne våre: «Ta Docker Hub-containeren, kjør den, og vi kan levere loggene».
Det andre aspektet er å begrense volumet av logger. Hvis flere containere opplever et volumutbrudd (applikasjonen skriver stack-trace i en loop), øker belastningen på CPU, nettverkskanaler, logsamlesystemet, og dette påvirker vertsmaskinen generelt og andre containere på verten, noe som noen ganger fører til at vertsmaskinen «faller».
Det tredje aspektet er at vi må støtte så mange metoder for innsamling av målinger som mulig fra starten av. Fra å lese filer og spørre Prometheus-endepunktet til å bruke spesifikke applikasjonsprotokoller.
Og det siste aspektet er at vi må minimere ressursforbruket.
Vi har valgt en open-source-løsning skrevet i Go, kalt Telegraf. Dette er en universell connector som støtter mer enn 140 typer inngangskanaler (input plugins) og 30 typer utgangskanaler (output plugins). Vi har tilpasset den, og nå skal vi vise hvordan den brukes av oss i eksemplet Kubernetes.
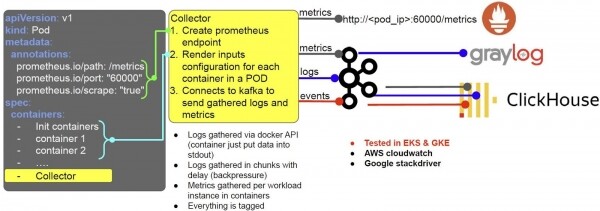
La oss si at en utvikler distribuerer arbeidslast, og Kubernetes mottar forespørselen om å opprette en pod. I dette øyeblikket opprettes det automatisk en container kalt Collector for hver pod (vi bruker en mutasjons-webhook). Collector er vår agent. Ved oppstart konfigurerer denne containeren seg selv til å jobbe med Prometheus og logsamlingssystemet.
- For dette bruker den pod-annotasjoner, og avhengig av innholdet, oppretter den, for eksempel, en Prometheus endepunkt.
- Basert på spesifikasjonen til pod-en og spesifikke innstillingsalternativer for containerne avgjør den hvordan loggene skal leveres.
Vi samler logger gjennom Docker API: utviklerne trenger bare å legge dem i stdout eller stderr, så klarer Collector resten. Loggene samles inn i biter med en viss forsinkelse for å forhindre mulig overbelastning av vertsmaskinen.
Målinger samles inn per instanser av arbeidslastene (prosesser) i containerne. Alt merkes med tagger: namespace, pod, osv., og blir deretter konvertert til Prometheus-format – og blir tilgjengelig for innsamling (bortsett fra logger). I tillegg sender vi logger, målinger og hendelser til Kafka og videre:
- Loggene er tilgjengelige i Graylog (for visuell analyse);
- Logger, metrikker og hendelser sendes til Clickhouse for langtidslagring.
Alt fungerer på samme måte i AWS, bare at vi bytter ut Graylog med Kafka til Cloudwatch. Vi sender logger dit, og det blir veldig praktisk: det er lett å se hvilken klynge og container de tilhører. Det samme gjelder for Google Stackdriver. Så vårt oppsett fungerer både on-premise med Kafka og i skyen.
Hvis vi ikke har Kubernetes med pods, blir oppsettet litt mer komplisert, men fungerer etter de samme prinsippene.
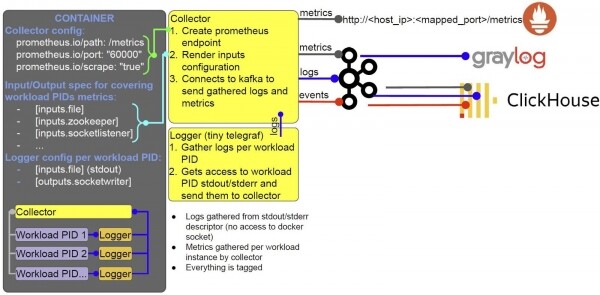
Inne i containeren kjører samme prosesser, og de orkestreres ved hjelp av S6. Alle de samme prosessene kjører inne i én container.
Resultatet er
Vi har laget en helhetlig løsning for bygging og implementering av bilder, med alternativer for innsamling og levering av logger og metrikker:
- Utviklet en standardisert tilnærming til bygging av bilder, basert på dette har vi utviklet CI-maler;
- Agenter for datainnsamling er våre utvidelser av Telegraf. Vi har godt testet dem i produksjon;
- Bruker mutation webhook for å implementere containere med agenter i pods;
- Integrert i Kubernetes/Rancher-økosystemet;
- Vi kan kjøre identiske containere i forskjellige orkestreringssystemer og oppnå det resultatet vi forventer;
- Vi har laget en helt dynamisk konfigurasjon for containeradministrasjon.
Samarbeidspartnere: Ilya Prudnikov
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish