

Jeg har lagt ut et nytt prosjekt A Simple GPU Hash Table på Github .
Det vil si at hastigheten på den bærbare PC-en er omtrent 300 millioner innsettinger/sekund og 500 millioner fjerninger/sekund.
Tabellen er skrevet i CUDA, selv om samme metode kan brukes i HLSL eller GLSL. Implementeringen har noen begrensninger som gir høy ytelse på grafikkortet:
Kun 32-bit nøkler og verdier blir behandlet.
- Hash-tabellen har en fast størrelse.
- Og denne størrelsen må være en makt av to.
- For nøkler og verdier må det reserveres en enkel avgrensningsmarkør (i den medfølgende koden er det 0xffffffff).
Hash-tabellen uten låser
I hash-tabellen brukes åpen adressering med
lineær sondering KeyValue struct KeyValue { uint32_t key; uint32_t value; };:
Størrelsen på tabellen er like mye en makt av to, ikke et primtall, fordi det er tilstrekkelig med en rask instruksjon for å påføre pow2/AND-maskering, mens modulus-operatøren fungerer mye saktere. Dette er viktig når man bruker lineær sondering, ettersom indeksen til slotten må omslutte hver slot. Og resultatet blir at kostnaden for modulus-operasjonen legges til i hver slot.
Tabellen lagrer bare nøkkel og verdi for hvert element, ikke hasherekjærer. Siden tabellen bare lagrer 32-bit nøkler, beregnes hash veldig raskt. I den medfølgende koden brukes Murmur3-hash, som bare utfører noen få skift, XOR-er og multiplikasjoner.
Murmur3-hashen brukes, som utfører bare noen få skift, XOR-er og multiplikasjoner.
I hassetabellen blir det brukt en blokkeringbeskyttelsesmetode som ikke avhenger av rekkefølgen på minneplassering. Selv om noen skriveoperasjoner forstyrrer rekkefølgen til andre slike operasjoner, vil hassetabellen fremdeles opprettholde en korrekt tilstand. Dette skal vi diskutere nærmere senere. Metoden fungerer glimrende med grafikkort, der tusenvis av tråder kjører samtidig.
Nøkler og verdier i hassetabellen initialiseres som tomme.
Koden kan endres slik at den kan håndtere både 64-bits nøkler og verdier. For nøkler kreves atomære operasjoner for lesing, skriving og sammenligning med bytte (compare-and-swap). For verdier er atomære operasjoner for lesing og skriving nødvendig. Heldigvis er lesing-skriving-operasjoner for 32- og 64-bits verdier atomære så lenge de er naturlig justert (se. ), og moderne grafikkort støtter 64-bits atomære sammenligningsoperasjoner med bytte. Selvfølgelig vil ytelsen reduseres noe når man går over til 64 biter.
Tilstanden til hassetabellen
Hver nøkkel-verdi-par i hassetabellen kan ha en av fire tilstander:
- Nøkkelen og verdien er tomme. I denne tilstanden blir hassetabellen initialisert.
- Nøkkelen har blitt skrevet, men verdien er ennå ikke. Hvis en annen utførelsestråd leser data på dette tidspunktet, vil den returnere en tom verdi. Dette er normalt; det samme ville skjedd hvis en annen utførelsestråd hadde kjørt litt tidligere, og vi snakker om en konkuransstrukturert datamodell.
- Både nøkkel og verdi er skrevet.
- Verdien er tilgjengelig for andre utførelsestråder, men nøkkelen er ikke ennå. Dette kan skje fordi programmeringsmodellen i CUDA antar en svakt ordnet minnemodell. Dette er normalt; uansett hendelse er nøkkelen fremdeles tom, selv om verdien ikke lenger er det.
Et viktig poeng er at så snart nøkkelen er skrevet til plassen, vil den ikke bli flyttet — selv om nøkkelen blir slettet, skal vi diskutere dette senere.
Koden for hassetabellen fungerer selv med svakt ordnede minnemodeller, hvor rekkefølgen på lesing og skriving til minnet ikke er kjent. Når vi går gjennom innsetting, søk og sletting i hassetabellen, husk at hvert nøkkel-verdi-par befinner seg i en av de fire ovenfor beskrevne tilstandene.
Innsatt i hassetabellen
CUDA-funksjonen som setter inn nøkkel-verdi-par i hash-tabellen, ser slik ut:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
For å sette inn en nøkkel, itererer koden over hash-tabellens array fra hashen av den innsettende nøkkelen. I hver slot i arrayet utføres en atomær sammenligning med bytte, der nøkkelen i denne slotten sammenlignes med tom. Hvis det oppdages en ulikhet, blir nøkkelen i slotten oppdatert til den innsettende nøkkelen, og deretter returneres den originale nøkkelen i slotten. Hvis denne originale nøkkelen var tom eller samsvarte med den innsettende nøkkelen, betyr det at koden har funnet en passende slot for innsetting og legger inn den innsettende verdien.
Hvis i ett kjernemekanisk anrop gpu_hashtable_insert() har flere elementer med samme nøkkel, kan hvilken som helst av verdiene bli skrevet til nøkkelens slot. Dette anses som normalt: én av skriveoperasjonene med nøkkel-verdi under anropet vil være vellykket, men siden alt dette skjer parallelt i flere utførelsestråder, kan vi ikke forutsi hvilken skriveoperasjon til minnet som vil være den siste.
Søk i hash-tabellen
Koden for å søke etter nøkler:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
For å finne verdien av nøkkelen som er lagret i tabellen, itererer vi over arrayet fra hashen av den ønskede nøkkelen. I hver slot sjekker vi om nøkkelen er den vi leter etter, og hvis ja, returnerer vi verdien. Vi sjekker også om nøkkelen er tom, og hvis ja, avbryter vi søket.
Hvis vi ikke klarer å finne nøkkelen, returnerer koden en tom verdi.
Alle disse søkeoperasjonene kan utføres samtidig under innsetting og sletting. Hver par i tabellen vil ha en av de fire ovenfor beskrevne tilstandene for tråden.
Sletting i hash-tabellen
Koden for å slette nøkler:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Fjerning av nøkkelen skjer på en uvanlig måte: vi lar nøkkelen forbli i tabellen og merker verdien den har (ikke selve nøkkelen) som tom. Denne koden ligner veldig på lookup(), bortsett fra at når det finnes et samsvar med nøkkelen, gjøres verdien tom.
Som nevnt tidligere, så snart nøkkelen er skrevet i sporet, flyttes den ikke lenger. Selv ved fjerning av et element fra tabellen forblir nøkkelen på plass, kun verdien blir tom. Dette betyr at vi ikke trenger å bruke atomiske skriveoperasjoner på sporets verdi, for det spiller ingen rolle om den nåværende verdien er tom eller ikke — den vil uansett bli tom.
Endring av hash-tabellen
Endre størrelsen på hash-tabellen kan gjøres ved å opprette en større tabell og sette inn de ikke-tomme elementene fra den gamle tabellen. Jeg har ikke implementert denne funksjonaliteten, fordi jeg ønsket å holde kodeeksempelet enkelt. Videre foregår minneallokering ofte i vertskoden, ikke i CUDA-kjernen.
I artikkelen er beskrevet hvordan man endrer en slik datakonstruksjon som er beskyttet mot låser.
Konkurranse
I de ovennevnte kodeeksemplene håndterer funksjonene gpu_hashtable_insert(), _lookup() og _delete() én nøkkel-verdi-par av gangen. Og nedenfor gpu_hashtable_insert(), _lookup() og _delete() behandler en rekke par parallelt, hvert par i en egen GPU-tråd:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Hash-tabellen med låsebeskyttelse støtter konkurrerende innsetting, søk og fjerning. Siden nøkkel-verdi-par alltid er i en av fire tilstander, og nøklene ikke flyttes, garanterer tabellen korrekthet selv med samtidige operasjoner av forskjellige typer.
Men hvis vi parallelt behandler en batch med innsettinger og fjerninger, og hvis inngangsmassen av par inneholder dupliserte nøkler, kan vi ikke forutsi hvilke par som "vinner" - som vil bli skrevet inn i hash-tabellen sist. La oss si at vi kalte innsettingskoden med inngangsmassen av par A/0 B/1 A/2 C/3 A/4. Når koden fullføres, vil parene B/1 og C/3 garantert være til stede i tabellen, men det vil også være noe av parene A/0, A/2 eller A/4Dette kan være et problem, eller det kan det ikke være — alt avhenger av bruken. Du kan vite på forhånd at det ikke finnes dublikater i den inngående matrisen, eller du kan være likegyldig til hvilket verdi som ble skrevet sist.
Hvis dette er et problem for deg, må du dele dublikerte par mellom forskjellige systemkall til CUDA. I CUDA vil enhver operasjon med kjernens kall alltid bli fullført før neste kjernens kall (i det minste innen én tråd. I forskjellige tråder kjøreres kjernene parallelt). Hvis vi i eksempelet ovenfor kaller én kjerne med A/0 B/1 A/2 C/3, og en annen med A/4, så vil nøkkelen A få verdien 4.
La oss nå snakke om hvorvidt funksjonene lookup() og delete() bør bruke en vanlig (plain) eller variabel (volatile) peker til matriser med par i hashtabellen. påstår at:
Kompilatoren kan etter eget skjønn optimalisere lesing og skriving av global eller delt minne... Disse optimaliseringene kan deaktiveres med nøkkelordet
volatile: ... enhver referanse til denne variabelen kompileres til en faktisk instruksjon for å lese eller skrive i minnet.
Hensyn til korrekthet krever ikke anvendelse volatile. Hvis kjøringsstrømmen bruker et bufret verdig fra en tidligere leseoperasjon, betyr det at det vil bruke litt utdatert informasjon. Men likevel er dette informasjon fra en gyldig tilstand av hashtabellen på et bestemt tidspunkt ved kjernens kall. Hvis du trenger å bruke den nyeste informasjonen, kan du bruke pekeren volatile, men da vil ytelsen bli litt redusert: etter mine tester — ved sletting av 32 millioner elementer gikk hastigheten ned fra 500 millioner slettinger/sek til 450 millioner slettinger/sek.
Ytelse
I testen med innsetting av 64 millioner elementer og sletting av 32 millioner av dem, er konkurransen mellom std::unordered_map og hashtabellen for GPU faktisk ikke eksisterende:
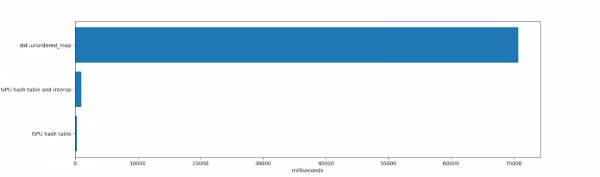
std::unordered_map brukte 70 691 ms på innsetting og sletting av elementer med etterfølgende frigjøring unordered_map (frigjøring fra millioner av elementer tar tid, fordi mange minneallokeringer skjer innvendig). Ærlig talt, for unordered_map std:unordered_map ble det flere helt andre begrensninger. Dette er en enkel CPU-tråd for utførelse, den støtter nøkkelverdi-par av enhver størrelse, fungerer godt ved høye brukskoeffisienter og viser stabil ytelse etter mange slettinger.
Varigheten av hash-tabellen for GPU og mellomprogramsinteraksjon var 984 ms. Dette inkluderer tiden brukt på å plassere tabellen i minnet og frigjøre den (en enkelt tildeling av 1 GB minne, som tar tid i CUDA), innsetting og sletting av elementer, samt iterering over dem. Alle overføringer til og fra GPU-minnet er også tatt med.
Jobben med selve hash-tabellen tok 271 ms. Dette inkluderer tiden GPU-en bruker på å sette inn og slette elementer, og tar ikke med tiden brukt på å kopiere til minnet og iterere over den resulterende tabellen. Hvis GPU-tabellen lever lenge, eller hvis hash-tabellen helt holdes i GPU-minnet (for eksempel for å lage en hash-tabell som vil brukes av annen GPU-kode, ikke CPU-en), er testresultatet relevant.
Hash-tabellen for GPU viser høy ytelse takket være stor båndbredde og aktiv parallellbehandling.
Ulemper
Det er flere problemer med arkitekturen til hash-tabellen som man må huske på:
- Klynge hindrer lineær probing, noe som gjør at nøklene i tabellen ikke plasseres på en ideell måte.
- Nøkler slettes ikke ved hjelp av funksjon
sletteog tetter gradvis tabellen over tid.
Som et resultat kan ytelsen til hash-tabellen gradvis avta, spesielt hvis den eksisterer lenge og det utføres mange innsettinger og slettinger. En av måtene å dempe disse ulempene på er ved å rehahere til en ny tabell med tilstrekkelig lav utnyttelsesgrad og filtrering av slettede nøkler ved rehahering.
For å illustrere de beskrevne problemene, vil jeg bruke koden ovenfor for å opprette en tabell med 128 millioner elementer, og syklisk sette inn 4 millioner elementer inntil 124 millioner plasser er fylt (utnyttelsesgrad på omtrent 0,96). Her er resultat-tabellen, hver rad er en CUDA-kjerneanrop med innsetting av 4 millioner nye elementer i en hash-tabell:
Utnyttelsesgrad
Varigheten av innsetting av 4 194 304 elementer
0,00
11,608448 ms (361,314798 millioner nøkler/sek.)
0,03
11,751424 ms (356,918799 millioner nøkler/sek.)
0,06
11,942592 ms (351,205515 millioner nøkler/sek.)
0,09
12,081120 ms (347,178429 millioner nøkler/sek.)
0,12
12,242560 ms (342,600233 millioner nøkler/sek.)
0,16
12,396448 ms (338,347235 millioner nøkler/sek.)
0,19
12,533024 ms (334,660176 millioner nøkler/sek.)
0,22
12,703328 ms (330,173626 millioner nøkler/sek.)
0,25
12,884512 ms (325,530693 millioner nøkler/sek.)
0,28
13,033472 ms (321,810182 millioner nøkler/sek.)
0,31
13,239296 ms (316,807174 millioner nøkler/sek.)
0,34
13,392448 ms (313,184256 millioner nøkler/sek.)
0,37
13,624000 ms (307,861434 millioner nøkler/sek.)
0,41
13,875520 ms (302,280855 millioner nøkler/sek.)
0,44
14,126528 ms (296,909756 millioner nøkler/sek.)
0,47
14,399328 ms (291,284699 millioner nøkler/sek.)
0,50
14,690304 ms (285,515123 millioner nøkler/sek.)
0,53
15,039136 ms (278,892623 millioner nøkler/sek.)
0,56
15,478656 ms (270,973402 millioner nøkler/sek.)
0,59
15,985664 ms (262,379092 millioner nøkler/sek.)
0,62
16,668673 ms (251,627968 millioner nøkler/sek.)
0,66
17,587200 ms (238,486174 millioner nøkler/sek.)
0,69
18,690048 ms (224,413765 millioner nøkler/sek.)
0,72
20,278816 ms (206,831789 millioner nøkler/sek.)
0,75
22,545408 ms (186,038058 millioner nøkler/sek.)
0,78
26,053312 ms (160,989275 millioner nøkler/sek.)
0,81
31,895008 ms (131,503463 millioner nøkler/sek.)
0,84
42,103294 ms (99,619378 millioner nøkler/sek.)
0,87
61,849056 ms (67,815164 millioner nøkler/sek.)
0,90
105,695999 ms (39,682713 millioner nøkler/sek.)
0,94
240,204636 ms (17,461378 millioner nøkler/sek.)
Når utnyttelsesgraden øker, synker ytelsen. Dette er uønsket i de fleste tilfeller. Hvis en applikasjon setter inn elementer i en tabell og deretter kaster dem (for eksempel ved å telle ord i en bok), er dette ikke et problem. Men hvis applikasjonen bruker en langvarig hashtabell (for eksempel i et grafisk program for å lagre ikke-tomme deler av bilder, når brukeren ofte setter inn og sletter informasjon), kan slik oppførsel være plagsom.
Og jeg målte dybden av probing i hashtabellen etter 64 millioner innsettinger (utnyttelsesgrad 0,5). Gjennomsnittlig dybde var 0,4774, så de fleste nøklene var enten i den beste av tilgjengelige plasser, eller i en plass fra den beste posisjonen. Maksimal probingdybde var 60.
Så målte jeg dybden av probing i tabellen med 124 millioner innsettinger (utnyttelsesgrad 0,97). Gjennomsnittlig dybde var allerede 10,1757, og maksimal — 6474 (!!). Ytelsen til lineær probing faller kraftig ved høye utnyttelsesgrader.
Det er best å opprettholde en lav belønningsgrad for denne hash-tabellen. Men da øker vi ytelsen på bekostning av minneforbruk. Heldigvis, med 32-biter nøkkel- og verdiformater, kan det være berettiget. Hvis vi i eksemplet ovenfor har en tabell på 128 millioner elementer med en belønningsgrad på 0,25, vil vi kunne plassere maksimalt 32 millioner elementer i den, mens de resterende 96 millioner plassene vil gå tapt – 8 byte per par, 768 MB tapt minne.
Vær oppmerksom på at dette handler om tap av minne i grafikkortet, som er en mer verdifull ressurs enn systemminnet. Selv om de fleste moderne stasjonære grafikkort som støtter CUDA har minst 4 GB minne (på tidspunktet for skrivingen hadde NVIDIA 2080 Ti 11 GB), vil det uansett ikke være det smarteste valget å miste slike mengder.
Senere vil jeg skrive mer om hvordan man lager hash-tabeller for grafikkort som ikke har problemer med probing-dybde, samt strategier for gjenbruk av slettede plasser.
Måling av probing-dybde
For å bestemme probing-dybden av en nøkkel, kan vi trekke ut hash av nøkkelen (dens ideelle indeks i tabellen) fra dens faktiske tabellindeks:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
På grunn av magien til to binære tall i to-komplement og det faktum at kapasitetsgrensen i en hash-tabell er en makt av to, vil denne metoden fungere selv når nøkkelindeksen flyttes til starten av tabellen. La oss ta en nøkkel som hashes til 1, men som settes inn i slot 3. Da, for en tabell med kapasitet 4, får vi (3 — 1) & 3, noe som er lik 2.
Konklusjon
Hvis du har spørsmål eller kommentarer, kan du skrive til meg på eller åpne et nytt emne i.
Denne koden er skrevet under inspirasjon av de fantastiske artiklene:
I fremtiden vil jeg fortsette å skrive om implementasjoner av hash-tabeller for grafikkort og analysere ytelsen deres. Jeg planlegger å inkludere kjedetabling, Robin Hood hashing og cuckoo hashing ved bruk av atomiske operasjoner i datastrukturer som er optimale for grafikkort.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish