

Vi hadde 2 sekkar med gras, 75 tabletter meskalin unix-miljø, docker-repositorium og oppgåva å implementere kommandoane docker pull og docker push utan docker-klienten.
UPD:
Spørsmål: Kvifor alt dette?
Svar: Lastetesting av produktet (IKKJE med bash-verktøy, skript er gjeve til utdanningsføremål). Det vart bestemt å ikkje bruke docker-klienten for å redusere ekstra lag (innen rimelige grenser) og dermed emulere ein høgare belastning. Resultatet var at vi fjerna alle systemforsinkelsar frå docker-klienten. Vi fekk ein relativt rein last direkte på produktet.
I artikkelen vart det nytta GNU-verktøy.
La oss først sjå på kva desse kommandoane gjer.
Så kva er docker pull brukt til? I følgje :
"Hent eit bilete eller eit repositorium frå ein registry".
Der finn vi også lenka til .
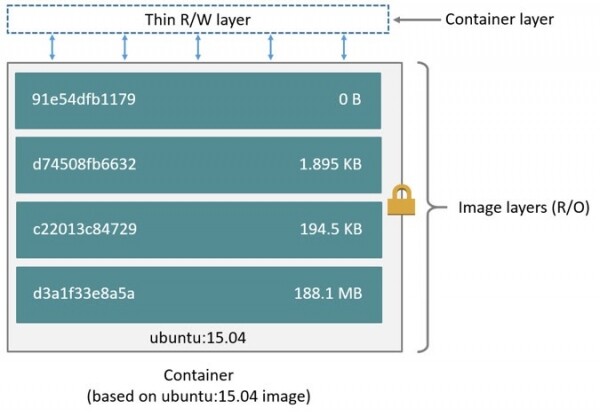
Herfrå kan vi forstå at docker-bilete er eit sett med lag, som inneheld informasjon om dei siste endringane i biletet, som sjølvsagt er det vi treng. Deretter ser vi på .
Her blir det sagt følgjande:
"Eit “bilete” er ei kombinasjon av ein JSON-manifest og individuelle lagfiler. Prosessen med å hente eit > bilete handlar om å hente desse to komponentane."
Så det første steget ifølgje dokumentasjonen er “Henting av eit bilde-manifest”.
Vi vil sjølvsagt ikkje hente det, men vi treng data frå det. Deretter blir eit eksempel på ei førespurnad gjeve: GET /v2/{name}/manifests/{reference}
"Navnet og referanseparameteren identifiserer biletet og er påkravd. Referansen kan inkludere ei tag eller digest."
Vårt docker-repositorium er oppsett lokalt, la oss prøve å utføre førespurnaden:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
Som svar får vi JSON der vi akkurat nå kun er interessert i laga, nærmare bestemt deira hashes. Når vi har fått dei, kan vi gå gjennom kvar enkelt og utføre følgjande førespurnad: "GET /v2/{name}/blobs/{digest}"
“Tilgang til eit lag vil bli avgrensa av namnet på repositoriet, men er unikt identifisert i registren av digest.”
digest er her faktisk hashen vi fekk.
La oss prøve
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
La oss sjå kva fil vi fekk som den første laga.
file firstLayer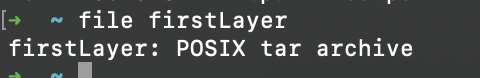
d.v.s. laga er tar-arkiv, og pakka ut i riktig rekkefølgje får vi innhaldet i biletet.
Vi skriv eit lite bash-skript for å automatisere alt dette.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Nå kan vi starte den med ønskede parametere og få innholdet til det nødvendige imaget.
. /script.sh dirName "http://localhost:8081/link/to/docker/registry" myAwesomeImage 1.0Del 2 — docker push
Her blir det litt mer komplisert.
Vi begynner igjen med . Så vi må laste opp hver lag, samle den tilsvarende manifesten og laste den også. Det høres ganske enkelt ut.
Ved å studere dokumentasjonen kan vi dele opplastingsprosessen i flere trinn:
- Initialisering av prosessen — "POST /v2/{repoName}/blobs/uploads/"
- Opplasting av lag (vi vil bruke monolitisk opplasting, dvs. hvert lag sendes i sin helhet) — "PUT /v2/{repoName}/blobs/uploads/{uuid}?digest={digest}"
Content-Length: {size of layer}
Content-Type: application/octet-stream
Lag Binær Data". - Opplasting av manifest — "PUT /v2/{repoName}/manifests/{reference}".
Men i dokumentasjonen er et trinn utelatt, uten dette kommer ingenting til å fungere. For monolitisk opplasting, akkurat som for delvis (chunked), må du utføre et PATCH-forespørsel før du laster opp lageret:
"PATCH /v2/{repoName}/blobs/uploads/{uuid}"
Content-Length: {size of chunk}
Content-Type: application/octet-stream
{Layer Chunk Binary Data}".
Ellers vil du ikke kunne komme videre fra første punkt, da du i stedet for den forventede 202-responsen vil få 4xx.
Nå ser algoritmen slik ut:
- Initialisering
- Patch lag
- Opplasting av lag
- Opplasting av manifest
Punktene 2 og 3 vil gjentas så mange ganger som nødvendig lag må lastes opp.
Først trenger vi et hvilket som helst image. Jeg skal bruke archlinux:latest.
docker pull archlinux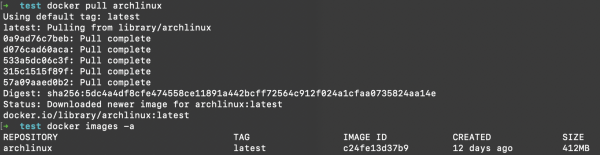
Nå skal vi lagre det lokalt for videre analyse.
docker save c24fe13d37b9 -o savedArch
Vi pakker ut den mottatte arkivet i den nåværende katalogen.
tar xvf savedArch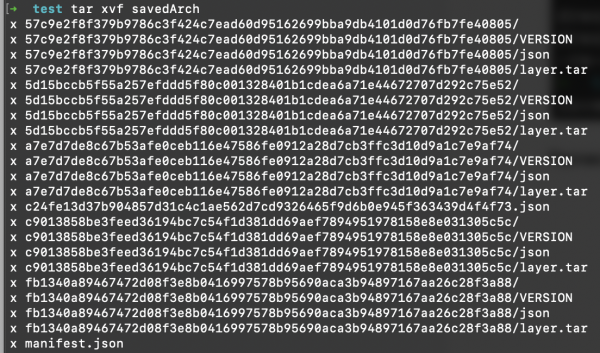
Som vi ser, ligger hvert lag i sin egen mappe. Nå skal vi se på strukturen av manifesten vi har mottatt.
cat manifest.json | json_pp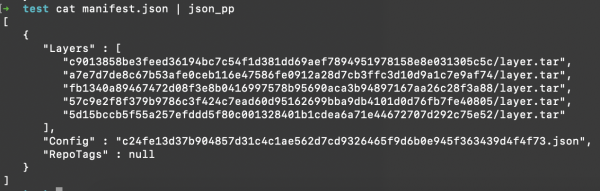
Ikke mye. La oss se hvilket manifest som trengs for opplasting, ifølge .
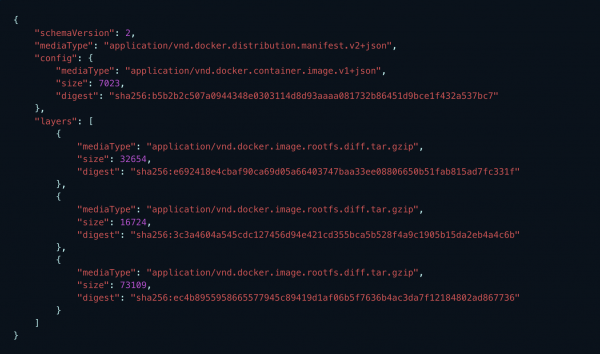
Det er åpenbart at det eksisterende manifestet ikke passer, så vi lager vårt eget med blackjack og prostituerte lag og konfigurasjoner.
Vi vil alltid ha minst én config-fil og en array av lag. Versjonen av skjemaet er 2 (aktuelt på tidspunktet for skrivingen), mediaType holder vi uendret:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Etter å ha laget et grunnleggende manifest må vi fylle det med gyldige data. For dette bruker vi mal for json-objektet av laget:
{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      },
denne vil vi legge til i manifestet for hvert lag.
Neste må vi finne størrelsen på konfigurasjonsfilen og erstatte plassholderne i manifestet med reelle data.
sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFileNå kan vi initiere opplastingsprosessen og lagre uuid, som alle påfølgende forespørselene må følge.
Det komplette skriptet ser omtrent slik ut:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
vi kan bruke et ferdig skript:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
Hva fikk vi som resultat?
For det første, reelle data for analyse, ettersom testene kjører i blazemeter og dataene fra docker-klientens forespørsel er ganske uinformative i motsetning til rene HTTP-forespørsel.
For det andre, førte overgangen til at vi kunne øke antallet virtuelle brukere for docker-opplasting med omtrent 150 % og oppnå en gjennomsnittlig responstid som var 20-25 % raskere. For docker-nedlasting klarte vi å øke antallet brukere med 500 %, mens den gjennomsnittlige responstiden dermed falt med omtrent 60 %.
Takk for oppmerksomheten.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish