

For flere måneder siden — en offentlig for PostgreSQL.
I løpet av denne tiden har du allerede brukt den mer enn 6000 ganger, men en av de nyttige funksjonene kan ha gått ubemerket hen — det er strukturert hjelp, som ser omtrent slik ut:
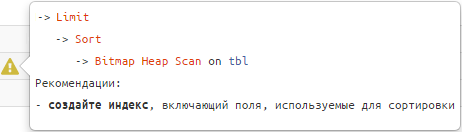
Lytt til dem, så blir spørringene dine "glatte og silkeaktige". 🙂
Og for å være seriøs, er mange situasjoner som gjør spørringen treg og "ressurskrevende" typiske og kan gjenkjennes gjennom strukturen og dataene i planen.
I dette tilfellet trenger hver enkelt utvikler ikke å lete etter optimaliseringsalternativer på egen hånd, kun basert på sin egen erfaring — vi kan gi ham hint om hva som skjer, hva som kan være årsaken, og hvordan man kan tilnærme seg løsningen. Det gjorde vi.
La oss se nærmere på disse casene — hvordan de identifiseres og hvilke anbefalinger de fører til.
For en bedre forståelse av temaet kan vi først lytte til den relevante delen fra , og deretter gå videre til en detaljert analyse av hvert eksempel:
#1: индексная «недосортировка»
Når skjer det
Vis den siste fakturaen for kunden "OOO Kolokolchik".
Hvordan identifisere
-> Limit
   -> Sort
      -> Indeks [Bare] Skanning [Bakover] | Bitmap Heap Scan
Anbefalinger
Brukt indeks utvide med sorteringsfelter.
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fakta"
, (random() * 1000)::integer fk_cli; -- 1K forskjellige fremmednøkler

CREATE INDEX ON tbl(fk_cli); -- indeks for fremmed nøkkel

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- filtrering etter spesifikk tilknytning
ORDER BY
  pk DESC -- vi ønsker bare en "siste" post
LIMIT 1; 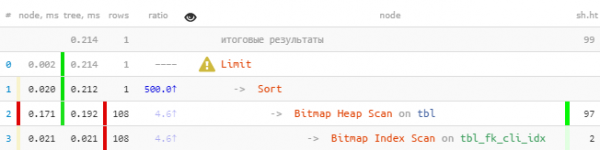
Man kan straks merke at mer enn 100 poster ble lest av indeksen, som deretter ble sortert, og bare én ble beholdt.
Vi fikser:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- la til sorteringsnøkkel
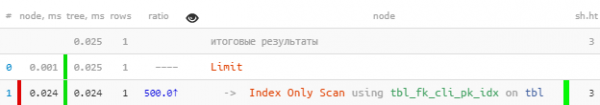
Selv på et så primitivt utvalg — 8.5 ganger raskere og 33 ganger færre lesninger. Effekten vil være mer tydelig jo flere "fakta" du har for hver verdi fk.
Jeg vil påpeke at en slik indeks vil fungere som en "prefiks" like godt som den tidligere også for andre spørringer med fk, hvor sorteringene etter pk ikke var og ikke er (mer om dette kan leses ). I tillegg vil den også sikre en normal støtte for eksplisitt foreign key for dette feltet.
#2: пересечение индексов (BitmapAnd)
Når skjer det
Vis alle avtaler for kunden «OOO Kolokollik», inngått på vegne av «NAO Lyutik».
Hvordan identifisere
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Anbefalinger
Opprett sammensatt indeks for feltene fra begge kilder eller utvid en eksisterende med feltene fra den andre.
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fakta"
, (random() *  100)::integer fk_org  -- 100 forskjellige fremmednøkler
, (random() * 1000)::integer fk_cli; -- 1K forskjellige fremmednøkler

CREATE INDEX ON tbl(fk_org); -- indeks for foreign key
CREATE INDEX ON tbl(fk_cli); -- indeks for foreign key

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- utdrag etter et spesifikt par 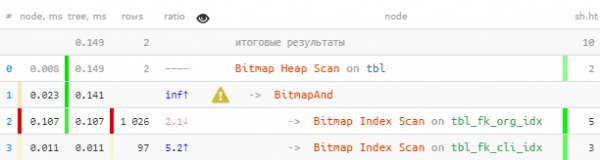
Vi fikser:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
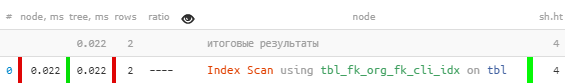
Her er gevinsten mindre, siden Bitmap Heap Scan er effektiv i seg selv. Men likevel 7 ganger raskere og 2,5 ganger færre lesinger.
#3: объединение индексов (BitmapOr)
Når skjer det
Vis de første 20 eldste «dine» eller ikke-tildelte forespørslene for behandling, der det er prioritert for dine.
Hvordan identifisere
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Anbefalinger
Bruk UNION [ALL] for å kombinere delspørringer for hver av OR-blokkene av betingelser.
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fakta"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- med sannsynlighet 1:16 er oppføringen "uavgjort"
    ELSE (random() * 100)::integer -- 100 forskjellige fremmednøkler
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- indeks med "tilsynelatende passende" sortering

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- dine
  fk_own IS NULL -- ... eller "uavgjorte"
ORDER BY
  pk
, (fk_own = 1) DESC -- først "dine"
LIMIT 20;
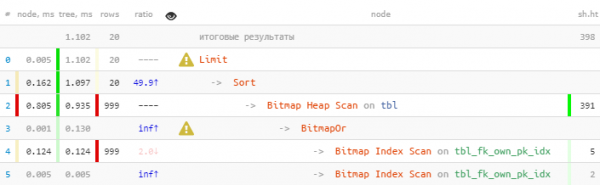
Vi fikser:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- først "dine" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- så "uavgjorte" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- men totalt - 20, mer er ikke nødvendig 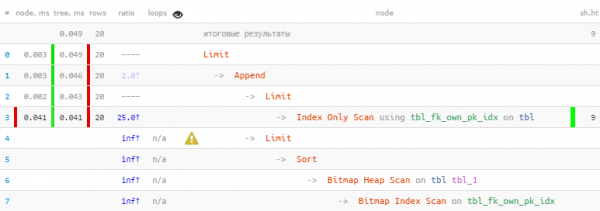
Vi benyttet oss av at alle 20 nødvendige oppføringer allerede ble hentet i den første blokken, så den andre, med en "dyrere" Bitmap Heap Scan, ble ikke engang utført - til slutt 22 ganger raskere, 44 ganger færre lesinger!
En detaljert beskrivelse av denne optimaliseringsmetoden med spesifikke eksempler kan leses i artiklene og .
Den generaliserte varianten av sortering etter flere nøkler (og ikke bare etter et par const/NULL) er beskrevet i artikkelen .
#4: читаем много лишнего
Når skjer det
Som regel skjer det når man ønsker å «legge til enda et filter» til allerede eksisterende spørring.
«Er det ikke slik at du har en som er lik, men med perlemorsknapper?» film "Diamantarm"
For example, modifying the above task to show the first 20 oldest "critical" requests for processing, regardless of their purpose.
Hvordan identifisere
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows 80% read
   && loops × RRbF > 100 -- and at the same time more than 100 records in total
Anbefalinger
Create [more] specialized index with a WHERE condition or include additional fields in the index.
If the filtering condition is "static" for your tasks — that is, does not anticipate an expansion of the list of values in the future — it is better to use a WHERE index. Different boolean/enum statuses fit well into this category.
If, however, the filtering condition can take different values, it is better to expand the index with these fields — as in the situation with BitmapAnd above.
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "facts"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 different foreign keys
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, that the request is "critical"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 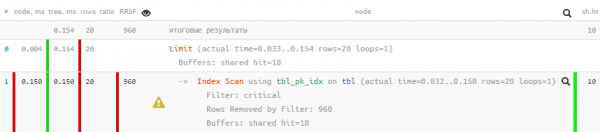
Vi fikser:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- added a "static" filtering condition
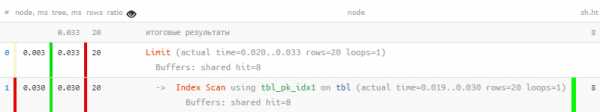
As we can see, filtering from the plan has completely disappeared, and the query has become 5 times faster.
#5: разреженная таблица
Når skjer det
Various attempts to create your own task processing queue, when a large number of updates/deletes of records on the table lead to a situation of a large number of "dead" records.
Hvordan identifisere
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Anbefalinger
Regularly perform manually VACUUM [FULL] or achieve adequately frequent operation by fine-tuning its parameters, including .
In most cases, such problems are caused by poor query composition during calls with business logic like those discussed in .
But it should be understood that even VACUUM FULL may not always help. In such cases, it is worth familiarizing oneself with the algorithm from the article .
#6: чтение с «середины» индекса
Når skjer det
It seems like we read a bit, and everything was indexed, and no unnecessary filtering — yet significantly more pages were read than desired.
Hvordan identifisere
-> Indeks [Bare] Skann [Bakover]
   && løkker × (rader + RRbF)  64
Anbefalinger
Se nøye på strukturen til den brukte indeksen og nøkkelområdene spesifisert i forespørselen — mest sannsynlig, en del av indeksen er ikke angitt. Du må trolig opprette en lignende indeks, men uten prefiksfeltene eller .
Eksempel:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fakta"
, (random() *  100)::integer fk_org  -- 100 forskjellige fremmednøkler
, (random() * 1000)::integer fk_cli; -- 1K forskjellige fremmednøkler

CREATE INDEX ON tbl(fk_org, fk_cli); -- alt nesten som i #2
-- men vi har allerede vurdert at en egen indeks på fk_cli er unødvendig og har fjernet den

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- men fk_org er ikke angitt, selv om det står i indeksen før
LIMIT 20; 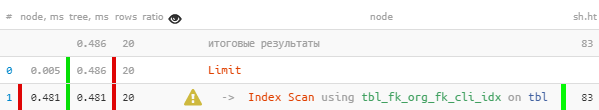
Alt ser ut til å være bra, selv med indeksen, men det er fortsatt mistenkelig — for hver av de 20 leste oppføringene måtte vi lese 4 datasider, 32KB per oppføring — er ikke det mye? Og navnet på indeksen tbl_fk_org_fk_cli_idx får oss til å tenke.
Vi fikser:
CREATE INDEX ON tbl(fk_cli); 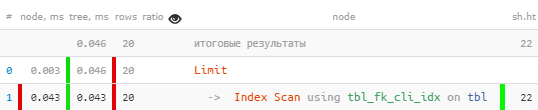
Plutselig — 10 ganger raskere, og 4 ganger mindre å lese!
Andre eksempler på situasjoner med ineffektiv bruk av indekser kan sees i artikkelen .
#7: CTE × CTE
Når skjer det
I forespørselen har vi skrevet "fete" CTEer fra forskjellige tabeller, og så bestemte vi oss for å gjøre JOIN.
Tilfellet er aktuelt for versjoner under v12 eller forespørselen med WITH MATERIALIZED.
Hvordan identifisere
-> CTE Skann
   && løkker > 10
   && løkker × (rader + RRbF) > 10000
      -- for stort kartesisk produkt av CTE
Anbefalinger
Analyser forespørselen nøye — er ? Если все-таки да, то implementere "ordbokoppslag" i hstore/json etter modellen beskrevet i .
#8: swap на диск (temp written)
Når skjer det
Engangsbehandling (sortering eller unifisering) av et stort antall oppføringer passer ikke inn i det tildelte minnet.
Hvordan identifisere
-> *
   && temp skrevet > 0
Anbefalinger
Hvis minnet som brukes av operasjonen ikke overskrider den angitte verdien for parameteren , bør det justeres. Det kan gjøres umiddelbart i konfigurasjonen for alle, eller gjennom SET [LOKAL] for en spesifikk forespørsel/transaksjon.
Eksempel:
SHOW work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 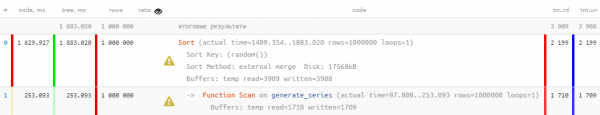
Vi fikser:
SET work_mem = '128MB'; -- før utførelsen av forespørselen 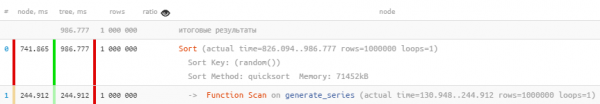
Av åpenbare grunner, hvis bare minnet brukes, og ikke disken, vil forespørselen også fullføres mye raskere. Samtidig reduseres belastningen på HDD.
Men må forstå at det ikke alltid er mulig å tildele mye minne – det vil rett og slett ikke være nok til alle.
#9: неактуальная статистика
Når skjer det
Det ble umiddelbart lagt mye inn i databasen, men vi rakk ikke å kjøre det. ANALYZE.
Hvordan identifisere
-> Sekvenskanning | Bitmap Haugskanning | Indeks [Bare] skanning [Bakover]
   && forhold >> 10
Anbefalinger
La oss gjennomføre ANALYZE.
Mer om denne situasjonen er beskrevet i .
#10: «что-то пошло не так»
Når skjer det
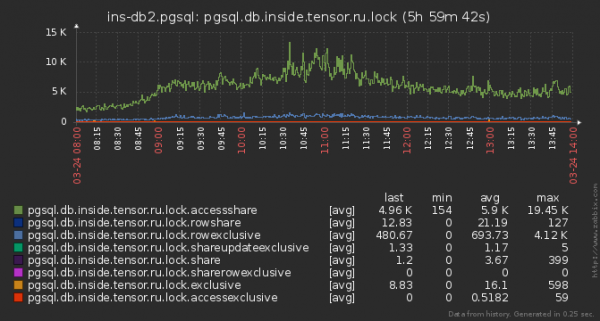
Det oppstod en venting på blokkering pålagt av en konkurrerende forespørsel, eller det manglet maskinvare ressurser for CPU/hypervisor.
Hvordan identifisere
-> *
   && (delt hit / 8K) + (delt lesning / 1K) < tid / 1000
      -- RAM hit = 64MB/s, HDD lesning = 8MB/s
   && tid > 100ms -- vi leste lite, men det tok for lang tid
Anbefalinger
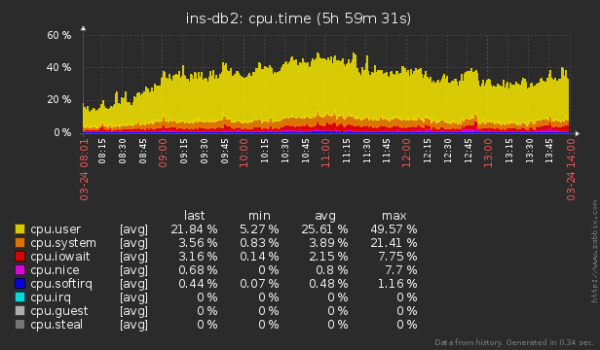
Bruk et eksternt system for overvåking av servere for å sjekke om det er blokkeringer eller unormal ressursforbruk. Vi har allerede fortalt om vår måte å organisere denne prosessen for hundrevis av servere. og .
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish