

Jeg heter Sergej, jeg er fra selskapet ITSumma, og jeg vil fortelle deg hvordan vi nærmer oss reservasjon i Kubernetes. I det siste har jeg vært mye involvert i rådgivning knyttet til implementering av forskjellige devops-løsninger for ulike team, og jeg jobber spesielt med prosjekter som bruker K8s. På konferansen Uptime day 4, som var dedikert til reservasjon i komplekse arkitekturer, holdt jeg en presentasjon om reservasjon av 'kuben', og her er en fri gjengivelse av den. Jeg vil bare på forhånd advare om at det ikke er en direkte håndbok til handling, men snarere en oppsummering av tanker om det aktuelle temaet.
I prinsippet er overvåking og reservasjon de to hovedverktøyene for å øke feiltoleransen til ethvert prosjekt. Men, men i Kubernetes balanseres alt automatisk, vil du si, alt skaleres automatisk, og hvis noe skjer, vil det vil løfte seg selv... Så ved første overfladiske undersøkelse av temaet, svarte internett meg på spørsmålet om hvordan folk nærmer seg reservasjon i K8s, med 'hvorfor?' Mange tror at Kubernetes er en magisk ting som løser alle infrastrukturproblemer og sørger for at prosjektet aldri vil falle. Men... verden er ikke slik den ser ut.
Hvordan nærmet vi oss reservasjonsprosessen tidligere? Vi hadde identiske plattformer for hosting - enten virtuelle maskiner eller fysiske servere, servere, der vi brukte tre grunnleggende praksiser:
- kode- og statisk synkronisering
- konfigurasjonssynkronisering
- replikering av databaser
Og vips: i hvilket som helst øyeblikk kan vi bytte over til reserveløsningen, alle er lykkelige, vi reiser oss og går.
Hva tilbyr vi for å øke den kontinuerlige tilgjengeligheten av Kubernetes-applikasjonen vår? Det første som ikke-offisiell dokumentasjon nevner, er å sette opp mange maskiner, lage mange mestre – antallet må oppfylle kravene for å oppnå quorum innen klyngen, og på hver av de mesterne må etcd, API, MC, scheduler osv. være oppe. Og det ser egentlig flott ut: når flere arbeidsnoder eller mestre svikter, vil klyngen vår ombalanseres, og applikasjonen fortsetter å fungere. Det ser igjen ut som magi! Men ofte befinner klyngen vår seg innenfor ett datasenter, noe som kan reise visse spørsmål. Hva skjer hvis en gravemaskin kommer og graver opp en kabel, om lynet slår ned, eller om det skjer en stor oversvømmelse? Alt går tapt, klyngen vår er ikke lenger der. Hvordan nærme seg reserven med denne siden av problemet i tankene?
Fremfor alt må du ha en annen klynge i varm reserve, det vil si en klynge som du kan bytte til når som helst. Fra Kuber-standpunktet må infrastrukturen være helt identisk. Så hvis det finnes noen ikke-standard plugins for filsystemet, tilpassede løsninger for ingress, må de være helt identiske på de to (eller tre, eller ti, alt etter hvor mye penger og krefter administratorene har) klusterne dine. Du må tydelig definere to sett med applikasjoner (deployment’er, statefulsets, daemonsets, cronjobs osv.): hvilke av dem kan kjøre på reserven konstant, og hvilke er bedre å ikke starte før det skjer en faktisk omkobling.
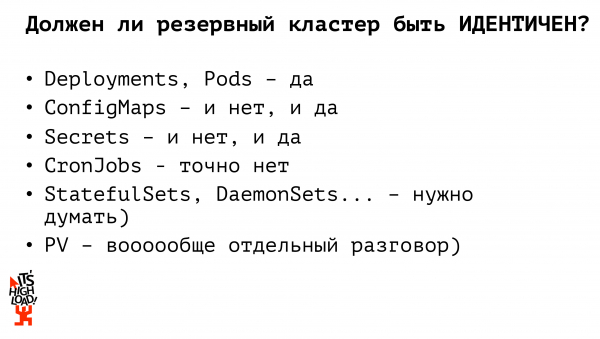
Bør vår reserveklynge være helt identisk med vår produksjonsklynge? Nei. Tidligere, i arbeidet med monolittiske prosjekter og fysisk infrastruktur, holdt vi praktisk talt et helt identisk miljø, men i Kubernetes synes jeg ikke dette er nødvendig. La oss se på hvorfor.
For example, let's start with the basic entities of Kubernetes — deployments — which should be identical. Applications must be running that can intercept traffic processing at any moment and allow our project to continue functioning. When it comes to configuration files, we need to assess whether they should be identical or not. In other words, if we, sensible people, do not use any prohibited substances and do not keep the database in K8s, then our configmaps should contain access settings for the production database (the backup process of which is built separately). Accordingly, to ensure access to the backup database instance, we need to have a separate configuration file (configmap). We work in the same way with secrets: passwords for database access, API keys; at any given moment, we can either have a production secret or a backup one. Thus, we already have two Kubernetes entities whose backup versions should not be identical to the production ones. The next entity worth stopping at is cronjob. Backup cronjobs must not be identical to the set of cronjobs in the production cluster! If we deploy a backup cluster and spin it up completely with all cronjobs enabled, for example, people will receive two emails from you simultaneously instead of one. Or some data synchronization with external sources will happen twice, and as a result, we start to get sick, cry, scream, and get angry.
So how do people from the internet suggest we organize the backup cluster? The second most popular answer after 'why bother?' is the use of Kubernetes Federation.
Hva er dette? Det er, la oss si, en stor meta-klynge. Hvis vi forestiller oss arkitekturen av Kubernetes – der vi har en master og flere noder – så har vi, når det gjelder federasjon, også en master og flere noder, men hver node er en egen klynge. Det betyr at vi jobber med de samme enhetene, de samme primitivene, som med en enkelt Kubernetes, bare at vi roterer ikke med våre fysiske maskiner, men med hele klynger. I forbundsrammen skjer det full synkronisering av føderale ressurser fra foreldre til avkom. For eksempel, hvis vi har initiert en distribusjon gjennom federasjonen – vil den bli distribuert til hver av våre underklynger. Hvis vi tar en hvilken som helst configmap, hemmelighet, og distribuerer den gjennom federasjonen – vil den spre seg til alle våre underklynger; samtidig tillater federasjonen å tilpasse våre ressurser på barna. Det vil si at vi tok en hvilken som helst configmap, distribuerte den gjennom federasjonen, og deretter, hvis vi trenger å justere noe på spesifikke klynger, går vi for å redigere på den spesifikke klyngen, og denne endringen vil ikke bli synkronisert noe sted.
Kubernetes Federation — et verktøy som ikke har eksistert så lenge, og som ikke støtter hele spekteret av ressurser som K8s tilbyr: i en av de første dokumentasjonsversjonene, ble det nevnt støtte kun for config maps, deployering av en replica-set og ingress. Hemmeligheter ble ikke støttet, og arbeid med volume ble heller ikke støttet. Et altfor begrenset sett av verktøy. Spesielt hvis vi liker å eksperimentere — for eksempel å sende våre egne ressurser til Kubernetes gjennom custom resource definition — kan vi ikke fylle dem inn i federasjonen. Så det er på en måte… en løsning som ligner på sannheten, men som får oss til å skyte oss selv i foten periodisk. På den annen side lar federasjonen oss administrere vår replicaset fleksibelt. For eksempel, hvis vi ønsker at 10 kopier av applikasjonen vår skal kjøre, vil federasjonen som standard dele dette tallet proporsjonalt mellom antallet klynger. Og dette kan faktisk konfigureres! Vi kan spesifisere at det aktive klyngen skal ha 6 kopier av applikasjonen vår, mens i den reserveklyngen, for å spare ressurser eller for egne eksperimenter — bare 4 kopier av applikasjonen vår. Det er også ganske praktisk. Men med federasjonen må vi bruke noen nye løsninger, deploye noe underveis og tvinge oss selv til å tenke litt mer...
Er det mulig å nærme seg prosessen med å reservere kubernetes på en enklere måte? Hvilke verktøy har vi tilgjengelig?
For det første har vi alltid et slags ci/cd-system, det vil si vi går ikke manuelt inn og skriver create/apply på servere. Systemet genererer yaml-filer for containerne våre.
For det andre finnes det flere klynger, vi har enten en eller flere (hvis vi er smarte) registre, som vi også har reservert. Og vi har det fantastiske verktøyet kubectl, som kan jobbe med flere klynger samtidig.
Sånn sett mener jeg at den enkleste og mest korrekte løsningen for å bygge et sikkerhetskluster, er en primitiv parallell distribusjon. Det finnes et eller annet pipeline i CI/CD-systemet; først bygger vi containerne våre, tester dem og ruller ut applikasjonene via kubectl på flere uavhengige klynger. Vi kan lage samtidige utrullinger på flere klynger. Følgelig løser vi også leveringen av konfigurasjoner på dette trinnet. Vi kan på forhånd definere et sett med konfigurasjoner for vår produksjonsklynge og et sett med konfigurasjoner for sikkerhetsklyngen, og på CI/CD-nivå rulle ut produksjonsmiljøet i produksjonsklyngen og sikkerhetsmiljøet i sikkerhetsklyngen. Sammenlignet med en føderasjon trenger vi ikke å gå til hver underklynge etter å ha definert den fødererte ressursen for å overstyrke noe. Vi har gjort dette på forhånd. For et bra stykke arbeid.
Men... det er... jeg skulle ha skrevet at det finnes "roten til alt ondt", men det er faktisk to. For det første, filsystemet. Det finnes en eller annen PV, eller vi bruker ekstern lagring. Hvis vi lagrer filer inne i klyngen, må vi følge de gamle praksisene fra tidene med maskinvareinfrastruktur: for eksempel synkronisere med lsync. Eller med en annen personlig foretrukket kronglete løsning. Vi ruller ut alt til andre maskiner og lever videre.
For det andre, og faktisk et enda mer viktig hinder, er databasen. Hvis vi er smarte mennesker og ikke holder databasen i Kubernetes, så er prosessen med å sikre data på den gamle måten — master-slave replikasjon, så bytter vi, og vi skal få replikatet oppdatert og leve godt. Men hvis vi holder databasen vår inne i klyngen, finnes det i prinsippet mange klare løsninger for å organisere samme master-slave replikasjon, mange løsninger for å sette opp databasen inne i Kubernetes.
Det er allerede skrevet milliarder av foredrag og artikler om databaseregistrering; det er egentlig ikke noe nytt her. Generelt, følg drømmene deres, lev som dere vil, oppfinn deres egne kompliserte løsninger, men tenk nøye gjennom hvordan dere vil gjøre sikkerhetskopieringen.
Nå, la oss nå se på hvordan prosessen med å bytte til en reserveløsning vil foregå i tilfelle brann. Først og fremst distribuerer vi stateless-applikasjoner parallelt. De påvirker ikke forretningslogikken i applikasjonene våre, prosjektet vårt. Vi kan alltid ha to sett med kjørende applikasjoner, og de kan begynne å motta trafikk. Det er veldig viktig under overgangen til reserveløsningen å sjekke om konfigurasjonene må overstyres. For eksempel har vi en produksjonsklynge i Kubernetes, en reservklynge i Kubernetes, en ekstern masterdatabase og en reservmasterdatabase. Vi har fire alternativer for hvordan disse applikasjonene i produksjonen kan begynne å samhandle. Vi kan få en database til å svikte, og da må vi omdirigere trafikken i produksjonsklyngen til den nye databasen, eller vi kan ha en klynge som svikter – og vi har gått over til reserveløsningen, men fortsetter å jobbe med produksjonsdatabasen. Det tredje alternativet er når begge systemene svikter, og vi må omdirigere begge applikasjonene og overstyre konfigurasjonen vår slik at de nye applikasjonene jobber med den nye databasen.
Så, hva kan vi konkludere fra alt dette?
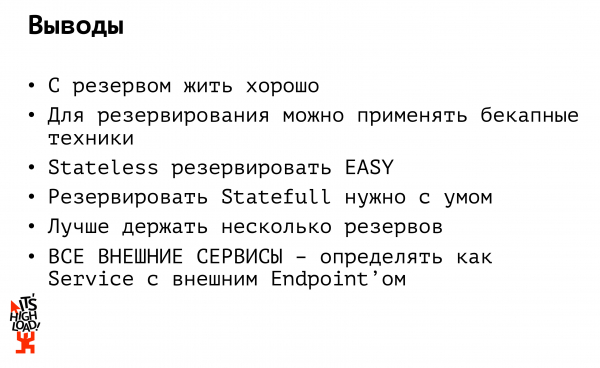
Første konklusjon: det er bra å ha reserveløsning. Men det er dyrt. Ideelt sett bør man ikke ha bare én reserveløsning. Man bør i realiteten ha flere reserveløsninger. For det første, reserveløsningen bør være minst i to forskjellige datasentre, og for det andre, helst hos en annen leverandør. Dette har ofte skjedd – og i min erfaring har det vært tilfeller. Jeg kan dessverre ikke navngi prosjekter, spesielt da det brant i et datasenter... Jeg tenkte: nå bytter vi til reserveløsning! Men de reserverte serverne sto i samme rack...
Eller tenk deg at Amazon blir sensurert i Russland (og det har skjedd). Og alt er ødelagt: hva nyttig er det at reserven vår ligger et annet sted hos Amazon? Det er ikke tilgjengelig heller. Så la meg gjenta: hold reserve, minst i et annet datasenter, og helst – hos en annen leverandør.
Den andre anbefalingen: hvis du har en applikasjon i Kubernetes som kommuniserer med eksterne kilder (det kan være både en database og et eksternt API), bør du absolutt definere det som en tjeneste med en ekstern endpoint, slik at du ikke må omdeploere 15 applikasjoner som kontakter den samme databasen når du gjør en endring. Definer databasen som en egen tjeneste, og kommuniser med den som om den var internt i klyngen: hvis databasen feiler, kan du endre IP-adressen ett sted og fortsette å fungere som før.
Og til slutt: jeg elsker 'kubikk', akkurat som jeg elsker eksperimenter med det. Jeg elsker også å dele resultatene av disse eksperimentene og min personlige erfaring. Derfor har jeg laget en serie webinarer om K8s, velkommen til for mer informasjon.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish