

Serverless ― det handlar ikke om fysisk fravær av servere. Det er ikke en «morder» av containere og ikke en forbigående trend. Det er en ny tilnærming til systembygging i skyen. I dagens artikkel skal vi berøre arkitekturen til Serverless-applikasjoner, se hvilken rolle Serverless-tjenesteleverandøren spiller og open-source prosjekter. Til slutt vil vi snakke om bruken av Serverless.
Jeg vil skrive serverdelen av en applikasjon (til og med en nettbutikk). Det kan være en chat, en tjeneste for publisering av innhold, eller en lastbalanserer. Uansett vil det bli en del hodebry: jeg må forberede infrastrukturen, definere avhengigheter til applikasjonen, tenke på operativsystemet til vertsmaskinen. Så må jeg oppdatere små komponenter som ikke påvirker resten av monolitten. Og vi skal ikke glemme om skalering under belastning.
Hva om vi tar ephemeral containere, hvor nødvendige avhengigheter allerede er forhåndsinstallert, og der disse containerne er isolert fra hverandre og fra vertssystemet? Vi kan dele monolitten opp i mikrotjenester, hvor hver kan oppdateres og skaleres uavhengig av de andre. Ved å plassere koden i en slik container, kan jeg kjøre den på hvilken som helst infrastruktur. Det ser allerede bedre ut.
Men hvis jeg ikke ønsker å konfigurere containere? Jeg ønsker ikke å tenke på skalering av applikasjonen. Jeg vil ikke betale for stillestående containere når belastningen på tjenesten er minimal. Jeg ønsker å skrive kode. Fokuser på forretningslogikken og lansere produkter på markedet med lysets hastighet.
Disse tankene førte meg til serverløse beregninger. Serverless i dette tilfellet betyr ikke fysisk fravær av servere, men fravær av hodebry med å administrere infrastrukturen.
Ideen er at logikken til applikasjonen brytes ned i uavhengige funksjoner. De har en hendelsesstruktur. Hver av funksjonene utfører en «mikrooppgave». Alt som kreves fra utvikleren er å laste opp funksjoner til den konsollen som tilbys av skyleverandøren og knytte dem til hendelseskilder. Koden vil bli kjørt på forespørsel i en automatisk tilberedt container, og jeg betaler bare for kjøretiden.
La oss se på hvordan utviklingsprosessen for applikasjonen nå vil se ut.
Fra utviklerens side
Tidligere begynte vi å snakke om applikasjonen for nettbutikken. I den tradisjonelle tilnærmingen utfører en monolitisk applikasjon hovedlogikken i systemet. Serveren med applikasjonen kjører hele tiden, selv når det ikke er noen belastning.
For å gå over til serverless, deler vi applikasjonen opp i mikrooppgaver. For hver av dem skriver vi vår egen funksjon. Funksjonene er uavhengige av hverandre og lagrer ikke statusinformasjon (stateless). De kan til og med være skrevet på forskjellige språk. Hvis en av dem "feiler", stopper ikke applikasjonen helt opp. Arkitekturen til applikasjonen vil se slik ut:
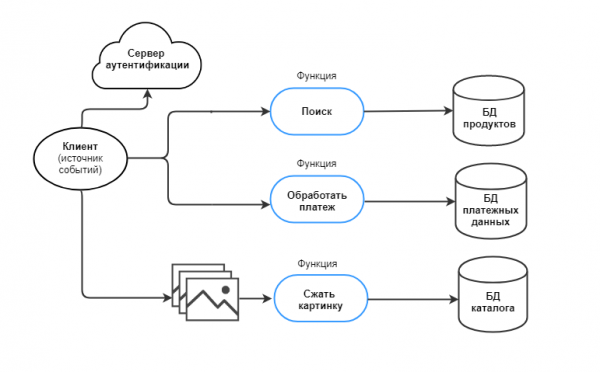
Delingen i funksjoner i Serverless ligner arbeidet med mikrotjenester. Men en mikrotjeneste kan utføre flere oppgaver, mens en funksjon i ideelt fall bør utføre én. La oss anta at det er oppgaven å samle statistikk og vise den på forespørsel fra brukeren. I den mikrotjenestebaserte tilnærmingen utfører én tjeneste oppgaven med to inngangspunkter: for skriving og for lesing. I serverless computing vil dette være to forskjellige funksjoner, som ikke er koblet sammen. Utvikleren sparer beregningsressurser hvis, for eksempel, statistikken oppdateres oftere enn den lastes ned.
Serverless-funksjoner må utføres innenfor en kort tidsramme (timeout) som bestemmes av tjenesteleverandøren. For eksempel er timeout for AWS 15 minutter. Det betyr at langvarige funksjoner må endres i henhold til kravene – dette er hva som skiller Serverless fra andre populære teknologier i dag (containere og Platform as a Service).
Vi tildeler hvert funksjon et hendelse. En hendelse er et trigger for handling:
Hendelse
Handling som funksjonen utfører
Et bilde av produktet er lastet opp til lagringen
Komprimere bildet og laste det opp til katalogen
Adressen til den fysiske butikken har blitt oppdatert i databasen
Laste det nye stedet inn i kartene
Kunden betaler for varen
Starte betalingsbehandlingen
Hendelser kan være HTTP-forespørsler, strømmer av data, meldingskøer og så videre. Kilder til hendelser er endringen eller opprettelsen av data. I tillegg kan funksjoner kjøres på timer.
Arkitekturen er utviklet, og applikasjonen har nesten blitt serverless. Nå går vi videre til tjenesteleverandøren.
Fra leverandørens side
Vanligvis tilbys serverless computing av leverandører av skyløsninger. De kalles forskjellige ting: Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
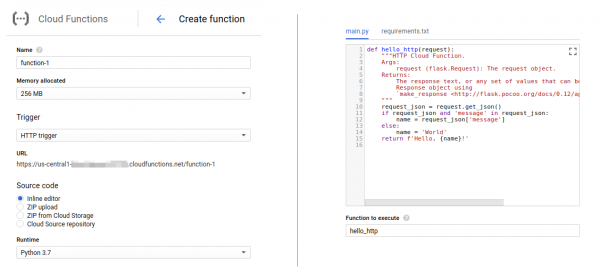
Vi vil bruke tjenesten gjennom konsollen eller kundesenteret til leverandøren. Funksjonskoden kan lastes opp på en av følgende måter:
- skrive koden i de innebygde redigererne via nett-konsollen,
- laste opp et arkiv med koden,
- arbeide med offentlige eller private git-repositorier.
Her setter vi opp hendelser som utløser funksjonen. Ulike leverandører kan ha ulike sett med hendelser.
Leverandøren har bygget og automatisert et system for Function as a Service (FaaS) på sin infrastruktur:
- Funksjonskoden havner i lagringen på leverandørens side.
- Når det dukker opp en hendelse, blir containere med det forberedte miljøet automatisk rullet ut på serveren. Hver instans av funksjonen har sin egen isolerte container.
- Fra lagringen sendes funksjonen til containeren, beregnes og gir et resultat.
- Antall parallelle hendelser øker – antallet containere øker. Systemet skalerer automatisk. Hvis brukerne ikke henvender seg til funksjonen, vil den være inaktiv.
- Leverandøren angir tiden for containernes inaktivitet – hvis funksjonene ikke dukker opp i containere i løpet av denne tiden, blir de destruert.
Slik får vi Serverless «out of the box». Vi betaler for tjenesten etter pay-as-you-go-modellen, bare for de funksjonene som brukes, og bare for den tiden de ble brukt.
For å bli kjent med tjenesten, tilbyr leverandørene opptil 12 måneders gratis testing, men begrenser totalt behandlingstid, antall forespørsel per måned, penger eller energiforbruk.
Den viktigste fordelen med å jobbe med leverandøren er muligheten til å ikke bekymre seg for infrastrukturen (servere, virtuelle maskiner, containere). Fra sin side kan leverandøren implementere FaaS både med egne utviklinger og ved hjelp av open-source verktøy. Dette vil vi snakke om videre.
Fra open source-siden
De siste par årene har open-source fellesskapet jobbet aktivt med Serverless-verktøy. Blant annet bidrar de største aktørene på markedet til utviklingen av serverløse plattformer:
- Google tilbyr utviklerne sitt open-source verktøy ― . IBM, RedHat, Pivotal og SAP har deltatt i utviklingen av dette;
- IBM har jobbet med Serverless-plattformen , som senere ble et prosjekt under Apache Foundation;
- Microsoft åpnet deler av koden til plattformen .
Utviklingen pågår også i retning av serverless-rammeverk. og som blir distribuert innenfor forhåndskonfigurerte Kubernetes-klynger, fungerer både med Kubernetes og Docker Swarm. Rammeverket fungerer som en slags kontroller – det forbereder et kjøre miljø i klyngen ved forespørsel, og deretter kjører det funksjonen der.
Rammeverkene gir rom for konfigurasjon av verktøyet etter egne behov. I Kubeless kan utvikleren for eksempel sette en timeout for funksjonskjøringen (standardverdien er 180 sekunder). Fission forsøker å løse problemet med kald start ved å holde en del av containerne alltid på, selv om dette dermed medfører kostnader for ressursene. OpenFaaS tilbyr et utvalg av triggere for enhver smak: HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs og flere.
Instruksjoner for hvordan man kommer i gang kan finnes i den offisielle dokumentasjonen til rammeverkene. Å jobbe med dem krever litt mer ferdigheter enn å jobbe med en leverandør – dette er minimum evnen til å starte en Kubernetes-klynge via CLI. Maksimalt inkluderer det å bruke andre open-source verktøy (for eksempel kømanageren Kafka).
Uavhengig av hvordan vi jobber med Serverless – enten gjennom en leverandør eller ved hjelp av open-source, vil vi få en rekke fordeler og ulemper med Serverless-tilnærmingen.
Fra perspektivet av fordeler og ulemper
Serverless utvikler ideene fra container-infrastruktur og mikrotjeneste-tilnærming, der team kan jobbe i flerspråklig modus uten å være bundet til én plattform. Byggingen av systemet forenkles, og det blir enklere å rette feil. Mikrotjenestearkitekturen gjør det mulig å legge til ny funksjonalitet i systemet betydelig raskere enn i tilfelle med en monolittisk applikasjon.
Serverless reduserer utviklingstiden enda mer, og lar utvikleren fokusere utelukkende på forretningslogikken til applikasjonen og koding. Som et resultat forkortes tiden det tar å få utviklinger på markedet.
Som en bonus får vi automatisk skalering etter belastning, og betaler kun for ressursene som brukes og bare når de brukes.
Som med enhver teknologi, har Serverless sine ulemper.
En slik ulempe kan være tiden for kald start (i gjennomsnitt opptil 1 sekund for språk som JavaScript, Python, Go, Java, Ruby).
På den ene siden avhenger tiden for kald oppstart i praksis av mange variabler: språket funksjonen er skrevet i, antall biblioteker, kodevolum, interaksjon med ekstra ressurser (som databaser eller autentiseringstjenere). Siden utvikleren har kontroll over disse variablene, kan han redusere oppstartstiden. Men på den andre siden kan utvikleren ikke kontrollere oppstartstiden for containeren ― her avhenger alt av leverandøren.
Kald oppstart kan bli til varm oppstart når funksjonen gjenbruker en container som ble startet av en tidligere hendelse. Denne situasjonen vil oppstå i tre tilfeller:
- hvis kundene ofte bruker tjenesten og antallet henvendelser til funksjonen øker;
- hvis leverandøren, plattformen eller rammeverket lar holde noen containere alltid kjørende;
- hvis utvikleren starter funksjoner på en timer (for eksempel hvert 3. minutt).
For mange applikasjoner er kald oppstart ikke et problem. Her må man ta utgangspunkt i typen og oppgavene til tjenesten. En oppstartsforsinkelse på ett sekund er ikke alltid kritisk for en forretningsapplikasjon, men kan bli kritisk for medisinske tjenester. Sannsynligvis vil en serverløs tilnærming ikke være passende i dette tilfellet.
Det neste problemet med Serverless omtales som den korte levetiden til funksjonen (timeout, innen denne tidsrammen må funksjonen være utført).
Men hvis man skal jobbe med langvarige oppgaver, kan man bruke en hybridarkitektur ― kombinere Serverless med en annen teknologi.
Ikke alle systemer vil kunne fungere etter Serverless-modellen.
Noen applikasjoner vil fortsatt lagre data og tilstand under kjøring. Noen arkitekturer vil forbli monolittiske, og noen funksjoner vil være langvarige. Men (som tidlige skyteknologier, og senere containere), er Serverless en teknologi med stort potensial.
I denne forbindelse ønsker jeg å smidig gå over til spørsmålet om anvendelsen av Serverless-tilnærmingen.
Fra et anvendelsesperspektiv
I løpet av 2018 økte bruken av Serverless . Blant selskapene som allerede har implementert teknologien i tjenestene sine, finner vi markedsgigantene Twitter, PayPal, Netflix, T-Mobile, Coca-Cola. Samtidig må man forstå at Serverless ikke er en mirakelkur, men et verktøy for å løse et bestemt sett med oppgaver:
- Redusere ressursstillstand. Du trenger ikke å ha en virtuell maskin konstant aktiv for tjenester med lite bruk.
- Behandle data "on-the-fly". Kompresjon av bilder, fjerning av bakgrunn, endring av videokoding, arbeid med IoT-sensorer, utførelse av matematiske operasjoner.
- "Lim sammen" andre tjenester. Git-repositorium med interne applikasjoner, en chatbot i Slack med Jira og kalender.
- Lastbalansering. Her stopper vi opp for en nærmere omtale.
La oss anta at det finnes en tjeneste som har 50 besøkende. Det er en virtuell maskin med svakere maskinvare som kjører for den. Periodisk øker belastningen på tjenesten betraktelig. Da takler ikke den svake maskinvaren det.
Vi kan inkludere en lastbalanserer i systemet som fordeler belastningen på tre virtuelle maskiner. I denne fasen kan vi ikke nøyaktig forutsi belastningen, så vi holder en del ressurser aktivert "for sikkerhets skyld". Og vi betaler mer for stillstand.
I en slik situasjon kan vi optimalisere systemet gjennom en hybrid tilnærming: vi lar én virtuell maskin være bak lastbalansereren og setter opp en lenke til Serverless Endpoint med funksjoner. Hvis belastningen overskrider en viss terskel, starter lastbalansereren funksjonsinstanser som tar seg av en del av forespørslene.
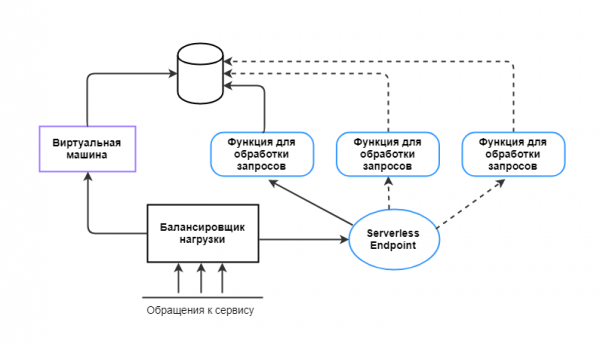
Dermed kan Serverless brukes der man ikke trenger å behandle et stort antall forespørsel ofte, men intensivt. I så fall er det mer lønnsomt å aktivere flere funksjoner i 15 minutter enn å ha en virtuell maskin eller server konstant aktiv.
Til tross for alle fordelene med serverløse beregninger, bør man først vurdere logikken til applikasjonen før implementering og forstå hvilke oppgaver Serverless kan løse i dette spesifikke tilfellet.
Serverless og Selectel
I Selectel har vi allerede gjennom vårt kontrollpanel. Nå bygger vi vår egen FaaS-plattform. Vi ønsker at utviklere skal kunne løse sine oppgaver med Serverless gjennom et brukervennlig, fleksibelt grensesnitt.
Hvis du har ideer om hvordan den ideelle FaaS-plattformen bør være, og hvordan du ønsker å bruke Serverless i prosjektene dine, del dem gjerne i kommentarene. Vi vil ta hensyn til ønskene dine i utviklingen av plattformen.
Materialet brukt i artikkelen:
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish