

Vi i Badoo overvåker kontinuerlig nye teknologier og vurderer om det er verdt å bruke dem i systemet vårt. Vi ønsker å dele en av disse studiene med samfunnet. Den er dedikert til Loki – et system for aggregasjon av logger.
Loki er en løsning for lagring og visning av logger, samt at denne stakken tilbyr et fleksibelt system for analyse av dem og sending av data til Prometheus. I mai kom det en ny oppdatering som utviklerne aktivt promoterer. Vi ble interessert i hva Loki kan gjøre, hvilke muligheter den gir, og i hvilken grad den kan være et alternativ til ELK – stakken vi bruker nå.
Hva er Loki
Grafana Loki er et sett med komponenter for et fullverdig system for arbeid med logger. I motsetning til andre lignende systemer er Loki basert på ideen om kun å indeksere metadataene til loggene – labels (som i Prometheus), mens selve loggene komprimeres i separate chunks.
,
Før vi går videre til beskrivelsen av hva som kan gjøres med Loki, vil jeg forklare hva som menes med «ideen om å indeksere kun metadata». La oss sammenligne tilnærmingen til Loki og tilnærmingen til indeksering i tradisjonelle løsninger, som Elasticsearch, ved hjelp av et eksempel på en linje fra nginx-loggen:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Tradisjonelle systemer parser hele linjen, inkludert felt med mange unike verdier som user_id og item_id, og lagrer alt i store indekser. Fordelen med denne tilnærmingen er at man kan utføre komplekse forespørsel raskt, siden nesten alle dataene er i indeksen. Men det koster å ha en stor indeks, som krever mer minne. Resultatet er at den fulltekstsøkende indeksen for logger er sammenlignbar i størrelse med selve loggene. For å søke raskt i den, må indeksen lastes inn i minnet. Jo flere logger, desto raskere vokser indeksen og desto mer minne bruker den.
Loki-tilnærmingen krever at vi kun henter nødvendige data fra strengen, hvor antallet av verdier er lite. Slik får vi en liten indeks og kan søke etter data ved å filtrere dem etter tid og indekserte felt, deretter skanne det som er igjen med regulære uttrykk eller substring-søk. Prosessen kan virke litt treg, men Loki deler opp forespørselen i flere deler og utfører dem parallelt, noe som gjør at et stort volum av data kan behandles på kort tid. Antallet shards og parallelle forespørsel i dem kan konfigureres; dermed er mengden data som kan behandles per tidsenhet lineært avhengig av antallet ressurser som tilbys.
Denne avveiningen mellom en stor rask indeks og en liten indeks med parallell full skanning lar Loki kontrollere systemkostnadene. Den kan fleksibelt tilpasses og utvides i henhold til behov.
Loki-stakken består av tre komponenter: Promtail, Loki, Grafana. Promtail samler logger, behandler dem og sender dem til Loki. Loki lagrer dem. Og Grafana kan spørre om data fra Loki og vise dem. Generelt kan Loki brukes ikke bare til lagring av logger og søk i dem. Hele stakken gir store muligheter for behandling og analyse av innkommende data, ved å bruke Prometheus-metoden.
Beskrivelse av installasjonsprosessen kan finnes .
Jeg mener, at det er en fornøjelse at arbejde med logs i R80. Vi har en meget smart søgestreng, der giver os mulighed for at "skære" både på vilkårlig tekst, blade og andre indeksérbare parametre som kilde, destination, handling osv.
Søking i logger kan utføres i det spesielle grensesnittet i Grafana – Explorer. For forespørslene brukes LogQL-språket, som ligner veldig på PromQL som brukes i Prometheus. I prinsippet kan det betraktes som en distribuert grep.
Søkegrensesnittet ser slik ut:
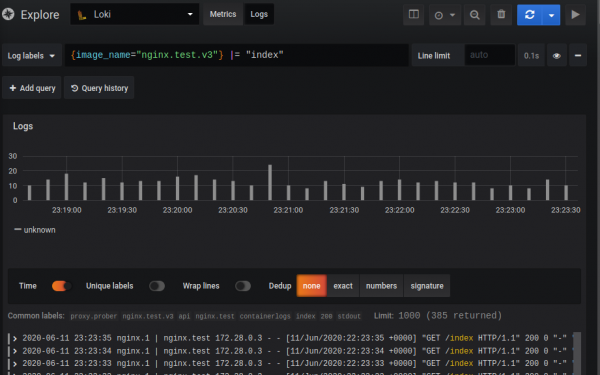
Selve forespørselen består av to deler: selector og filter. Selector er søk i indekserte metadata (etiketter) som er tildelt logger, mens filter er søkestrengen eller regexen som brukes til å filtrere postene som er bestemt av selectoren. I eksempelet som er gitt: I klammeparentesene er selectoren, alt etter er filteret.
{image_name="nginx.promtail.test"} |= "index"På grunn av hvordan Loki fungerer, kan man ikke gjøre forespørsel uten selector, men etikettene kan gjøres så generelle som ønsket.
Selector er key-value verdier i klammeparenteser. Man kan kombinere selectorer og angi forskjellige søkekriterier ved å bruke operatorene =, != eller regulære uttrykk:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Vil finne logger med etiketten instance som har verdiene kafka-2, kafka-3 og ekskludere dev
En filter er en tekst eller regex som vil filtrere all data hentet av selektoren.
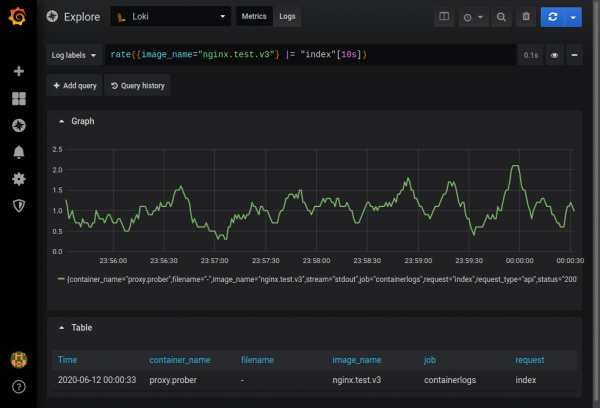
Det er mulighet for å hente ad-hoc-diagrammer basert på innsamlede data i metrics-modus. For eksempel kan man finne frekvensen av oppføringen i nginx-loggene som inneholder strengen index:
Fullstendig beskrivelse av mulighetene kan finnes i dokumentasjonen .
Loggparsing
Det finnes flere metoder for å samle logger:
- Ved hjelp av Promtail, en standardkomponent i stabelen for loggsamling.
- Direkte fra Docker-containere ved hjelp av
- Bruke Fluentd eller Fluent Bit, som kan sende data til Loki. I motsetning til Promtail har de ferdige parser for nesten alle typer logger og takler til og med multiline-logger.
Vanligvis brukes Promtail til parsing. Det gjør tre ting:
- Finner datakilder.
- Knytter etiketter til dem.
- Sender data til Loki.
Per nå kan Promtail lese logger fra lokale filer og fra systemd journal. Det må installeres på hver maskin hvor loggene skal samles.
Det er integrering med Kubernetes: Promtail finner automatisk tilstanden til klyngen via Kubernetes REST API og samler logger fra noden, tjenesten eller podden, samtidig som det knytter etiketter basert på metadata fra Kubernetes (podnavn, filnavn osv.).
Det er også mulig å knytte etiketter basert på data fra loggen ved hjelp av Pipeline. Pipen til Promtail kan bestå av fire typer stadium. Mer detaljert - i , jeg vil også nevne noen nyanser.
- Parsing stages. Dette er RegEx og JSON-stadiet. På dette stadiet henter vi data fra loggene til det såkalte extracted map. Vi kan hente fra JSON ved bare å kopiere feltene vi trenger til extracted map, eller ved hjelp av regulære uttrykk (RegEx), der de “mapper” named groups. Extracted map representerer et key-value lager, hvor key er navnet på feltet og value er verdien fra loggene.
- Transform stages. Dette stadiet har to alternativer: transform, hvor vi definerer regler for transformasjon, og source - datakilden for transformasjon fra extracted map. Hvis det ikke finnes et felt i extracted map, vil det bli opprettet. Dermed kan vi lage etiketter som ikke er basert på extracted map. På dette stadiet kan vi manipulere dataene i extracted map ved å bruke en ganske kraftig . I tillegg må vi huske at extracted map lastes helt inn under parsing, noe som gir muligheten til for eksempel å sjekke verdien i den: “{{if .tag}tag value exists{end}}”. Malen støtter betingelser, løkker og enkelte strengefunksjoner som Replace og Trim.
- Handlingsfaser. På dette stadiet kan vi gjøre noe med det utdragne:
- Opprett en etikett fra extracted data som vil bli indeksert av Loki.
- Endre eller sette tidspunktet for hendelsen i loggen.
- Endre dataene (loggtekst) som skal sendes til Loki.
- Opprett metrikker.
- Filtreringsfaser. Match-fasen, hvor vi kan sende unødvendige poster til /dev/null, eller viderebehandle dem.
Jeg viser et eksempel på behandling av vanlige nginx-logger, og hvordan vi kan parse logger ved hjelp av Promtail.
For testen tar vi en modifisert nginx jwilder/nginx-proxy:alpine som nginx-proxy og en liten demon som kan forespørre seg selv via HTTP. Demonen har flere endepunkter som den kan gi svar med forskjellig størrelse, ulike HTTP-status og oppholdstid.
Vi vil samle logger fra Docker-beholdere som kan finnes på stien /var/lib/docker/containers//-json.log
I docker-compose.yml konfigurerer vi Promtail og angir banen til konfigurasjonen:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Vi legger til i promtail.yml banen til loggene (i konfigurasjonen finnes det et alternativ "docker" som gjør det samme med en enkelt linje, men det ville ikke vært så tydelig):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # for linux only
Når en slik konfigurasjon er aktivert, vil logger fra alle beholdere bli sendt til Loki. For å unngå dette, endrer vi innstillingene for testnginx i docker-compose.yml – vi legger til loggingsfeltet tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Vi retter opp promtail.yml og konfigurerer pipeline. Logger av denne typen kommer inn:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /api/index HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.096"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] "GET /200 HTTP/1.1" 200 0 "-" "Stub_Bot/0.1" "0.000"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Pipeline-steg:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Vi henter innholdet fra JSON-feltet stream, attrs, attrs.tag (hvis de finnes) og plasserer dem i en extracted map.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
Hvis feltet tag ble lagt i extracted map, bruker vi regex for å hente ut navnene på bildet og containeren.
 - labels:
     image_name:
     container_name:
Vi tilordner etiketter. Hvis det finnes nøkler image_name og container_name i extracted data, vil deres verdier bli tildelt de tilhørende etikettene.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Vi kaster bort alle logger hvor de angitte etikettene image_name og container_name ikke ble funnet.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
For alle logger der image_name er lik nginx.promtail.test, henter vi feltet log fra den opprinnelige loggen og plasserer det i extracted map med nøkkelen row.
  - regex:
         # suppress forego colors
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
Vi renser inngangsstrengen med regex og henter ut nginx virtual host og nginx logg-strengen.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Vi parser nginx-loggen med regex.
    - regex:
           source: request_url
           expression: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?.]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?.]+).*$
Vi analyserer request_url. Ved hjelp av regex bestemmer vi forespørselens hensikt: statiske filer, bilder, API og plasserer den tilhørende nøkkelen i extracted map.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Ved hjelp av betingede operatorer i Template sjekker vi de tilordnede feltene i extracted map og setter de nødvendige verdiene for feltet request_type: photo, static, API. Setter other hvis det ikke var mulig. Nå inneholder request_type forespørselstypen.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
Vi tilordner etiketter til api_request, virtual_host, request_type og status (HTTP status) basert på det som er lagt i extracted map.
       - output:
           source: nginx_log_row
Vi endrer output. Nå sendes den rensede nginx-loggen fra extracted map til Loki.
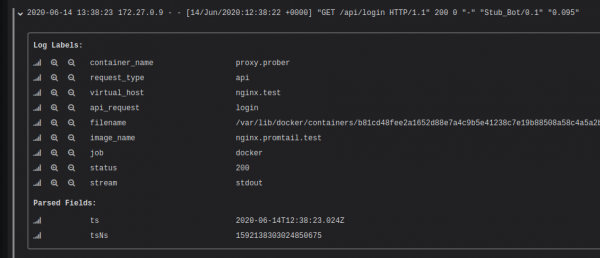
Etter å ha startet den gitte konfigurasjonen kan man se at hver post har fått tildelt etiketter basert på dataene fra loggen.
Det er viktig å merke seg at utvinning av etiketter med høy kardinalitet kan betydelig bremse Loki. Det vil si at man ikke bør plassere for eksempel user_id i indeksen. Les mer om dette i artikkelen “”. Men det betyr ikke at man ikke kan søke etter user_id uten indekser. Man må bruke filtre under søket (for å «greppe» dataene), mens indeksen her fungerer som en identifikator for strømmen.
Visualisering av logger
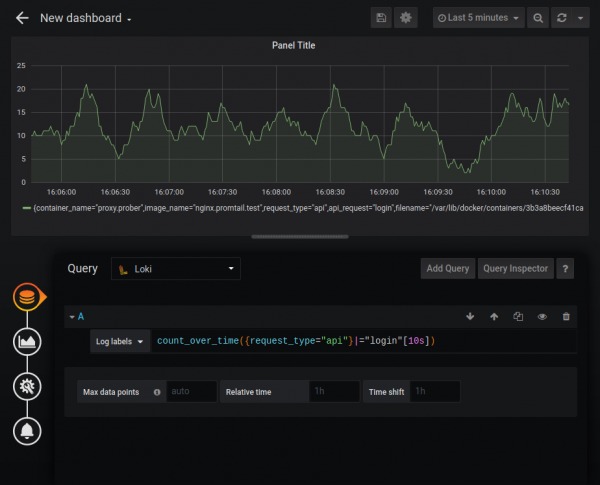
Loki kan brukes som datakilde for grafikker i Grafana ved hjelp av LogQL. Følgende funksjoner støttes:
- rate — antall oppføringer per sekund;
- count over time — antall oppføringer i et gitt tidsintervall.
Det finnes også aggregasjonsfunksjoner som Sum, Avg og andre. Man kan lage ganske komplekse grafer, for eksempel graf over antall HTTP-feil:
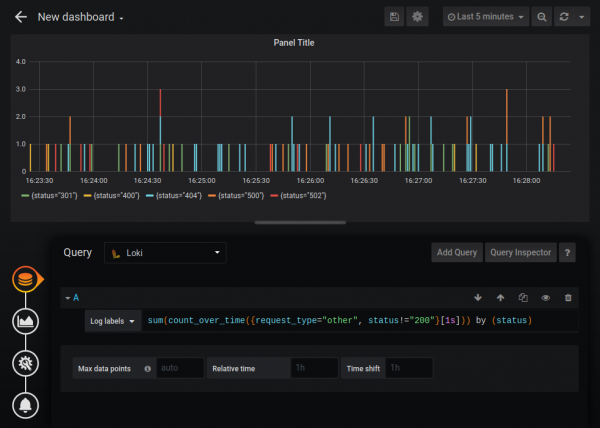
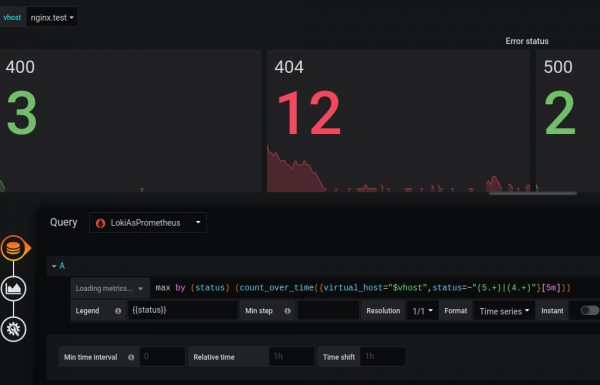
Den standard data source Loki er noe begrenset i funksjonalitet sammenlignet med data source Prometheus (for eksempel kan man ikke endre legenden), men Loki kan kobles til som en kilde av typen Prometheus. Jeg er ikke sikker på om dette er dokumentert atferd, men ifølge utviklernes svar “”, er dette for eksempel helt lovlig, og Loki er fullstendig kompatibel med PromQL.
Vi legger til Loki som datakilde av typen Prometheus og skriver inn URL /loki:

Og man kan lage grafer som om vi jobbet med metrikker fra Prometheus:
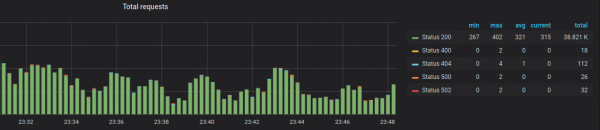
Jeg tror at forskjellen i funksjonalitet er midlertidig, og utviklerne vil rette dette i fremtiden.
Metrikker
I Loki er det mulig å utvinne numeriske metrikker fra logger og sende dem til Prometheus. For eksempel, i nginx-loggen finner vi antall bytes på svaret, samt, med en bestemt modifikasjon av standard loggformat, tiden i sekunder som ble brukt på svaret. Disse dataene kan utvinnes og sendes til Prometheus.
Vi legger til en ny seksjon i promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "svartid ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "total response bytes"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "telle response bytes"
           source: bytes_out
           config:
             action: inc
Alternativet gjør at du kan definere og oppdatere metrikker basert på data fra extracted map. Disse metrikene sendes ikke til Loki – de vises i Promtail /metrics-endepunktet. Prometheus må konfigureres slik at den kan motta dataene som er samlet på dette stadiet. I det gitte eksemplet for request_type="api" samler vi en histogrammetrisk. Med denne typen metrikker er det enkelt å få percentiler. For statisk og bilder samler vi summen av byte og antallet linjer der vi fikk byte for å beregne gjennomsnittet.
Les mer om metrikker .
Åpner porten på Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
Forsikrer oss om at metrikker med prefikset promtail_custom har dukket opp:
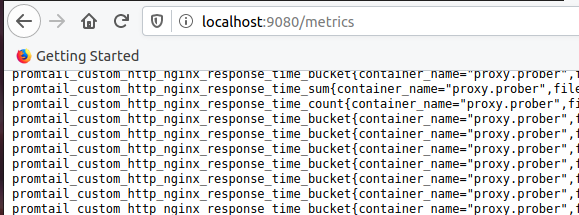
Konfigurerer Prometheus. Legger til jobben promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
Og tegner et diagram:
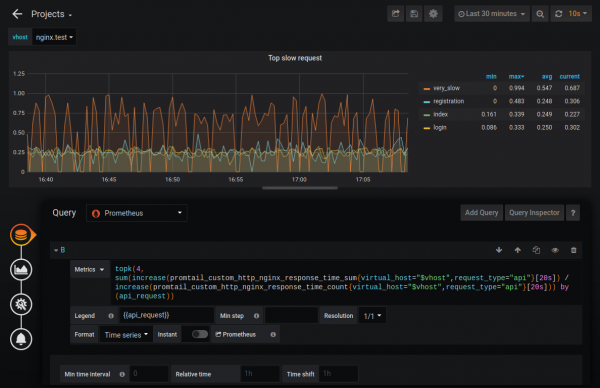
Slik kan man for eksempel finne de fire tregeste forespørslene. Også for disse metrikene kan man sette opp overvåking.
Skalering
Loki kan være i både enkeltmodus (single binary mode) og i sharding-modus (horizontally-scalable mode). I det andre tilfellet kan den lagre data i skyen, og chunkene og indeksen lagres separat. I versjon 1.5 ble det implementert muligheten for lagring på ett sted, men den anbefales ikke brukt i produksjon ennå.
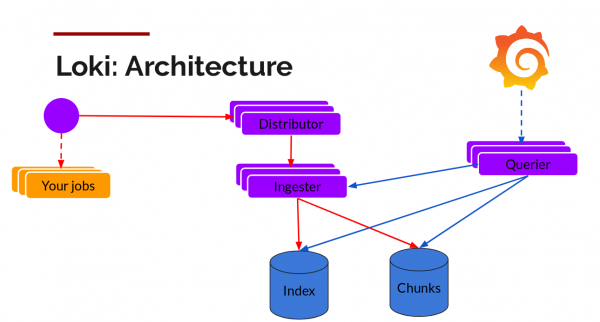
Chunkene kan lagres i S3-kompatibel lagring, og for lagring av indekser kan man bruke horisontalt skalerbare databaser: Cassandra, BigTable eller DynamoDB. Andre deler av Loki – Distributors (for skriving) og Querier (for forespørsel) – er stateless og kan også skaleres horisontalt.
På DevOpsDays Vancouver 2019 sa en av deltakerne, Callum Styan, at med Loki har prosjektet hans petabyte av logger med en indeks på mindre enn 1% av totalstørrelsen: “”.
Sammenligning av Loki og ELK
Indeksstørrelse
For testing av den resulterende indeksstørrelsen tok jeg logger fra nginx-containeren, for hvilken Pipeline ble konfigurert som nevnt over. Filen med logger inneholdt 406 624 linjer med en total størrelse på 109 MB. Loggene ble generert over en time, omtrent 100 oppføringer i sekundet.
Eksempel på to linjer fra loggen:
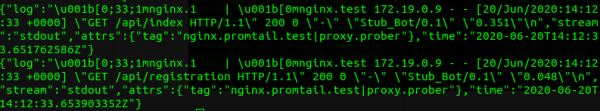
Ved indeksering i ELK ga dette en indeksstørrelse på 30,3 MB:
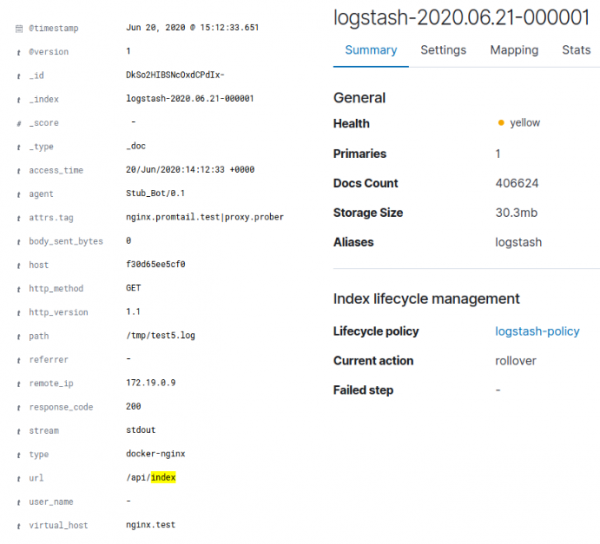
I tilfelle av Loki ga dette omtrent 128 KB med indekser og omtrent 3,8 MB med data i blokker. Det er verdt å merke seg at loggen ble kunstig generert og ikke skilte seg ut med stor variasjon av data. Enkel gzip på den opprinnelige Docker JSON-loggen med data ga en komprimering på 95,4 %, og med tanke på at det kun ble sendt renset nginx-logg til Loki, er komprimeringen ned til 4 MB forståelig. Det totale antallet unike verdier for etikettene i Loki var 35, noe som forklarer den lille størrelsen på indeksen. For ELK ble loggen også renset. Dermed komprimerte Loki de opprinnelige dataene med 96 %, mens ELK gjorde det med 70 %.
Minneforbruk
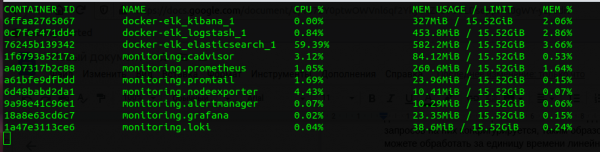
Sammenlignet med hele Prometheus-stakken og ELK, så "spiser" Loki flere ganger mindre. Det er klart at en tjeneste skrevet i Go bruker mindre enn en tjeneste skrevet i Java, og sammenligningen mellom JVM Heap-størrelsen til Elasticsearch og den tildelte minnen for Loki er feilaktig, men det er likevel verdt å merke seg at Loki bruker betydelig mindre minne. Dets fordel når det gjelder prosessorkraft er ikke så åpenbar, men finnes fortsatt.
Hastighet
Loki "fortærer" logger raskere. Hastigheten avhenger av mange faktorer - hva slags logger det er, hvor intrikate vi parser dem, nettverket, disken, osv. - men den er definitivt høyere enn for ELK (i min test omtrent det dobbelte). Dette forklares med at Loki legger mye mindre data i indeksen, og dermed bruker mindre tid på indeksering. Når det gjelder søkehastighet er situasjonen motsatt: Loki sakker betydelig bak på data som overstiger noen gigabyte, mens hastigheten for ELK ikke avhenger av datastørrelsen.
Jeg mener, at det er en fornøjelse at arbejde med logs i R80. Vi har en meget smart søgestreng, der giver os mulighed for at "skære" både på vilkårlig tekst, blade og andre indeksérbare parametre som kilde, destination, handling osv.
Loki er betydelig bak ELK når det gjelder muligheter for å søke i logger. Grep med regulære uttrykk er kraftig, men det kan ikke måle seg med en mer sofistikert database. Mangelen på range-spørsmål, aggregasjon kun etter etiketter, samt umuligheten av å søke uten etiketter - alt dette begrenser oss i søket etter informasjon av interesse i Loki. Dette betyr ikke at man ikke kan finne noe med Loki, men det definerer arbeidsflyten for logger, hvor man først finner problemer på Grafana-diagrammer, og deretter søker etter hva som skjedde i loggene basert på disse etikettene.
Grensesnittet
For det første ser det bra ut (beklager, jeg kunne ikke la være). Grafana har et vakkert grensesnitt, men Kibana er langt mer funksjonell.
Fordeler og ulemper med Loki
Blant fordelene er at Loki integreres med Prometheus, dermed får vi metrikker og varsling ut av boksen. Det er praktisk for innsamling og lagring av logger fra Kubernetes Pods, da det arver service discovery fra Prometheus og automatisk legger på etiketter.
Ulempene er svak dokumentasjon. Noen ting, som spesifikasjoner og funksjoner i Promtail, oppdaget jeg bare under arbeid med koden, godt at det er open-source. En annen ulempe er dårlige parsing-muligheter. For eksempel kan ikke Loki parse multiline-logger. En annen svakhet er at Loki er en relativt ung teknologi (release 1.0 kom i november 2019).
Konklusjon
Loki er en 100% interessant teknologi som er egnet for små og mellomstore prosjekter, og lar deg løse mange oppgaver knyttet til loggaggregasjon, loggsøk, overvåkning og logganalyse.
Vi bruker ikke Loki i Badoo, siden vi har en ELK-stack som fungerer for oss og som over mange år har fått en rekke tilpassede løsninger. For oss er problemet loggsøk. Med nesten 100 GB logger per dag, er det viktig for oss å kunne finne alt og litt mer, og gjøre det raskt. For å lage grafer og overvåking bruker vi andre løsninger som er tilpasset våre behov og integrert med hverandre. Loki-stack har merkbare fordeler, men den vil ikke gi oss mer enn det vi har, og fordelene vil helt sikkert ikke oppveie kostnadene ved migrasjonen.
Og selv om det etter undersøkelsen ble klart at vi ikke kan bruke Loki, håper vi at dette innlegget vil hjelpe deg i valget.
Repository med koden som ble brukt i artikkelen, finnes .
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish