

I løpet av Pinterest sin eksistens har 300 millioner brukere av tjenesten laget mer enn 200 milliarder pins på over 4 milliarder tavler. For å betjene denne horde av brukere og den omfattende innholdsbasen, har portalen utviklet tusenvis av tjenester, fra mikrotjenester som kan håndteres av flere CPU-er, til gigantiske monolitter som kjører på en hel flåte av virtuelle maskiner. Og nå har øynene til selskapet blitt rettet mot k8s. Hva er det som fanger Pinterest sin interesse for «kubene»? Dette vil du finne ut i vår oversettelse av en fersk artikkel fra .
Så, hundrevis av millioner brukere og hundrevis av milliarder pins. For å betjene denne horde av brukere og den omfattende innholdsbasen, har vi utviklet tusenvis av tjenester, fra mikrotjenester som kan håndteres av flere CPU-er, til gigantiske monolitter som kjører på en hel flåte av virtuelle maskiner. I tillegg har vi diverse rammeverk som også kan kreve CPU-ressurser, minne eller tilgang til I/O-operasjoner.
I støtte av denne dyrehagen av verktøy står utviklingsteamet overfor en rekke utfordringer:
- Ingeniørene har ikke en enhetlig måte å starte arbeidsmiljøet på. Stateless-tjenester, Stateful-tjenester og prosjekter under aktiv utvikling er basert på helt forskjellige teknologiske stakker. Dette har ført til opprettelsen av et helt opplæringskurs for ingeniører, og gjør også arbeidet vårt infrastrukturteam betydelig mer komplisert.
- Utviklere som har sin egen flåte av virtuelle maskiner, skaper enorm belastning for interne administratorer. Resultatet er at selv enkle operasjoner, som oppdatering av OS eller AMI, strekker seg over uker og måneder. Dette fører til økt belastning i situasjoner som tilsynelatende virker hverdagslige.
- Utfordringer med å lage globale verktøy for infrastrukturadministrasjon over allerede eksisterende løsninger. Situasjonen forverres også av at det ikke er lett å finne eiere av de virtuelle maskinene. Det vil si at vi ikke vet om vi trygt kan trekke disse kreftene for å bruke dem på andre områder i vår infrastruktur.
Containerty system for orchestration er en metode for å forene styring av arbeidsbelastning. De gir deg muligheten til å øke utviklingshastigheten og forenkle administrasjonen av infrastrukturen, ettersom alle ressurser involvert i prosjektet styres av et sentralisert system.
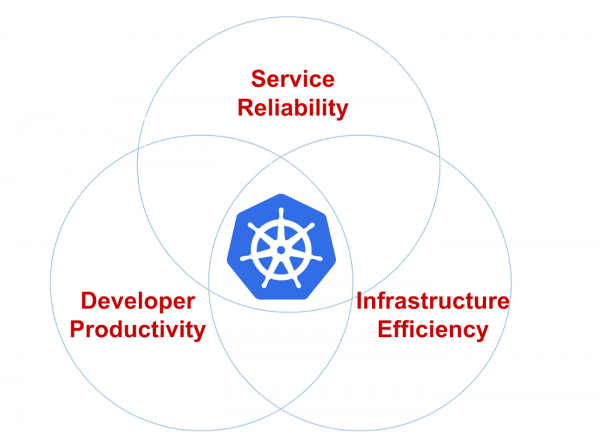
Figur 1: Infrastrukturprioriteringer (pålitelighet, utviklerens ytelse og effektivitet).
Cloud Management Platform-teamet hos Pinterest ble kjent med K8s i 2017. I første halvdel av 2017 dokumenterte vi mye av vår produksjonskapasitet, inkludert API-er og alle våre webservere. Deretter gjennomførte vi en grundig evaluering av ulike systemer for orkestrering av containerløsninger, oppbygging av klynger og drift med dem. Ved slutten av 2017 besluttet vi å ta i bruk Kubernetes. Det var fleksibelt nok og fikk bred støtte i utviklermiljøet.
Per nå har vi utviklet egne primærstartverktøy for klyngen basert på Kops og migrert eksisterende infrastrukturkomponenter til Kubernetes — som nettverk, sikkerhet, metrikker, logging, identitetsadministrasjon og trafikk. Vi har også implementert et system for modellering av arbeidsbelastninger for vår ressurs, der kompleksiteten er skjult for utviklerne. Nå er vi fokusert på å sikre stabiliteten til klyngen, dens skalering og tilknytning av nye kunder.
Kubernetes: veien til Pinterest
Å komme i gang med Kubernetes i stor skala hos Pinterest som en plattform som våre ingeniører vil elske, førte til mange utfordringer.
Som et stort selskap har vi investert betydelige midler i infrastrukturverktøy. Eksempler inkluderer sikkerhetsverktøy som håndterer sertifikater og fordeler nøkler, trafikkontrollkomponenter, tjenesteoppdagelsessystemer, synlighetskomponenter og utsendelse av logger og metrikker. Alt dette ble samlet på en logisk måte: vi har gått gjennom en normal prosess med prøving og feiling, og derfor ønsket vi å integrere alt dette i den nye infrastrukturen basert på Kubernetes, i stedet for å finne opp det gamle hjulet på en ny plattform. Denne tilnærmingen har generelt forenklet migrasjonen, ettersom all støtte for applikasjoner allerede eksisterer og ikke må bygges fra bunnen av.
På den annen side er det ikke tilstrekkelig med modeller for lastprognoser i Kubernetes selv (for eksempel distribusjoner, oppgaver og Daemon-sett) for prosjektet vårt. Disse brukervennlighetsproblemene utgjør enorme hindringer for overgangen til Kubernetes. For eksempel har vi hørt utviklere av tjenester klage over mangel på eller feilkonfigurert innlogging. Vi har også opplevd feil bruk av malmotorer, der hundrevis av kopier med identisk spesifikasjon og oppgave ble opprettet, noe som førte til marerittproblemer med feilsøking.
Det har også vært svært vanskelig å støtte ulike versjoner i samme klynge. Tenk deg kompleksiteten i kundestøtte når du må jobbe med flere versjoner av samme kjøringsmiljø, med alle deres problemer, feil og oppdateringer.
Brukerressurser og kontrollerere for Pinterest
For å lette prosessen med å implementere Kubernetes for ingeniørene våre, samt for å forenkle infrastrukturen og akselerere dens drift, har vi utviklet våre egne definisjoner av brukerressurser (CRD).
CRD gir følgende funksjonalitet:
- Sammenfletting av diverse native Kubernetes-ressurser slik at de fungerer som en enhetlig last. For eksempel inkluderer ressursen PinterestService distribusjon, inngangstjeneste og konfigurasjonskart. Dette gjør det mulig for utviklere å ikke bekymre seg for DNS-innstillinger.
- Implementering av nødvendig applikasjonsstøtte. Brukeren må kun fokusere på spesifikasjonen til containeren i henhold til sin forretningslogikk, mens CRD-kontrollereren implementerer alle nødvendige init-containere, miljøvariabler og pod-spesifikasjoner. Dette gir en prinsipielt annen komfortnivå for utviklerne.
- CRD-kontrollerere håndterer også livssyklusen til egne ressurser og øker tilgjengeligheten av feilsøking. Dette inkluderer å matche ønskede og reelle spesifikasjoner, oppdatere CRD-status og føre loggføring av hendelser og mer. Uten CRD ville utviklere vært nødt til å håndtere et stort antall ressurser, noe som bare ville økt sjansen for feil.
Her er et eksempel på PinterestService og en intern ressurs som administreres av kontrollereren vår:
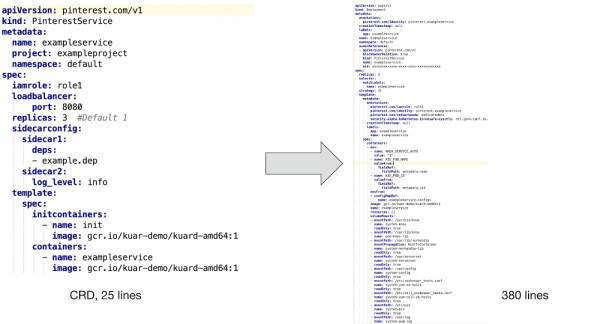
Som viste ovenfor, for å støtte den brukerdefinerte containeren er vi nødt til å integrere den med en initialiseringscontainer og flere tillegg for å sikre sikkerhet, synlighet og håndtering av nettverkstrafikk. I tillegg har vi laget konfigurasjonskartmaler og implementert støtte for PVC-maler for batchjobber, samt sporing av mange miljøvariabler for å spore identifikasjon, ressursforbruk og samle «søppel».
Det er vanskelig å forestille seg at utviklere vil skrive disse konfigurasjonsfilene manuelt uten støtte fra CRD, for ikke å nevne videre vedlikehold og feilsøking av konfigurasjoner.
Arbeidsflyt for distribusjon av applikasjoner
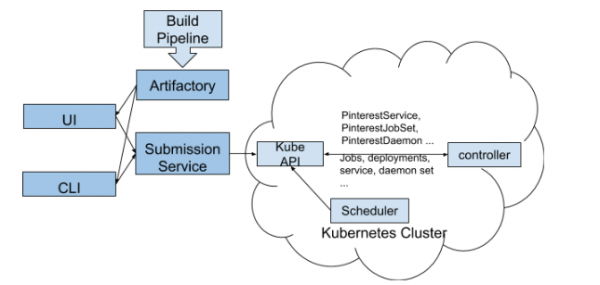
Figuren ovenfor viser hvordan man distribuerer en brukerdefinert Pinterest-ressurs i et Kubernetes-kluster:
- Utviklere samhandler med vårt Kubernetes-kluster via CLI og brukergrensesnittet.
- CLI- og UI-verktøy henter YAML-konfigurasjonsfiler for arbeidsflyten og andre produksjonsegenskaper (samme versjonsidentifikator) fra Artifactory, før de sender dem til Job Submission Service. Dette trinnet sikrer at bare arbeidsversjoner blir levert til klusteren.
- JSS fungerer som en bro for forskjellige plattformer, inkludert Kubernetes. Her skjer brukerautentisering, kvoteutdeling og delvis validering av konfigurasjonen til vår CRD.
- Etter at CRD er validert av JSS, sendes informasjonen til API-en til k8s-plattformen.
- Vår CRD-kontroller overvåker hendelser på alle brukerdefinerte ressurser. Den omformer CR til native k8s-ressurser, legger til nødvendige moduler, setter passende miljøvariabler og utfører andre støtteoppgaver, som sikrer at brukerdefinerte applikasjoner får tilstrekkelig infrastrukturell støtte.
- Deretter overfører CRD-kontrolleren de mottatte dataene til Kubernetes API, slik at de kan bli behandlet av planleggeren og iverksatt.
Merk: dette pre-release arbeidsflyt for distribusjon ble opprettet for de tidlige brukerne av den nye k8s-plattformen. Vi er nå i prosessen med å forbedre denne prosessen for fullt å integrere med vår nye CI/CD. Dette betyr at vi ikke kan dele alt som har med Kubernetes å gjøre. Vi ser frem til å kunne dele vår erfaring og fortelle om teamets fremgang på dette området i vår neste blogginnlegg «Bygge en CI/CD-plattform for Pinterest».
Typer spesielle ressurser
Basert på de spesifikke behovene til Pinterest har vi utviklet følgende CRD-er som passer for ulike arbeidsprosesser:
- PinterestService er allerede veldrevne stateless-tjenester. Mange av våre kjerne systemer er basert på en samling av slike tjenester.
- PinterestJobSet modellerer batchjobber med full syklus. I Pinterest finnes det et vanlig scenario der flere jobber kjører de samme containerne parallelt, uavhengig av andre lignende prosesser.
- PinterestCronJob brukes i stor grad sammen med små periodiske belastninger. Dette er et skall for nativen cron-funksjonalitet med støtte mekanismer for Pinterest, som håndterer sikkerhet, trafikk, logger og målinger.
- PinterestDaemon inkluderer infrastruktur-Daemon-er. Denne familien fortsetter å vokse ettersom vi legger til mer støtte for våre klynger.
- PinterestTrainingJob dekker prosesser i Tensorflow og Pytorch og gir samme støtte under kjøring som alle andre CRD-er. Siden Pinterest aktivt bruker Tensorflow og andre maskinlæringssystemer, var det fornuftig å bygge en egen CRD rundt dem.
Vi jobber også med PinterestStatefulSet, som snart vil bli tilpasset for datalagring og andre stateful-systemer.
Støtte for kjøre miljø
Når applikasjonsmodulen startes i Kubernetes, får den automatisk et sertifikat for å identifisere seg selv. Dette sertifikatet brukes for tilgang til hemmelighetshyllen eller for kommunikasjon med andre tjenester via mTLS. I mellomtiden vil containerinitiereren og Daemon laste ned alle nødvendige avhengigheter før containerapplikasjonen startes. Når alt er klart, vil sidecar for trafikk og Daemon registrere modulen sin IP-adresse i vår Zookeeper, slik at klienter kan oppdage den. Alt dette vil fungere, ettersom nettverksmodulen ble konfigurert før applikasjonen ble startet.
Ovenfor er typiske eksempler på støtte for arbeidsmengder under kjøring. For andre typer arbeidsmengder kan det kreves noe annen støtte, men alle presenteres som sidecars på pod-nivå, nodenivå eller Daemon-er på virtuell maskinnivå. Vi sørger for at alt blir implementert innenfor styringsinfrastrukturen og er koordinert mellom applikasjonene, noe som betydelig reduserer arbeidsbelastningen når det gjelder teknisk arbeid og kundestøtte.
Testing og QA
Vi har samlet et end-to-end testpipeline over den eksisterende testinfrastrukturen i Kubernetes. Disse testene gjelder for alle våre klynger. Vår pipeline har gjennomgått mange omarbeidelser før den ble en del av produktklyngen.
I tillegg til testsystemene våre har vi overvåkings- og varselsystemer som kontinuerlig overvåker tilstanden til systemkomponentene, ressursforbruket og andre viktige indikatorer, og varsler oss kun når menneskelig inngripen er nødvendig.
Alternativer
Vi har vurdert noen alternativer til tilpassede ressurser, som mutasjonskontrollere og malssystemer. Imidlertid er alle de medfølgende alvorlige vanskeligheter i drift, så vi valgte veien med CRD.
Mutasjonskontrolleren ble brukt for å introdusere sidecars, miljøvariabler og annen støtte under kjøring. Den møtte imidlertid ulike problemer, som ressursbinding og livssyklusstyring, mens det ikke oppstår slike problemer i CRD.
Merk: Mal jaket system, som Helm-diagram, blir også mye brukt for å kjøre applikasjoner med lignende konfigurasjoner. Imidlertid er våre arbeidsapplikasjoner for varierte til å kunne administreres med maler. I tillegg vil det oppstå for mange feil under kontinuerlig distribusjon når man bruker maler.
Kommende arbeid
Nå håndterer vi en blandet belastning på alle klusterne våre. For å støtte slike prosesser av forskjellig type og størrelse, arbeider vi med følgende retninger:
- Klyngen fordeler store applikasjoner på forskjellige kluster for å sikre skalerbarhet og stabilitet.
- Å sikre stabilitet, skalerbarhet og synlighet for klusteret for å skape forbindelsen mellom applikasjonen og dens SLA.
- Administrasjon av ressurser og kvoter, slik at applikasjoner ikke står i konflikt med hverandre, og at skalaen på klusteret kan kontrolleres fra vår side.
- Ny CI/CD-plattform for å støtte og distribuere applikasjoner i Kubernetes.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish