

God dag alle sammen!
Jeg heter Nikita, jeg er teamleder for ingeniørteamet i Cian. En av mine oppgaver i selskapet er å redusere antall hendelser relatert til infrastrukturen i produksjon til null.
Det som vil bli diskutert videre, har gitt oss mye smerte, og målet med denne artikkelen er å hindre andre fra å gjenta våre feil, eller i det minste minimere deres innvirkning.
Forord
For lenge siden, når Cian bestod av monolitter, og det ikke var noen tegn på mikrotjenester, målte vi tilgjengeligheten av ressursen ved å sjekke 3–5 sider.
Svarte – alt er bra, svarer ikke etter lang tid – alert. Hvor lenge de må være nede for at det skal betraktes som en hendelse, ble avgjort av folk på møter. Ingeniørteamet var alltid involvert i etterforskningen av hendelsen. Når etterforskningen var fullført, skrev vi et postmortem – en slags rapport sendt på e-post i formatet: hva som skjedde, hvor lenge det varte, hva vi gjorde i øyeblikket, hva vi vil gjøre i fremtiden.
De viktigste sidene på nettstedet eller hvordan vi forstår at vi har truffet bunnen
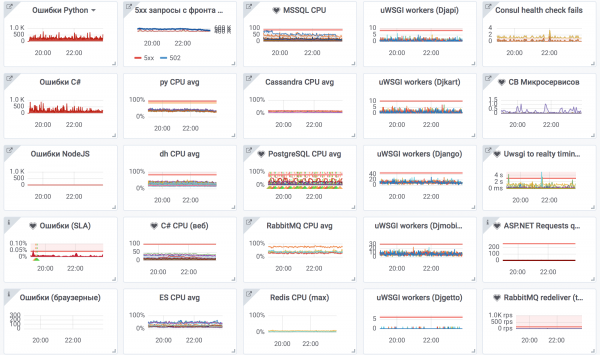
For å kunne forstå prioriteten til feilen, identifiserte vi de mest kritiske sidene for forretningsfunksjonaliteten på nettstedet. For disse sidene teller vi antall vellykkede/ mislykkede forespørsel og tidsavbrudd. På denne måten måler vi oppetid.
La oss si at vi har funnet ut at det er flere superviktige seksjoner på nettstedet som er ansvarlige for hovedtjenesten – søk og innlevering av annonser. Hvis antall forespørsel som resulterte i feil overskrider 1% – er det en kritisk hendelse. Hvis prosentandelen av feil overskrider 0,1% i løpet av 15 minutter i rushtiden – betraktes dette også som en kritisk hendelse. Disse kriteriene dekker de fleste hendelser, mens andre går utenfor rammen av denne artikkelen.
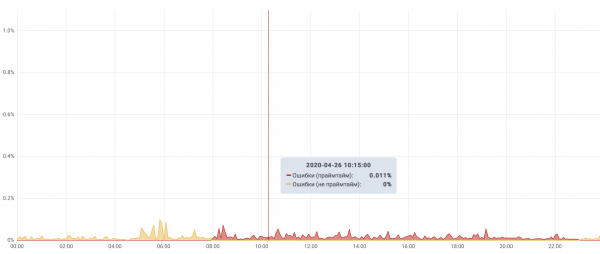
Top beste hendelsene til Cian
Så vi har absolutt lært å identifisere at en hendelse har skjedd.
Nå er hver hendelse detaljert beskrevet og reflektert i en episk Jira. For ordens skyld: for dette opprettet vi et eget prosjekt, kalt FAIL – her kan det kun opprettes episoder.
Hvis vi samler alle feilene fra de siste årene, er de ledende:
- hendelser relatert til mssql;
- hendelser forårsaket av eksterne faktorer;
- administrasjonsfeil.
La oss gå mer detaljert inn på administrasjonsfeilene, samt noen andre interessante feil.
Femte plassen – «Vi rydder opp i DNS»
Det var en grå tirsdag. Vi bestemte oss for å rydde opp i DNS-klyngen.
Vi ønsket å migrere interne DNS-servere fra BIND til PowerDNS, og dedikere helt separate servere til dette, hvor det bare kjører DNS.
Vi plasserte én DNS-server i hver lokasjon av våre datasentre, og tiden for å flytte sonene fra BIND til PowerDNS og bytte infrastrukturen til de nye serverne kom.
I det mest hektiske øyeblikket under overføringen av alle servere, som ble oppgitt i de lokale cacherende BIND-serverne på alle serverne, gjensto bare én, som befant seg i datasenteret i St. Petersburg. Dette datasenteret var opprinnelig deklarert som ikke-kritisk for oss, men ble plutselig en single point of failure.
Akkurat i løpet av denne overføringsperioden falt kanalen mellom Moskva og St. Petersburg. Vi sto faktisk uten DNS i fem minutter og kom opp igjen da hoster feilen var utbedret.
Konklusjoner:
Tidligere overså vi eksterne faktorer under forberedelsene til arbeidet, men nå inkluderer vi også dem i listen over hva vi må forberede oss på. Nå streber vi etter at alle komponenter er reservert i n-2, og i løpet av arbeidene kan vi senke dette nivået til n-1.
- Når du lager handlingsplanen, noter punktene hvor tjenesten kan falle, og tenk på scenarier der alt går «så dårlig som mulig» på forhånd.
- Fordel interne DNS-servere på forskjellige geolokasjoner/datasentre/stativer/brytere/inntak.
- Sett opp en lokal cacherende DNS-server på hver server, som videresender forespørslene til de primære DNS-serverne, og i tilfelle den ikke er tilgjengelig, vil svare fra cachen.
Fjerde plassen – «Vi rydder opp i Nginx»
En vakker dag bestemte teamet vårt at «nå er det nok», og prosessen med refaktorering av Nginx-konfigurasjonene ble igangsatt. Hovedmålet var å gjøre konfigurasjonene intuitivt forståelige. Tidligere var alt «historisk oppbygd» og inneholdt ikke noe logikk. Nå har vi flyttet hver server_name til en tilsvarende fil og fordelt alle konfigurasjoner i mapper. For å si det slik – konfigurasjonen inneholder 253949 linjer eller 7836520 tegn og tar nesten 7 megabyte. Øverste nivå av strukturen:
Nginx-struktur
├── tilgang
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Land.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Det ble betydelig bedre, men i prosessen med å omdøpe og fordele konfigurasjoner hadde noen av dem feil filendelse og havnet ikke i direktivet include *.conf. Som et resultat ble deler av vertene utilgjengelige og ga 301 til hovedsiden. På grunn av at svarkoden ikke var 5xx/4xx, ble dette ikke lagt merke til med en gang, men først tidlig om morgenen. Etter dette begynte vi å skrive tester for å sjekke infrastrukturkomponentene.
Konklusjoner:
- Strukturer konfigurasjonene riktig (ikke bare nginx) og tenk gjennom strukturen tidlig i prosjektet. Dette vil gjøre dem enklere å forstå for teamet, noe som igjen vil redusere TTM.
- Skriv tester for enkelte infrastrukturkomponenter. For eksempel: sjekk at alle nøkkelservere gir riktig status og kropp av svaret. Det er nok å ha noen skript tilgjengelig som tester hovedfunksjonene til komponenten, så du ikke må statte deg selv i panikk klokken tre om natten om hva mer som skal sjekkes.
Tredjeplassen - 'Plutselig var det ikke mer plass i Cassandra'
Dataene vokste jevnt, og alt var greit inntil det punktet hvor store cassandra-kapsekser begynte å feile ved vedlikehold fordi kompaktsjon ikke kan fungere.
På en dårlig dag ble klusteret nesten til en gresskar, som sagt:
- det var omtrent 20% ledig plass totalt i klusteret;
- det er ikke mulig å legge til noder ordentlig fordi det ikke gjennomføres rensing etter å ha lagt til en node på grunn av plassmangel på partisjoner;
- ytelsen synker litt, siden kompaktsjon ikke fungerer;
- klusteret fungerer i nødmodus.
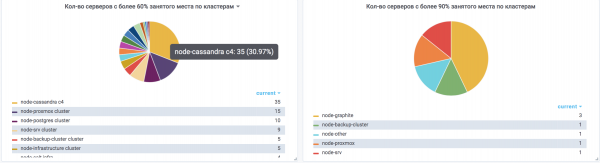
Ute — vi har lagt til fem flere noder uten rensing, hvoretter vi begynte å trekke dem systematisk ut av klyngen og deretter legge dem inn igjen som tomme noder som har fylt opp plassen. Tiden brukt har vært betydelig mer enn ønsket. Det var risiko for delvis eller full utilgjengelighet av klyngen.
Konklusjoner:
- På alle servere bør cassandra ha opptil 60 % av plassen brukt på hver partisjon.
- De bør være lastet opp til maksimalt 50 % av CPU.
- Ikke undervurder kapasitetsplanlegging, og det bør tenkes på for hver komponent med hensyn til dens spesifikasjoner.
- Jo flere noder i klyngen, desto bedre. Servere som inneholder en liten mengde data, blir raskere gjenopprettet, og en slik klynge er lettere å reaktivere.
Andreplass — «Dataene forsvant fra konsulens key-value-lagring»
For tjenestegjenkjenning bruker vi, som mange andre, konsul. Men vi bruker også dens key-value for blue-green distribusjon av monolittisk programvare. Der lagres informasjon om aktive og inaktive upstreams, som bytter plass under distribusjonen. For dette ble det skrevet en distribusjonstjeneste som interagerte med KV. På et tidspunkt forsvant dataene fra KV. Vi gjenopprettet dem fra hukommelsen, men med en rekke feil. Følgelig ble belastningen på upstreamene fordelt ujevnt under distribusjonen, og vi fikk mange 502-feil på grunn av overbelastning av backendene på CPU. Til slutt flyttet vi fra konsul KV til postgres, hvor det er mye vanskeligere å slette dem.
Konklusjoner:
- Tjenester uten noen form for autorisering bør ikke inneholde kritiske data for nettstedets drift. For eksempel, hvis du ikke har autorisasjon i ES — ville det vært bedre å blokkere tilgang på nettverksnivå fra alle steder der det ikke er nødvendig, og beholde bare de nødvendige, samt gjøre action.destructive_requires_name: true.
- Øv på mekanismen for sikkerhetskopiering og gjenoppretting på forhånd. For eksempel, lag en skript (for eksempel i python) som kan både sikkerhetskopiere og gjenopprette.
Førsteplass — «Kapitano utydelighet»
På et tidspunkt merket vi en ujevn belastning på nginx upstreams når backend hadde 10+ servere. Siden round-robin dirigerte forespørslene fra 1 til siste upstream i rekkefølge, og hver reload av nginx startet på nytt, fikk de første upstreamene alltid flere forespørsel enn de andre. Som et resultat jobbet de tregere, og hele nettsiden led. Dette ble mer og mer merkbart etter hvert som trafikken økte. Det var ikke nok å bare oppdatere nginx for å aktivere random; vi måtte omskrive mye lua-kode som ikke fungerte på versjon 1.15 (på den tiden). Vi måtte patch nginx 1.14.2 for å legge til støtte for random. Dette løste problemet. Denne feilen vinner prisen for «kaptein åpenbarhet».
Konklusjoner:
Det var veldig interessant og engasjerende å undersøke denne feilen).
- Sett opp overvåkning slik at den kan hjelpe deg med å raskt finne slike fluktuasjoner. For eksempel kan man bruke ELK for å overvåke rps på hver backend av hver upstream, og følge med på svartidene gjennom nginx. I dette tilfellet hjalp det oss å avdekke problemet.
Mye av feilen kunne vært unngått med en mer grundig tilnærming til det man gjør. Man må alltid huske på Murphy’s lov: Anything that can go wrong will go wrong, og bygge komponenter med dette i tankene.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish