

Sannsynligvis er det ingen som lenger stiller spørsmål ved hvorfor det er nødvendig å samle målinger av tjenester. Neste logiske steg er å sette opp varsling for de innsamlede målingene, som vil varsle om eventuelle avvik i dataene til de kanalene du foretrekker (e-post, Slack, Telegram). I tjenesten for online hotellreservasjoner renner alle målinger av våre tjenester inn i InfluxDB og vises i Grafana, hvor det også er satt opp grunnleggende varsling. For oppgaver hvor "man må beregne noe og sammenligne med dette" bruker vi Kapacitor.
Kapacitor er en del av TICK-stakken, som kan behandle målinger fra InfluxDB. Den kan koble sammen flere målinger (join), beregne noe nytt fra de oppnådde dataene, skrive resultatet tilbake til InfluxDB, og sende varsler i Slack/Telegram/e-post.
Hele stakken har en kul og detaljer , men det vil alltid være nyttige ting som ikke nødvendigvis er angitt eksplisitt i manualene. I denne artikkelen har jeg bestemt meg for å samle en rekke slike nyttige, men kanskje ikke åpenbare råd (den grunnleggende syntaksen til TICKscipt er beskrevet ) og vise hvordan de kan brukes, med et eksempel på en av våre små oppgaver.
La oss gå!
float & int, beregningsfeil
Det er et helt standard problem som løses ved å bruke typekonvertering:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
Bruk av default()
Hvis tag/område ikke er fylt ut, oppstår det beregningsfeil:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill i join (inner vs outer)
Som standard vil join kaste bort punkter der det ikke er data (inner).
Ved å bruke fill('null') vil det bli utført en outer join, etterfulgt av default() for å fylle ut tomme verdier:
var data = res1
    |join(res2)
        .as('res1', 'res2)
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Det er imidlertid en nyanse her. Hvis en av seriene (res1 eller res2) er tom, vil også den endelige serien (data) være tom. Det er flere saker om dette på GitHub (, , ) – vi venter på feilrettinger og lider litt.
Bruk av betingelser i beregninger (if i lambda)
|eval(lambda: if("value" > 0, true, false)
De siste fem minuttene fra pipelinen for perioden
For eksempel, hvis du trenger å sammenligne verdiene for de siste fem minuttene med den forrige uken. Du kan ta to sett med data i separate batcher eller hente deler av dataene fra en større periode:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Et alternativ for de siste fem minuttene kan være å bruke BarrierNode-noden, som stopper dataene før angitt tid:
|barrier()
        .period(5m)
Eksempler på bruk av Go-maler i meldinger
Maler følger formatet fra pakken , her er noen vanlige oppgaver.
if-else
Vi organiserer, uten å trigge folk med unødvendig tekst:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Det er greit nå{{ else }}Sjef, alt er ødelagt{{end}}'
    )
To desimaler etter komma i meldingen
Vi forbedrer lesbarheten til meldingen:
|alert()
    ...
    .message(
        'nå verdien er {{ index .Fields "value" | printf "%0.2f" }}'
    )
Utdrag av variabler i meldingen
Vi viser mer informasjon i meldingen for å svare på spørsmålet «Hvorfor skriker den?»:
var warnAlert = 10
  |alert()
    ...
    .message(
       'Dagens verdi er under '+string(warnAlert)+'%'
    )
Unik identifikator for varsler
En nyttig ting når det er mer enn en gruppe i dataene, ellers vil det bare bli generert ett varsel:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Egendefinerte handlere
I den store listen over handlere finnes det en exec som lar deg kjøre ditt eget skript med sendte parametere (stdin) – bare kreativitet!
En av våre egendefinerte er et lite Python-skript for å sende varsler til Slack.
Først ville vi sende et bilde fra Grafana, beskyttet med autentisering, i meldingen. Deretter – skrive OK i tråden til det forrige varselet fra den samme gruppen, i stedet for som en egen melding. Litt senere – legge til i meldingen den vanligste feilen de siste X minuttene.
Et eget emne – kobling til andre tjenester og eventuelle handlinger initiert av varsler (bare hvis overvåkingen din fungerer bra).
Eksempel på beskrivelse av en handler, hvor slack_handler.py er vårt egenutviklede skript:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Hvordan feilsøke?
Alternativ med output til logg
|log()
      .level("error")
      .prefix("something")
Se (cli): kapacitor -url :9092 logs lvl=error
Alternativ med httpOut
Viser data i den nåværende pipelinen:
|httpOut('something')
Se (get): :9092\/kapacitor\/v1\/tasks\/task_name\/something
Kjøringsskjema
- Hver oppgave returnerer et kjøretrær med nyttige tall i formatet .
- Vi tar en blokk .
- Setter inn i viewer, .
Hvor annet kan man hente timestamp fra InfluxDB ved tilbakeføring
timestamp i influxdb ved tilbakeføring
For example, we set up an alert for the number of requests over an hour (groupBy(1h)) and want to record the triggered alert in influxdb (to visually show the existence of a problem on a graph in grafana).
influxDBOut() will record the time value from the alert, accordingly, the point on the graph will be recorded earlier/later than the alert was received.
When precision is required: we bypass this issue by calling a custom handler that will write data to influxdb with the current timestamp.
docker, build and deploy
Upon starting, kapacitor can load tasks, templates, and handlers from the directory specified in the config, in the [load] block.
To correctly create a task, the following things are needed:
- File name – expands to id/name of the script
- Type – stream/batch
- dbrp – a keyword to specify which database + policy the script operates in (dbrp "supplier"."autogen")
If any batch task lacks the dbrp line, the entire service will refuse to start and will write this honestly in the log.
In chronograf, on the contrary, this line should not be present; it is not accepted through the interface and will throw an error.
Build container hack: Dockerfile exits with -1 if there are lines with //.+dbrp, which will immediately let you understand the reason for the build failure.
join one to many
Example task: we need to take the 95th percentile of service response time over a week, comparing each minute from the last 10 with this value.
You cannot do a one-to-many join; last/mean/median over a group of points turns the node into a stream, returning the error "cannot add child mismatched edges: batch -> stream."
The result of the batch, as a variable in a lambda expression, is also not substituted.
There is a way to save the required numbers from the first batch to a file via udf and load this file through sideload.
What were we solving with this?
We have about 100 hotel suppliers, each of them may have several connections, which we will call a channel. There are about 300 of these channels, each of which may fail. Of all the recorded metrics, we will monitor the error rate (requests and errors).
Why not grafana?
Alerts for errors set up in grafana have several downsides. Some are critical, while others can be overlooked, depending on the situation.
Grafana does not handle calculations between measures + alerting, while we need the rate (requests-errors)/requests.
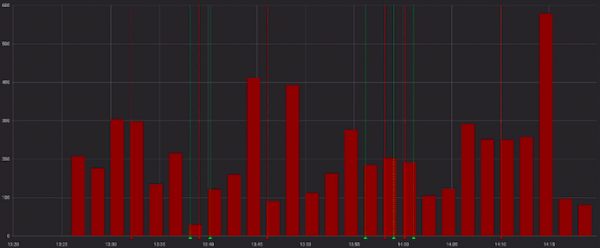
Errors look menacing:
And less menacing when viewed with successful requests:
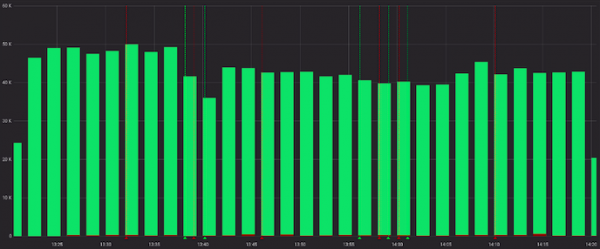
OK, vi kan forhåndsberegne raten i tjenesten før Grafana, og i noen tilfeller vil dette være tilstrekkelig. Men ikke i vårt tilfelle, fordi for hver kanal beregnes et «normalt» forhold, og alerter fungerer etter statiske verdier (vi ser med øynene, endrer hvis det alerter ofte).
Dette er eksempler på «normalt» for ulike kanaler:
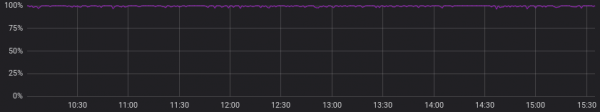
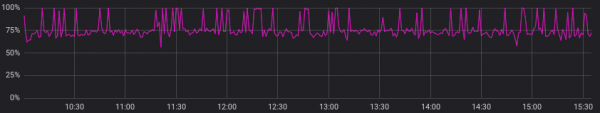
Vi ser bort fra forrige punkt og antar at alle leverandører har en «normal» situasjon som ligner. Nå er alt bra, og kan vi klare oss med alerter i Grafana?
Vi kan, men det frister veldig lite, fordi vi må velge en av alternativene:
a) lage mange grafer for hver kanal separat (og plage oss med å holde dem oppdatert)
b) beholde én graf med alle kanaler (og bli tapt i fargerike linjer og konfigurerte alerter)
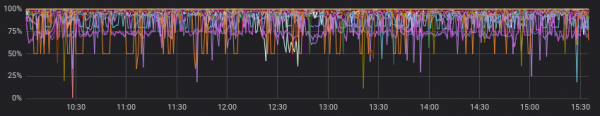
Hvordan løste vi dette?
Som før, finnes det et godt starteksempel i dokumentasjonen (), som man kan se på eller ta utgangspunkt i for lignende oppgaver.
Hva vi fikk til slutt:
- join av to serier over flere timer, gruppering etter kanaler;
- fyller serier etter grupper, hvis det ikke var noen data;
- sammenligner medianen de siste 10 minuttene med tidligere data;
- ropte ut hvis vi oppdaget noe;
- skrev ut de beregnede ratene og oppståtte alerter i InfluxDB;
- sendte en nyttig melding til Slack.
Etter min mening lyktes vi maks med alt vi ønsket å oppnå (og kanskje litt mer med tilpassede håndterere).
På github.com kan man se og til den resulterende skriptet.
Eksempel på den resulterende koden:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // заполняем значения нулями, если их не было
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // if в lambda: считаем рейт, только если ошибки были
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// записываем посчитанные значения в инфлюкс
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// выбираем данные за последние 10 минут, считаем медиану
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // собираем в message ссылку на график дашборда графаны
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req ratio ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}It is ok now{{ else }}
'+string(todayPeriod)+' median is {{ index .Fields "today.median" | printf "%0.2f" }}%, by previous '+string(period)+' is {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+'
?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" дублируем как "value", также пишем в инфлюкс остальные филды алерта (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Og hva er resultatet?
Kapacitor gjør en fantastisk jobb med å utføre overvåking og varsling med mange grupperinger, utføre tilleggskalkulasjoner på allerede lagrede målinger, utføre tilpassede handlinger og kjøre skript (udf).
Inngangsbarrieren er ikke så høy – prøv det hvis Grafana eller andre verktøy ikke fullt ut oppfyller dine ønsker.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish