

En liten innledning
Jeg mener at vi kunne ha gjort mye mer dersom vi fikk trinn-for-trinn-instruksjoner som forklarte hva vi skulle gjøre og hvordan. Jeg husker i mitt liv øyeblikk hvor jeg ikke kunne begynne på et prosjekt fordi det rett og slett var vanskelig å forstå hvor man skulle begynne. Kanskje for lenge siden så du ordet «Data Science» på internett og tenkte at dette var langt unna deg, og at folk i denne bransjen holdt til et helt annet sted. Men nei, de er rett her. Og kanskje takket være folk i dette feltet har en artikkel kommet i feeden din. Det finnes masser av kurs som kan hjelpe deg å mestre dette håndverket, her vil jeg hjelpe deg med å ta det første steget.
Så, er du klar? Jeg vil med en gang si at du må kunne Python 3, ettersom det er det jeg skal bruke her. Jeg anbefaler også at du installerer Jupyter Notebook på forhånd eller ser hvordan du bruker Google Colab.
Første steg
Kaggle er din betydelige hjelper i denne prosessen. Generelt kan du klare deg uten det, men dette vil jeg ta opp i en annen artikkel. Det er en plattform hvor konkurranser i Data Science avholdes. I hvert av disse konkurransene vil du i begynnelsen få en enorm mengde erfaring fra å løse ulike oppgaver, utvikle prosjekter, og jobbe i team, noe som er viktig i vår tid.
Vi tar oppgaven vår derfra. Den heter «Titanic». Oppgaven er som følger: forutsi om hver enkelt person overlever. Generelt sagt, oppgaven til en person som jobber med DS er å samle data, bearbeide dem, trene en modell, lage prognoser, og så videre. På Kaggle blir vi imidlertid spart for datainnsamlingsprosessen — de er allerede tilgjengelige på plattformen. Vi må laste dem opp, og så kan vi begynne arbeidet!
Dette kan gjøres på følgende måte:
Under fanen Data ligger filene som inneholder dataene.


Vi har lastet opp dataene, forberedt Jupyter-notatbøkene våre, og ...
Andre steg
Hvordan laster vi nå opp disse dataene?
For det første importerer vi de nødvendige bibliotekene:
import pandas as pd
import numpy as np
Pandas lar oss laste opp .csv-filer for videre behandling.
Numpy er nødvendig for å representere datatabellen vår som en matrise med tall.
La oss gå videre. Vi tar filen train.csv og laster den opp til oss:
dataset = pd.read_csv('train.csv')
Vi vil referere til vårt datasett fra train.csv gjennom variabelen dataset. La oss se hva som er der:
dataset.head()
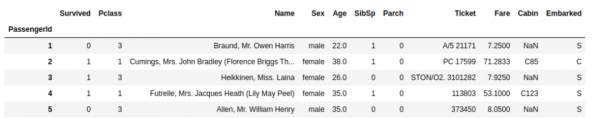
Funksjonen head() lar oss se de første radene av datasettet.
Kolonnen Survived er våre resultater som er kjent i dette datasettet. I denne oppgaven må vi forutsi kolonnen Survived for dataene i test.csv. I disse dataene finnes informasjon om andre passasjerer av Titanic, for hvem vi, som jobber med oppgaven, ikke kjenner utfallet.
Så, la oss dele opp tabellen vår i avhengige og uavhengige data. Her er det enkelt. Avhengige data er de som avhenger av uavhengige - det som er i utfallet. Uavhengige data er de som påvirker utfallet.
For eksempel har vi følgende datasett:
«Vova lærte informatikk - nei.
Vova fikk 2 i informatikk.»
Karakteren i informatikk avhenger av svaret på spørsmålet: lærte Vova informatikk? Forstått? La oss gå videre, vi er allerede nærmere målet!
Den tradisjonelle variabelen for uavhengige data er X. For avhengige er det y.
Vi gjør følgende:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Hva er dette? Ved å bruke iloc[:, 2: ] sier vi til Python: jeg vil se dataene som starter fra den andre kolonnen (inkludert, og med forutsetning om at tellingen begynner fra null). I den andre linjen sier vi at vi vil se dataene fra den første kolonnen i y.
[ a:b, c:d ] - dette er konstruksjonen vi bruker i parentesene. Hvis vi ikke angir noen variabler, vil de bli beholdt som standard. Det vil si at vi kan spesifisere [:,: d] og da vil vi få alle kolonnene i datasettet, unntatt de som begynner fra nummer d og videre. Variablene a og b definerer radene, men vi trenger alle, så vi lar dette være standard.
La oss se hva vi har fått ut:
X.head() 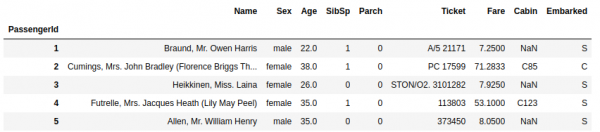
y.head() 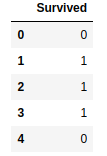
For å forenkle denne lille leksjonen, vil vi fjerne de kolonnene som krever spesielt «vedlikehold» eller som ikke påvirker overlevelsen i det hele tatt. De inneholder data av type str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Supert! La oss gå videre til neste steg.
Trinn tre
Her må vi koding av dataene våre, slik at maskinen bedre forstår hvordan disse dataene påvirker resultatet. Men vi vil ikke kode alt, bare data av typen str som vi har lått stå. Kolonnen «Sex». Hvordan ønsker vi å kode dette? La oss representere dataene om en persons kjønn som en vektor: 10 — mannlig, 01 — kvinnelig.
La oss først oversette tabellene våre til en NumPy-matrise:
X = np.array(X)
y = np.array(y)
Og nå ser vi:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Sklearn-biblioteket er et fantastisk bibliotek som lar oss utføre hele arbeidet innen Data Science. Det inneholder en stor mengde interessante modeller for maskinlæring, og gjør det også mulig å arbeide med dataklargjøring.
OneHotEncoder vil la oss kode en persons kjønn i det formatet vi har beskrevet. Det vil bli opprettet 2 klasser: mannlig, kvinnelig. Hvis personen er mann, blir 1 skrevet i kolonnen «mannlig», og 0 i «kvinnelig».
Etter OneHotEncoder() står [1] — dette betyr at vi ønsker å kode kolonne nummer 1 (teller fra null).
Supert! La oss gå videre!
Som regel skjer det at noen data forblir ufullstendige (det vil si NaN — ikke et tall). For eksempel har vi informasjon om en person: hans navn, kjønn. Men vi har ingen data om hans alder. I så fall bruker vi følgende metode: vi finner det aritmetiske gjennomsnittet av alle kolonner, og hvis det er noen tomme data i en kolonne, fyller vi inn med det aritmetiske gjennomsnittet.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Og nå må vi ta hensyn til at det kan oppstå situasjoner der dataene er veldig spredte. Noen data ligger i intervallet [0:1], mens andre kan være i hundrevis og tusenvis. For å eliminere slik spredning og for at datamaskinen skal være mer presis i beregningene, vil vi skalere dataene, det vil si normalisere dem. La oss si at alle tall ikke skal overstige tre. For dette bruker vi funksjonen StandardScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Nå ser dataene våre slik ut:

Flott! Vi er allerede nær målet vårt!
Trinn fire
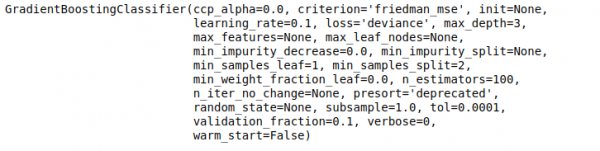
La oss trene vår første modell! Fra biblioteken sklearn kan vi finne et stort antall interessante ting. Jeg brukte Gradient Boosting Classifier-modellen for denne oppgaven. Vi bruker en klassifikator, siden oppgaven vår er en klassifiseringsoppgave. Vi må forutsi om resultatet er 1 (overlevd) eller 0 (ikke overlevd).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Fit-funksjonen sier til Python: La modellen finne sammenhenger mellom X og y.
På mindre enn ett sekund er modellen klar.
Hvordan bruke den? Det skal vi se nå!
Trinn fem. Konklusjon
Nå må vi laste opp tabellen med testdataene våre, for hvilke vi trenger å lage en prognose. Vi vil gjøre akkurat det samme med denne tabellen som vi gjorde med X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
La oss bruke modellen vår nå!
gbc_predict = gbc.predict(X_test)
Ferdig. Vi har laget en prognose. Nå må vi lagre den i CSV og sende den til nettstedet.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Ferdig. Vi har fått en fil som inneholder spådommer for hver passasjer. Det gjenstår bare å laste opp disse løsningene på nettstedet og få vurderingen av prognosen. Denne primitive løsningen gir ikke bare 74% nøyaktighet offentlig, men også et visst trykk i Data Science. De mest nysgjerrige kan når som helst sende meg en privat melding og stille spørsmål. Takk alle sammen!
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish