

Hei, Habr!
I lys av de nåværende hendelsene på grunn av coronaviruset har flere internetttjenester begynt å oppleve økt belastning. For eksempel, , fordi de ikke hadde nok kapasitet. Og det er langt fra alltid mulig å øke serverens ytelse bare ved å legge til kraftigere utstyr, men forespørslene fra kundene må håndteres (eller så går de til konkurrentene).
I denne artikkelen vil jeg kort fortelle om populære praksiser som kan gjøre tjenesten rask og robust. Men av de mulige utviklingsskjemaene har jeg bare valgt de som nå er lette å bruke.For hvert punkt har du enten eksisterende biblioteker eller muligheten til å løse oppgaven ved hjelp av en skyplattform.
Horiskontal skalering
Det enkleste og mest kjente punktet. Man kan grovt sett si at de to mest brukte lastbalanseringsskjemaene er horiskontal og vertikal skalering. lar du tjenestene jobbe samtidig, og dermed fordeler du belastningen mellom dem. bestiller du kraftigere servere eller optimaliserer koden.
Som eksempel tar jeg en abstrakt skyfilerlagring, det vil si en slags analog av OwnCloud, OneDrive osv.
Standardbildet av et slikt skjema er nedenfor, men det viser bare kompleksiteten i systemet. For vi må på en eller annen måte synkronisere tjenestene. Hva skjer hvis brukeren lagret en fil fra nettbrettet og deretter ønsker å se den fra telefonen?
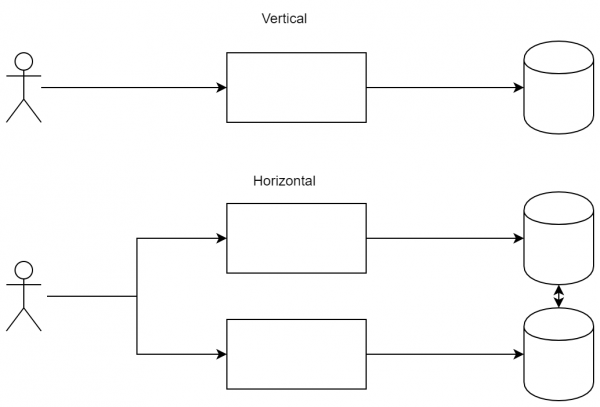
Forskjellen mellom tilnærmingene: i vertikal skalering er vi klare til å øke kraften i nodene, mens i horiskontal skalering legger vi til nye noder for å fordele belastningen.
CQRS
er et ganske viktig mønster, siden det lar forskjellige kunder ikke bare koble til forskjellige tjenester, men også motta lignende hendelsesstrømmer. Dets fordeler er ikke så åpenbare for en enkel applikasjon, men det er ekstremt viktig (og enkelt) for en tung belastes tjeneste. Dets essens: innkommende og utgående datastreamer skal ikke krysse hverandre. Det vil si at du ikke kan sende en forespørsel og forvente et svar, i stedet sender du en forespørsel til tjeneste A, men får svar i tjeneste B.
Den første fordelen med denne tilnærmingen er muligheten til å bryte forbindelsen (i vid forstand av ordet) under behandling av en lang forespørsel. La oss ta et mer eller mindre standard forløp som eksempel:
- Klienten sendte en forespørsel til serveren.
- Serveren startet en lang behandling.
- Serveren svarte klienten med resultatet.
La oss anta at det skjedde en avbrudd i forbindelsen i punkt 2 (enten nettverket koblet fra igjen, eller brukeren gikk til en annen side og brøt forbindelsen). I så fall vil det bli vanskelig for serveren å sende svaret til brukeren med informasjonen om hva som ble behandlet. Ved å bruke CQRS vil forløpet være litt annerledes:
- Klienten abonnerte på oppdateringer.
- Klienten sendte en forespørsel til serveren.
- Serveren svarte 'forespørsel mottatt'.
- Serveren svarte med resultatet gjennom kanalen fra punkt '1'.
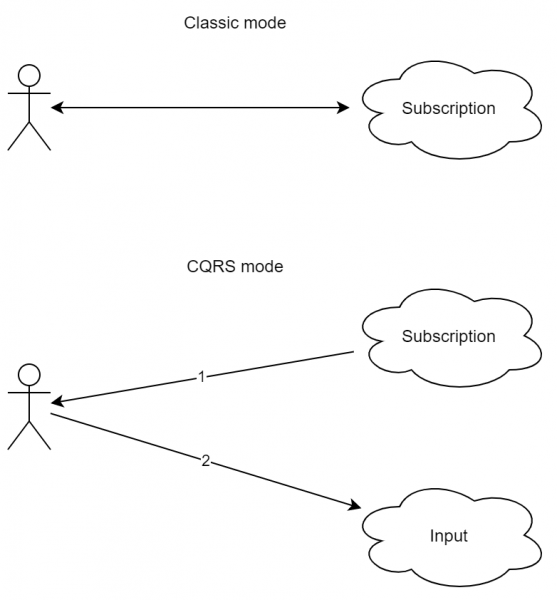
Som vi kan se, er oppsettet litt mer komplisert. Videre er den intuitive request-response-tilnærmingen fraværende her. Men som vi kan se, vil et avbrudd i forbindelsen under behandlingen av forespørselen ikke føre til en feil. Dessuten, hvis brukeren faktisk er koblet til tjenesten fra flere enheter (for eksempel fra mobiltelefon og nettbrett), kan vi sørge for at svaret kommer til begge enheter.
Det interessante er at koden for håndtering av innkommende meldinger blir lik (ikke 100%) for både hendelser påvirket av klienten selv og for andre hendelser, inkludert fra andre kunder.
Imidlertid får vi i praksis ytterligere fordeler ved at den énveis strømmen kan behandles på funksjonell måte (ved hjelp av RX og lignende). Og dette er allerede en stor fordel, for i prinsippet kan applikasjonen gjøres helt reaktiv, samtidig som man bruker en funksjonell tilnærming. For store programmer kan dette betydelig spare ressurser til utvikling og vedlikehold.
Hvis vi kombinerer denne tilnærmingen med horisontal skalering, får vi muligheten til å sende forespørslene til én server, men motta svar fra en annen. Dermed kan klienten selv velge den tjenesten som passer ham best, mens systemet internt fortsatt vil kunne håndtere hendelsene korrekt.
Event Sourcing
Som du vet, er en av hovedtrekkene ved et distribuert system fraværet av felles tid og felles kritisk seksjon. For én prosess kan du oppnå synkronisering (med de samme mutexene), hvor du er trygg på at ingen andre utfører denne koden. Men for et distribuert system er dette risikabelt, da det vil kreve overhead, og alt det fantastiske med skalering blir ødelagt – alle komponenter må vente på én.
Her får vi en viktig faktum – en rask distribuert system kan ikke synkroniseres, for da vil vi redusere ytelsen. På den annen side er det ofte nødvendig med en bestemt konsistens av komponentene. Og for dette kan vi bruke tilnærmingen med , hvor det garanteres at, dersom det ikke skjer noen datamessige endringer over en viss periode etter den siste oppdateringen («til slutt»), vil alle forespørslene returnere den siste oppdaterte verdien.
Det er viktig å forstå at for klassiske databaser, benyttes ofte , hvor hver node har identisk informasjon (dette oppnås ofte når en transaksjon anses å være etablert først etter svar fra den andre serveren). Her finnes det noen lettelser på grunn av isolasjonsnivåer, men den generelle essensen forblir den samme – du kan leve i en helt konsistent verden.
Men la oss gå tilbake til den opprinnelige oppgaven. Hvis en del av systemet kan bygges med , kan vi konstruere følgende skjema.
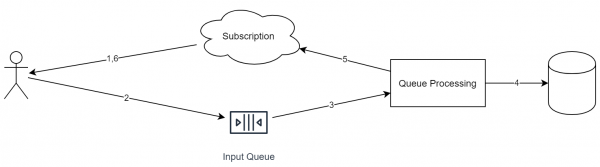
Viktige trekk ved denne tilnærmingen:
- Hver innkommende forespørsel plasseres i en enkelt kø.
- Under behandlingen av forespørselen kan tjenesten også plassere oppgaver i andre køer.
- Hver innkommende hendelse har en identifikator (som er nødvendig for deduplisering).
- Køen fungerer ideologisk etter "append only"-modellen. Elementer kan ikke fjernes eller flyttes rundt.
- Køen fungerer etter FIFO-prinsippet (unnskyld for tautologien). Hvis vi trenger parallell behandling, bør objektene overføres til forskjellige køer i ett av trinnene.
Husk at vi ser på tilfelle av en online filserver. I dette tilfelle vil systemet se omtrent slik ut:
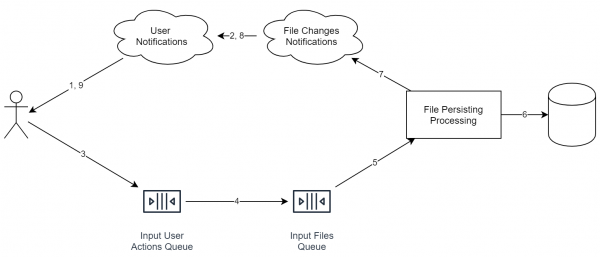
Det er viktig at tjenestene i diagrammet ikke nødvendigvis betyr en egen server. Selv prosessen kan være den samme. Det viktigste er imidlertid at disse tingene er ideologisk delt opp på en måte som gjør det enkelt å bruke horisontal skalering.
Og for to brukere vil skjemaet se slik ut (tjenester beregnet for forskjellige brukere er merket med forskjellige farger):
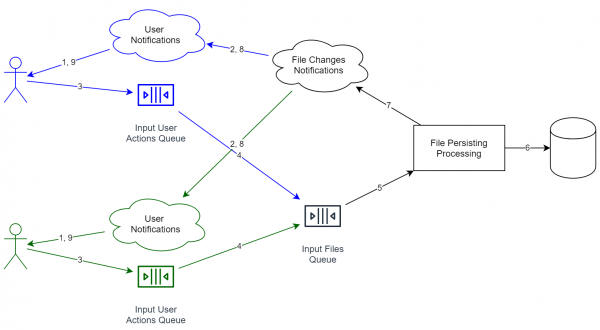
Fordeler med en slik kombinasjon:
- Informasjonsklargjøringstjenester er delt. Kjøene er også delt. Hvis vi trenger å øke systemets kapasitet, må vi bare kjøre flere tjenester på et større antall servere.
- Når vi mottar informasjon fra brukeren, er det ikke nødvendig å vente på at dataene er fullstendig lagret. Tvert imot, vi trenger bare å svare "ok", og deretter kan vi gradvis begynne arbeidet. I tillegg jevner køen ut topper, da tillegg av nye objekter skjer raskt, og brukeren trenger ikke å vente på en full gjennomgang av hele syklusen.
- Som et eksempel har jeg lagt til en deduplication-tjeneste, som prøver å slå sammen identiske filer. Hvis den jobber lenge i 1 % av tilfellene, vil kunden nesten ikke merke det (se over), noe som er en stor fordel, ettersom vi ikke lenger krever hundre prosent hastighet og pålitelighet.
Men ulempene er også umiddelbart åpenbare:
- Systemet vårt har mistet streng samsvar. Dette betyr at hvis man for eksempel abonnerer på forskjellige tjenester, kan man teoretisk få forskjellige tilstander (da en av tjenestene kan hende å ikke motta varslingen fra den interne køen i tide). Som et annet konsekvens, har systemet nå ikke noe felles tidspunkt. Det vil si at man for eksempel ikke kan sortere alle hendelser bare etter tidspunktet for ankomst, da klokken mellom serverne ikke nødvendigvis er synkronisert (mer enn det, lik tid på to servere er en utopi).
- Ingen hendelser kan nå enkelt rulles tilbake (som man ville kunne gjort med en database). I stedet må man legge til en ny hendelse — , som vil endre den siste tilstanden til den nødvendige. Som et eksempel fra et lignende felt: uten å overskrive historien (som er dårlig i en rekke tilfeller) i git kan man ikke rulle tilbake et commit, men man kan lage et spesial , som i hovedsak bare vil returnere den gamle tilstanden. Men både den feilaktige commit og rollback vil forbli i historien.
- Dataskjemaet kan endres fra utgivelse til utgivelse, men gamle hendelser kan nå ikke oppdateres til den nye standarden (siden hendelser generelt ikke kan endres).
Som vi ser, fungerer Event Sourcing utmerket med CQRS. Dessuten er det allerede vanskelig å implementere et system med effektive og brukervennlige køer uten å skille datastreamer, ettersom vi må legge til synkroniseringspunkter som vil nøytralisere hele den positive effekten av køene. Når begge tilnærmingene brukes samtidig, må koden for programmet justeres litt. I vårt tilfelle, når en fil sendes til serveren, kommer svaret tilbake som bare "ok", som bare betyr at "operasjonen med å legge til filen er lagret". Formelt betyr dette ikke at dataene allerede er tilgjengelige på andre enheter (for eksempel kan dedupliseringssystemet omstrukturere indeksen). Men etter en tid vil klienten motta et varsel i form av "fil X er lagret".
Som resultat:
- Antallet statuser for filsending øker: i stedet for den klassiske "fil sendt" får vi to: "fil lagt til i kø på serveren" og "fil lagret i lagring". Det siste betyr at andre enheter allerede kan begynne å motta filen (med forbehold om at køene jobber med ulik hastighet).
- På grunn av at informasjon om sending nå kommer over forskjellige kanaler, må vi finne løsninger for å motta status for filbehandling. Som følge av dette: i motsetning til klassisk request-response, kan klienten startes på nytt mens filen behandles, men statusen for denne behandlingen vil fortsatt være korrekt. Og dette punktet fungerer stort sett ut av boksen. Som konsekvens er vi nå mer tolerante overfor feil.
Sharding
Som allerede beskrevet tidligere, mangler systemer med event sourcing streng konsistens. Dette betyr at vi kan bruke flere lagringsløsninger uten noen synkronisering mellom dem. Nærmere vår oppgave kan vi:
- Dele filer etter typer. For eksempel kan bilder/videoer dekodes og velge en mer effektivt format.
- Skille kontoene etter land. På grunn av mange lover kan dette være nødvendig, men denne arkitekturmodellen gir den muligheten automatisk.
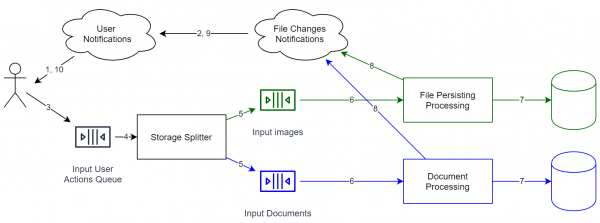
Hvis du vil flytte data fra ett lagringssted til et annet, kan standardmetoder ikke brukes. Dessverre må køen stoppes, migreringen gjøres, og deretter startes den igjen. Generelt kan data ikke flyttes «i sanntid», men dersom alle hendelseskøene lagres fullstendig, og du har kopier av tidligere tilstander av lagringsstedet, kan vi gjengi hendelsene på følgende måte:
- I Event Source har hver hendelse sin egen identifikator (ideelt sett — ikke avtagende). Det betyr at vi kan legge til et felt i lagringsstedet — id for det siste behandlede elementet.
- Vi dupliserer køen, slik at alle hendelsene kan behandles for flere uavhengige lagringssteder (den første er det som allerede har dataene, og den andre er ny, men ennå tom). Den andre køen behandles selvfølgelig ikke ennå.
- Vi starter den andre køen (altså begynner vi å gjengi hendelsene).
- Når den nye køen er relativt tom (det vil si at den gjennomsnittlige tiden mellom å legge til et element og å hente det igjen er akseptabel), kan vi begynne å bytte leserne til det nye lagringsstedet.
Som det fremgår, har vi i systemet vårt aldri hatt og har fortsatt ikke strenge konsistenser. Det finnes bare eventual consistency, som betyr at det er garantert at hendelsene behandles i samme rekkefølge (men kanskje med ulik forsinkelse). Ved å dra nytte av dette kan vi relativt enkelt flytte data uten å stoppe systemet til den andre siden av kloden.
Dermed, ved å fortsette med vårt eksempel om et online lagringssted for filer, gir denne arkitekturen oss allerede flere fordeler:
- Vi kan flytte objektene nærmere brukerne, på en dynamisk måte. Dette kan forbedre kvaliteten på tjenesten.
- Vi kan lagre deler av dataene internt i selskapene. For eksempel krever Enterprise-brukere ofte at deres data lagres i kontrollerte datasentre (for å unngå datalekkasjer). Gjennom sharding kan vi enkelt støtte dette. Og oppgaven blir enda enklere hvis kunden har en kompatibel sky (for eksempel, ).
- Det viktigaste är att vi kanske inte behöver göra det. Först och främst skulle vi vara nöjda med en enda lagring för alla konton (för att snabbare kunna börja arbeta). Nyckelfunktionen i detta system är att, även om det är skalbart, är det relativt enkelt i början. Man behöver bara inte skriva kod som fungerar med en mängd separata oberoende köer osv. Om det behövs kan det göras i framtiden.
Statisk Innehålls Hosting
Denna punkt kan verka helt uppenbar, men den är ändå nödvändig för en mer eller mindre standardbelastad applikation. Dess kärna är enkel: all statisk innehåll distribueras inte från samma server som applikationen, utan från speciella servrar som är avsedda för detta ändamål. Som en följd av detta utförs dessa operationer snabbare (hypotetisk nginx levererar filer både snabbare och mer kostnadseffektivt än en Java-server). Dessutom gör CDN-arkitekturen () att vi kan placera våra filer närmare slutanvändarna, vilket positivt påverkar användarvänligheten.
Det enklaste och mest standardiserade exemplet på statiskt innehåll är en uppsättning skript och bilder för en webbplats. Med dem är allt enkelt – de är kända i förväg, därefter laddas arkivet upp på CDN-servrarna, från vilka det distribueras till slutanvändarna.
Men i praktiken kan ett liknande tillvägagångssätt användas för statiskt innehåll som liknar lambda-arkitektur. Låt oss återvända till vår uppgift (ett online lagringsutrymme för filer), där vi behöver dela filer med användarna. Den enklaste lösningen är att skapa en tjänst som för varje användarförfrågan gör alla nödvändiga kontroller (behörighet osv.), och sedan laddar ner filen direkt från vårt lagringsutrymme. Huvudnackdelen med detta tillvägagångssätt är att det statiska innehållet (och en fil med en viss revision är i princip statiskt innehåll) distribueras av samma server som innehåller affärslogiken. Istället kan man skapa följande schema:
- Servern tillhandahåller en URL för nedladdning. Den kan ha formatet file_id + key, där key är en mini-nummersignatur som ger rätt till åtkomst till resursen under de kommande 24 timmarna.
- Nedladdningen av filen hanteras av en enkel nginx med följande alternativ:
- Caching of content. Since this service can be located on a separate server, we have allowed for the future possibility of storing all recently downloaded files on disk.
- Key check at the moment of connection creation
- Optionally: streaming content processing. For example, if we compress all files in the service, we can perform the unzipping directly in this module. As a result, IO operations are performed where they should be. A Java archiver may allocate a lot of extra memory, but rewriting the service with business logic in conditional Rust/C++ may also prove ineffective. In our case, we use different processes (or even services), allowing for a fairly effective separation of business logic and IO operations.
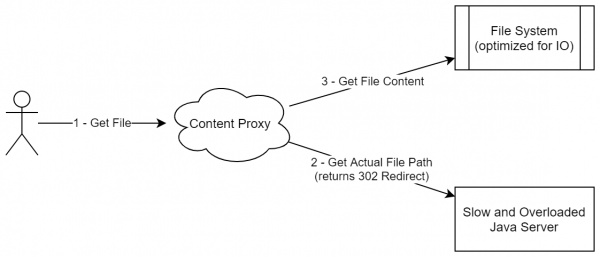
This scheme does not closely resemble serving static content (since we are not unloading the entire static package somewhere), but in reality, this approach is precisely what deals with serving immutable data. Moreover, this scheme can be generalized to other cases where the content is not just static but can be represented as a set of immutable and non-deletable blocks (although they can be added).
As another example (for reinforcement): if you have worked with Jenkins/TeamCity, you know that both solutions are written in Java. They both represent a Java process that handles both build orchestration and content management. Specifically, they both have tasks like "transfer file/folder from server". For instance: issuing artifacts, transferring source code (when the agent does not download the code directly from the repository, but the server does it for them), and access to logs. All these tasks differ in terms of IO load. So, it turns out that the server responsible for complex business logic also needs to be able to effectively push large data streams through itself. Interestingly, this type of operation can be delegated to nginx in exactly the same way (except that a data key should be added to the request).
However, if we return to our system, the resulting scheme is as follows:
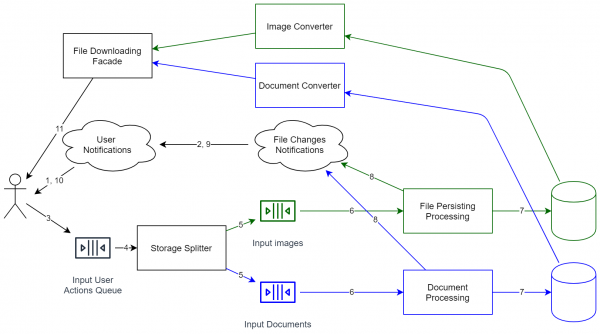
Som synlig, har systemet blitt radikalt mer komplisert. Nå er det ikke bare en liten prosess som lagrer filer lokalt. Nå kreves det ikke akkurat den enkleste støtten, kontroll av API-versjoner, osv. Derfor, etter at alle diagrammer er tegnet, er det best å vurdere i detalj om utvidelsen av slike kostnader er verdt det. Men hvis du ønsker å kunne utvide systemet (inkludert for å håndtere et større antall brukere), må du gå for slike løsninger. Som et resultat, er systemarkitekturen klar for økt belastning (nesten hver komponent kan klones for horisontal skalering). Systemet kan oppdateres uten å stoppe det (bare noen operasjoner vil bli litt forsinket).
Som jeg allerede nevnte i starten, har en rekke internettjenester nå begynt å oppleve økt belastning. Og noen av dem har bare sluttet å fungere skikkelig. Faktisk feilet systemene nettopp i det øyeblikket bedriften skulle tjene penger. I stedet for utsatt levering, i stedet for å tilby kundene ‘planlegg leveringen for de kommende månedene’, sa systemet bare ‘gå til konkurrentene’. Dette er prisen på lav ytelse: tapene skjer nettopp når inntektene ville vært høyest.
Konklusjon
Alle disse tilnærmingene har vært kjent før. Det samme VK har lenge brukt ideen om Static Content Hosting for å levere bilder. Mange nettspill bruker Sharding-mekanismen for å dele spillere etter regioner eller for å dele spillområder (hvis selve verden er enhetlig). Event Sourcing-tilnærmingen er aktivt brukt i e-post. De fleste applikasjoner for tradere, hvor data kontinuerlig kommer inn, er faktisk bygget på CQRS-tilnærmingen for å kunne filtrere de mottatte dataene. Og horisontal skalering har blitt brukt i mange tjenester en god stund.
Men det viktigste er at alle disse mønstrene har blitt veldig enkle å bruke i moderne applikasjoner (forutsatt at de er relevante, selvfølgelig). Skyene tilbyr Sharding og horisontal skalering umiddelbart, noe som er mye lettere enn å bestille forskjellige dedikerte servere i ulike datasentre på egenhånd. CQRS er mye enklere nå, delvis på grunn av utviklingen av biblioteker som RX. For ti år siden ville det vært sjeldent for et nettsted å støtte noe slikt. Event Sourcing konfigureres også utrolig enkelt takket være allerede tilgjengelige containere med Apache Kafka. For ti år siden ville dette vært en innovasjon, nå er det hverdagskost. Tilsvarende med Static Content Hosting: på grunn av mer brukervennlige teknologier (blant annet fordi det finnes omfattende dokumentasjon og et stort svargrunnlag), har en slik tilnærming blitt enda enklere.
Som et resultat har implementeringen av en rekke ganske kompliserte arkitektoniske mønstre nå blitt mye enklere, noe som betyr at det er klokt å se nærmere på dem på forhånd. Hvis et ti år gammelt program forlot en av løsningene nevnt ovenfor på grunn av høye kostnader ved implementering og drift, kan man nå i et nytt program eller etter refaktorering lage en tjeneste som allerede er både skalerbar (med hensyn til ytelse) og klar for nye forespørslene fra kunder (for eksempel for lokalisering av personlig informasjon).
Og det viktigste: vennligst ikke bruk disse tilnærmingene hvis du har en enkel applikasjon. Ja, de er vakre og interessante, men for et nettsted med en maksimal trafikk på 100 besøkende kan man ofte klare seg med en klassisk monolitt (i hvert fall utenfra, innvendig kan alt deles opp i moduler osv.).
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish