

Hei, og først litt lyrikk. Jeg misunner noen ganger kolleger som jobber eksternt – for det er fantastisk å kunne jobbe fra hvor som helst i en internett-tilkoblet verden, ta ferie når som helst, ta ansvar for prosjekter og frister, i stedet for å være på kontoret fra 8 til 17. Min posisjon og arbeidsoppgaver utelukker nesten muligheten for langvarig fravær fra datasenteret. Men - av og til skjer det interessante saker, som beskrevet nedenfor - og jeg innser at det finnes få posisjoner hvor det er så mye rom for kreativt uttrykk fra en intern troubleshooter.
En liten disclaimere - på tidspunktet for skrivingen av artikkelen er saken fortsatt ikke løst, men med tanke på responstiden fra leverandørene, kan det ta måneder før det er helt løst, og jeg ønsker å dele mine funn allerede nå. Jeg håper, kjære lesere, at dere tilgir meg for denne hastverket. Men nok med vann – hva er status på saken?
Først litt bakgrunn: det er et selskap (hvor jeg jobber som nettverksingeniør) som hoster kundeløsninger i en privat sky på VMWare. De fleste nye løsninger kobles til VXLAN-segmenter, som styres av NSX-V - jeg vil ikke vurdere hvor mye tid denne løsningen har gitt meg, men kort sagt – mye. Jeg har til og med klart å lære opp kolleger i konfigurasjonen av NSX ESG, og små kundeløsninger settes opp uten min deltakelse. Viktig å merke seg - kontrollplanet vårt har unicast-replikering. Hypervisorene er koblet redundant via to grensesnitt til forskjellige fysiske Juniper QFX5100 svitsjer (satt sammen i Virtual Chassis) og med en rute-policy basert på opprinnelig virtuell port – dette for å få helhetsbildet.
Kundens løsninger er svært varierte: fra Windows IIS, hvor alle komponentene for webserveren er installert på én maskin, til ganske store - for eksempel lastbalanserte Apache web-fronter + LB MariaDB i Galera + delte servere synkronisert med GlusterFS. Praktisk talt hver server må overvåkes separat, og offentlige adresser er ikke tilgjengelige for alle komponenter - hvis du har støtt på denne oppgaven og har mer elegante løsninger, vil jeg gjerne høre råd.
Mine overvåkningsløsning går ut på å «koble til» brannmuren (Fortigate) til hvert internt kundnettverk (+SNAT og selvsagt strenge begrensninger på type tillatt trafikk) og overvåke interne adresser — slik oppnås en form for enhetlighet og forenkling av overvåkningen. Selve overvåkningen skjer fra en klynge av PRTG-servere. Overvåkningsskjemaet er omtrent slik:
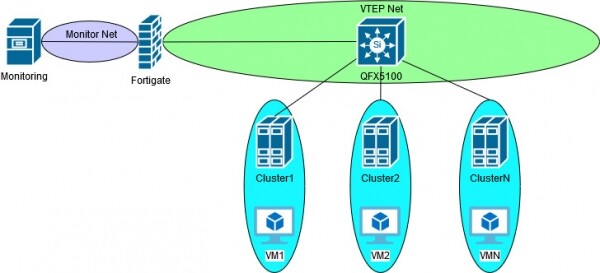
Så lenge vi bare jobbet med VLAN, fungerte alt ganske normalt og forutsigbart, som et klokkeverk. Etter implementeringen av NSX-V og VXLAN støtte vi på spørsmålet — kan vi fortsette overvåkningen som før? På dette tidspunktet var den «raskeste» løsningen å sette opp NSX ESG og koble VXLAN trunk-grensesnittet til VTEP-nettverket. Rask i anførselstegn — ettersom bruken av GUI for å konfigurere kundnettverk, SNAT og brannmurregler kan forene administrasjonen i det samme grensesnittet i vSphere, men etter min mening er det ganske klønete og begrenser dessuten verktøyene for feilsøking. De som har brukt NSX ESG som en erstatning for en «ekte» brannmur, tror jeg vil være enige. Selv om det kanskje ville vært en mer stabil løsning — for alt skjer innenfor en enkelt leverandør.
En annen løsning er å bruke NSX DLR i bro-modus mellom VLAN og VXLAN. Her tror jeg det er ganske klart – man mister enkelt gevinsten ved å bruke VXLAN, for i så fall må man fortsatt trekke VLAN til overvåkningsinstallasjonen. For øvrig støtte jeg på et problem i prosessen med å implementere denne løsningen, hvor DLR-broen ikke sendte pakker til den virtuelle maskinen som den befant seg på samme vert som. Jeg vet, jeg vet – i bøker og guider om NSX-V står det klart at NSX Edge må tildeles en egen klynge, men det er i bøkene... Uansett, etter et par måneder med support klarte vi ikke å løse problemet. Generelt forsto jeg logikken i handlingsforløpet – kjernemodulen til hypervisoren, ansvarlig for innkapslingen av VXLAN, ble ikke aktivert hvis DLR og den overvåkede serveren befant seg på samme vert, ettersom trafikken ikke forlot verten og logisk sett burde vært koblet til VXLAN-segmentet – innkapsling er ikke nødvendig. Sammen med support fokuserte vi på den virtuelle grensesnittet vdrPort, som logisk sammenføyer uplinks og som også utfører broing/innkapsling – der ble det observert en uoverensstemmelse i den inngående trafikken, som jeg tok med meg for behandling i den aktuelle saken. Men som nevnt, jeg fullførte ikke denne saken, da jeg ble overført til et annet prosjekt, og denne grenen var opprinnelig en blindvei, så det var ikke mye lyst til å utvikle den. Hvis jeg ikke tar feil, ble problemet observert i versjoner NSX 6.1.4 og 6.2.
Og her – bingo! Fortinet annonserer innebygd . Og ikke bare point-to-point eller VXLAN-over-IPSec, ikke programvarebroing VLAN-VXLAN – alt dette begynte de å implementere allerede fra versjon 5.4 (og er representert hos andre ), og den faktiske støtten til unicast control plane. Da jeg implementerte løsningen, møtte jeg et annet problem — de overvåkede serverne «forsvant» og dukket opp igjen i overvåkingen, selv om selve virtuelle maskinen var oppe. Årsaken viste seg å være at jeg glemte å tillate Ping på VXLAN-grensesnittet. I prosessen med å rebalansering av klynger, ble de virtuelle maskinene flyttet, og Ping avsluttet vMotion, for å indikere den nye ESXI-vert som maskinen hadde blitt flyttet til. Det var dumt av meg, men dette problemet undergravde igjen tilliten til støtten fra produsenten — i dette tilfellet Fortinet. Jeg nevner ikke engang at hver sak relatert til VXLAN begynner med spørsmålet «hvor har du innstillingene for programvaredisken VLAN-VXLAN?» Denne gangen ble jeg rådet til å endre MTU — det gjelder Ping, som er 32 byte. Deretter «lek med» tcp-send-mss og tcp-receive-mss i policy — for VXLAN som er kapslet i UDP. Uf, beklager — det har bygget seg opp. Uansett, dette problemet løste jeg med egne krefter.
Etter å ha testet trafikken, ble det bestemt at denne løsningen skulle implementeres. Og i produksjon viste det seg at etter en dag eller to, begynte alt som ble overvåket gjennom VXLAN gradvis å falle bort. Deaktivering/aktivering av grensesnittet hjalp, men bare for en periode. Med tanke på den trege støtten fra produsenten, tok jeg fatt på feilsøking på min side — tross alt, mitt selskap, mitt nettverk — mitt ansvar.
Under spoileren finnes fremdriften av feilsøkingen. De som er lei av bokstaver og skryting — hopp over og gå til etteranalysen.
Fremdrift av feilsøkingenTakk for at du fortsatte å lese — la oss fortsette!
Så, overvåkingen fungerer en stund, før den faller bort av seg selv. Det betyr at det sannsynligvis ikke er noe problem med brannmurpolitikkene. Men, siden jeg har støtt på problemet med hengende systemprosesser i Fortigate versjoner 5.6+, ser vi først på «diagnose debug flow» — som forventet blir trafikken tillatt og går ut av grensesnittet, mens ingenting kommer tilbake. Så vi graver videre nedover i stakken. Jeg må dessverre skjule adresser, selv om det er RFC1918, men jeg håper å sørge for tilstrekkelig beskrivelse for forståelse. Serveren inne i VXLAN har adressen x.x.x.15, Fortigate-grensesnittet er x.x.x.254, alle andre adresser tilhører VTEP-nettverket.
For the successful transmission of VXLAN-encapsulated packets, correct information must be available in several tables. For overlay, this is ARP and OVSDB; for underlay, ARP and CAM. In the case of Fortigate, the VXLAN FDB is OVSDB. That’s where we will start:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=у.у.у.47 port=4789 vni=5008 ifindex=7
It's quite simple here — the virtual machine's MAC address must be on the VTEP with the address у.у.у.47. After reviewing the contents and settings of the ESXI cluster, I find that the virtual machine's MAC is correct, and the VTEP address is also correct. I check the CAM/ARP table on the Fortigate — again, everything matches the settings of the ESXI host:
fortigate (root) #get sys arp | grep у.у.у.47
у.у.у.47 0 00:50:56:65:f6:2c dmz
The tables are correct and the traffic is passing — could the issue be not on the Fortigate? I intentionally skipped analyzing the traffic switching on the Juniper — logically, it should be the next troubleshooting step there, but my network is simple — just one VLAN for VTEP with all components directly connected. Plus, I remember a case with a DLR bridge, VDR, and disappearing traffic — I’m going to sniff on the ESXI host and simultaneously create a case with VMWare. Below, the MAC "97:6e" belongs to Fortigate, vmnic1 — this is the interface that has the VTEP with the address у.у.у.47, sniffing in both directions "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
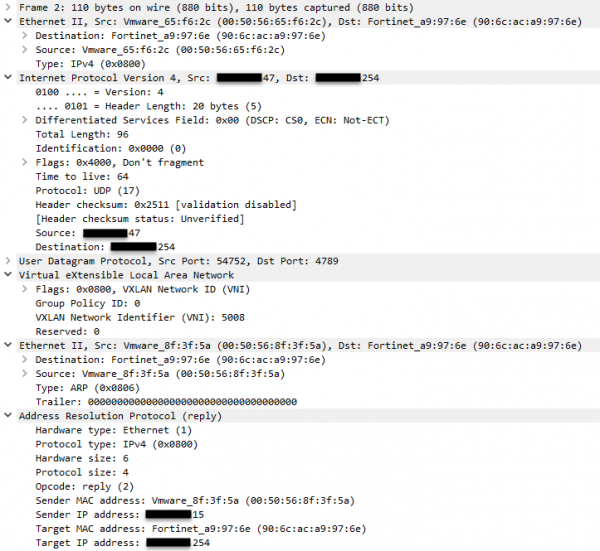
Progress — in the sniff, I see an ARP request and the incoming response. I’m only providing the ARP response and everything is correct there. I didn’t mention that throughout this time the monitoring server is pinging the address х.х.х.15 — where is the ICMP traffic? I remember that I have two uplinks. One might argue that the virtual source port is the same (my teaming policy), meaning the same uplink should be selected for the same vNIC, but since I’m on the host, checking the other uplink is not a problem:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
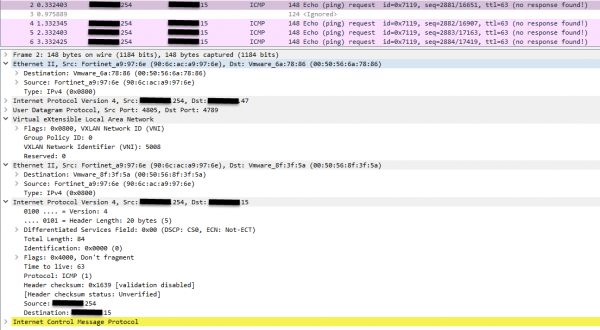
Det kommer forespørselar frå Fortigate, men det kjem ingen svar. Altså, problemet ligg ikkje hos Fortigate. Vel, tenker eg — det er igjen det same problemet med tapt trafikk på VDR, igjen nokre månader med å leite opp saken. Etter nokre dagar, når eg har roe meg ned, og ikkje vil godta det hengande, bestemte eg meg for å samle fleire sniffar for supportteamet, for å få prosessen til å gå raskare. Og her «tilfeldigvis» falt blikket mitt på Ethernet-kapsling underlay. Kongen er ikkje ekte, og MAC-adressa til VTEP samsvarer ikkje med IP-en hans. Eg nullstiller, sniffer, graver — det er rett at det ikkje er rett. Eg legg ved ARP-tabellen slik at det er enklare å samanlikne. Vær merksam på den første Ethernet-kapslinga på bildet ovanfor:
fortigate (root) #get sys arp | grep u.u.u.47
u.u.u.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep u.u.u.42
u.u.u.42 0 00:50:56:6a:78:86 dmz
Så, kva har vi til slutt — etter migrering av den virtuelle maskinen, prøver Fortigate å sende trafikk til VTEP frå (korrekte) VXLAN FDB, men bruker feil DST MAC, og trafikken vert forventa avvist av grensesnittet i hypervisoren som mottar den. I eitt av fire tilfeller høyrde denne MAC-en til den opprinnelege hypervisoren som vi starta migreringa frå.
I går fekk eg ei e-post frå Fortinet si tekniske støtte — dei har opna ein feil i mitt case, 615586. Eg veit verkeleg ikkje om eg skal vere glad eller trist: på den eine sida — problemet ligg ikkje i innstillingane, på den andre — fixen kjem først med ein firmware-oppgradering, i beste fall neste gong. Eg har også funne ei anna feil som held på å varme opp egoet mitt, som eg oppdaga i forrige månad, denne gongen i HTML5 GUI vSphere. Verkeleg som eit lokalt QA-team for leverandørar…
Eg vil tørre å anta følgjande:
1 — multicast control plane vil mest sannsynleg ikkje vere utsett for det beskrevne problemet — sidan MAC-adressene til VTEP blir henta frå IP-adressa til gruppa som grensesnittet er abonnera på.
2 — det er sannsynleg at problemet til Fortigate ligg i offloadinga av sesjonar til Network Processor (tilsvarande CEF) — dersom kvart pakke blir sendt gjennom CPU, vil tabellene som inneheld korrekt — i alle fall visuelt — informasjon bli brukt. Det støttar denne antagelsen at det hjelper å lukke/opne grensesnittet eller å vente ei lita stund — meir enn 5 minutt.
3 — endring av teaming policy, til dømes til explicit failover, eller innføring av LAG vil ikkje løysa problemet, sidan det har vore observert «hefting» av MAC-adressa til den opprinnelege hypervisoren i innkapsla pakkar.
I lys av dette kan eg dele at eg nyleg har oppdaga , hvor det i en af artiklerne blev hævdet, at stateful firewalls og cacheable dataoverførselsmetoder er en slags nødløsninger. Nå, jeg er ikke så erfaren inden for IT, at jeg vil gøre sådanne påstande, og jeg er heller ikke straks enig i alle påstande fra blogartiklerne. Men noget fortæller mig, at der er en portion sandhed i Ivans ord.
Tak for opmærksomheden! Jeg ser frem til at besvare spørgsmål og høre konstruktiv kritik.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish