

Kjære lesere, god dag. I dag skal vi snakke litt om Apache Spark og dens utviklingsutsikter.
I den moderne Big Data-verdenen er Apache Spark de facto standarden for utvikling av batchbehandlingsoppgaver. I tillegg brukes det også til å lage strømmeapplikasjoner som opererer i micro-batch-konseptet, og som behandler og laster data i små porsjoner (Spark Structured Streaming). Tradisjonelt har det vært en del av den generelle Hadoop-stakken, som bruker YARN som ressursforvalter (eller, i noen tilfeller, Apache Mesos). Innen 2020 er bruken av det i tradisjonell forstand for de fleste selskaper sterkt usikker på grunn av mangelen på skikkelige Hadoop-distribusjoner — utviklingen av HDP og CDH har stoppet opp, CDH er ikke tilstrekkelig utviklet og er dyrt, og de andre Hadoop-leverandørene har enten opphørt å eksistere eller har en usikker fremtid. Derfor vekker lanseringen av Apache Spark ved hjelp av Kubernetes økt interesse blant fellesskapet og store selskaper — ved å bli standarden for orkestrering av containere og ressursforvaltning i private og offentlige skyer, løser det problemene med upraktisk ressursplanlegging av Spark-oppgaver på YARN og tilbyr en stabilt utviklende plattform med mange kommersielle og åpne distribusjoner for selskaper av alle størrelser. I tillegg har mange, på bølgen av popularitet, allerede fått noen av sine installasjoner og bygget ekspertise i bruken, noe som gjør overgangen lettere.
Fra versjon 2.3.0 har Apache Spark fått offisiell støtte for å kjøre oppgaver i Kubernetes-klynger, og i dag skal vi diskutere dagens modenhet av denne tilnærmingen, ulike bruksområder og potensielle fallgruver ved implementering.
Først og fremst skal vi se på prosessen med utvikling av oppgaver og applikasjoner basert på Apache Spark og fremheve typiske tilfeller der det er nødvendig å kjøre en oppgave i en Kubernetes-klynge. I forberedelsen av dette innlegget brukes OpenShift som distribusjon, og kommandoene som presenteres vil være relevante for dens kommandolinjeverktøy (oc). For andre Kubernetes-distribusjoner kan de relevante kommandoene for standard Kubernetes kommandolinjeverktøy (kubectl) eller deres alternativer (for eksempel oc adm policy) brukes.
Den første bruksvarianten er spark-submit
I prosessen med å utvikle oppgaver og applikasjoner må utvikleren kjøre oppgaver for å feilsøke datatransformasjoner. Teoretisk kan stubs brukes til disse formålene, men utvikling med virkelige (om enn test-) instanser av slutt-systemene har vist seg å være raskere og mer kvalitativ i denne typen oppgaver. Når vi feilsøker på virkelige instanser av slutt-systemer, finnes det to mulige arbeids scenarier:
- Utvikleren kjører en Spark-oppgave lokalt i standalone-modus;

- Utvikleren kjører en Spark-oppgave på et Kubernetes-klynge i et testmiljø.
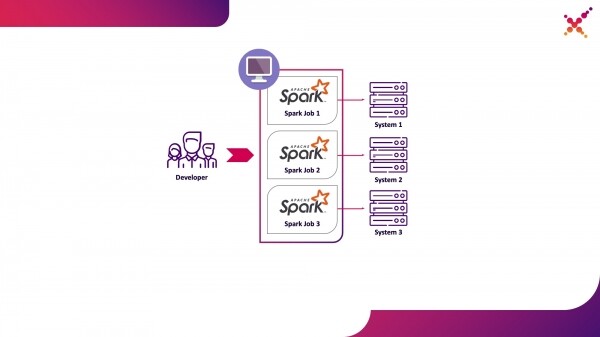
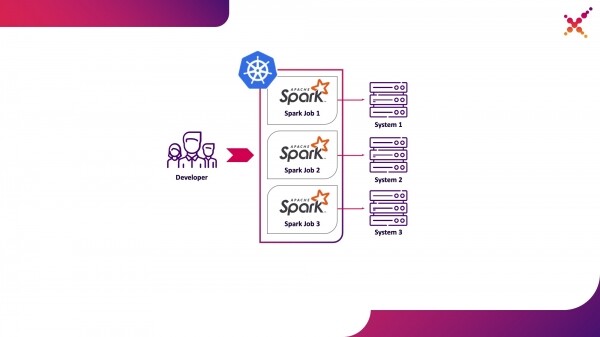
Den første varianten har sin plass, men medfører en rekke ulemper:
- Hver utvikler må ha tilgang fra sin arbeidsplass til alle nødvendige instanser av slutt-systemene;
- Den arbeidsmaskinen må ha tilstrekkelige ressurser for å kjøre den utviklede oppgaven.
Den andre varianten mangler disse ulemper, ettersom bruken av Kubernetes-klusteret gir mulighet til å tildele et nødvendig ressurs-pool for å kjøre oppgaver og å sikre de nødvendige tilgangene til instansene av slutt-systemene, fleksibelt gi tilgang til det ved hjelp av Kubernetes sin rollemode for alle medlemmer av utviklingsteamet. La oss fremheve dette som den første bruksvarianten — kjøring av Spark-oppgaver fra utviklerens lokale maskin på et Kubernetes-kluster i et testmiljø.
La oss gå nærmere inn på prosessen med å konfigurere Spark for lokal kjøring. For å begynne å bruke Spark må det installeres:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Vi samler de nødvendige pakkene for å jobbe med Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Den fullstendige byggingen tar mye tid, og for å lage Docker-bilder og kjøre dem på Kubernetes-klusteret trengs det i virkeligheten bare jar-filer fra katalogen «assembly/», så vi kan bare bygge dette delprosjektet:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
For å kjøre Spark-oppgaver i Kubernetes må det opprettes et Docker-bilde som skal brukes som base. Her er det to tilnærminger:
- Det opprettede Docker-bildet inkluderer den kjørbare koden til Spark-oppgaven;
- Det opprettede bildet inneholder kun Spark og nødvendige avhengigheter, den kjørbare koden plasseres eksternt (for eksempel i HDFS).
La oss begynne med å samle bildet av Docker som inneholder et testeksempel på en Spark-oppgave. For å lage Docker-bilder har Spark et passende verktøy kalt «docker-image-tool». La oss se på hjelpen:
./bin/docker-image-tool.sh --help
Med dette verktøyet kan man lage Docker-bilder og laste dem opp til eksterne registre, men som standard har det en rekke mangler:
- det oppretter alltid 3 Docker-bilder — ett for Spark, ett for PySpark og ett for R;
- det lar ikke spesifisere navnet på bildet.
Derfor skal vi bruke en modifisert versjon av dette verktøyet, som beskrevet nedenfor:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Med dette verktøyet lager vi et basisbilde av Spark, som inneholder en testoppgave for å beregne π med Spark (her {docker-registry-url} er URL-adressen til Docker-registeret, {repo} er navnet på depotet i registret, som samsvarer med prosjektet i OpenShift, {image-name} er navnet på bildet (hvis det brukes en tre-nivå vurdering av bilder, for eksempel som i det integrerte bildet registeret Red Hat OpenShift), {tag} er taggen for denne versjonen av bildet):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Vi logger inn i OKD-klyngen ved hjelp av kommandolinjeverktøyet (her {OKD-API-URL} er URL-en for API-et til OKD-klyngen):
oc login {OKD-API-URL}
Vi får tokenet til den nåværende brukeren for autorisering i Docker Registry:
oc whoami -t
Vi logger inn i den interne Docker Registry for OKD-klyngen (bruk tokenet hentet med den forrige kommandoen som passord):
docker login {docker-registry-url}
Vi laster opp det samlede Docker-bildet til Docker Registry for OKD:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Vi sjekker at det opprettede bildet er tilgjengelig i OKD. For å gjøre dette åpner vi i nettleseren URL-en med listen over bilder for det aktuelle prosjektet (her {project} er prosjektets navn i OpenShift-klyngen, {OKD-WEBUI-URL} er URL-en til Web-konsollen for OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
For å kjøre oppgaver må det opprettes en tjenestekonto med privilegier til å kjøre podder som root (vi skal diskutere dette punktet senere):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Vi utfører kommandoen spark-submit for å publisere Spark-oppgaven i OKD-klyngen, og spesifiserer den opprettede tjenestekontoen og Docker-bildet:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Her:
—name — navnet på oppgaven, som vil være en del av den resulterende navngivningen av Kubernetes-poddene;
—class — klassen til kjørbar fil, som kalles ved oppstart av oppgaven;
—conf — konfigurasjonsparameter for Spark;
spark.executor.instances — antall Spark-utøvere som kjøres;
spark.kubernetes.authenticate.driver.serviceAccountName — navnet på Kubernetes-tjenestekontoen som brukes ved oppstart av podder (for å bestemme sikkerhetskonteksten og rettighetene ved interaksjon med Kubernetes API);
spark.kubernetes.namespace — Kubernetes-navnerommet der podder for driver og utøvere vil kjøre;
spark.submit.deployMode — måten å kjøre Spark på (For standard spark-submit brukes "cluster", for Spark Operator og nyere versjoner av Spark "client");
spark.kubernetes.container.image — Docker-bildet som brukes for å kjøre podder;
spark.master — URL til Kubernetes API (angir eksternt så henvisning skjer fra lokal maskin);
local:// — sti til Spark-kjørbar fil inni Docker-bildet.
Gå til det tilsvarende OKD-prosjektet og se på de opprettede poddene — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
For å forenkle utviklingsprosessen kan en annen versjon brukes, hvor et delt basisbilde av Spark opprettes, brukt av alle oppgaver for kjøring, og kjørbare filsnapshotter publiseres i ekstern lagring (for eksempel Hadoop) og angis ved kall av spark-submit som lenke. I dette tilfellet kan forskjellige versjoner av Spark-oppgaver kjøres uten å bygge om Docker-bilder, for eksempel ved å bruke WebHDFS for publisering av bilder. Send en forespørsel om oppretting av fil (her {host} — verten til WebHDFS-tjenesten, {port} — porten til WebHDFS-tjenesten, {path-to-file-on-hdfs} — ønsket bane til filen på HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
En respons av følgende type vil bli mottatt (her {location} — er URL-en som må brukes for å laste opp filen):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Last opp den kjørbare Spark-filen til HDFS (her {path-to-local-file} — banen til den kjørbare Spark-filen på den nåværende verten):
curl -i -X PUT -T {path-to-local-file} "{location}"
Deretter kan vi gjøre spark-submit ved å bruke Spark-filen som er lastet opp til HDFS (her {class-name} — navnet på klassen som må kjøres for å utføre oppgaven):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Det må bemerkes at tilgang til HDFS og å sikre at oppgaven fungerer kan kreve endringer i Dockerfile og entrypoint.sh-skriptet — legge til en direktiv i Dockerfile for å kopiere avhengige biblioteker til katalogen /opt/spark/jars og inkludere HDFS-konfigurasjonsfilen i SPARK_CLASSPATH i entrypoint.sh.
Den andre bruken - Apache Livy
Når oppgaven er utviklet og resultatet må testes, oppstår spørsmålet om hvordan man skal kjøre den innenfor CI/CD-prosessen og overvåke statusene for utførelsen. Selv om det er mulig å starte den med lokal spark-submit, kompliserer dette CI/CD-infrastrukturen, da det krever installasjon og konfigurering av Spark på CI-serverens agenter/runnere, samt tilgangsinnstillinger til Kubernetes API. For dette tilfellet er målet å bruke Apache Livy som et REST API for å kjøre Spark-oppgaver plassert inne i Kubernetes-klyngen. Dette gjør det mulig å kjøre Spark-oppgaver på Kubernetes-klyngen ved hjelp av vanlige cURL-forespørsel, noe som enkelt kan implementeres på hvilken som helst CI-løsning, og dens plassering inne i Kubernetes-klyngen løser autentiseringsproblemet ved interaksjon med Kubernetes API.
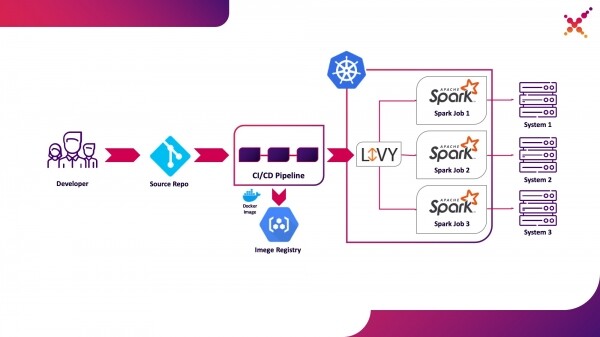
La oss fremheve det som det andre bruksområdet - kjøring av Spark-oppgaver innenfor CI/CD-prosessen på Kubernetes-klyngen i testområdet.
Litt om Apache Livy - det fungerer som en HTTP-server som tilbyr et webgrensesnitt og et RESTful API som gjør det mulig å fjernstarte spark-submit ved å overføre nødvendige parametere. Tradisjonelt ble det levert som en del av HDP-distribusjonen, men det kan også distribueres i OKD eller en hvilken som helst annen Kubernetes-installasjon ved hjelp av det relevante manifestet og et sett med Docker-bilder, for eksempel dette - . For vårt tilfelle ble det bygget et lignende Docker-bilde som inkluderte Spark versjon 2.4.5 fra følgende Dockerfil:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
Det opprettede bildet kan bygges og lastes opp til ditt eksisterende Docker-register, for eksempel det interne OKD-registeret. Følgende manifest brukes for å implementere det ({registry-url} — URL til Docker-registeret, {image-name} — navnet på Docker-bildet, {tag} — taggen til Docker-bildet, {livy-url} — ønsket URL der Livy-serveren vil være tilgjengelig; manifestet «Route» brukes hvis Red Hat OpenShift er distribusjonen av Kubernetes, ellers brukes det tilsvarende Ingress- eller NodePort Service-manifestet):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Etter at den er brukt og podden er vellykket lansert, er det grafiske grensesnittet til Livy tilgjengelig på lenken: http://{livy-url}/ui. Med Livy kan vi publisere vår Spark-oppgave ved å bruke et REST-anrop, for eksempel fra Postman. Et eksempel på en samling med forespørselene er vist nedenfor (i arrayet «args» kan konfigurasjonsargumenter med variabler som er nødvendige for å kjøre oppgaven sendes):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Send job with jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Send job without jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Vi utfører den første forespørselen fra samlingen, går til OKD-grensesnittet og sjekker at oppgaven har blitt startet vellykket — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. Samtidig vil Livy-grensesnittet (http://{livy-url}/ui) vise en økt, der vi kan overvåke fremdriften av oppgaven og studere øktloggene ved hjelp av Livy APIet eller det grafiske grensesnittet.
Vi vil nå vise hvordan Livy fungerer. For dette vil vi undersøke loggene til Livy-containeren inne i pod-en med Livy-serveren — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Her kan vi se at ved kalling av Livy REST API, blir spark-submit utført i containeren med navnet «livy», lik den vi brukte over (her {livy-pod-name} er navnet på pod-en som kjører Livy-serveren). Samlingen inneholder også et andre kall som tillater kjøring av oppgaver med fjerntilgang til Spark-kjørbarheten via Livy-serveren.
Den tredje bruken er Spark Operator.
Nå som oppgaven er testet, reiser spørsmålet seg om dens regelmessige kjøring. Den native metoden for å kjøre oppgaver regelmessig i Kubernetes-klyngen er CronJob-entiteten, og den kan brukes, men for øyeblikket er det høy popularitet i å bruke operatorer til å administrere applikasjoner i Kubernetes, og for Spark finnes det en godt utviklet operator som også brukes i Enterprise-løsninger (f.eks. Lightbend FastData Platform). Vi anbefaler å bruke den — den nåværende stabile versjonen av Spark (2.4.5) har begrensede muligheter for å konfigurere kjøringen av Spark-oppgaver i Kubernetes, mens i den neste hovedversjonen (3.0.0) er det annonsert full støtte for Kubernetes, men datoen for lanseringen er fortsatt ukjent. Spark Operator kompenserer for denne mangelen ved å legge til viktige konfigurasjonsparametere (for eksempel montering av ConfigMap med tilgangskonfigurasjon til Hadoop i Spark-pod-er) og muligheten for å kjøre oppgaver regelmessig etter timeplan.
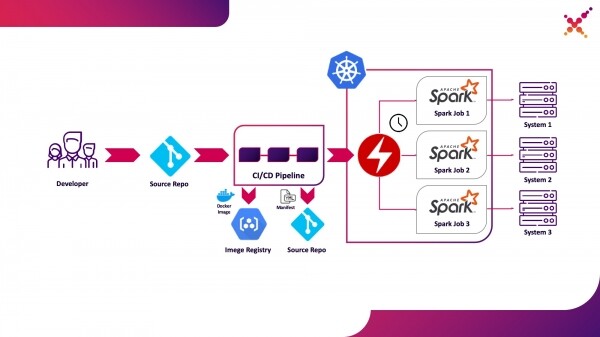
Vi fremhever dette som den tredje bruken — regelmessig kjøring av Spark-oppgaver i Kubernetes-klyngen i produksjonsmiljøet.
Spark Operator har åpen kildekode og utvikles innen Google Cloud Platform — . Den kan installeres på 3 måter:
- Gjennom installasjonen av Lightbend FastData Platform/Cloudflow;
- Ved hjelp av Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Ved å bruke manifester fra det offisielle repositoriet (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Det er viktig å merke seg at Cloudflow inkluderer en operator med API-versjon v1beta1. Hvis denne installasjonstypen brukes, bør beskrivelsene av Spark-applikasjonsmanifester være basert på eksempler fra Git-tags som samsvarer med den relevante API-versjonen, for eksempel «v1beta1-0.9.0-2.4.0». Versjonen av operatoren kan sees i beskrivelsen av CRD som inngår i operatoren under ordboken «versions»:
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Hvis operatoren er installert korrekt, vil det i det aktuelle prosjektet finnes en aktiv pod med Spark-operatoren (for eksempel cloudflow-fdp-sparkoperator i Cloudflow-rommet for Cloudflow-installasjonen), og det vil oppstå en tilsvarende type Kubernetes-ressurs med navnet «sparkapplications». Du kan utforske tilgjengelige Spark-applikasjoner med følgende kommando:
oc get sparkapplications -n {project}
For å kjøre oppgaver med Spark Operator må tre ting gjøres:
- opprette et Docker-bilde som inkluderer alle nødvendige biblioteker, samt konfigurasjons- og kjørbare filer. I målet er dette et bilde som er opprettet i CI/CD-fasen og testet på et testkluster;
- publisere Docker-bildet i et register som er tilgjengelig fra Kubernetes-klusteret;
- lage et manifest med typen «SparkApplication» og beskrivelsen av oppgaven som skal kjøres. Eksempler på manifester er tilgjengelige i det offisielle repositoriet (for eksempel, ). Det er viktig å merke seg noen viktige punkter om manifestet:
- i ordboken «apiVersion» må API-versjonen som samsvarer med operatorens versjon spesifiseres;
- i ordboken «metadata.namespace» må navnerommet hvor applikasjonen skal kjøres angis;
- i ordboken «spec.image» må adressen til det opprettede Docker-bildet i det tilgjengelige registeret spesifiseres;
- i ordboken «spec.mainClass» må klassen for Spark-oppgaven som skal kjøres ved oppstart av prosessen spesifiseres;
- i ordboken «spec.mainApplicationFile» må stien til den kjørbare jar-filen spesifiseres;
- i ordboken «spec.sparkVersion» må den brukte versjonen av Spark spesifiseres;
- i ordboken «spec.driver.serviceAccount» må servicekontoen innen det aktuelle Kubernetes-navnerommet som skal brukes til å kjøre applikasjonen spesifiseres;
- i ordboken «spec.executor» må antallet ressurser som tildeles applikasjonen angis;
- I ordboken «spec.volumeMounts» må det angis en lokal katalog der de lokale filene for Spark-oppgaven skal opprettes.
Eksempel på oppretting av manifest (her er {spark-service-account} - tjenestekontoen i Kubernetes-klyngen for å kjøre Spark-oppgaver):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:////opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
I dette manifestet er det angitt en tjenestekonto, for hvilken nødvendige rollebindinger må opprettes før publisering av manifestet, som gir nødvendige rettigheter for Spark-applikasjonen til å interagere med Kubernetes API (hvis nødvendig). I vårt tilfelle trenger applikasjonen rettigheter til å opprette podder. La oss lage den nødvendige rollebindingen:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Det er også verdt å merke seg at spesifikasjonen av dette manifestet kan inkludere parameteren «hadoopConfigMap», som lar deg spesifisere en ConfigMap med Hadoop-konfigurasjon uten å måtte legge den aktuelle filen i Docker-bildet på forhånd. Den passer også for regelmessig kjøring av oppgaver — ved hjelp av parameteren «schedule» kan det oppgis en tidsplan for kjøringen av denne oppgaven.
Etter dette lagrer vi manifestet vårt i filen spark-pi.yaml og anvender det på vår Kubernetes-klynge:
oc apply -f spark-pi.yaml
Det vil opprettes et objekt av typen «sparkapplications»:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Det vil bli opprettet en pod med applikasjonen, hvis status vil vises i den opprettede «sparkapplications». Den kan sees med følgende kommando:
oc get sparkapplications spark-pi -o yaml -n {project}
Når oppgaven er fullført, vil POD gå til status «Completed», som også vil oppdateres i «sparkapplications». Loggene til applikasjonen kan sees i nettleseren eller ved å bruke følgende kommando (her er {sparkapplications-pod-name} - navnet på podden til den kjørende oppgaven):
oc logs {sparkapplications-pod-name} -n {project}
I styring av Spark-oppgaver kan bruke det spesialiserte verktøyet sparkctl. For å installere det, kloner vi depotet med kildekoden, installerer Go og bygger verktøyet:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
La oss se på listen over kjørende Spark-oppgaver:
sparkctl list -n {project}
La oss opprette en beskrivelse for Spark-oppgaven:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "tmp"
La oss starte den beskrevne oppgaven med sparkctl:
sparkctl create spark-app.yaml -n {project}
La oss se på listen over kjørende Spark-oppgaver:
sparkctl list -n {project}
La oss se på listen over hendelser for den kjørende Spark-oppgaven:
sparkctl event spark-pi -n {project} -f
La oss sjekke statusen til den kjørende Spark-oppgaven:
sparkctl status spark-pi -n {project}
Til slutt ønsker vi å se på de oppdagede ulemperne ved å bruke den nåværende stabile versjonen av Spark (2.4.5) i Kubernetes:
- Den første og sannsynligvis største ulempen er mangelen på Data Locality. Til tross for alle ulempene, hadde YARN også fordeler ved bruken, for eksempel prinsippet om å levere kode til dataene (i stedet for dataene til koden). Takket være dette ble Spark-oppgaver utført på noder hvor dataene som deltok i beregningene var lagret, noe som betydelig reduserte tiden brukt på å overføre data over nettverket. Når vi bruker Kubernetes, møter vi behovet for å flytte dataene som er involvert i oppgavens arbeid over nettverket. Hvis disse er ganske store, kan det føre til betydelig økning i oppgavens løpetid, og det kan også kreves en betydelig mengde diskplass tildelt Spark-oppgaveinstansene for midlertidig lagring. Denne ulempen kan reduseres ved å bruke spesialiserte programvareverktøy som sikrer datalokalisering i Kubernetes (for eksempel Alluxio), men dette innebærer i praksis at det må lagres en komplett kopi av dataene på nodene i Kubernetes-klyngen.
- Den andre viktige ulempen er sikkerhet. Som standard er funksjoner knyttet til sikkerhet ved kjøring av Spark-oppgaver deaktivert, bruken av Kerberos er ikke dekket i den offisielle dokumentasjonen (selv om tilsvarende parametere dukket opp i versjon 3.0.0, noe som vil kreve ekstra arbeid), og i dokumentasjonen for sikkerhet ved bruk av Spark (https://spark.apache.org/docs/2.4.5/security.html) er kun YARN, Mesos og Standalone Cluster nevnt som lagringssystemer for nøkler. Brukeren som kjører Spark-oppgavene kan heller ikke spesifiseres direkte - vi angir bare en tjenestekonto som oppgaven vil kjøre under, og brukeren velges ut fra de konfigurerte sikkerhetspolicyene. I lys av dette brukes enten root-brukeren, noe som ikke er trygt i produksjonsmiljøer, eller en bruker med tilfeldig UID, noe som er upraktisk når det gjelder fordeling av tilgangsrettigheter til dataene (løses ved å opprette PodSecurityPolicies og koble dem til de relevante tjenestekontoene). For øyeblikket løses dette enten ved å plassere alle nødvendige filer direkte i Docker-bildet, eller ved å modifisere oppstartsskriptet for Spark til å bruke mekanismen for lagring og henting av hemmeligheter som er vedtatt i organisasjonen din.
- Kjøring av Spark-oppgaver med Kubernetes er fortsatt offisielt i eksperimentelt modus, og det kan i fremtiden være betydelige endringer i de brukte artefaktene (konfigurasjonsfiler, basis Docker-bilder og oppstartsskript). Faktisk, under forberedelsen av materialet ble versjoner 2.3.0 og 2.4.5 testet, og atferden var betydelig forskjellig.
Vi ser frem til oppdateringer — nylig ble den nyeste versjonen av Spark (3.0.0) utgitt, som brakte merkbare endringer i hvordan Spark fungerer på Kubernetes, men som opprettholdt den eksperimentelle statusen for støtten til denne ressursadministratoren. Kanskje vil kommende oppdateringer virkelig gjøre det mulig å anbefale fullstendig å gi opp YARN og kjøre Spark-oppgaver på Kubernetes uten å bekymre seg for sikkerheten til systemet ditt, og uten behov for egen utvikling av funksjonskomponenter.
Fin.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish