

Data Science for Beginners
1. Sentiment Analysis
See the full implementation of the Data Science project using the source code — .
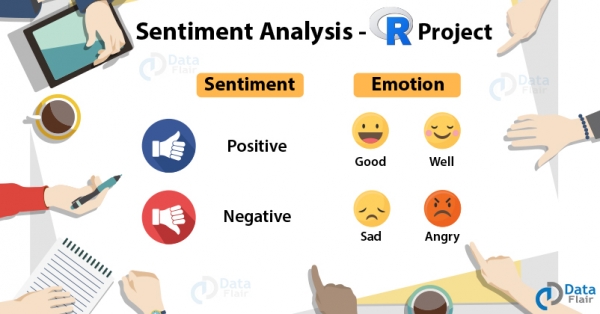
Sentiment Analysis is the analysis of words to determine sentiments and opinions that can be positive or negative. This is a type of classification where the classes can be binary (positive and negative) or multiple (happy, angry, sad, etc.). We will implement this Data Science project in R and use the dataset from the 'janeaustenR' package. We will use general-purpose dictionaries such as AFINN, Bing, and Loughran, perform inner joins, and finally, we will create a word cloud to display the results.
Language: R
Dataset/Package: janeaustenR
Artikkelen er oversatt med støtte fra EDISON Software, som , samt .
2. Fake News Detection
Take your skills to the next level by working on a beginner Data Science project — .
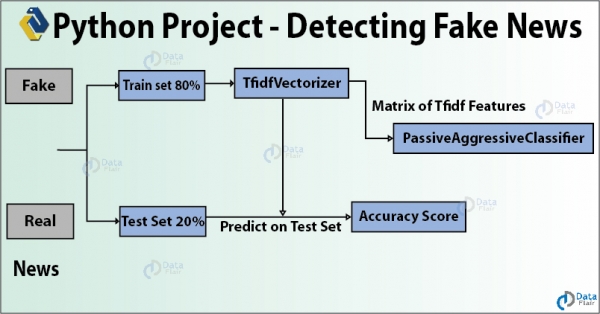
Fake news is false information disseminated through social networks and other online media for political purposes. In this Data Science project idea, we will use Python to build a model that can accurately determine whether a news article is real or fake. We will create a TfidfVectorizer and use a PassiveAggressiveClassifier to classify news as 'real' or 'fake'. We will use a dataset of 7796 × 4 and do everything in Jupyter Lab.
Language: Python
Dataset/Package: news.csv
3. Detecting Parkinson’s Disease
Advance your skills by working on the Data Science project idea — .
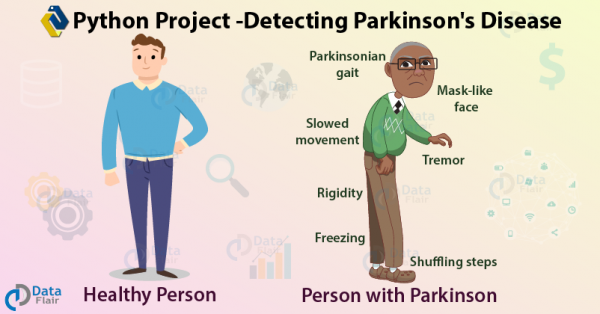
We started using Data Science to improve healthcare and services — if we can predict illnesses at an early stage, we will have many advantages. So, in this Data Science project idea, we will learn to detect Parkinson's Disease using Python. It is a neurodegenerative, progressive disease of the central nervous system that affects movement and causes tremors and stiffness. It affects dopamine-producing neurons in the brain, and every year it impacts over 1 million people in India.
Language: Python
Dataset/Package: UCI ML Parkinson's dataset
Medium Complexity Data Science Projects
4. Speech Emotion Recognition
Bli kjent med den komplette implementeringen av Data Science-prosjektet — .
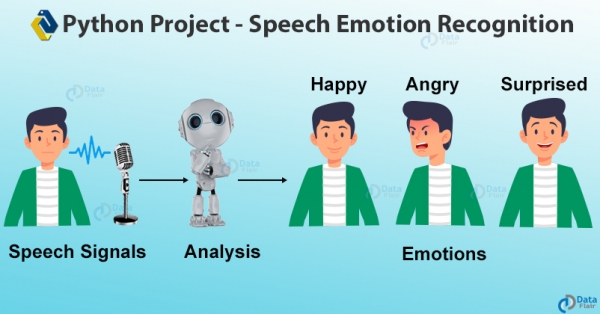
La oss nå lære å bruke forskjellige biblioteker. Dette Data Science-prosjektet bruker librosa for talegjenkjenning. SER er prosessen med å bestemme menneskelige følelser og affektive tilstander gjennom tale. Siden vi bruker tone og tonehøyde for å uttrykke følelser med stemmen, er SER aktuelt. Men ettersom følelser er subjektive, er annotering av lyd en kompleks oppgave. Vi vil bruke mfcc-, chroma- og mel-funksjoner og benytte RAVDESS-datasettet for å gjenkjenne følelser. Vi vil lage en MLPC-klassifikator for denne modellen.
Language: Python
Dataset/Package: RAVDESS-datasett
5. Kjønn og Alderdeteksjon
Imponer arbeidsgivere med det nyeste Data Science-prosjektet — .
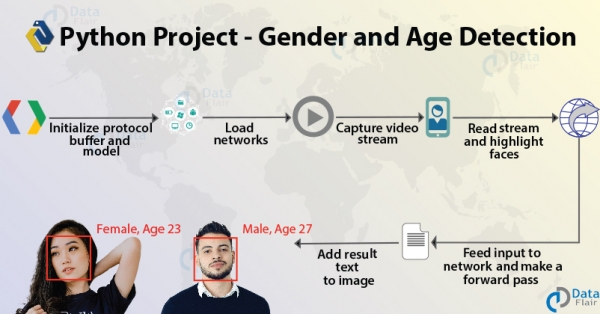
Dette er et spennende Data Science-prosjekt med Python. Ved å bruke bare ett bilde vil du lære å forutsi kjønn og alder på en person. I dette prosjektet vil vi introdusere deg for Computer Vision og dens prinsipper. Vi vil bygge en og bruke modeller trent av Tal Hassner og Gil Levi for Adience-datasettet. Underveis vil vi bruke noen .pb, .pbtxt, .prototxt og .caffemodel-filer.
Language: Python
Dataset/Package: Adience
6. Uber Dataanalyse
Se den komplette implementeringen av Data Science-prosjektet med kildekode — .
Dette er et datavisualiseringsprosjekt med ggplot2, der vi vil bruke R og dens biblioteker for å analysere forskjellige parametere. Vi vil bruke datasettet Uber Pickups i New York og lage visualiseringer for ulike tidsrammer i året. Dette viser oss hvordan tiden påvirker kundenes reiser.
Language: R
Dataset/Package: Uber Pickups i New York City-datasett
7. Oppdagelse av sjåførsløvhet
Ta ferdighetene dine til neste nivå med et topp Data Science-prosjekt — .
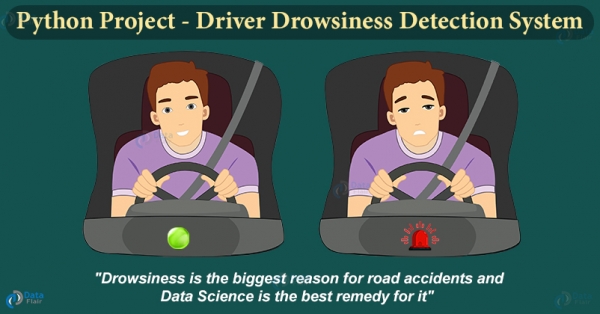
Søvnig kjøring er ekstremt farlig, og hver år skjer det rundt tusen ulykker fordi sjåfører sovner under kjøring. I dette Python-prosjektet vil vi lage et system som kan oppdage søvnige sjåfører, samt varsle dem med en lydsignal.
Dette prosjektet er implementert ved hjelp av Keras og OpenCV. Vi skal bruke OpenCV for ansikts- og øyegjenkjenning, og med Keras klassifisere øyets tilstand (Åpen eller Lukket) ved hjelp av metoder fra dyp læring.
8. Chatbot
Lag en chatbot med Python og ta et skritt fremover i karrieren — .
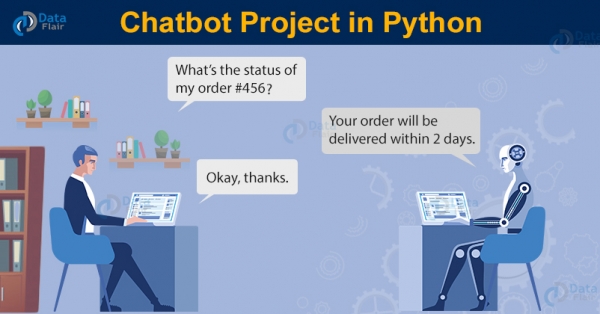
Chatboter er en integrert del av virksomheten. Mange bedrifter må tilby tjenester til sine kunder, og for å betjene dem kreves det mye arbeidskraft, tid og innsats. Chatboter kan automatisere mye av kundeinteraksjonen ved å svare på noen av de vanlige spørsmålene kundene stiller. Det finnes hovedsakelig to typer chatboter: Domenespesifikke og Åpen-domen. Domenespesifikke chatboter brukes ofte for å løse et spesifikt problem. Du må derfor tilpasse dem for effektiv drift i ditt felt. Åpen-domen chatboter kan få spørsmål om hva som helst, så det kreves en enorm mengde data for å trene dem.
Datasett: Intents json-fil
Language: Python
Avanserte Data Science-prosjekter
9. Bildebeskrivelsesgenerator
Se den komplette prosjektimplementeringen med kildekoden — .
Å beskrive hva som er i et bilde er en enkel oppgave for mennesker, men for datamaskiner er bildet bare en mengde tall som representerer fargeverdien til hver piksel. Det er en utfordrende oppgave for datamaskiner. Å forstå hva som er i bildet og så lage en beskrivelse på naturlig språk (for eksempel engelsk) er en annen utfordrende oppgave. Dette prosjektet bruker metoder for dyp læring, hvor vi implementerer et konvolusjonært nevrale nettverk (CNN) med et rekurrent nevrale nettverk (LSTM) for å lage en generator for bildebeskrivelser.
Datasett: Flickr 8K
Language: Python
Rammeverk: Keras
10. Kredittkortsvindeldeteksjon
Gjør ditt beste ved å jobbe med prosjektideen innen Data Science — .
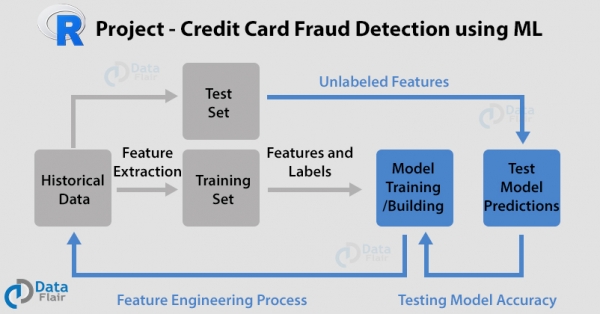
Så langt har du begynt å forstå metoder og konsepter. La oss gå videre til noen avanserte prosjekter innen datavitenskap. I dette prosjektet vil vi bruke R-språket med algoritmer som , logistisk regresjon, kunstige nevrale nettverk og gradientboosterklassifikator. Vi skal bruke et datasett med korttransaksjoner for å klassifisere kredittkorttransaksjoner som svindel eller ekte. Vi vil tilpasse forskjellige modeller for dem og bygge ytelseskurver.
Language: R
Dataset/Package: Datasett for korttransaksjoner
11. Filmanbefalingssystem
Utforsk implementeringen av det beste Data Science-prosjektet med kildekode —
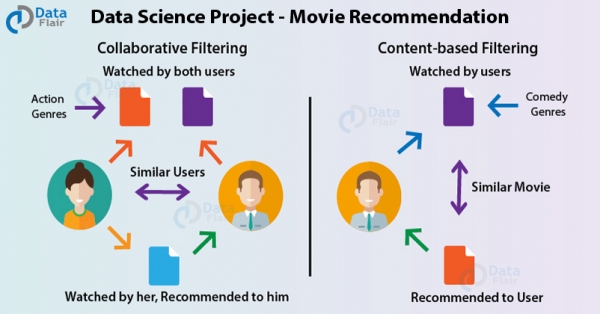
I dette Data Science-prosjektet vil vi bruke R for å gi filmanbefalinger gjennom maskinlæring. Anbefalingssystemet sender forslag til brukere gjennom en filtreringsprosess basert på preferansene til andre brukere og seerhistorikk. Hvis A og B liker Home Alone, og B elsker Mean Girls, kan det foreslås til A at de også kan like det. Dette lar kundene engasjere seg med plattformen.
Language: R
Dataset/Package: MovieLens-datasett
12. Kundesegmentering
Imponer arbeidsgiverne med et Data Science-prosjekt (inkludert kildekode) — .
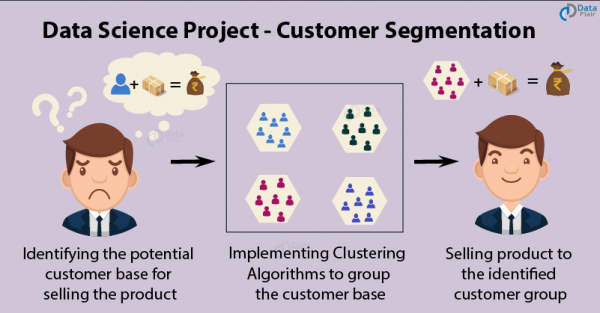
Kundesegmentering er en populær applikasjon Ved å bruke klynging definerer selskaper kundegrupper for å jobbe med en potensiell brukerbase. De deler kunder i grupper basert på felles egenskaper, som kjønn, alder, interesser og forbruksvaner, slik at de kan selge produktene sine effektivt til hver gruppe. Vi vil bruke , samt visualisere fordelingen etter kjønn og alder. Deretter analyserer vi deres årlige inntekter og forbruksnivå.
Language: R
Dataset/Package: Mall_Customers-datasett
13. Klassifisering av brystkreft
Se den komplette implementeringen av Data Science-prosjektet i Python — .
Når vi vender tilbake til den medisinske innflytelsen av data science, la oss lære å oppdage brystkreft ved hjelp av Python. Vi skal bruke datasettet IDC_regular for å identifisere invasiv duktal karsinom, den mest utbredte formen for brystkreft. Den utvikler seg i melkegangene og trenger inn i bindevev eller fettvev utenfor gangen. I dette vitenskapelige prosjektet om datainnsamling vil vi bruke og Keras-biblioteket for klassifisering.
Language: Python
Dataset/Package: IDC_regular
14. Gjenkjenning av trafikkskilt
Å oppnå nøyaktighet innen teknologi for selvkjørende biler gjennom et data science-prosjekt om med åpen kildekode.
Trafikkskilt og trafikkregler er svært viktige for hver sjåfør for å unngå ulykker. For å følge reglene må man først forstå hvordan et trafikkskilt ser ut. En person må lære seg alle trafikkskiltene før de kan få førerkort for et hvilket som helst kjøretøy. Men nå vokser antall autonome kjøretøy, og i nær fremtid vil mennesket ikke lenger kjøre bilen selv. I prosjektet 'Gjenkjenning av trafikkskilt' vil du lære hvordan et program kan gjenkjenne typen trafikkskilt ved å ta et bilde som inngangssignal. Datasettet for gjenkjenning av trafikkskilt i Tyskland (GTSRB) brukes til å bygge et dypt nevralt nettverk for å gjenkjenne hvilken klasse trafikkskiltet tilhører. Vi lager også et enkelt grafisk brukergrensesnitt for å interagere med applikasjonen.
Language: Python
Datasett: GTSRB (Tysk gjenkjenning av trafikkskilt-benchmark)
Read more
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish