

SciPy (uttales som «sai pai») er et pakke for anvendt matematikk basert på utvidelsen av Numpy Python. Med SciPy blir en interaktiv Python-økt en fullverdig databehandlings- og prototypingmiljø, lik MATLAB, IDL, Octave, R-Lab og SciLab. I dag vil jeg kort fortelle om hvordan man bør anvende noen kjente optimaliseringsalgoritmer i pakken scipy.optimize. Mer detaljert og oppdatert informasjon om bruk av funksjoner kan alltid hentes med kommandoen help() eller ved å bruke Shift+Tab.
Innledning
For å spare meg selv og leserne mine fra å lete etter og lese originalkildene, vil lenkene til beskrivelsene av metodene hovedsakelig føre til Wikipedia. Som regel er denne informasjonen tilstrekkelig for å forstå metodene i grove trekk og forholdene for bruken av dem. For å forstå essensen av de matematiske metodene, kan vi gå til lenkene til mer autoritative publikasjoner, som kan finnes på slutten av hver artikkel eller i din favoritt søkemotor.
Så, modulen scipy.optimize inkluderer implementeringen av følgende prosedyrer:
- Betinget og ubetinget minimering av skalarfunksjoner med flere variabler (minim) ved hjelp av ulike algoritmer (Nelder-Mead-simplices, BFGS, konjugerte gradienter av Newton, og )
- Global optimalisering (for eksempel: , )
- Minimering av rester (least_squares) og algoritmer for kurvetilpasning med ikke-lineær MKN (curve_fit)
- Minimering av skalarfunksjoner med én variabel (minim_scalar) og rotfinningsmetoder (root_scalar)
- Multidimensjonale løsningsmetoder for likningssystemer (root) ved hjelp av ulike algoritmer (hybrid Powell, eller storskala metoder, som ).
I denne artikkelen vil vi bare se på det første punktet fra hele denne listen.
Ubetinget minimering av en skalarfunksjon med flere variabler
Funksjonen minim fra pakken scipy.optimize gir et generelt grensesnitt for å løse oppgaver om betinget og ubetinget minimering av skalarfunksjoner med flere variabler. For å demonstrere dens virkemåte, trenger vi en passende funksjon med flere variabler, som vi vil minimere på forskjellige måter.
For disse formålene passer funksjonen til Rosenbrock av N variabler perfekt, som har formen:

Selv om Rosenbrock-funksjonen og dens Jacobiske og Hessianske matriser (første og andre deriverte henholdsvis) allerede er definert i scipy.optimize-pakken, vil vi definere den selv.
import numpy as np

def rosen(x):
    """Rosenbrock-funksjonen"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
For å gjøre det tydelig, vil vi visualisere 3D-verdier av Rosenbrock-funksjonen basert på to variabler.
Kode for visualisering
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Konfigurer 3D-plotet
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Sett visningsvinkel
ax.view_init(45, 30)

# Lag data for plottet
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Tegn overflaten
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
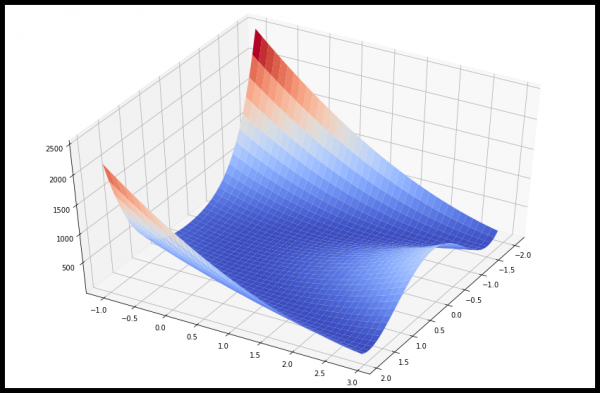
Med vite at minimumet er lik 0 når  , vil vi se på eksempler på hvordan man kan bestemme minimumsverdien av Rosenbrock-funksjonen ved hjelp av forskjellige prosedyrer fra scipy.optimize.
Nelder-Mead simplexmetode
La oss anta at vi har et startpunkt x0 i 5-dimensjonalt rom. Vi skal finne det nærmeste minimumspunktet av Rosenbrock-funksjonen ved hjelp av algoritmen (algoritmen er spesifisert som verdien av parameteren method):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimaliseringen ble avsluttet med suksess.
Nåværende funksjonsverdi: 0.000000
Iterasjoner: 339
Funksjonsvurderinger: 571
[1. 1. 1. 1. 1.]Nelder-Mead simplexmetode er den enkleste måten å minimere en eksplisitt definert og ganske glatt funksjon. Den krever ikke beregning av funksjonens deriverte, det er nok å angi dens verdier. Metoden er et godt valg for enkle optimaliseringsoppgaver. Imidlertid, siden den ikke bruker gradientvurderinger, kan det ta lengre tid å finne minimum.
Powell-metoden
En annen optimaliseringsalgoritme som kun beregner funksjonsverdier er . For å bruke den, må du angi method = 'powell' i minim-funksjonen.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimaliseringen ble avsluttet med suksess.
Nåværende funksjonsverdi: 0.000000
Iterasjoner: 19
Funksjonsvurderinger: 1622
[1. 1. 1. 1. 1.]Broyden-Fletcher-Goldfarb-Shanno (BFGS) algoritmen
For å oppnå raskere konvergens mot løsningen, prosedyren benytter gradienten av mål-funksjonen. Gradient kan enten spesifiseres som en funksjon eller beregnes ved hjelp av førsteparts forskjeller. Uansett krever vanligvis BFGS-metoden færre funksjonskall enn simplex-metoden.
La oss finne den analytiske deriverte av Rosenbrock-funksjonen:


Dette uttrykket gjelder for deriverte av alle variabler unntatt den første og den siste, som defineres som:


La oss se på en Python-funksjon som beregner denne gradienten:
def rosen_der (x):
    xm = x [1: -1]
    xm_m1 = x [: - 2]
    xm_p1 = x [2:]
    der = np.zeros_like (x)
    der [1: -1] = 200 * (xm-xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1-xm)
    der [0] = -400 * x [0] * (x [1] -x [0] ** 2) - 2 * (1-x [0])
    der [-1] = 200 * (x [-1] -x [-2] ** 2)
    return der
Gradientfunksjonen oppgis som verdien av parameteren jac i minim-funksjonen, som vist nedenfor.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
Optimalisering avsluttet med hell.
Nåverdi av funksjonen: 0.000000
Iterasjoner: 25
Funksjonsvurderinger: 30
Gradientvurderinger: 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]Metode for konjugerte gradienter (Newton)
Algoritme er en modifisert Newton-metode.
Newton-metoden er basert på å tilnærme funksjonen i et lokalt område med et polynom av andre grad:

der  er matrisen av andre deriverte (Hessianske matrisen, hessian).
Hvis hessian er positiv definert, kan det lokale minimumet av denne funksjonen finnes ved å sette den null gradienten av den kvadratiske formen til null. Resultatet blir et uttrykk:

Den inverse hessian beregnes ved hjelp av metoden for konjugerte gradienter. Et eksempel på bruk av denne metoden for å minimere Rosenbrock-funksjonen er vist nedenfor. For å bruke Newton-CG-metoden, må man spesifisere en funksjon som beregner hessian.
Hessianske funksjonen til Rosenbrock i analytisk form er:


der  og
 , definerer matrisen
 .
De øvrige ikke-null-elementene i matrisen er lik:


For eksempel, i femdimensjonalt rom N = 5, har hessian for Rosenbrock-funksjonen båndet utseende:

Koden som beregner denne hessian sammen med koden for å minimere Rosenbrock-funksjonen ved hjelp av metoden for konjugerte gradienter (Newton):
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimalisering avsluttet vellykket.
Nåværende funksjonsverdi: 0.000000
Iterasjoner: 24
Funksjonsvurderinger: 33
Gradientvurderinger: 56
Hessianvurderinger: 24
[1. 1. 1. 0.99999999 0.99999999]Eksempel med definisjon av hessianproduksjonsfunksjon og vilkårlig vektor
I virkelige oppgaver kan beregning og lagring av hele Hessian-matrisen kreve betydelige ressurser i tid og minne. Det er imidlertid egentlig ikke nødvendig å definere selve Hessian-matrisen, da det for optimaliseringsprosedyren kun trengs en vektor som er lik produktet av hessianen med en annen vilkårlig vektor. På denne måten er det teknisk sett mye mer fordelaktig å umiddelbart definere en funksjon som returnerer resultatet av produktet av hessianen med en vilkårlig vektor.
La oss vurdere funksjonen hess, som tar minimiseringsvektor som første argument, mens den vilkårlige vektoren brukes som det andre argumentet (sammen med andre argumenter til den som minimeres funksjon). I vårt tilfelle å beregne produktet av hessianen til Rosenbrock-funksjonen med en vilkårlig vektor er ikke veldig komplisert. Hvis p — vilkårlig vektor, så er produktet  i form:

Funksjonen som beregner produktet av hessianen og en vilkårlig vektor, sendes som verdien til argumentet hessp for funksjonen minimize:
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
Optimalisering avsluttet vellykket.
         Nåværende funksjonsverdi: 0.000000
         Iterasjoner: 24
         Funksjonsvurderinger: 33
         Gradientvurderinger: 56
         Hessianvurderinger: 66
Trust-region metodens konjugerte gradienter (Newton)
Dårlig tilstand av Hessian-matrisen og feil søke retninger kan føre til at Newtons konjugerte gradientmetode kan være ineffektiv. I slike tilfeller foretrekkes (trust-region) for Newtons konjugerte gradienter.
Eksempel med definisjon av Hessian-matrisen:
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimalisering avsluttet med suksess.
Nåværende funksjonsverdi: 0.000000
Iterasjoner: 20
Funksjonsevalueringer: 21
Gradientevalueringer: 20
Hessianevalueringer: 19
[1. 1. 1. 1. 1.]Eksempel med produktet av hessian og en vilkårlig vektor:
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimalisering avsluttet med suksess.
Nåværende funksjonsverdi: 0.000000
Iterasjoner: 20
Funksjonsevalueringer: 21
Gradientevalueringer: 20
Hessianevalueringer: 0
[1. 1. 1. 1. 1.]Krylov-type metoder
Likt trust-ncg-metoden, passer Krylov-type metoder godt for å løse storskalaoppgaver, ettersom de kun bruker matrise-vektorprodukter. Kjernen i dem er at de løser problemet i et tillitsområde, begrenset av et avkortet Krylov-underrom. For ubestemte oppgaver er det bedre å bruke denne metoden, da den bruker færre ikke-lineære iterasjoner gjennom et mindre antall matrise-vektorprodukter per delproblem, sammenlignet med trust-ncg-metoden. I tillegg er løsningen av det kvadratiske delproblemet mer presis enn med trust-ncg.
Eksempel med definisjon av Hessian-matrisen:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

Optimalisering avsluttet med suksess.
         Nåværende funksjonsverdi: 0.000000
         Iterasjoner: 19
         Funksjonsevalueringer: 20
         Gradientevalueringer: 20
         Hessianevalueringer: 18

print(res.x)

    [1. 1. 1. 1. 1.]
Eksempel med produktet av hessian og en vilkårlig vektor:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

Optimalisering avsluttet med suksess.
         Nåværende funksjonsverdi: 0.000000
         Iterasjoner: 19
         Funksjonsevalueringer: 20
         Gradientevalueringer: 20
         Hessianevalueringer: 0

print(res.x)

    [1. 1. 1. 1. 1.]
Algoritme for tilnærmet løsning i et tillitsområde
Alle metodene (Newton-CG, trust-ncg og trust-krylov) passer godt for å løse storskalaoppgaver (med tusenvis av variabler). Dette skyldes at algoritmen for konjugerte gradienter som ligger til grunn for dem, innebærer en approksimativ inversjon av Hessian-matrisen. Løsningen finnes iterativt, uten eksplisitt dekomponering av hessian. Siden det kun kreves å bestemme funksjonen for produktet av hessian og en vilkårlig vektor, er denne algoritmen særlig god for å håndtere sparsomme (båndede diagonale) matriser. Dette gir lave minnekostnader og betydelige tidsbesparelser.
I mellomstore oppgaver er lagringskostnadene og faktoriseringen av Hessianen ikke avgjørende. Dette betyr at det er mulig å finne løsninger med færre iterasjoner ved å løse tillitsområdets deloppgaver nesten nøyaktig. For dette løses enkelte ikke-lineære likninger iterativt for hver kvadratisk deloppgave. Denne løsningen krever vanligvis 3 eller 4 Cholesky-faktoriseringer av Hessian-matrisen. Som et resultat konvergerer metoden med færre iterasjoner og krever færre evalueringer av målfunksjonen sammenlignet med andre implementerte metoder for tillitsområder. Denne algoritmen forutsetter bare bestemmelsen av den fullstendige Hessian-matrisen, og støtter ikke muligheten til å bruke produktfunksjonen av Hessianen og en vilkårlig vektor.
Eksempel med minimering av Rosenbrock-funksjonen:
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
Optimalisering avsluttet med suksess.
Nåværende funksjonsverdi: 0.000000
Iterasjoner: 13
Funksjonsevalueringer: 14
Gradientevalueringer: 13
Hessian-evalueringer: 14
array([1., 1., 1., 1., 1.])La oss avslutte her. I den neste artikkelen vil jeg prøve å fortelle det mest interessante om betinget minimering, bruken av minimering i løsningen av tilnærmingsoppgaver, minimering av en variabelfunksjon, vilkårlige minimeringsmetoder og rotfunn av likningssystemer ved hjelp av scipy.optimize-pakken.
Kilde:
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish