

Tiden for rapportering i Excel forsvinner raskt — trenden med brukervennlige verktøy for presentasjon og analyse av informasjon er tydelig i alle områder. Vi har lenge diskutert digitalisering av rapportering og valgte visualiserings- og selvbetjent analyssystemet Tableau. Aleksandr Bezugly, leder for avdelingen for analytiske løsninger og rapportering i «M.Video-Eldorado»-gruppen, delte erfaringene og resultatene fra oppbyggingen av et handlingsdashboard.
Jeg vil si med én gang at ikke alt som ble planlagt, ble gjennomført, men erfaringen var interessant, og jeg håper den vil være nyttig for dere også. Hvis noen har ideer om hvordan vi kunne ha gjort det bedre, vil jeg sette stor pris på råd og forslag.
Under finner du informasjon om hva vi møtte og det vi lærte.
Hvordan vi startet
I «M.Video-Eldorado» finnes det en godt utviklet datamodell: strukturert informasjon med nødvendig lagringsdybde og et stort antall rapporter i fast format (se mer i ). Av disse lager analytikerne enten pivottabeller eller formaterte utsendelser i Excel, eller flotte presentasjoner i PowerPoint for sluttbrukerne.
For omtrent to år siden begynte vi å lage analytiske rapporter i SAP Analysis (en tillegg til Excel, essensielt en pivottabell over OLAP-motoren) i stedet for rapporter i fast format. Men dette verktøyet klarte ikke å dekke behovene til alle brukerne, og de fleste fortsatte å bruke informasjon bearbeidet av analytikere.
Våre sluttbrukere deles inn i tre kategorier:
Topplederne. Be om informasjon på en godt presentert og lettfattelig måte.
Mellomledere, avanserte brukere. De er interessert i datagjennomgang og i stand til å lage rapporter selv når de har de rette verktøyene. Det er de som har blitt nøkkelbrukerne av analytiske rapporter i SAP Analysis.
Massebrukere. De er ikke interessert i selvstendig dataanalyse, og bruker rapporter med begrenset frihet, i format av utsendelser og pivottabeller i Excel.
Vår idé var å dekke behovene til alle brukere og gi dem et enkelt, praktisk verktøy. Vi begynte med toppledelsen. De trengte brukervennlige paneler for analyse av de viktigste forretningsresultatene. Slik startet vi med Tableau og valgte i første omgang to retninger: salgsindikatorer for både detaljhandel og nettbutikk med begrenset dybde og bredde i analysene, som skulle dekke omtrent 80 % av dataene som toppledelsen etterspurte.
Siden brukerne av dashbordene var toppledelsen, oppstod det en ekstra KPI for produktet – responstid. Ingen vil vente 20-30 sekunder mens dataene oppdaterer seg. Navigasjonen måtte være innenfor 4-5 sekunder, helst umiddelbart. Og dette klarte vi dessverre ikke.
Slik så utkastet til vårt hoveddashbord:
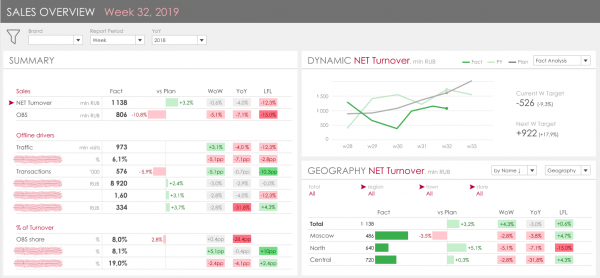
Hovedideen var å samle de viktigste KPI-driverne, som til slutt ble 19, til venstre og presentere deres dynamikk og oppdeling etter hovedattributtene til høyre. Oppgaven virker ikke komplisert, visualiseringen er logisk og forståelig, inntil man dykker inn i detaljene.
Detalj 1. Datamengde
Hovedtabellen for salg for året vår har omtrent 300 millioner rader. Siden vi må reflektere dynamikken fra forrige og året før der, er datamengden bare for faktiske salg omtrent 1 milliard rader. Og separat blir informasjon om planlagte data og blokken for netthandel lagret. Derfor, selv om vi brukte den kolonnedata in-memory DB SAP HANA, var spørringshastigheten for å velge alle indikatorene for en uke fra de nåværende lagrene på farten omtrent 15-20 sekunder. Løsningen på denne oppgaven er åpenbar - ekstra materialisering av data. Men dette har også sine fallgruver, som vi vil gå inn på senere.
Detalj 2. Ikke-additive indikatorer
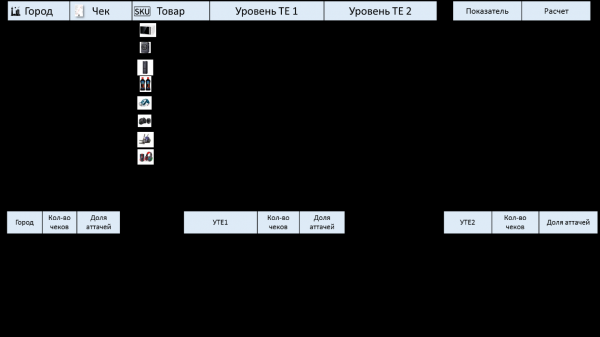
Mange av våre KPI-er er knyttet til antall kvitteringer. Denne indikatoren representerer COUNT DISTINCT av antall rader (overskrifter av kvitteringer) og viser ulike summer avhengig av valgte attributter. For eksempel, hvordan denne indikatoren og dens avledninger bør beregnes:
For å sikre nøyaktige beregninger kan man:
- Utføre beregningen av slike indikatorer i sanntid i lagringen;
- Utføre beregningen på hele datamengden i Tableau, det vil si ved forespørsel i Tableau, levere alle data etter valgte filtre i granulariteten til kvitteringsposisjonene;
- Lag en materialisert visning der alle indikatorer beregnes for alle utvalgsvarianter som gir ulike ikke-additive resultater.
Det er klart at i eksempelet UTE1 og UTE2 er dette attributter for materialet som representerer produkthierarkiet. Dette er ikke noe statisk; gjennom det foregår styring internt i selskapet, ettersom forskjellige produktgrupper styres av ulike ledere. Vi har hatt mange globale revisjoner av dette hierarkiet der alle nivåer har blitt endret, hvor sammenhenger har blitt gjennomgått, samt konstante punktvise endringer når en gruppe flyttes fra en node til en annen. I vanlig rapportering blir alt dette beregnet i sanntid fra materialattributtene, i tilfelle av materialisering av disse dataene er det nødvendig å utvikle en mekanisme for å spore slike endringer og automatisk laste opp historiske data. En temmelig ikke-triviell oppgave.
Detalj 3. Sammenligning av data
Dette punktet ligner på det forrige. Kjerne i saken er at i selskapet ved analyse er det vanlig å danne flere nivåer med sammenligning til forrige periode:
Sammenligning med forrige periode (dag for dag, uke for uke, måned for måned)
I denne sammenligningen antas det at avhengig av den perioden som brukeren velger (for eksempel 33. uke i året), må vi vise utviklingen mot 32. uke. Hvis vi for eksempel velger data for en måned, mai, vil denne sammenligningen vise utviklingen mot april.
Sammenligning med fjoråret
Her er hovedpoenget at når man sammenligner dager og uker, tar man ikke den samme dagen fra året før, altså kan man ikke bare ta inneværende år minus én. Man må se på den sammenlignede uken. Ved sammenligning av måneder må man derimot ta nøyaktig den samme kalenderdagen fra året før. Det er også detaljer med skuddår. I de underliggende databasene er all informasjon distribuert over dager, det finnes ingen separate felt for uker, måneder, eller år. Derfor, for å få et fullstendig analytisk utsnitt i panelet, må man regne med ikke bare én periode, for eksempel en uke, men fire uker, og deretter sammenligne disse dataene for å reflektere dynamikk og avvik. Følgelig kan også denne logikken for sammenligning i dynamikk implementeres enten i Tableau eller på butikkens side. Ja, og vi var selvfølgelig klar over disse detaljene og tenkte på dem allerede i designfasen, men det var vanskelig å forutsi deres innvirkning på ytelsen til det endelige dashbordet.
Ved implementeringen av dashbordet fulgte vi en lang Agile-reise. Vår oppgave var å så raskt som mulig gi et testverktøy med de nødvendige dataene. Derfor arbeidet vi i sprinter og fokuserte på å minimere arbeidet på den nåværende datakilde.
Del 1. Troen på Tableau
For å forenkle IT-støtten og raskt implementere endringer, bestemte vi oss for å gjøre logikken for beregning av ikke-additive indikatorer og sammenligning av tidligere perioder i Tableau.
Trinn 1. Alt live, ingen utvikling av butikkene.
På dette trinnet koblet vi Tableau til de nåværende butikkene og bestemte oss for å se hvordan antallet kvitteringer ville bli beregnet over ett år.
Resultat:
Svaret var nedslående – 20 minutter. Dataoverføring via nettverket, høy belastning på Tableau. Vi forsto at logikken med ikke-additive indikatorer måtte implementeres på HANA. Dette skremte oss ikke mye, vi hadde allerede erfaring med BO og Analysis, og vi visste hvordan vi skulle bygge raske butikker i HANA som gir riktig beregnede ikke-additive indikatorer. Nå gjensto det bare å tilpasse dem til Tableau.
Trinn 2. Tunet butikkene, ingen materialisering, alt skjer på farten.
Vi har laget et separat nytt grensesnitt som dynamisk leverte de nødvendige dataene for TABLEAU. Generelt fikk vi et godt resultat, vi forkjorte tiden for å generere alle nøkkeltall fra en uke til 9-10 sekunder. Og vi forventet ærlig talt at responstiden for dashbordet i Tableau ville være 20-30 sekunder ved første åpning, og deretter, takket være cache, fra 10 til 12 sekunder, noe som ville vært akseptabelt for oss.
Resultat:
Første åpning av dashbordene: 4-5 minutter
Hver klikk: 3-4 minutter
Ingen forventet en så betydelig forbedring i ytelsen til grensesnittet.
Del 2. Fordypning i Tableau
Trinn 1. Analyse av ytelsen til Tableau og rask tuning
Vi begynte å analysere hva Tableau brukte mest tid på. Og for dette finnes det ganske gode verktøy, noe som selvfølgelig er en fordel med Tableau. Den største utfordringen vi identifiserte, var de meget kompliserte SQL-spørringene som Tableau genererte. Disse var først og fremst knyttet til:
— transponering av data. Siden Tableau ikke har verktøy for å transponere dataset, måtte vi lage en tabell ved hjelp av case for å bygge den venstre delen av dashbordet med en detaljert fremstilling av alle KPI-ene. Størrelsen på SQL-spørringene i databasen nådde 120 000 tegn.
— valg av tidsperiode. En slik spørring på databasenivå tok lengre tid å kompilere enn å utføre:
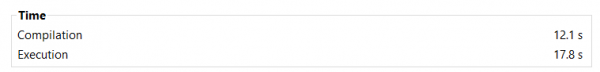
Det vil si at behandlingstiden for forespørselen var 12 sekunder + 5 sekunder for utførelse.
Vi bestemte oss for å forenkle logikken for beregningene på Tableau sin side og flytte en annen del av beregningene til grensesnittet og database nivå. Dette ga gode resultater.
Først gjorde vi transponeringen dynamisk, ved å bruke full outer join på det siste trinnet i beregningen av VIEW, i henhold til tilnærmingen beskrevet på wiki og .
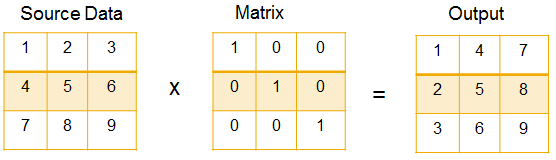
Så vi lagde en innstillingsmatrise – en transponeringsmatrise (21x21) og fikk alle indikatorene fordelt på rader.
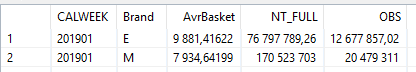
Var:
Ble:
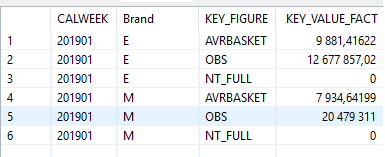
Selve transposeeringen av databasen tar nesten ingen tid. Forespørselen om alle indikatorer for uken ble fortsatt behandlet på omtrent 10 sekunder. Men fleksibiliteten i oppbyggingen av dashbordet for spesifikke indikatorer gikk tapt, det vil si for den høyre delen av dashbordet hvor dynamikken og detaljert inndeling av en spesifikk indikator ble presentert, ble lagret tidligere på 1-3 sekunder, da forespørselen gikk på én indikator, men nå valgte databasen alltid ut alle indikatorene og filtrerte resultatet før det ble returnert til Tableau.
Som et resultat har hastigheten på dashbordet blitt redusert nesten tre ganger.
Resultat:
- 5 sek — parsing av dashbordet, visualiseringer
- 15-20 sek — forberedelse til kompilering av forespørslene med utføring av forberegninger i Tableau
- 35-45 sek — kompilering av SQL-forespørslene og parallell-sekvensiell utførelse i Hana
- 5 sek — behandling av resultater, sortering, oppregning av visualiseringer i Tableau
- Selvfølgelig var ikke slike resultater tilfredsstillende for virksomheten, og vi fortsatte å optimalisere.
Trinn 2. Minst logikk i Tableau, full materialisering
Vi forsto at det ville være umulig å lage et dashbord med responstid på noen sekunder når vinduet fungerer i 10 sekunder, og vi vurderte alternativer for materialisering av data på databasesiden spesifikt for det aktuelle dashbordet. Men vi støtte på et globalt problem, beskrevet ovenfor – ikke-additive indikatorer. Vi klarte ikke å gjøre det slik at Tableau fleksibelt kunne bytte mellom forskjellige vinduer og nivåer, forhåndsberegnet for forskjellige varehierarkier (i eksemplet danner tre forespørsel uten UTE, med UTE1 og UTE2 forskjellige resultater). Derfor besluttet vi å forenkle dashbordet, gi avkall på varehierarkiet i dashbordet og se hvor raskt det kan bli i en forenklet versjon.
Så, i dette siste trinnet samlet vi et eget lager, hvor vi la alle KPI-ene i transponert form. På databasesiden behandler enhver forespørsel til et slikt lager på 0,1 – 0,3 sekunder. I dashbordet fikk vi følgende resultater:
Første åpning: 8-10 sekunder
Enhver klikk: 6-7 sekunder
Tiden som Tableau bruker, består av:
- 0,3 sek — parsing av dashbordet og kompilering av SQL-forespørslene
- 1,5-3 sek — utførelse av SQL-forespørslene i Hana for hovedvisualiseringene (kjøres parallelt med p.1)
- 1,5-2 sek — rendering, omregning av visualiseringer
- 1,3 sek — utføring av ekstra SQL-spørringer for å hente relevante verdier fra filtre (Merke, Divisjon, By, Butikk), parsing av resultater
Om vi skal oppsummere kort
Vi likte verktøyet Tableau med tanke på visualisering. I designfasen vurderte vi ulike visualiseringselementer, og vi fant dem alle i bibliotekene, inkludert komplekse flernivåsegmenteringer og multidrivende waterfall.
Når vi implementerte dashboards med viktige salgsindikatorer, støtte vi på ytelsesproblemer som vi ikke har klart å overkomme ennå. Vi brukte over to måneder og fikk et funksjonelt ufullstendig dashboard, hvor responstiden er på kanten av akseptabelt. Og vi har konkludert:
- Tableau klarer ikke å jobbe med store datamengder. Hvis du har mer enn 10 GB data i den opprinnelige datamodellen (ca. 200 millioner x 50 rader), blir dashboardet betydelig tregere – fra 10 sekunder til flere minutter per klikk. Vi eksperimenterte både med live-tilkobling og med eksektrakter. Ytelsen var sammenlignbar.
- Begrensninger ved bruk av flere datakilder (datasett). Det er ikke mulig å angi forholdet mellom datasettene ved standardmetoder. Hvis man bruker omveier for å koble sammen datasett, vil dette ha stor innvirkning på ytelsen. I vårt tilfelle vurderte vi alternativet med å materialisere data i hver nødvendig skive av presentasjoner, og at man skulle gjøre bytter på disse materialiserte datasettene med bevaring av tidligere valgte filtre – noe som viste seg å være umulig i Tableau.
- I Tableau er det ikke mulig å lage dynamiske parametre. Du kan ikke fylle en parameter som brukes til å filtrere datasettet i ekstraktet eller ved live-tilkobling med resultatet av et annet utvalg fra datasettet eller resultatet av en annen SQL-spørring, bare brukerens native inndata eller konstant.
- Begrensninger knyttet til bygging av dashboards med OLAP-elementer | Pivot-tabeller.
I MSTR, SAP SAC, SAP Analysis, hvis du legger til et datasett i rapporten, er alle objektene knyttet til hverandre som standard. Dette er ikke tilfelle i Tableau, der må du sette opp forbindelsen manuelt. Dette er kanskje mer fleksibelt, men for alle våre dashbord er det et krav til elementene – derfor medfører det ekstra arbeidskostnader. Videre, hvis du lager relaterte filtrer slik at for eksempel listen over byer begrenses til bare byene i den valgte regionen, vil du straks oppleve sekvensielle spørringer til databasen eller ekstrakten, noe som merkerbart reduserer hastigheten på dashbordet. - Begrensninger i funksjoner. Verken på ekstrakten eller ikke minst på datasettet fra Live-connect kan du utføre storskala transformasjoner. Dette kan gjøres via Tableau Prep, men det medfører ekstra arbeidskostnader og enda et verktøy som må læres og vedlikeholdes. Du kan for eksempel ikke transponere data eller gjøre en join med seg selv. Dette blir begrenset gjennom transformasjoner på individuelle kolonner eller felt, som må velges via case eller if, noe som gir svært komplekse SQL-spørringer hvor databasen bruker mesteparten av tiden på å kompilere tekstspørringen. Disse begrensningene i verktøyet måtte adresseres på nivået av vitrinene, noe som fører til mer kompliserte lagringsløsninger, ekstra belastninger og transformasjoner.
Vi har ikke avskrevet Tableau. Men som et verktøy som kan bygge industrielle dashbord og som et middel for å erstatte og digitalisere hele selskapets rapporteringssystem, vurderer vi ikke Tableau.
Vi jobber nå aktivt med å utvikle et tilsvarende dashbord i et annet verktøy, samtidig som vi prøver å se på arkitekturen til dashbordet i Tableau for å forenkle den ytterligere. Hvis dette interesserer samfunnet, vil vi dele resultatene.
Vi venter også på deres idéer eller råd om hvordan man kan bygge raske dashbord i Tableau med så store datamengder, ettersom vi har vår egen nettside, hvor dataene er mye større enn i detaljhandelen.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish