

Utsendelsen av databasen Redis 8.4, som tilhører klassen NoSQL-systemer, er nå offentliggjort. Redis tilbyr funksjoner for lagring av data i nøkkel/verdi-format, utvidet med støtte for strukturerte dataformater som lister, hash og sett, samt muligheten til å kjøre skripter på serversiden skrevet i Lua. Prosjektkoden er skrevet i C og distribueres under AGPLv3-lisensen.
Databasen Redis støtter transaksjoner som lar deg utføre en gruppe kommandoer i ett trinn, og garanterer konsistens og sekvens (kommandoer fra andre forespørsel kan ikke blande seg inn) i utførelsen av et givent sett med kommandoer, samt tillater tilbaketrekking av endringer i tilfelle problemer. Alle data buffers i sin helhet i RAM. Klientbiblioteker er tilgjengelige for de fleste populære språk, inkludert Perl, Python, PHP, Java, Ruby og Tcl.
For databehandling tilbys kommandoer som inkrementering/dekrementering, standardoperasjoner for lister og sett (forening, skjæring), omdøping av nøkler, flerfaglige utvalg og sorteringsfunksjoner. To lagringsmoduser støttes: periodisk synkronisering av data til disk og vedlikehold av en logger for endringer på disk. I det andre tilfellet garanteres full bevaring av alle endringer. Det er mulig å organisere master-slave datamatching for flere servere, utført i ikke-blokkerende modus. Det er også tilgjengelig en meldingsutvekslingsmodus for «publisering/abonnement», der det opprettes en kanal hvor meldinger distribueres til abonnenter.
Nøkkelendringer i Redis 8.4:
- Det er lagt til en kommando «FT.HYBRID» med implementering av hybrid søk som kombinerer mulighetene for fulltekstsøk og vektorsøk i en enkelt forespørsel, og tar hensyn til både direkte treff og semantisk nærhet. Muligheter for aggregering av resultater støttes med syntaks som den for kommandoen «FT.AGGREGATE».
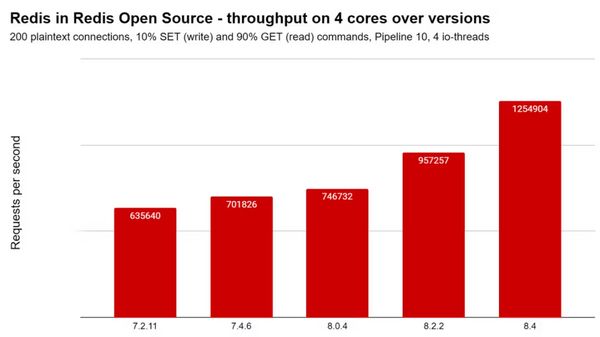
- Gjennomstrømningsevnen i typiske Redis-applikasjoner for caching er forbedret. For eksempel, med belastninger som inkluderer 10% skriveoperasjoner (SET) og 90% leseoperasjoner (GET) med lagring av strengverdier på 1 KB, økte gjennomstrømningen med 30%.

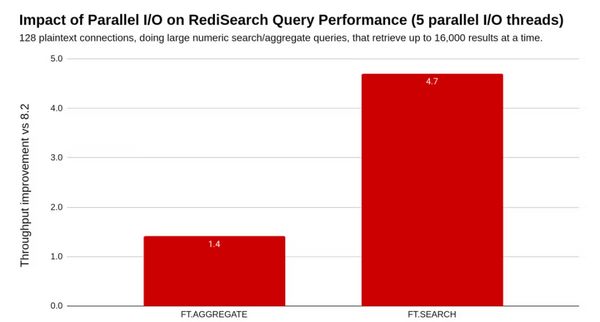
- Yttra til søk (FT.SEARCH) og aggregering av resultater (FT.AGGREGATE) har blitt forbedret. I belastede systemer med et høyt antall parallelle forespørselene er det registrert økning i båndbredde og reduksjon i latens med opptil 4,7 ganger under søk og opptil 1,4 ganger under aggregasjon av resultater.

- Optimalisering av minneallokering under forespørselene er gjennomført, og det er nå mulig å tilpasse oppførselen ved uttømming av tilgjengelig minne (OOM, out-of-memory).
- Minneforbruket har blitt redusert ved lagring av små strenger (opptil 7 byte) i JSON-strukturer. For eksempel, et JSON-array med 500 små elementer i nøkkel/verdi-format bruker nå 37 % mindre minne.
- Effektiviteten ved lagring av numeriske JSON-arrayer, der alle elementene har samme type, har blitt forbedret (tidligere ble både type og verdi lagret for hvert element, mens nå typen lagres én gang for hele arrayet). I tester har slike arrayer med en million homogene elementer nå et minnebehov som er 50-92 % lavere, avhengig av type.
- Kommandoen SET har fått alternativene IFEQ, IFNE, IFDEQ og IFDNE, som tillater å oppdatere en strengenøkkel med kun én kommando i situasjoner der tilknyttede verdier ikke er endret av en annen klient siden de ble hentet.
- Kommandoen XDELEX har blitt lagt til for atomisk sletting av en strengenøkkel hvis den tilknyttede verdien ikke har blitt endret siden den ble hentet.
- Kommandoen DIGEST er lagt til, som returnerer en hash av verdien knyttet til den angitte nøkkelen.
- I kommandoen XREADGROUP er alternativet «CLAIM » lagt til for å lese både ventende (idle pending) og mottatte (incoming) meldinger.
- Kommandoen MSETEX er lagt til for atomisk oppsett eller oppdatering av flere strengenøkler samtidig, samt oppdatering av levetiden deres.
- Det er introdusert en mekanisme for atomisk migrering av slotter mellom klusterknuter (ASM — Atomic Slot Migration), lik total synkron replikasjon, men fungerer på nivået til individuelle datalagringsslotter. Kommandoen CLUSTER MIGRATION er lagt til, som gjør det mulig å importere slotter fra andre noder, spore fremdriften av migreringen og i nødvendige tilfeller markere ventende migrasjonsoperasjoner.
- Team CLUSTER SLOT-STATS has been added for evaluating statistics in the cluster for individual slots, such as the number of keys, CPU load, and network I/O.
Kilde: opennet.ru

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish