

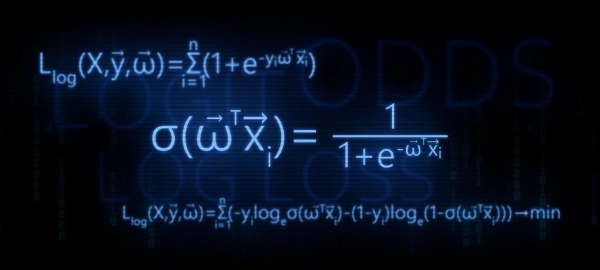
I denne artikkelen vil vi gå gjennom de teoretiske utledningene av transformasjonen funksjonen for lineær regresjon i den inverse logit-transformasjonen (ellers kjent som logit-responsfunksjonen). Deretter, ved hjelp av arsenalet metoden for maksimalt sannsynlighet, i samsvar med modellen for logistisk regresjon, vil vi utlede tapfunksjonen Logistic Loss, eller med andre ord, vi vil definere funksjonen som brukes til å tilpasse parameterne i vektvektoren i modellen for logistisk regresjon  .
Plan for artikkelen:
- La oss repetere den lineære avhengigheten mellom to variabler
- Vi vil avdekke behovet for transformasjonen funksjonen for lineær regresjon
 i logit-responsfunksjonen
- Vi vil gjennomføre transformasjoner og utlede logit-responsfunksjonen
- La oss prøve å forstå hva som er galt med minste kvadraters metode for å tilpasse parametrene functions Logistic Loss
- Bruker metoden for maksimalt sannsynlighet for å fastslå parameterjusteringsfunksjonene :
5.1. Tilfelle 1: funksjonen Logistic Loss for objekter med klassebetegnelser 0 og 1:
5.2. Tilfelle 2: funksjonen Logistic Loss for objekter med klassebetegnelser -1 og +1:
 i logit-responsfunksjonen

 functions Logistic Loss
 :


Artikkelen inneholder en rekke enkle eksempler der alle beregningene lett kan utføres muntlig eller på papir; i enkelte tilfeller kan en kalkulator være nødvendig. Så vær forberedt 🙂
Denne artikkelen er i stor grad rettet mot datavitere med grunnleggende kunnskaper om maskinlæring.
Artikkelen vil også inkludere kode for å tegne diagrammer og beregninger. All kode er skrevet i python 2.7. Jeg vil på forhånd forklare om «nyheten» til den brukte versjonen - dette er et av kravene for å ta det kjente kurset fra Yandex på den ikke mindre kjente nettplattformen for online utdanning Coursera, og som man kan forvente, er materialet forberedt med utgangspunkt i dette kurset.
01. Lineær avhengighet
Det er helt rimelig å stille spørsmålet - hva har lineær avhengighet og logistisk regresjon med hverandre å gjøre?
Det er enkelt! Logistisk regresjon er en av modellene som tilhører den lineære klassifikatoren. Enkelt sagt, oppgaven til en lineær klassifikator er å forutsi målverdier  fra variabler (regressorer)
 . Det antas at det er en avhengighet mellom trekkene
 og målverdiene
 som er lineær. Derav navnet på klassifikatoren - lineær. Hvis vi skal oppsummere veldig grovt, hviler modellen for logistisk regresjon på antagelsen om en lineær avhengighet mellom trekkene
 og målverdiene
 . Der har vi forbindelsen.
I studio er det første eksemplet, og det handler, riktig nok, om den lineære avhengigheten til de undersøkte størrelsene. Under forberedelsene til artikkelen kom jeg over et eksempel som mange allerede har hørt om — avhengigheten av strømstyrken fra spenningen. («Praktisk regresjonsanalyse», N. Draper, G. Smith). Her vil vi også se på det.
I samsvar med ohms lov:
 , hvor
 — strømstyrke,
 — spenning,
 — motstand.
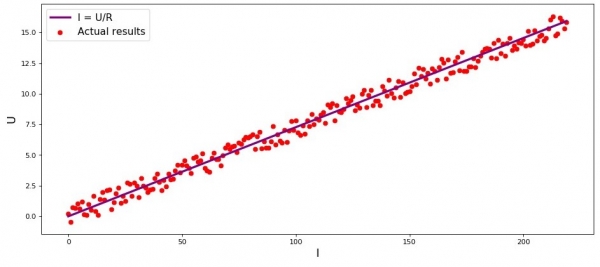
Hvis vi ikke visste ohms lov, kunne vi finne avhengigheten empirisk ved å variere  og måle
 , mens vi holder
 fast. Da ville vi sett at grafen for avhengigheten
 fra
 gir en mer eller mindre rett linje som går gjennom origo. Vi sa «mer eller mindre», fordi selv om avhengigheten faktisk er nøyaktig, kan målingene våre inneholde små feil, og derfor vil punktene på grafen kanskje ikke ligge strengt på linjen, men være tilfeldig spredt rundt den.
Graf 1 «Avhengighet  fra
 »
Kode for å tegne grafen
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i + random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize=(14,6), dpi=80)
plt.plot(x_line, y_line, color='purple', lw=3, label='I = U/R')
plt.scatter(x_line, y_dot, color='red', label='Faktiske resultater')
plt.xlabel('I', size=16)
plt.ylabel('U', size=16)
plt.legend(prop={'size':14})
plt.show()
02. Behovet for transformasjoner av lineær regresjonsligning
La oss se på et annet eksempel. Forestill deg at vi jobber i en bank og står overfor oppgaven med å bestemme sannsynligheten for at en låntaker tilbakebetaler lånet avhengig av noen faktorer. For å forenkle oppgaven, vurderer vi bare to faktorer: den månedlige lønnen til låntakeren og månedlig betaling for tilbakebetaling av lånet.
Oppgaven er meget hypotetisk, men med dette eksemplet vil vi kunne forstå hvorfor det å bruke funksjonen for lineær regresjon, ikke er tilstrekkelig, og vi vil også finne ut hvilke transformasjoner som kreves av funksjonen.
La oss gå tilbake til eksempelet. Det er forstått at jo høyere lønn, jo mer kan låntakeren månedlig bruke på å tilbakebetale lånet. For et bestemt lønnsspenn vil denne avhengigheten være ganske lineær. La oss for eksempel ta et lønnsspenn fra 60.000R til 200.000R og anta at i det angitte lønnsspenn er sammenhengen mellom månedlig betaling og lønn lineær. Anta at det for det spesifiserte lønnsspennet er avdekket at forholdet mellom lønn og betaling ikke kan være mindre enn 3, og at låntakeren må ha 5.000R til overs. Bare da vil vi anse at låntakeren vil tilbakebetale lånet til banken. Da tar ligningen for lineær regresjon form:

der  ,
 ,
 ,
 — lønn
 til låntakeren,
 — betalingen på lånet
 til låntakeren.
Ved å sette inn lønn og betaling på lånet med faste parametere  kan man ta beslutning om å gi eller avslå lånet.
For å forutspreke, la oss merke oss at, ved de gitte parameterne  den lineære regresjonsfunksjonen, brukt i logistisk respons-funksjon vil gi store verdier som vil vanskeliggjøre beregningene av tilbakebetalingsprobabilitetene. Derfor foreslås det å redusere våre koeffisienter med, la oss si, 25.000 ganger. Denne transformasjonen i koeffisientene vil ikke endre beslutningen om å gi lån. La oss huske på dette til senere, men nå, for å gjøre det enda tydeligere hva vi snakker om, la oss vurdere situasjonen med tre potensielle låntakere.
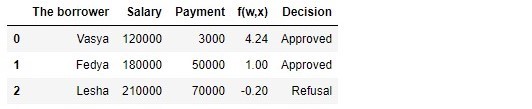
Tabell 1 «Potensielle låntakere»
Kode for å lage tabellen
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'The borrower':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Salary':np.array([120000,180000,210000]),
       'Payment':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Salary']*w_1 + df['Payment']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Approved'
        decision.append(dec)
    else:
        dec = 'Refusal'
        decision.append(dec)

df['Decision'] = decision

df[['The borrower', 'Salary', 'Payment', 'f(w,x)', 'Decision']]
I henhold til dataene i tabellen ønsker Vasja, med en lønn på 120.000R, å få et lån som han kan tilbakebetale med 3.000R månedlig. Vi har fastslått at for å godkjenne lånet må Vasjas lønn være tre ganger høyere enn betalingene, i tillegg til at han må ha 5.000R til overs. Vasja oppfyller dette kravet:  . Det blir til og med 106.000R. Til tross for at vi har redusert koeffisientene
 med 25.000 ganger, fikk vi det samme resultatet — lånet kan bli godkjent. Fedya vil også få lånet, mens Lesha, til tross for at han tjener mest, må dempe sine appetitter.
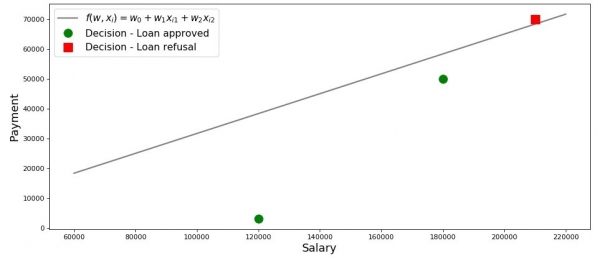
 La oss tegne en graf i dette tilfellet.
Graf 2 «Klassifisering av låntakere»
Kode for å tegne grafen
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize = (14,6), dpi = 80) plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color ='green', markersize = 12, label = 'Decision - Lånet godkjent') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color = 'red', markersize = 12, label = 'Decision - Lånet avslått') plt.xlabel('Lønn', size = 16) plt.ylabel('Betaling', size = 16) plt.legend(prop = {'size': 14}) plt.show()
Så, vår linje, konstruert i henhold til funksjonen, skiller de «dårlige» låntakerne fra de «gode». De låntakerne som har ønsker som ikke samsvarer med mulighetene, ligger over linjen (Lesha), mens de som ifølge parametrene i modellen vår kan betale tilbake lånet, ligger under linjen (Vasya og Fedya). Med andre ord, vår linje deler låntakere i to klasser. La oss definere dem som følger: til klassen  henfører vi de låntakerne som sannsynligvis vil betale tilbake lånet, til klassen
 henfører vi de låntakerne som sannsynligvis ikke vil kunne betale tilbake lånet.
 eller
 La oss oppsummere funnene fra dette enkle eksemplet. Ta et punkt
og ved å sette inn koordinatene til punktet i den relevante likningen for linjen  , vurder tre alternativer:
 Hvis punktet ligger under linjen, og vi tilordner det til klassen
- , vil funksjonsverdien være positiv fra . Det betyr at vi kan si at sannsynligheten for å betale tilbake lånet ligger innenfor til . Jo større funksjonsverdi, jo høyere sannsynlighet. Hvis punktet ligger over linjen og vi tilordner det til klassen
- , vil funksjonsverdien være negativ fra eller . Da vil vi si at sannsynligheten for å tilbakebetale gjelden ligger innenfor til , og jo større i modul verdien av funksjonen, jo mer sikkerhet har vi. Punktet ligger på linjen, på grensen mellom de to klassene. I så fall vil funksjonsverdien
- være lik og sannsynligheten for å tilbakebetale lånet er lik Nå, forestill deg at vi ikke har to faktorer, men titalls, låntakere ikke tre, men tusen. Da vil vi i stedet for en linje ha .
 være positiv fra
 . Det betyr at vi kan si at sannsynligheten for å betale tilbake lånet ligger innenfor
 til
 . Jo større funksjonsverdi, jo høyere sannsynlighet.
 Hvis punktet ligger over linjen og vi tilordner det til klassen
 eller
 . Da vil vi si at sannsynligheten for å tilbakebetale gjelden ligger innenfor
 til
 , og jo større i modul verdien av funksjonen, jo mer sikkerhet har vi.
 Punktet ligger på linjen, på grensen mellom de to klassene. I så fall vil funksjonsverdien
 og sannsynligheten for å tilbakebetale lånet er lik
 Nå, forestill deg at vi ikke har to faktorer, men titalls, låntakere ikke tre, men tusen. Da vil vi i stedet for en linje ha
 .
Nå, la oss forestille oss at vi ikke har to faktorer, men titalls, og at låntakerne ikke er tre, men tusen. Da vil vi i stedet for en direkte ... m-metrisk plan og koeffisienter  Vi vil ikke ta dem fra luften, men utlede dem etter alle regler, basert på akkumulerte data om låntakere som har betalt eller ikke betalt tilbake lånet. Og merk deg, vi velger nå låntakere med allerede kjente koeffisienter.
 Egentlig er oppgaven til den logistiske regresjonsmodellen nettopp å bestemme parametrene
 hvor verdien av tapsfunksjonen Logistic Loss vil strebe etter å være minimal. Men hvordan vektoren
 beregnes, vil vi få vite i det 5. avsnittet av artikkelen. Men la oss nå komme tilbake til vårt lovede land — til vår bankmann og tre av hans kunder.
deployDump  Vi vet hvem vi kan gi lån til, og hvem vi må si nei til. Men med slik informasjon kan vi ikke gå til direktøren, for de ønsket å få sannsynligheten for tilbakebetaling av lån for hver låntaker. Hva skal vi gjøre? Svaret er enkelt — vi må på en eller annen måte transformere funksjonen
 hvis verdier ligger i området
 til en funksjon der verdiene vil ligge i området
 . Og en slik funksjon eksisterer, den kalles logistisk responsfunksjon eller logit-transformasjon.La oss se på:

La oss se trinnvis hvordan logistisk responsfunksjon oppnås.Merk at vi vil gå i motsatt retning, det vil si at vi antar at vi vet sannsynlighetsverdien som ligger mellom  til
 og videre vil vi 'rulle ut' denne verdien til hele mengden av tall fra
 til
 .
03. Vi utleder den logistiske responsfunksjonen.
Trinn 1. La oss konvertere sannsynlighetsverdiene til området

I løpet av funksjonstransformasjonen  i logit-responsfunksjonen
 lar vi vår kredittanalytiker være i fred, og i stedet går vi til bookmakers. Nei, selvsagt vil vi ikke plassere innsatser, alt vi er interessert i der, er betydningen av uttrykket, for eksempel sjansen 4 til 1. Odds, kjent av alle spillere som gjør innsatser, er forholdet mellom 'succeser' og 'feil'. Fra sannsynlighets synspunkt er odds sannsynligheten for at en hendelse inntreffer delt på sannsynligheten for at hendelsen ikke skjer. La oss skrive formelen for sjansen for at hendelsen inntreffer
 :

, hvor  — sannsynligheten for at hendelsen inntreffer,
 — sannsynligheten for at hendelsen IKKE inntreffer
For eksempel, hvis sannsynligheten for at en ung, sterk og livlig hest kalt 'Vintervind' overgår en gammel og slapp dame ved navn 'Matilda' er  , så sjansene for suksess til «Vetek» vil være
 til

 og omvendt, ved å kjenne sjansene, vil det ikke være vanskelig å beregne sannsynligheten
 :

Dermed har vi lært hvordan vi «oversetter» sannsynlighet til sjanser, som tar verdier fra  til
 . La oss ta enda et skritt og lære å «oversette» sannsynlighet til hele den numeriske linjen fra
 til
 .
Trinn 2. Vi vil oversette sannsynlighetsverdier til området

Dette trinnet er veldig enkelt – vi logaritmerer sjansene med grunnlag på Eulers tall  og får:

Nå vet vi at hvis  , så vil det være veldig enkelt å beregne verdien
 og dessuten, det burde være positivt:
 . Så er det.
Til vår nysgjerrighet, la oss sjekke, at hvis  , da forventer vi å se en negativ verdi
 . Sjekker vi:
 . Alt er korrekt.
Nå vet vi hvordan vi oversetter sannsynlighetsverdien fra  til
 til hele den numeriske linjen fra
 til
 . I neste trinn vil vi gjøre alt motsatt.
Men først, la oss merke oss at i henhold til reglene for logaritmering, ved å kjenne verdien av funksjonen  , kan vi beregne sjansene:

Denne måten å definere sjanser på, vil komme til nytte i neste trinn.
Trinn 3. Vi skal utlede en formel for å bestemme

Så vi har lært, ved å kjenne  , å finne verdiene til funksjonen
 . Men faktisk trenger vi det helt motsatte – ved å kjenne verdien
 finnes
 . For dette vil vi referere til begrepet om den inverse sjansefunksjonen, i henhold til hvilken:

I artikkelen vil vi ikke utlede den nevnte formelen, men vi vil sjekke med tallene fra eksempelet ovenfor. Vi vet at når sjansene er 4 til 1 ( ), er sannsynligheten for at hendelsen inntreffer 0.8 (
 ). La oss gjøre erstatningen:
 . Dette samsvarer med våre tidligere beregninger. La oss gå videre.
I forrige trinn utledet vi at  , så vi kan gjøre en erstatning i den inverse sjansefunksjonen. Vi får:

La oss dele både teller og nevner med  , så:

For enhver brann, for å forsikre oss om at vi ikke har gjort noen feil, la oss gjøre en liten kontroll til. I trinn 2 bestemte vi for  at
 . Så, ved å sette verdien
 inn i den logistiske responsfunksjonen, forventer vi å få
 . Vi setter inn og får:

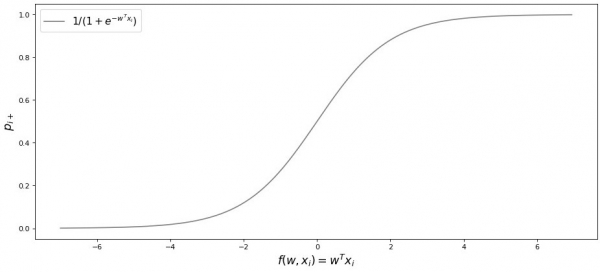
Gratulerer, kjære leser, vi har nettopp utledet og testet den logistiske responsfunksjonen. La oss se på grafen til funksjonen.
Graf 3 «Logistisk responsfunksjon»
salary = np.arange(60000,240000,20000) payment = (-w_0-w_1*salary)/w_2fig, axes = plt.subplots(figsize = (14,6), dpi = 80) plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$') plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color ='green', markersize = 12, label = 'Decision - Lånet godkjent') plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color = 'red', markersize = 12, label = 'Decision - Lånet avslått') plt.xlabel('Lønn', size = 16) plt.ylabel('Betaling', size = 16) plt.legend(prop = {'size': 14}) plt.show()
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
I litteraturen kan man også møte denne funksjonen som sigmoidfunksjon. Grafen viser tydelig at hovedendringen i sannsynligheten for at et objekt tilhører en klasse skjer over et relativt smalt intervall  , et sted fra
 til
 .
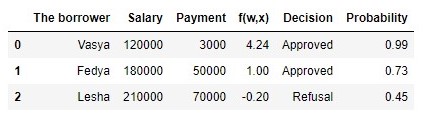
La oss gå tilbake til vår kredittanalytiker og hjelpe ham med å beregne sannsynligheten for kredittbetaling, ellers risikerer han å miste bonusen 🙂
Tabell 2 «Potensielle låntakere»
Kode for å lage tabellen
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Probability'] = proba

df[['Låntakeren', 'Lønn', 'Betaling', 'f(w,x)', 'Beslutning', 'Sannsynlighet']]
Dermed har vi bestemt sannsynligheten for kredittilbakebetaling. Generelt sett virker dette rimelig.
Faktisk er sannsynligheten for at Vasja, med en lønn på 120.000R, kan betale 3.000R til banken hver måned, nær 100%. For øvrig må vi huske at banken kan gi lån til Ljosha, hvis bankens retningslinjer tillater å kreditere kunder med en sannsynlighet for tilbakebetaling som overstiger 0.3. I så fall vil banken sette av større reserver for mulige tap.
Det er også verdt å merke seg at forholdet mellom lønn og betaling på minst 3 og med en reserve på 5.000R ble valgt noe tilfeldig. Derfor kunne vi ikke bruke vektoren av vekter i sin opprinnelige form  . Vi måtte sterkt redusere koeffisientene, så vi delte hver koeffisient med 25.000, som i praksis tilpasset resultatet. Men dette ble gjort bevisst for å forenkle forståelsen av materialet i begynnelsen. I virkeligheten må vi ikke finne på eller tilpasse koeffisientene, men finne dem. I de følgende seksjonene av artikkelen vil vi utvikle ligninger som brukes til å tilpasse parametrene
 .
04. Metoden for minste kvadrater ved bestemme vekter i logistikfunksjonen
 i logistikfunksjonen
Vi kjenner allerede en slik metode for finjustering av vektene  , som metoden for minste kvadrater (MNK) og hvorfor skulle vi ikke bruke den i oppgaver med binær klassifisering? Faktisk er det ingenting som hindrer å bruke MKN, men denne metoden gir mindre nøyaktige resultater i klassifiseringsoppgaver enn Logistic Loss. Dette har et teoretisk grunnlag. La oss først se på et enkelt eksempel.
La oss anta at modellene våre (som bruker MSE og Logistic Loss) allerede har begynt å tilpasse vektvektoren,  og vi stoppet beregningen på et eller annet trinn. Det spiller ingen rolle om det er i midten, på slutten eller i begynnelsen, det viktigste er at vi allerede har noen verdier for vektvektoren, og la oss si at ved dette trinnet, vektvektorene
 for begge modellene ikke har forskjeller. Da tar vi de oppnådde vektene og setter dem inn i logit-responsfunksjonen (
 ) for et objekt som tilhører klassen
 . Vi undersøker to tilfeller der modellen vår gjør en stor feil i henhold til den tilpassede vekten, og motsatt – modellen er veldig sikker på at objektet tilhører klassen
 . La oss se hvilke straffer som vil bli «utskrevet» ved bruk av MKN og Logistic Loss.
Koden for å beregne straffer avhengig av den brukte tapfunksjonen
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Tilfellet med en grov feil – modellen tilskriver objektet til klassen  med en sannsynlighet på 0,01
Straffen ved bruk av MKN vil være:

Straffen ved bruk av Logistic Loss vil være:

Tilfellet med sterk sikkerhet – modellen tilskriver objektet til klassen  med en sannsynlighet på 0,99
Straffen ved bruk av MKN vil være:

Straffen ved bruk av Logistic Loss vil være:

Dette eksempelet illustrerer godt at ved en grov feil straffer tapfunksjonen Log Loss modellen betydelig sterkere enn MSE. La oss nå undersøke hvilke teoretiske forutsetninger som ligger til grunn for bruk av tapfunksjonen Log Loss i klassifiseringsoppgaver.
05. Metoden for maksimal sannsynlighet og logistisk regresjon
Som lovet i begynnelsen, er artikkelen full av enkle eksempler. I studioet er det et nytt eksempel og gamle gjester – banklåntakere: Vasja, Fedya og Lesha.
For å være på den sikre siden, før vi utvikler eksempelet, minner jeg om at i virkeligheten har vi med et treningssett bestående av tusenvis eller millioner av objekter med dusinvis eller hundrevis av trekk. Men her er tallene valgt slik at de lett kan forstås av en nybegynner datavitenskapsmann.
Vi vender tilbake til eksempelet. La oss si at banksjefen bestemte seg for å gi lån til alle som trenger det, til tross for at algoritmen indikerte at Ljoha ikke burde få det. Og nå har det gått tilstrekkelig med tid, og vi har fått vite hvem av de tre heltene som har betalt tilbake lånet og hvem som ikke har. Som forventet: Vassya og Fedya har betalt tilbake lånet, men Ljoha har ikke. Nå la oss forestille oss at dette resultatet blir vår nye treningsdatasett, og samtidig virker det som om all informasjon om faktorene som påvirker sannsynligheten for lånebetaling (låntakers lønn, beløp av månedlig betaling) har forsvunnet. Intuitivt kan vi anta at enhver tredje låntaker ikke returnerer lånet til banken, eller med andre ord, sannsynligheten for at dette skjer med den neste låntakeren  . Denne intuitive antagelsen har teoretisk støtte og er basert på metoden for maksimal sannsynlighet, ofte kjent i litteraturen som prinsippet for maksimal sannsynlighet.
La oss først bli kjent med begrepsapparatet.
Sannsynligheten for utvalget er sannsynligheten for å få nettopp dette utvalget, for å oppnå nettopp disse observasjonene/resultatene, det vil si produktet av sannsynlighetene for å oppnå hvert av resultatene i utvalget (for eksempel om Vassya, Fedya og Ljoha har betalt tilbake lånet samtidig).
Sannsynlighetsfunksjonen knyter sannsynligheten for utvalget til verdiene til parametrene i fordelingen.
I vårt tilfelle representerer treningsdatasettet en generalisert Bernoulli-prosess, der den tilfeldige variabelen har to mulige verdier:  eller
 . Følgelig kan sannsynligheten for utvalget skrives som en sannsynlighetsfunksjon av parameteren
 på følgende måte:


Den ovenfor nevnte oppstillingen kan tolkes som følger. Den felles sannsynligheten for at Vassya og Fedya betaler tilbake lånet er  , sannsynligheten for at Ljoha IKKE betaler tilbake lånet er
 (siden det faktisk var IKKE tilbakebetaling av lånet), følgelig er den felles sannsynligheten for alle tre hendelsene
 .
Metoden for maksimal sannsynlighet er en metode for å estimere en ukjent parameter ved å maksimere sannsynlighetsfunksjonen. I vårt tilfelle må vi finne en slik verdi  , der
 når sitt maksimum.
Hvor kommer ideen fra – å søke verdien av en ukjent parameter der sannsynlighetsfunksjonen når sitt maksimum? Ideen stammer fra forståelsen av at utvalget er den eneste tilgjengelige kilden til kunnskap om den underliggende befolkningen. Alt vi vet om befolkningen er representert i utvalget. Derfor kan vi si at utvalget er den mest nøyaktige refleksjonen av populasjonen som er tilgjengelig for oss. Følgelig trenger vi å finne en parameter der det eksisterende utvalget blir mest sannsynlig.
Det er åpenbart at vi har med et optimaliseringsproblem å gjøre, der vi må finne ekstremalpunktet til funksjonen. For å finne ekstremalpunktet, må vi vurdere førsteordensbetingelsen, det vil si sette den deriverte av funksjonen lik null og løse ligningen med hensyn til den ukjente parameteren. Men jakten på den deriverte av produktet av mange faktorer kan vise seg å være en tidkrevende affære, for å unngå dette finnes det en spesiell teknikk – å gå til logaritmen. sannsynlighetsfunksjonen. Hvorfor er en slik overgang mulig? La oss merke oss at vi ikke leter etter selve ekstremum av funksjonen , men etter ekstremalpunktet, det vil si den verdien den ukjente parameteren
 , der
 når maksimalt. Ved å gå til logaritmen endres ikke ekstremalpunktet (selv om selve ekstremum vil være forskjellig), fordi logaritmen er en monoton funksjon.
La oss, i henhold til det ovenforstående, fortsette å utvikle vårt eksempel med lån fra Vasilij, Fedja og Leja. Først går vi til logaritmen til sannsynlighetsfunksjonen:

Nå kan vi enkelt derivere uttrykket etter  :

Og til slutt vurderer vi førsteordensbetingelsen – setter den deriverte av funksjonen lik null:

Dermed ble vår intuitive vurdering av sannsynligheten for tilbakebetaling av lån  teoretisk begrunnet.
Flott, men hva skal vi nå gjøre med slik informasjon? Hvis vi antar at hver tredje låntaker ikke returnerer pengene til banken, vil den sistnevnte uungåelig gå konkurs. Slik er det, men når vi vurderer sannsynligheten for tilbakebetaling av lån til å være lik  Vi har ikke tatt hensyn til faktorene som påvirker tilbakebetalingen av lån: låntakers lønn og størrelsen på den månedlige betalingen. La oss huske at vi tidligere beregnet sannsynligheten for at hvert lån blir tilbakebetalt med hensyn til disse faktorene. Det er logisk at sannsynlighetene våre derfor er forskjellige fra konstanten som er lik
 .
La oss definere sannsynlighet for utvalgene:
Koden for beregning av sannsynlighet for utvalgene
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Sannsynlighet for utvalget ved konstant verdi p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Sannsynlighet for utvalget ved beregnet verdi p:', round(likelihood(y,p_log_response),3)
Sannsynlighet for utvalget ved konstant verdi  :

Sannsynlighet for utvalget ved beregning av tilbakebetalingsrisiko med hensyn til faktorene  :


Sannsynligheten for utvalget med sannsynlighet beregnet ut fra faktorene viste seg å være høyere enn sannsynligheten ved konstant verdi. Hva betyr dette? Det betyr at kjennskapen til faktorene har gjort det mulig å skaffe seg en mer nøyaktig vurdering av tilbakebetalingsrisikoen for hver kunde. Derfor, ved utdeling av neste lån, vil det være mer korrekt å bruke modellen for vurdering av gjeldsbetaling, som er foreslått i slutten av den tredje delen av artikkelen.
Men hvis vi da trenger å maksimere funksjonen for sannsynligheten til utvalget, hvorfor ikke bruke en algoritme som gir sannsynligheter for Vasilij, Fedja og Leša, for eksempel 0.99, 0.99 og 0.01 henholdsvis? Kanskje en slik algoritme vil prestere godt på treningsutvalget, da den nærmer seg sannsynlighet for utvalget.  , men først og fremst vil en slik algoritme sannsynligvis ha vanskeligheter med generaliseringsevnen, for det andre vil denne algoritmen helt sikkert ikke være lineær. Og hvis metoder for å bekjempe overtilpasning (lik svak generaliseringsevne) åpenbart ikke er en del av planen for denne artikkelen, så la oss gå nærmere inn på det andre punktet. For dette, er det nok å svare på et enkelt spørsmål. Kan sannsynligheten for kredittbetaling for Vasja og Fedja være lik med tanke på de faktorene vi kjenner til? Ut ifra sunn fornuft, selvfølgelig ikke, det kan den ikke. Så for å betale tilbake lånet, vil Vasja betale 2.5% av lønnen sin hver måned, mens Fedja vil betale nesten 27,8%. Også på graf 2, «Klassifisering av kunder», ser vi at Vasja ligger betydelig lenger fra linjen som deler klassene, enn Fedja. Og til slutt vet vi at funksjonen
 for Vasja og Fedja har forskjellige verdier: 4.24 for Vasja og 1.0 for Fedja. Hvis Fedja for eksempel tjente mye mer eller ba om et mindre lån, ville sannsynligheten for kredittbetaling for Vasja og Fedja vært liknende. Med andre ord, lineær avhengighet kan ikke forfalskes. Og hvis vi faktisk hadde beregnet koeffisientene
 , og ikke hentet dem fra luften, kan vi trygt påstå at våre verdier
 allerede gir den beste vurderingen av sannsynligheten for kredittbetaling av hver låntaker, men siden vi ble enige om å anta at definisjonen av koeffisientene
 ble utført etter alle regler, vil vi derfor anta at – våre koeffisienter gir den beste vurderingen av sannsynligheten 🙂
Men vi har blitt distrahert. I dette avsnittet må vi forstå hvordan vektoren med vekter  , som er nødvendig for å estimere sannsynligheten for tilbakebetaling av lån fra hver låntaker, blir bestemt.
Se kort oppsummert hva vi har til rådighet i jakten på koeffisientene  :
1. Vi antar at forholdet mellom den avhengige variabelen (det prognostiske verdien) og faktoren som påvirker resultatet – er lineært. Av denne grunn benyttes den lineære regresjonsfunksjonen typen  , linjen som deler objektene (kundene) i klasser
 og
 eller
 (kunder som kan tilbakebetale lån og de som ikke kan). I vårt tilfelle har ligningen formen
 .
2. Vi bruker den inverse logit-transformasjonsfunksjonen typen  for å bestemme sannsynligheten for at et objekt tilhører klassen
 .
3. Vi betrakter vårt treningsutvalg som en realisering av den generaliserte Bernoulli-skjemaer, det vil si at for hvert objekt genereres en tilfeldig variabel som med sannsynlighet  (sin egen for hvert objekt) tar verdien 1 og med sannsynlighet
 – 0.
4. Vi vet at vi trenger å maksimere funksjonen for sannsynligheten til utvalget med hensyn til de aksepterte faktorene for å gjøre utvalget så plausibelt som mulig. Med andre ord, vi må finne slike parametere at utvalget er mest plausibelt. I vårt tilfelle er den parameteren vi ønsker å finne sannsynligheten for tilbakebetaling av lån  , som igjen avhenger av ukjente koeffisienter
 . Dermed trenger vi å finne en vektervektor
 , der plausibiliteten til utvalget blir maksimal.
5. Vi vet at for å maksimere plausibilitetsfunksjonen til utvalget kan man bruke metoden for maksimalt sannsynlighet. Og vi kan alle de smarte triksene for å jobbe med denne metoden.
Slik blir det en komplisert tilnærming 🙂
Og nå, la oss huske at i begynnelsen av artikkelen ønsket vi å utlede to typer tapfunksjoner Logistic Loss avhengig av hvordan klassene av objekter er merket. Det har blitt tradisjonelt at i klassifiseringsoppgaver med to klasser, klassene blir merket som  og
 eller
 . Avhengig av merket, vil det i utgangen være den tilsvarende tapfunksjonen.
Tilfelle 1. Klassifisering av objekter som og
 og

Tidligere, når vi bestemte plausibiliteten til utvalget, der sannsynligheten for gjeldsbetaling fra låntakeren ble beregnet basert på faktorer og gitte koeffisienter  , brukte vi formelen:

Faktisk  — er dette verdien til den logistiske responsfunksjonen
 med den gitte vektervektoren

Da er det ingenting som hindrer oss i å skrive plausibilitetsfunksjonen til utvalget slik:

Det skjer ofte at noen nybegynnere analytikere synes det er vanskelig å forstå hvordan denne funksjonen fungerer. La oss se på 4 korte eksempler som alle vil avklare:
1. Hvis  (dvs. i samsvar med treningsutvalget gjelder objektet for klassen +1), og vår algoritme
 bestemmer sannsynligheten for at objektet tilhører klassen
 som er lik 0.9, så denne delen av plausibiliteten til utvalget vil bli beregnet slik:

2. Hvis  , men
 , så beregningen vil være slik:

3. Hvis  , men
 , så beregningen vil være slik:

4. Hvis  , men
 , så beregningen vil være slik:

Åpenbart vil plausibilitetsfunksjonen maksimeres i tilfellene 1 og 3 eller generelt — ved korrekt gjettede verdier for sannsynligheten for at objektet tilhører klassen  .
På grunn av at når man bestemmer sannsynligheten for at et objekt tilhører klassen  vi kjenner bare ikke koeffisientene
 , så vi skal lete etter dem. Som nevnt tidligere, er dette et optimaliseringsproblem der vi i begynnelsen trenger å finne den deriverte av sannsynlighetsfunksjonen med hensyn til vekstervaktoren
 . Men det gir mening å forenkle oppgaven: vi skal finne den deriverte av logaritmen sannsynlighetsfunksjonen.

Hvorfor etter logaritmering, i logistisk tap funksjon, endret vi tegnet fra  En funksjon har blitt
 . Det er enkelt, siden man i vurderingsoppgaver vanligvis ønsker å minimere verdien av funksjonen, så vi multipliserte høyresiden av uttrykket med
 og dermed, i stedet for å maksimere, minimerer vi nå funksjonen.
Egentlig, nå, for dine øyne ble tap funksjonen – Logistic Loss for treningssett med to klasser:  og
 .
Nå, for å finne koeffisientene, trenger vi bare å finne den deriverte logistisk tap funksjon og deretter, ved å bruke numeriske optimaliseringsmetoder som gradientnedstigning eller stochastisk gradientnedstigning, velge de mest optimale koeffisientene  . Men, med tanke på den allerede ganske utførlige artikkelen, foreslås det å gjøre differensieringen selv, eller kanskje dette blir temaet for neste artikkel med mer aritmetikk uten så mange detaljerte eksempler.
Tilfelle 2. Klassifisering av objekter på og
 og

Tilnærmingen her vil være den samme som for klassene  og
 , men selve veien til å utlede tap funksjonen Logistic Loss, vil være mer intrikat. La oss begynne. Vi skal bruke operatoren for sannsynlighet «hvis…, så…». Det vil si, hvis
 -te objektet tilhører klassen
 , så for å beregne sannsynligheten til utvalget bruker vi sannsynligheten
 , hvis objektet tilhører klassen
 , så setter vi inn i sannsynligheten
 . Slik ser sannsynlighetsfunksjonen ut:

La oss forklare hvordan dette fungerer. La oss se på 4 tilfeller:
1. Hvis  og
 , så i sannsynligheten til utvalget «går»

2. Hvis  og
 , så i sannsynligheten til utvalget «går»

3. Hvis  og
 , så i sannsynligheten til utvalget «går»

4. Hvis  og
 , så i sannsynligheten til utvalget «går»

Det er åpenbart at i tilfelle 1 og 3, når sannsynlighetene ble riktig bestemt av algoritmen, sannsynlighetsfunksjonen vil maksimeres, det er akkurat det vi ønsket å oppnå. Imidlertid er denne tilnærmingen ganske omstendelig, og videre skal vi se på en mer kompakt fremstilling. Men først, la oss logaritmere sannsynlighetsfunksjonen med endring av tegn, ettersom vi nå skal minimere den.

Vi setter inn i stedet for  uttrykket
 :

La oss forenkle det høyre leddet under logaritmen ved å bruke enkle aritmetiske teknikker og få:

Og nå er det på tide å kvitte seg med operatoren «hvis…, så…». Legg merke til at når objektet  tilhører klassen
 , så i uttrykket under logaritmen, i nevneren,
 heves til eksponenten
 , hvis objektet tilhører klassen
 , så $e$ heves til eksponenten
 . Følgelig kan vi forenkle eksponentnotasjonen — samle begge tilfeller i ett:
 . Da den logistiske feilfunksjonen form:

I henhold til logaritmereglene, snur vi brøken og tar minustegnet " " ut av logaritmen, og får:

Her er tapsfunksjonen logistic Loss, som brukes i treningssettet med objekter som tilhører klassene:  og
 .
Vel, på dette punktet tar jeg farvel, og vi avslutter artikkelen.
Forfatterens forrige arbeid — «Vi fører ligningen for lineær regresjon inn i matriseform»
Hjelpematerialer
1. Litteratur
1) Anvendt regresjonsanalyse / N. Draper, G. Smith – 2. utg. – M.: Finans og statistikk, 1986 (oversatt fra engelsk)
2) Sannsynlighetsteori og matematisk statistikk / V.E. Gmurman — 9. utg. — M.: Høyere skole, 2003
3) Sannsynlighetsteori / N.I. Tjernova — Novosibirsk: Novosibirsk statsuniversitet, 2007
4) Forretningsanalyse: fra data til kunnskap / Paklin N.B., Oreshkov V.I. — 2. utg. — St. Petersburg: Piter, 2013
5) Data Science — Vitenskap om data fra bunnen av / Joel Grass — St. Petersburg: BKHV Petersburg, 2017
6) Praktisk statistikk for Data Science spesialister / P. Bruce, E. Bruce — St. Petersburg: BKHV Petersburg, 2018
2. Forelesninger, kurs (video)
1)
2)
3)
4)
5)
3. Internett-kilder
1)
2)
3)
4)
5)
6)
7)
8)
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish