

Koden for programvarer for maskinlæring er ofte kompleks og ganske forvirrende. Å oppdage og fikse feil i den er en ressurskrevende oppgave. Selv de enkleste krever en seriøs tilnærming til nettdesign, initialisering av vekter og optimalisering av nettverket. En liten feil kan føre til ubehagelige problemer.
Denne artikkelen er dedikert til algoritmen for feilsøking av nevrale nettverk.
Skillbox anbefaler: Praktisk kursus .
Vi minner om: for alle lesere av «Habr» — 10 000 rubler rabatt ved påmelding til hvilket som helst Skillbox-kurs med kampanjekoden «Habr».
Algoritmen består av fem trinn:
- enkel start;
- bekreftelse av tap;
- sjekk av mellomresultater og tilkoblinger;
- diagnose av parametre;
- kontrollere ytelsen.
Hvis noe virker mer interessant enn annet, kan du gå direkte til disse delene.
Enkel start
Det er vanskeligere å feilsøke et nevralt nettverk med kompleks arkitektur, regularisering og læringshastighetsplanlegger enn et vanlig nettverk. Her er vi litt smarte, siden dette punktet for feilsøking har en indirekte tilknytning, men det er uansett en viktig anbefaling.
Enkel start går ut på å lage en forenklet modell og trene den på ett datasett (punkt).
Først lager vi en forenklet modell
For en rask start lager vi et lite nettverk med ett skjult lag og sjekker at alt fungerer korrekt. Deretter kompliserer vi modellen gradvis, sjekker hvert nytt aspekt av dens struktur (et ekstra lag, parameter osv.), og går videre.
Trene modellen på ett datasett (punkt)
Som en rask sjekk av funksjonaliteten i prosjektet ditt kan du bruke ett eller to datapunkter for å bekrefte at systemet fungerer korrekt. Det nevral nettverket må vise 100 % nøyaktighet på trening og testing. Hvis ikke, så er modellen enten for liten, eller så har du allerede en feil.
Selv om alt ser bra ut, forbered modellen på å kjøre i en eller flere epoker før du går videre.
Evaluering av tap
Tapsevaluering er den viktigste metoden for å klargjøre modellens ytelse. Du må forsikre deg om at tapet stemmer overens med oppgaven, og at tapsfunksjonene vurderes på en korrekt skala. Hvis du bruker mer enn én type tap, må du sørge for at alle er av samme rekkefølge og korrekt skalert.
Det er viktig å være oppmerksom på de innledende tapene. Sjekk hvor nært det faktiske resultatet er det forventede, hvis modellen startet med et tilfeldig antakelse. I : «Sørg for at du får resultatet forventet når du begynner å jobbe med et lite antall parametre. Det er bedre å sjekke datatapene med en regresjonsgrad satt til null med en gang. For eksempel, for CIFAR-10 med Softmax-klassifiserer forventer vi at de innledende tapene vil være 2.302, fordi den forventede diffuse sannsynligheten er 0,1 for hver klasse (siden det er 10 klasser), og Softmax-tapet er den negative logaritmiske sannsynligheten for den riktige klassen som -ln (0.1) = 2.302».
For et binært eksempel gjøres det en tilsvarende beregning for hver av klassene. Her er for eksempel dataene: 20 % 0-er og 80 % 1-er. Den forventede innledende tapen vil være opp til -0.2ln (0.5) - 0.8ln (0.5) = 0.693147. Hvis resultatet er større enn 1, kan dette tyde på at vektene i nevrale nettverket ikke er balansert eller at dataene ikke er normalisert.
Vi sjekker mellomresultatene og forbindelsene
For å feilsøke det nevrale nettverket må man forstå dynamikken i prosessene inne i nettverket og rollen til de ulike mellomlagene, siden de er sammenkoblede. Her er typiske feil du kan støte på:
- feil uttrykk for gradientoppdateringer;
- oppdateringer av vekt implementeres ikke;
- forsvinnende eller eksploderende gradienter (exploding gradients).
Hvis gradientverdiene er null, betyr det at læringshastigheten i optimalisatoren er for lav, eller at du har støtt på et feil uttrykk for gradientoppdatering.
I tillegg er det nødvendig å overvåke verdiene av aktiveringsfunksjonene, vektene og oppdateringene for hvert av lagene. For eksempel bør størrelsen på oppdateringene av parametrene (vektene og skjevhetene) .
Det finnes et fenomen som kalles 'Dying ReLU' eller , når ReLU-nevronene vil gi null etter å ha lært en stor negativ verdi (bias) for vektene sine. Disse nevronene vil aldri aktiveres igjen i noe datastykke.
Du kan bruke gradientkontroll for å oppdage disse feilene ved å tilnærme gradienten ved hjelp av en numerisk tilnærming. Hvis den er nær de beregnede gradientene, er tilbakepropageringen implementert riktig. For å lage en gradientkontroll, sjekk ut disse fantastiske ressursene fra CS231. og , samt til Andrew Ng om dette emnet.
angir tre hovedmetoder for visualisering av nevrale nettverk:
- Foreløpige — enkle metoder som viser oss den generelle strukturen til den trente modellen. De inkluderer utdata av former eller filtre fra individuelle lag av nevrale nettverk samt parametere fra hvert lag.
- Basert på aktivering. Her dekoder vi aktiveringene til individuelle nevroner eller grupper av nevroner for å forstå deres funksjoner.
- Basert på gradienter. Disse metodene har en tendens til å manipulere gradientene som dannes fra fremover- og bakoverpasseringene under trening av modellen (inkludert betydningskart og klasseaktiveringskart).
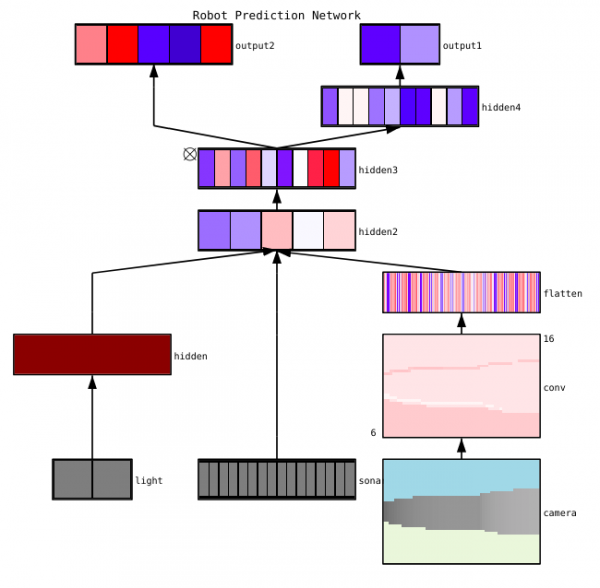
Det finnes flere nyttige verktøy for visualisering av aktiveringene og forbindelsene til individuelle lag, for eksempel, og .
Parameterdiagnostikk
Nevrale nettverk har mange parametere som interagerer med hverandre, noe som kompliserer optimaliseringen. Egentlig er dette avsnittet gjenstand for aktiv forskning fra eksperter, så forslagene nedenfor bør betraktes som råd, startpunkter å utgangspunkt i.
Batch-størrelse (batch size) — det er viktig at batch-størrelsen er stor nok til å gi nøyaktige estimater av feilkostnadsgradienten, men liten nok til at stokkastisk gradientdescent (SGD) kan ordne nettverket ditt. Små batch-størrelser vil føre til rask konvergens på grunn av støy i treningsprosessen, og senere — til vanskeligheter med optimalisering. Dette er beskrevet nærmere. .
Læringshastighet — for lav læringshastighet fører til treg konvergens eller risiko for å sitte fast i lokale minimum. På den annen side vil en høy læringshastighet føre til divergens i optimaliseringen, ettersom du risikerer å «henge» over en dyp, men smal del av tapfunksjonen. Prøv å bruke læringshastighetsplanlegging for å redusere den under treningen av nevrale nettverket. I kurset CS231n. .
Gradient clipping — klipping av gradientene til parametrene under tilbakepropagering til maksimalt verdi eller grenseverdi. Nyttig for å løse problemer med eksploderende gradienter som du kan møte i punkt tre.
Batch normalisering — brukes for å normalisere inndataene til hvert lag, noe som løser problemet med indre kovariatskift. Hvis du bruker Dropout og Batch Normal sammen, .
Stokastisk gradientnedstigning (SGD) — det finnes flere varianter av SGD som bruker momentum, adaptive læringsrater og Nesterov-metoden. Ingen av dem har en klar fordel når det gjelder læringseffektivitet eller generalisering ().
Regulering — er avgjørende for å bygge en generaliserbar modell, da det legger til en straff for modellens kompleksitet eller ekstremverdier til parametrene. Dette er en måte å redusere modellens varians uten å øke dens skjevhet betydelig. Mer .
For å vurdere alt selv, må du deaktivere regularisering og sjekke gradienten av tapet selv.
Dropout — en annen metode for å ordne nettverket ditt for å forhindre overbelastning. Under trening skjer dropout ved å holde aktiviteten til en neuron med en viss sannsynlighet p (hyperparameter) eller sette den til null i motsatt tilfelle. Som et resultat må nettverket bruke et annet delsett av parametrene for hver treningsbatch, noe som reduserer endringene i bestemte parametere som blir dominerende.
Viktig: hvis du bruker både dropout og batch normalisering, vær forsiktig med rekkefølgen på disse operasjonene eller til og med deres samtidige bruk. Alt dette er fortsatt aktivt diskutert og supplert. Her er to viktige diskusjoner om emnet og .
Kontroll av drift
Det handler om dokumentasjon av arbeidsprosesser og eksperimenter. Hvis man ikke dokumenterer noe, kan man for eksempel glemme hvilken læringshastighet eller hvilke klassenes vekter som brukes. Takket være kontroll kan man enkelt gjennomgå og reprodusere tidligere eksperimenter. Dette bidrar til å redusere antallet dupliserende eksperimenter.
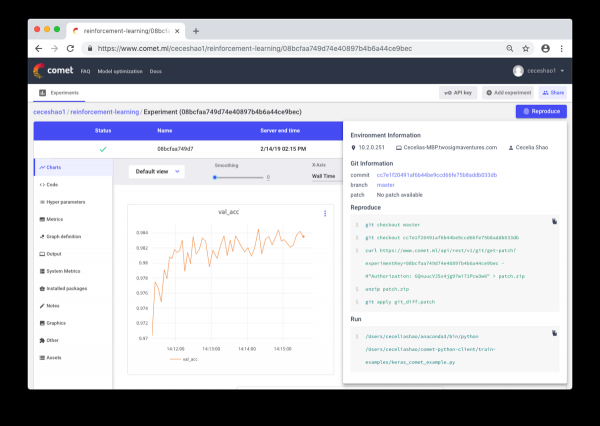
Imidlertid kan manuell dokumentasjon bli en utfordring når arbeidsmengden er stor. Her kommer verktøy som Comet.ml til hjelp, som automatisk logger datasett, kodeendringer, eksperimenthistorikk og produksjonsmodeller, inkludert viktige opplysninger om modellen din (hyperparametere, modellens ytelsesmålinger og miljødetaljer).
Nevronettverket kan være ganske følsomt for små endringer, noe som kan føre til ytelsestap. Å spore og dokumentere arbeidet er det første skrittet man bør ta for å standardisere miljøet og modelleringen.
Jeg håper denne posten kan bli et utgangspunkt for at du begynner å feilsøke nevronettverket ditt.
Skillbox anbefaler:
- Toårig praktisk kurs .
- Nettkurs .
- Praktisk ettårig kurs .
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish