

Spørsmålet om «hvordan implementere DevOps selv» har vært aktuelt i mange år, men gode ressurser er ikke så mange. Noen ganger blir man offer for reklame fra mindre kloke konsulenter som bare ønsker å selge sin tid, uansett hvordan. Av og til er det uklare og svært generelle utsagn om hvordan megaselskapenes skip krysser universets rom. Det reiser spørsmålet: hva får vi ut av dette? Kjære forfatter, kan du formulere dine ideer på en klar liste?
Alt dette skyldes at det ikke har samlet seg så mye reell erfaring og forståelse av utfallene av kulturtransformasjoner. Endringer i kulturen er langsiktige prosesser, hvis resultater ikke vil vise seg på en uke eller en måned. Vi trenger noen som er tilstrekkelig erfaren, som har sett hvordan selskaper har blitt til og blitt ødelagt gjennom mange år.
John Willis — en av fedrene til DevOps. John har mange år med erfaring fra et stort antall selskaper. På det siste har John lagt merke til spesifikke mønstre som er til stede i arbeidet med hver av dem. Ved å bruke disse arketypene guider John selskaper på den riktige veien for DevOps-transformasjon. Mer om disse arketypene finner du i oversettelsen av hans foredrag fra DevOops-konferansen i 2018.
Om foredragsholderen:
Over 35 år innen IT-ledelse, deltatt i utviklingen av forgjengeren til OpenCloud i Canonical, vært med i 10 oppstartsselskaper, to av dem solgt til Dell og Docker. Nåværende Vice President of DevOps and Digital Practices i SJ Technologies.
Deretter følger en beretning fra John.
Mitt navn er John Willis, og jeg er lett å finne på Twitter, . Jeg bruker samme pseudonym på Gmail og GitHub. Og kan du finne videoopptak av mine foredrag og presentasjoner.
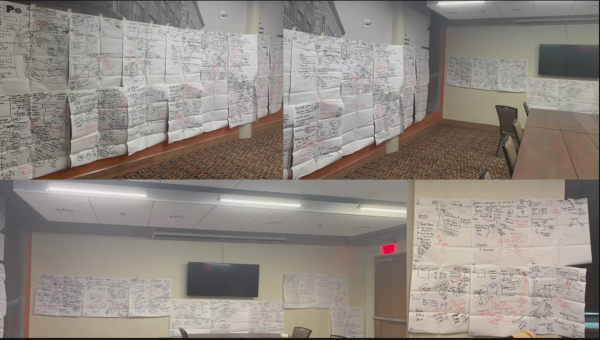
Jeg har mange møter med CIO-er i forskjellige store selskaper. De klager veldig ofte på at de ikke forstår hva DevOps er, og alle som prøver å forklare det for dem, snakker om noe helt annet. En annen vanlig klage er at DevOps ikke fungerer, selv om direktørene tilsynelatende gjør alt som de har fått forklart. Dette gjelder store selskaper som har eksisterte i over hundre år. Etter å ha snakket med dem, konkluderte jeg med at løsningen på mange problemer best oppnås med relativt lavteknologiske løsninger, snarere enn høyteknologiske. I uker snakket jeg bare med folk fra forskjellige avdelinger. Det du ser på det aller første bildet i innlegget – dette var mitt siste prosjekt, rommet så slik ut etter tre dagers arbeid.
Hva er DevOps?
Det er sant at hvis du spør ti forskjellige mennesker, vil de gi ti forskjellige svar. Men det interessante er at alle disse ti svarene vil være riktige. Det finnes ikke noe galt svar her. Jeg har jobbet dypt med DevOps i omtrent ti år, var den første amerikaneren på den første DevOpsDay. Jeg vil ikke si at jeg er smartere enn alle som jobber med DevOps, men det er neppe noen som har investert like mye tid og krefter som jeg har. Jeg mener at DevOps oppstår når menneskelig kapital og teknologi møtes. Vi glemmer ofte den menneskelige dimensjonen, selv om vi snakker mye om alle slags kulturer.
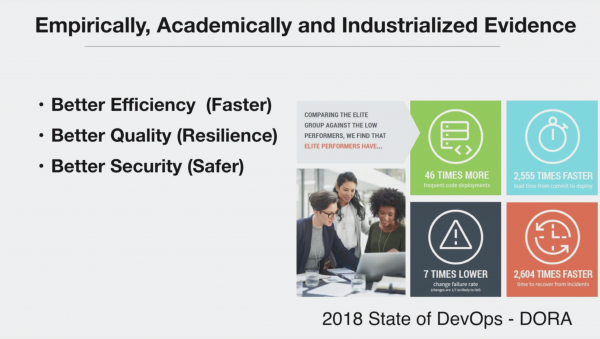
Nå har vi mye data, fem års akademisk forskning, og teoriene er blitt testet i stor skala. Denne forskningen forteller oss følgende: hvis man i organisasjonskulturen forener visse atferdsmønstre, kan man oppnå en effektivitetsøkning på 2000 ganger. Denne økningen tilsvarer en tilsvarende forbedring i robusthet. Dette er en kvantitativ måling av den fordelen DevOps kan gi enhver bedrift. For et par år siden snakket jeg om DevOps med administrerende direktør i et Fortune 5000-selskap. Da jeg forberedte meg til presentasjonen, var jeg veldig nervøs, fordi jeg måtte oppsummere mange års erfaring på fem minutter.
Til slutt gav jeg følgende definisjon av DevOps: det er et sett med praksiser og mønstre som gjør det mulig å omdanne menneskelig kapital til høyytelses organisasjonskapital. Et eksempel er måten Toyota har operert på de siste 50 eller 60 årene.
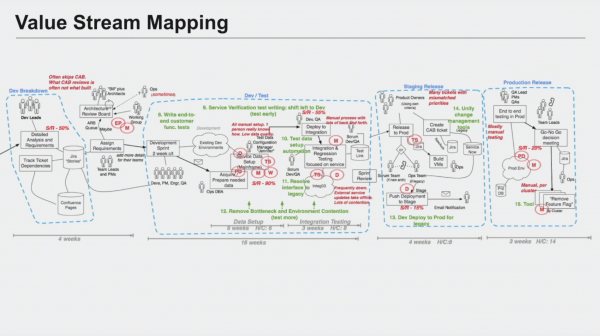
(Her og videre er sådanne skemaer ikke blot til reference, men som illustration. Indholdet vil variere for hver ny virksomhed. Dog kan billedet ses separat og forstørres
En af de mest succesfulde praksisser er value stream mapping. Der er skrevet flere gode bøger om dette emne, hvor den mest succesfulde forfatter er Karen Martin. Men i løbet af det sidste år er jeg kommet til den konklusion, at selv denne tilgang er for højteknologisk. Den har bestemt mange fordele, og jeg har haft stor gavn af den. Men når administrerende direktør spørger dig, hvorfor hans virksomhed ikke kan skifte til nye spor, er det for tidligt at tale om value stream mapping. Der er mange betydeligt mere fundamentale spørgsmål, som man først skal finde svar på.
Jeg mener, at mange af mine kollegaers fejl er, at de blot giver virksomheden en vejledning i fem punkter, og så vender de tilbage om seks måneder for at se, hvad der er sket. Selv med et godt skema som value stream mapping er der, lad os sige, blinde områder. Efter hundredevis af interviews med direktører i forskellige virksomheder har jeg udviklet et bestemt mønster, der gør det muligt at opdele problemet i komponenter, og nu vil vi systematisk diskutere hver af disse komponenter. Før jeg anvender nogen teknologiske løsninger, bruger jeg dette mønster, og resultatet er, at alle mine vægge ender med at være dækket af skemaer. For nylig arbejdede jeg med en investeringsfond, og jeg endte med 100-150 sådanne skemaer.
Dårlig kultur spiser gode tilgange til morgenmad
Hovedideen er, at ingen Lean, Agile, SAFE og DevOps vil hjælpe, hvis selve kulturen i organisationen er dårlig. Det er ligesom at dykke ned uden iltflaske eller operere uden røntgenbillede. Med andre ord, parafraserende Drucker og Deming: en dårlig organisationskultur vil opsluge ethvert godt system og ikke kvæle sig.
For at løse dette hovedproblem er det nødvendigt at tage følgende skridt:
- Gør alt arbejde synligt: man skal gøre alt arbejde synligt. Ikke i den forstand, at det nødvendigvis skal vises på en skærm, men at det skal være observerbart.
- Konsolider arbejdsstyringssystemer: det er nødvendig å konsolidere systemene for ledelse. I problematikken med «stamme»-kunnskap og institusjonell kunnskap er mennesker ofte flaskehalsen i 9 av 10 tilfeller. I boken lå problemet i en enkelt person, Brent, som forårsaket at prosjektet ble forsinket med tre år. Og slike «Brent» møter jeg overalt. For å løse disse flaskehalsene bruker jeg følgende to punkter fra vår liste.
- Theory of Constraints Methodology: teorien om begrensninger.
- Collaboration hacks: samarbeidstriks.
- Toyota Kata (): jeg skal ikke ha mye å si om Toyota Kata. Hvis du er interessert, har jeg på min GitHub nesten om hvert av disse emnene.
- Market Oriented Organization: markedsorientert organisasjon.
- Shift-left auditors: revisjoner i tidlige faser av syklusen.
Jeg begynner arbeidet med organisasjonen på en veldig enkel måte: jeg går inn i selskapet og snakker med de ansatte. Som vi ser, ingen høyteknologi. Alt som trengs, er å ha noe å skrive på. Jeg samler flere team i et rom og analyserer det de sier, ut fra mine 7 arketypene. Så gir jeg dem en tusj og ber dem skrive ned på tavlen alt de så langt har sagt høyt. Vanligvis er det en person på slike møter som skriver alt ned, og i beste fall klarer han å notere 10 % av diskusjonen. Med metoden min klarer vi å heve den prosentandelen til rundt 40%.
(Denne illustrasjonen kan )
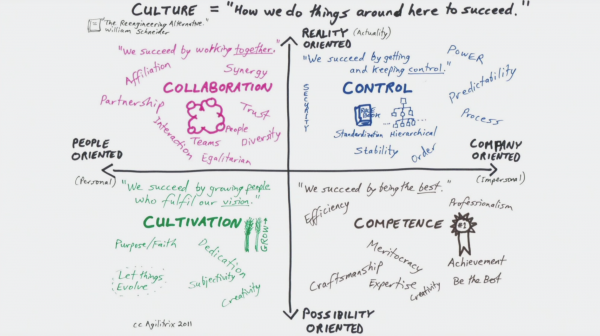
Min tilnærming er basert på arbeidet til William Schneider (William Schneider, ). Grunnideen i tilnærmingen er at enhver organisasjon kan deles opp i fire kvadranter. Dette diagrammet blir vanligvis resultatet av arbeidet med de hundrevis av andre diagrammene som oppstår når man analyserer organisasjonen. La oss anta at vi har en organisasjon med høy kontroll, men samtidig lav kompetanse. Dette er et ekstremt uønsket scenario: når alle følger reglene, men ingen vet hva de skal gjøre.
En bedre variant med høyt nivå av både kontroll og kompetanse. Hvis et slikt selskap har fortjeneste, er det kanskje ikke nødvendig med DevOps. Det mest interessante er å jobbe med et selskap som har høyt nivå av kontroll, lav kompetanse og samarbeid, men samtidig høy grad av kultur (cultivation). Dette betyr at det er mange ansatte i selskapet som trives med å jobbe der, og omsetningen av arbeidskraft er lav.
(Denne illustrasjonen kan )
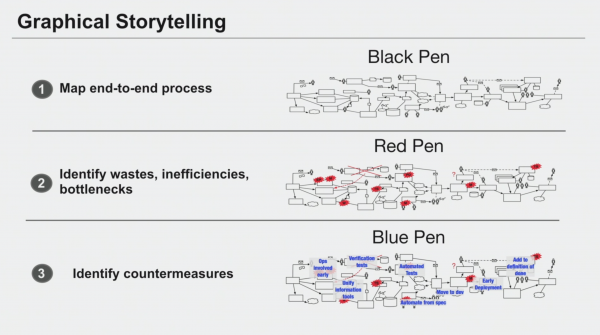
Jeg mener at metoder med strengt definerte anbefalinger i siste instans hindrer oss i å oppnå sannheten. Spesielt innen value stream mapping er det mange regler om hvordan informasjon skal struktureres. I de tidlige arbeidsfaser, som jeg snakker om, er disse reglene ikke nødvendige for noen. Hvis en person med en marker i hånden beskriver den faktiske situasjonen i selskapet på en tavle, er dette den beste måten å forstå situasjonen på. Denne informasjonen når ikke direktørene. På dette tidspunktet er det dumt å avbryte vedkommende og si at de har tegnet en feil pil. På dette stadiet bør en bruke enkle regler, for eksempel at man kan skape et flernivå-konsept ved kun å bruke merkestifter med forskjellige farger.
Jeg gjentar, ingen høyteknologi. Med svart markeravbildes den objektive virkeligheten, hvordan alt fungerer. Med rød marker markerer folk hva de misliker med den nåværende situasjonen. Det er viktig at det er dem som skriver dette, og ikke jeg. Når jeg etter møtet går til IT-direktøren, tilbyr jeg ikke en liste med 10 ting som må endres. Jeg prøver å finne forbindelser mellom det folk i selskapet sier og eksisterende, velprøvde mønstre. Til slutt foreslår blå marker mulige løsninger på problemet.
(Denne illustrasjonen kan )
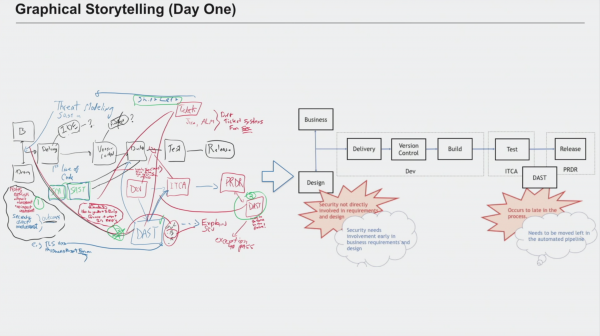
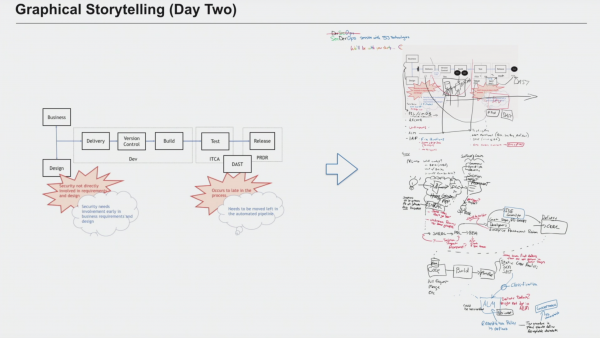
Eksempelet på slik tilnærming er vist over. Tidlig i år jobbet jeg med en bank. Ansatte fra sikkerhetsavdelingen var overbevist om at de ikke kunne delta på krav- og designgjennomganger (design and requirement reviews).
(Denne illustrasjonen kan )
Så snakket vi med folk fra andre avdelinger og fant ut at for rundt 8 år siden hadde programvareutviklerne presset ut sikkerhetsansvarlige fordi de sinket arbeidet. Og så ble dette en forbudt praksis som ble oppfattet som en gitt sannhet. Selv om det i virkeligheten ikke var noe forbud.
Møtet vårt utviklet seg på en svært forvirrende måte: I løpet av omtrent tre timer klarte fem forskjellige team ikke å forklare meg hva som skjer mellom koden og byggingen. Og dette, tilsynelatende, er den enkleste tingen. De fleste DevOps-konsulenter antar på forhånd at det allerede er noe alle vet.
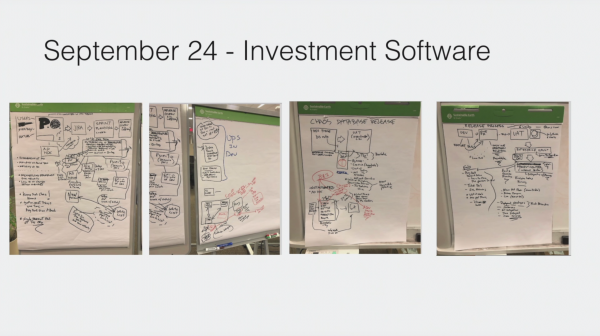
Deretter, personen som ansvarte for IT-styring, som hadde vært stille i fire timer, blomstret plutselig opp da vi kom til hans tema, og holdt oss opptatt i betydelig tid. På slutten spurte jeg ham hva han syntes om møtet, og jeg vil aldri glemme svaret hans. Han sa: «Tidligere trodde jeg at det var to måter å levere programvare på i banken vår, men nå vet jeg at det er hele fem, og jeg var ikke engang klar over tre av dem».
(Denne illustrasjonen kan )
Det siste møtet i denne banken var med teamet som jobber med programvare for investeringer. Det ble klart at det er bedre å tegne diagrammer med tusj på papir enn på en tavle, og til og med bedre enn på en smarttavle.
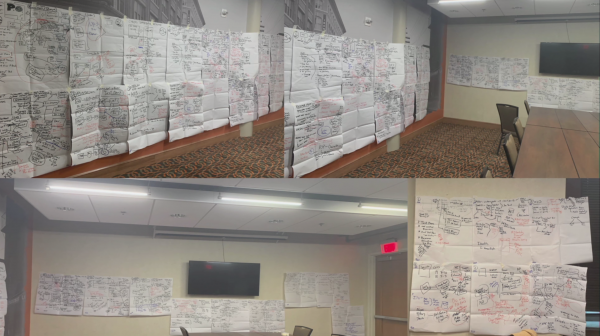
Bildene dere ser — dette er hvordan konferanserommet på hotellet så ut den fjerde dagen av møtet vårt. Og disse diagrammene brukte vi til å lete etter mønstre, altså arketypene.
Så jeg stiller spørsmål til de ansatte, de noterer svarene med tusjer i tre farger (svart, rødt og blått). Jeg analyserer svarene deres for arketypene. Nå la oss diskutere alle arketypene i rekkefølge.
1. Make All Work Visible: Gjør alt arbeid synlig
I de fleste selskaper jeg jobber med, er det en veldig høy prosentandel av ukjent arbeid. For eksempel når en ansatt ber en annen om å gjøre noe. I store organisasjoner kan det være 60% uplanlagt arbeid. Og opp til 40% av arbeidet er aldri dokumentert. Hvis det var Boeing, ville jeg aldri mer satt foten i et av deres fly. Hvis bare halvparten av arbeidet dokumenteres, er det uklart om arbeidet utføres riktig eller ikke. Alle andre metoder blir unyttige — det gir ikke mening å prøve å automatisere noe, fordi de kjente 50% kan være den mest koordinerte og presise delen av arbeidet, automatisering av som ikke gir store resultater, mens alt det mest grufulle ligger i den usynlige halvdelen. Uten dokumentasjon er det umulig å finne alle slags hacks og skjult arbeid, å identifisere flaskehalser, de såkalte «Brentene» jeg allerede har nevnt. Det er en flott bok av Dominica DeGrandis. . Den avdekker fem forskjellige «tidstyver» (thieves of time):
- For mye arbeid i prosess (WIP)
- Ukjente avhengigheter
- Uplanlagt arbeid
- Motstridende prioriteringer
- Negliserte oppgaver
Dette er en svært verdifull analyse, og boken er fantastisk, men alle disse rådene er nytteløse hvis bare 50% av dataene er synlige. Metodene foreslått av Dominica kan brukes så lenge nøyaktigheten er over 90%. Jeg snakker om situasjoner der en sjef gir en underordnet en 15-minutters oppgave, som tar tre dager; men sjefen vet faktisk ikke at den underordnede er avhengig av fire eller fem andre personer.
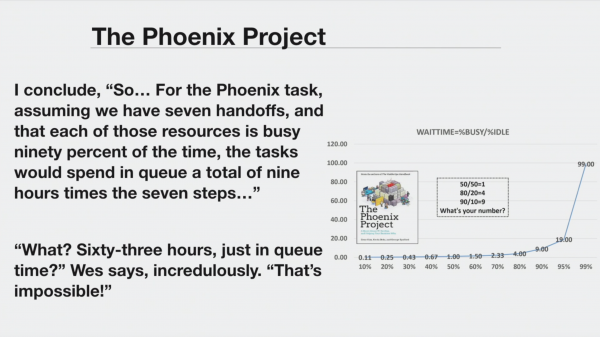
Phoenix Project er en fantastisk fortelling om et prosjekt som var tre år forsinket. En av heltene står i fare for å miste jobben på grunn av dette, og han møter en annen karakter som fremstår som en slags Sokrates. Denne hjelper ham med å forstå hva som egentlig gikk galt. Det viser seg at det er en systemadministrator i selskapet som heter Brent, og alt arbeid går på en eller annen måte gjennom ham. På et av møtene blir en av underordnede spurt: hvorfor tar hver halvtime med oppgaver en uke? Svaret er en veldig forenklet fremstilling av køteori og Little's lov, hvor det viser seg at ved 90 % belægning tar hver arbeidet time 9 timer. Hver oppgave må sendes til syv andre personer, så denne timen blir til 63 timer, 7 ganger 9. Jeg sier dette fordi for å bruke Little's lov eller noen som helst komplisert køteori, må man i det minste ha data.
Derfor når jeg snakker om synlighet, mener jeg ikke at alt må være på skjermen, men at man i det minste må ha data. Når de er tilgjengelige, viser det seg ofte at det er en stor mengde uplanlagt arbeid som av en eller annen grunn sendes til Brent, selv om det ikke er noe behov for det. Brent er en flott fyr, han sier aldri «nei», men han forteller ingen hvordan han gjør jobben sin.
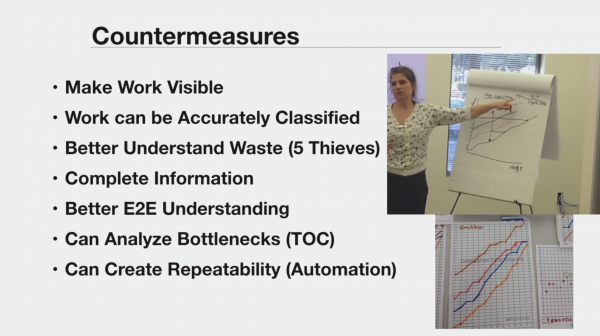
Når arbeidet er synlig, kan man systematisk klassifisere dataene (det er akkurat det Dominika gjør på bildet), man kan bruke abstraksjonen av de fem tidstyvene og automatisere.
2. Konsolider arbeidsstyringssystemer: Oppgavestyring
Arketypene jeg snakker om, danner en slags pyramide. Hvis det første er utført riktig, blir det andre en slags overbygning. Mange av dem fungerer ikke for oppstartsbedrifter, de må vurderes i tilfelle større selskaper, som de som kommer på Fortune 5000-listen. I det siste selskapet jeg jobbet for, var det 10 feilsporing systemer (ticketing system). Én gruppe brukte Remedy, en annen laget sitt eget system, en tredje benyttet Jira, og noen klarte seg med e-post. Det samme problemet oppstår hvis et selskap har 30 forskjellige arbeidsflyter, men jeg har ikke tid til å diskutere alle slike tilfeller.
Eg diskuterer med folk hvordan billettene opprettes, hva som skjer med dem videre, og hvordan de unngås. Det mest interessante er at folk på våre møter snakker ganske åpent. Jeg spurte hvor mange som setter "mindre / ingen påvirkning" på billetter som egentlig burde tildeles "stor påvirkning". Det viste seg at nesten alle gjør slik. Jeg driver ikke med angiveri og prøver på alle måter å ikke avdekke folk. Når jeg får en oppriktig bekjennelse, avslører jeg ikke personen. Men når nesten alle unngår systemet, betyr det at all sikkerheten, i realiteten, bare er en dekore. Derfor kan ingen konklusjoner trekkes fra dataene i dette systemet.
For å løse problemet med billetter, er det nødvendig å velge ett hovedsystem. Hvis du bruker Jira, skal det være bare Jira. Hvis det finnes et alternativ, skal det også være det eneste. Poenget er at billetter må betraktes som et nytt trinn i utviklingsprosessen. Hver handling må ha en billett som går gjennom arbeidsprosessen for utvikling. Billetter blir sendt til teamet, som legger dem på storyboard, og deretter tar ansvar for dem.
Dette gjelder for alle avdelinger, inkludert infrastruktur- og operasjonsavdelingen. I så fall kan det lages en mer eller mindre troverdig representasjon av situasjonen. Når denne prosessen er på plass, viser det seg plutselig at man lett kan fastslå hvem som er ansvarlig for hver applikasjon. For nå får vi ikke 50%, men 98% nye tjenester. Hvis den grunnleggende prosessen fungerer, øker nøyaktigheten i hele systemet.
Pipeline av tjenester
Dette gjelder igjen kun store selskaper. Hvis du er et nytt selskap i et nytt område – rull opp ermene og arbeid med din Travis CI eller CircleCI. Når det kommer til Fortune 5000-selskaper, er tilfellet med banken jeg jobbet i, beskrivende. De fikk besøk fra Google som viste dem diagrammer fra gamle IBM-systemer. Guttene fra Google spurte med forvirring – men hvor er kildekoden for dette? Det er ingen kildekode, det finnes ikke engang et GUI. Denne virkeligheten er noe store organisasjoner må forholde seg til: 40 år gamle bankoppføringer på en gammel mainframe. En av mine kunder bruker Kubernetes-containere med Circuit Breaker-mønstre, pluss Chaos Monkey, alt dette for KeyBank-applikasjonen. Men til slutt kobles disse containerne til en COBOL-applikasjon.
Guttene fra Google var helt sikre på at de skulle løse alle problemene til kunden min, men så begynte de å stille spørsmål: hva er IBM datapipe? De fikk svaret: det er en tilkobling. Hva kobles den til? Til Sperry-systemet. Og hva er det? Og så videre. Ved første øyekast ser det ut som det ikke er noe DevOps her. Men i realiteten er det mulig. Det finnes leveringssystemer som gjør det mulig å overføre arbeidsflyt til leveringsgruppene.
3. Theory of Constraints: Teorien om begrensninger
La oss gå videre til den tredje arketypen: institusjonell / «stamme»-kunnskap. Generelt finnes det i enhver organisasjon noen personer som vet alt og har kontroll over alt. Det er de som har vært lengst i organisasjonen og som kjenner alle snarveiene.
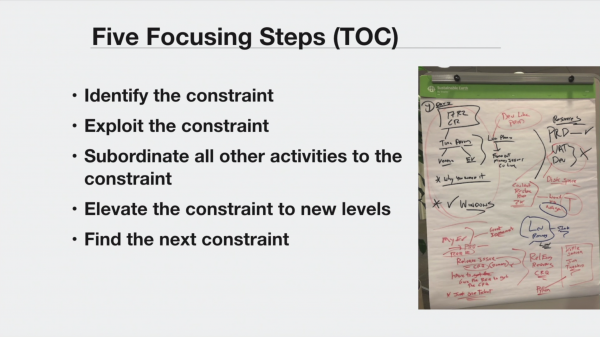
Når dette avdekkes på diagrammet, omgir jeg spesifikt slike mennesker med en markør: for eksempel viser det seg at en viss Lou er til stede på alle møter. Og for meg er det klart: dette er den lokale Brent. Når IT-direktøren velger mellom meg i t-skjorte og joggesko, og en fyr i dress fra IBM, velges jeg fordi jeg kan fortelle direktøren om ting som den andre fyren ikke vil fortelle, og som kan være ubehagelige for direktøren å høre om. Jeg forteller dem at det er et flaskehals i deres selskap, noen ved navn Fred og noen ved navn Lou. Denne flaskehalsen må oppheves, og deres kunnskap må på en eller annen måte utvinnes fra dem.
For solving such a problem, I might suggest using Slack, for example. A savvy director would ask, why? Typically, in such cases, DevOps consultants respond: because everyone does it. If the director is truly savvy, they'll say, so what. And that’s where the dialogue ends. To this, I would respond: because there are four bottlenecks in the company, Fred, Lou, Suzy, and Jane. To institutionalize their knowledge, we first need to implement Slack. All your wikis are complete nonsense because no one knows they exist. If the engineering team is working on both external and internal development, everyone should know that they can reach out to the external development team or the infrastructure team with questions. That’s when Lou or Fred will likely have time to engage with the wiki. Then someone might ask in Slack why step 5 isn’t working, for example. At that point, Lou or Fred would fix the instruction in the wiki. Once this process is established, many other things will fall into place.
This is my main point: to recommend any high-end technology, you first need to establish a foundation for it, and this can only be done with the low-tech solutions I just described. If you start with high-end technology without explaining why it's needed, it usually doesn’t end well. One of our clients uses Azure ML, which is a very cheap and simple solution. About 30% of their queries were already answered by the self-learning machine. And it was created by operators who had no experience in data science, statistics, or mathematics. This is telling. The cost of such a solution is minimal.
4. Collaboration hacks: Hacking cooperation
Den fjerde arketypen handler om å bekjempe isolasjon. De fleste vet allerede dette: isolasjon skaper fiendskap. Hvis hver avdeling er på sitt egne etasje, og folk ikke møter hverandre annet enn i heisen, er det veldig lett for fiendskap å oppstå. Men hvis folk derimot er i samme rom, forsvinner det straks. Når noen kommer med en generell anklage, for eksempel at et bestemt grensesnitt aldri fungerer — er det ikke noe enklere enn å avkrefte en slik anklage. Programmererne som har skrevet grensesnittet, trenger bare å begynne å stille konkrete spørsmål, så vil det snart vise seg at brukeren for eksempel bare har brukt verktøyet feil.
Det finnes mange måter å overvinne isolasjon på. Jeg ble en gang bedt om å rådgive en bank i Australia, men takket nei fordi jeg har to barn og en kone. Alt jeg kunne hjelpe dem med var å anbefale dem å bruke grafisk historiefortelling. Dette er noe som beviselig fungerer. En annen interessant metode er å ha lean coffee-møter. I en stor organisasjon er dette et utmerket alternativ for kunnskapsdeling. I tillegg kan man arrangere interne devopsdays, hackathons og så videre.
5. Coaching Kata
Som jeg allerede advarte om i begynnelsen, skal jeg ikke snakke om dette i dag. Hvis du er interessert, kan du se på .
Det er også en god presentasjon om dette emnet fra Mike Rother:
6. Markedsorientert: en organisasjon som er orientert mot markedet
Her er det ulike problemer. For eksempel folk som "I", folk som "T" og folk som "E". Folk som "I" er de som kun fokuserer på én ting. De eksisterer vanligvis i organisasjoner med isolerte avdelinger. "T" er når en person kjenner én ting godt, men også er dyktig i flere andre ting. "E" eller til og med "kam" — det er når en person har mange ferdigheter.
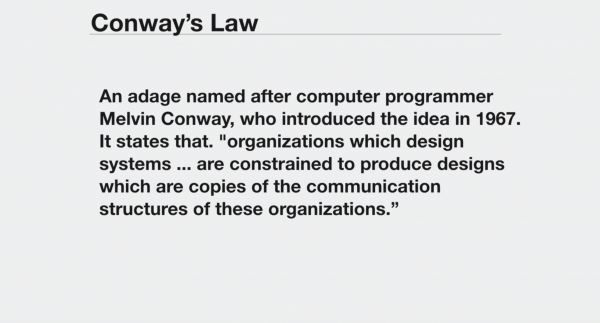
Her gjelder Conways lov (), som i sin mest forenklede form kan uttrykkes slik: hvis tre team jobber med en kompilator, vil det resultere i en kompilator delt opp i tre deler. Derfor, hvis det internt i organisasjonen er et høyt nivå av isolasjon, vil til og med Kubernetes, Circuit breaker, API extensibility og andre trendy ting i denne organisasjonen være strukturert slik som selve organisasjonen. Strengt etter Conway, til tross for alt dere unge nerder.
Løysinga på dette problemet har blitt omtalt mange gonger. Det er for eksempel organisatoriske arketypa beskriven av Fernando Fernandez. Den problematiske arkitekturen eg nettopp snakka om, med isolasjon — det er ein funksjonelt orientert arkitektur. Den andre typen — den verste, er matrisearkitekturen, der er det ein graut av dei to andre. Den tredje — er det som vert observert i dei fleste oppstartar, og store selskap prøver også å tilpasse seg denne typen. Det er ei marknadsorientert organisasjon. Her skjer det ei optimalisering for å oppnå det raskaste svaret på kundens forespørselar. Dette blir av og til kalla ei flat organisasjon.
Mange beskriver denne strukturen på ulike måtar, eg likar formuleringa build/run teams, i Amazon kallar dei det two pizza teams. I denne strukturen blir alle personer av type «I» grupperte rundt ein teneste, og gradvis blir dei nærmare type «T», og dersom det er etablert god leiing, kan dei til og med bli «E». Det første motargumentet her — er at det i ein slik struktur er unødvendige element. Kvifor trengs det ein tester i kvar avdeling, når ein kan ha eit spesialiserte testingsteam? Til det svarar eg: unødvendige kostnader i dette tilfellet er prisen for at heile organisasjonen i framtida skal bli type «E». I ein slik struktur lærer testaren gradvis om nettverk, arkitektur, design osv. Til slutt blir kvar deltakar i organisasjonen heilt informert om alt som skjer i organisasjonen. Dersom du vil vite korleis denne modellen fungerer i industrien, les .
7. Shift-left auditores: revisjon på tidlege stadium i syklusen. Overholding av sikkerheitsreglane på vis
Dette er når handlingene dine, på en måte, ikke klarer lukttesten. Folkene som jobber for deg, er ikke dumme. Hvis de, som i eksempelet ovenfor, hele tiden ga minor/no impact, og dette fortsatte i tre år uten at noen merket noe, så vet alle at systemet ikke fungerer. Et annet eksempel er endringsrådet, hvor hver onsdag må man levere rapporter. Der jobber det en gruppe mennesker (forresten ikke veldig godt betalte), som i teorien burde vite hvordan systemet fungerer som helhet. Over de siste fem årene, har du sikkert lagt merke til at systemene våre er vanvittig komplekse. Fem eller seks personer må ta beslutninger om endringer de ikke har gjort og som de ikke vet noe om.
Selvfølgelig fungerer ikke denne tilnærmingen. Jeg må kvitte meg med slike ting, fordi de personene ikke beskytter systemet. Beslutningen må tas av teamet selv, fordi teamet må være ansvarlig for den. Ellers oppstår det en paradoksal situasjon, hvor en manager, som aldri har skrevet kode i sitt liv, forteller programmereren hvor lang tid det skal ta å skrive koden. I et selskap jeg jobbet med, var det syv forskjellige råd som vurderte hver endring, inkludert arkitektur- og produkt rådgivning, osv. Det var til og med en obligatorisk ventetid, selv om en ansatt sa til meg at i løpet av ti år har ingen noen gang avvist endringene fra denne personen i denne obligatoriske perioden.
Revisorer bør inviteres til samarbejde i stedet for at blive undgået. Fortæl dem, at du skriver immutable binære containere, som forbliver uændrede for always, hvis de består alle tests. Fortæl dem, at du har pipeline as code, og forklar, hvad det betyder. Vis dem følgende skema: en immutable binær kun til læsning i en container, der består alle sårbarhedstests; og dernæst rører ingen ikke bare ved det — ikke engang ved systemet, der opretter pipeline'en, da det også oprettes dynamisk. Jeg har kunder, Capital One, der ved hjælp af Vault skaber noget, der ligner en blockchain. Revisoren behøver ikke at få vist „rezepte“ fra Chef, det er nok at vise blockchainen, der klart viser, hvad der skete med Jira-billetterne i produktionen, og hvem der er ansvarlig for dem.
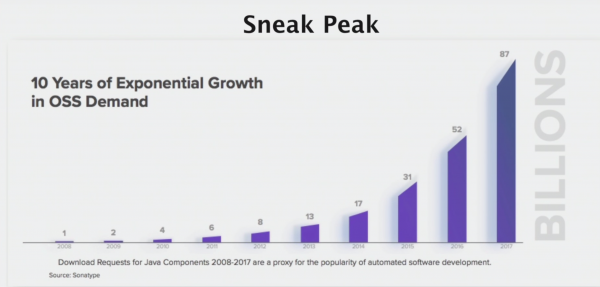
I henhold til , der blev oprettet i 2018, var der 87 milliarder OSS-downloadanmodninger i 2017.
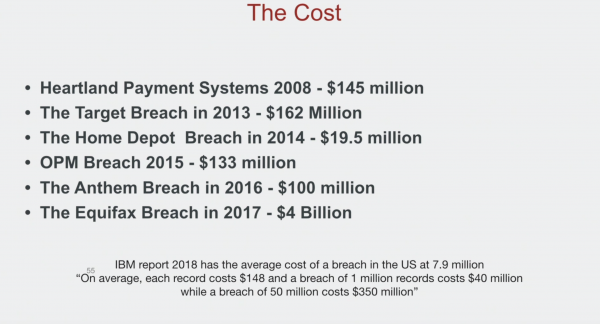
Tabene som følge af sårbarheder viser sig at være uoverkommelige høje. Desuden tæller de tal, du ser ovenfor, ikke de alternative omkostninger. En kort forklaring på, hvad DevSecOps er. Jeg vil straks sige, at jeg ikke er interesseret i diskussioner om, hvor godt dette navn er. Pointen er, at fordi DevOps har været meget succesfulde, er det nødvendigt at forsøge at tilføje sikkerhed til denne pipeline.
Et eksempel på en sådan sekvens:
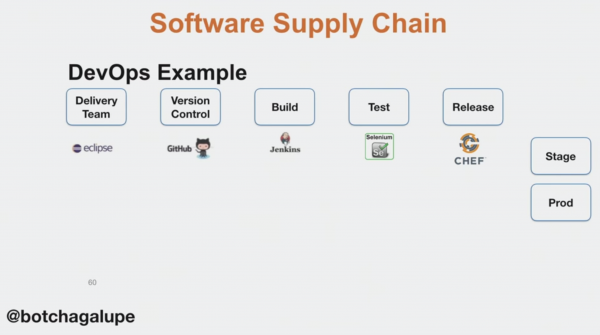
Dette er ikke en anbefaling af specifikke produkter, selvom jeg kan lide dem alle. Jeg har nævnt dem som et eksempel for at vise, at DevOps, der oprindeligt er baseret på en industriorganisation, muliggør automatisering af hvert trin i produktudviklingen.
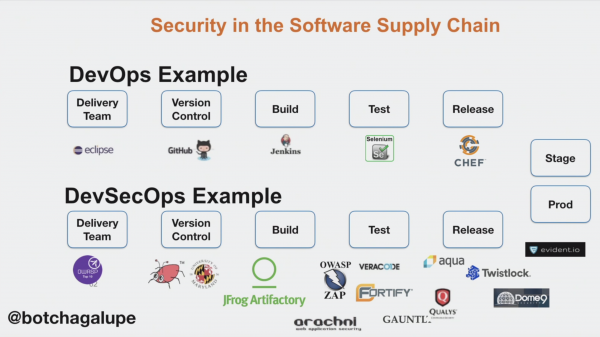
Og der er ingen grund til, at vi ikke skulle kunne anvende den samme tilgang til sikkerhed.
Resultat
Som en avslutning vil jeg gi noen råd til DevSecOps. Inkluder revisorer i prosessen med å bygge systemene deres, og bruk tid på å utdanne dem. Det er viktig å samarbeide med revisorer. Videre er det nødvendig å føre en absolutt nådeløs kamp mot falske alarmer. Selv med det dyreste verktøyet for sårbarhetsskanning kan man ende opp med å danne ekstremt skadelige vaner hos utviklerne, hvis man ikke vet forholdet mellom signal og støy. Utviklerne vil bli overveldet av hendelser og vil begynne å slette dem. Hvis du har hørt om historien med Equifax, skjedde nettopp dette, hvor signalet med høyeste fare ble ignorert. I tillegg må sårbarheter forklares på en måte som gjør det klart hvordan de påvirker forretningen. For eksempel kan man si at dette er den samme sårbarheten som i historien om Equifax. Sikkerhetsrelaterte sårbarheter må behandles på samme måte som andre programvareproblemer, dvs. de må integreres i den generelle DevOps-prosessen. De må håndteres gjennom Jira, Kanban, osv. Utviklerne må ikke tro at dette vil bli gjort av noen andre — tvert imot, dette er noe som alle må ta ansvar for. Til slutt må man bruke ressurser på å utdanne folk.
Nyttige lenker
Her er noen foredrag fra DevOops-konferansen som kan være nyttige for deg:
- Sergie Berdnikov, Artyom Kalichkin — Succes Historie, eller «Dev+DevOps+Ops» (, )
- Baruch Sadogursky, Leonid Igolnik — DevOps i stor skala: en gresk tragedie i tre akter (, )
- Alexander Titov, Kirill Tolkachev —
- Timothy Lister —
Sjekk ut DevOops 2020 Moskva — det er også mange interessante saker der.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish