

W ramach projektu Qwenputer badacze przygotowali rozszerzoną wersję modelu AI Qwen3.5-4B, która zawiera wbudowany symulator pełnoprawnego 32-bitowego CPU opartego na architekturze RISC-V (RV32IM), wspierającego rozszerzenie Zba i wyposażonego w koprocesor bignum do operacji arytmetycznych na dużych liczbach. Realizacja rdzenia CPU została skompilowana w zestawie wag i zintegrowana z dużym modelem językowym w postaci 11 dodatkowych warstw transformatorów, dodanych przed głównymi warstwami Qwen. Obliczenia są wykonywane bezpośrednio w procesie przejścia forward pass sieci neuronowej, bez użycia zewnętrznych narzędzi lub wtyczek.
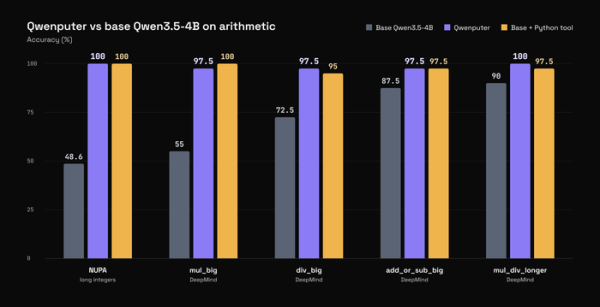
Realizacja pomyślnie przechodzi wszystkie testy z oficjalnego zestawu testów riscv-tests i jest w stanie wykonywać skompilowany kod w językach C i MicroPython. Podczas wykonywania obliczeń arytmetycznych na dużych liczbach Qwenputer zapewnia dokładność wynoszącą 97,5-100%, co jest porównywalne lub przewyższa wyniki podstawowego modelu Qwen3.5 z podłączonym zewnętrznym interpreteren Python.
Do symulacji pamięci operacyjnej w modelu wykorzystano oddzielne warstwy Gated DeltaNet (liniowe RNN), stosowane w podstawowym modelu AI Qwen do zachowania zmienionego stanu podczas pracy z dużymi oknami kontekstowymi. Poprzez zablokowanie stanu bramki i zastosowanie kodowania jednostkowego (one-hot) każde żądanie zapisu nadpisuje dokładnie jeden wiersz macierzy stanu, co pozwala na użycie stanu DeltaNet jako adresowanej pamięci o stałej wielkości, unikając liniowego wzrostu pamięci KV-cache (Key-Value) przy zwiększeniu długości kontekstu. W takiej pamięci umieszczane są rejestry CPU, dane i wykonywany kod maszynowy.
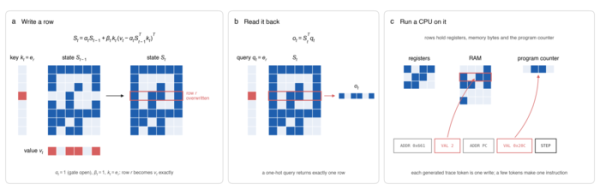
Instrukcje procesora, takie jak odczyt rejestrów, operacje arytmetyczne i skoki warunkowe, są kompilowane bezpośrednio w wagi warstw transformatora. Każdej instrukcji przypisane są specjalne tokeny (ADDR, VAL, STEP), które warstwy modelu AI interpretują jako logikę działania CPU. Do inicjalizacji CPU i załadowania oprogramowania używa się małego zewnętrznego sterownika RvChat, ale sam kod maszynowy jest w pełni przetwarzany wewnątrz wag modelu.
Jednym z ograniczeń projektu jest około dwukrotny wzrost rozmiaru (18,8 GB) w porównaniu z pierwotnym modelem Qwen, związany głównie z dodatkowymi warstwami, które wprowadzają nadmiarowe wypełnienie. Zauważono także stosunkowo niską prędkość obliczeniową (około 3200 tokenów na sekundę na GPU L4), co sprawia, że skomplikowane obliczenia mogą zajmować sekundy, a nie milisekundy.
Dodatkowo powstała wersja modelu AI z eksperymentalnym systemem plików, który pozwala na przechowywanie wewnątrz wag modelu AI do 512 plików z 53 tysiącami tokenów tekstu. Podobnie jak w przypadku pamięci operacyjnej, przechowywanie jest zorganizowane w związku z stanami DeltaNet, ale różni się tym, że system plików zapewnia stałe przechowywanie, które nie traci stanu między sesjami.
Badania nad Qwenputerem stały się również podstawą do analizy nowych potencjalnych problemów bezpieczeństwa w AI. Na przykładzie Qwenputera pokazano, jak specjalnie zmodyfikowany model AI może ukrywać swoje rozumowania w stanie RNN i omijać mechanizmy monitorowania rozumowań modelu (CoT, Chain-of-Thought). Również zademonstrowano
możliwość tworzenia mechanizmów kontroli i monitorowania bezpieczeństwa, wbudowanych w wagi modelu AI, które sama model nie może wyłączyć ani zmienić.
Źródło: opennet.ru
