

Część druga:
Każdy obraz rastrowy można przedstawić w postaci dwuwymiarowej macierzy . Kiedy mówimy o kolorach, można rozwinąć tę ideę, traktując obraz jakotrójwymiarową macierz , w której dodatkowe wymiary służą do przechowywania danych dla każdego z kolorów.Jeśli rozważymy ostateczny kolor jako kombinację tzw. kolorów podstawowych (czerwonego, zielonego i niebieskiego), w naszej trójwymiarowej macierzy definiujemy trzy płaszczyzny: pierwsza dla koloru czerwonego, druga dla zielonego, a ostatnia dla niebieskiego.
Nazwijmy każdy punkt w tej macierzy pikselem (elementem obrazu). Każdy piksel zawiera informacje o intensywności (zwykle w postaci wartości numerycznej) każdego koloru. Na przykład,
czerwony piksel oznacza, że zawiera 0 zielonego, 0 niebieskiego i maksymalną ilość czerwonego. Piksel różowego koloru może być stworzony za pomocą kombinacji trzech kolorów. Używając zakresu numerycznego od 0 do 255, różowy piksel definiuje się jako Czerwony = 255 Zielony = 192, Niebieski = 203 i Artykuł opublikowano dzięki wsparciu firmy EDISON..
Tworzymyaplikacje do monitoringu wideo, strumieniowania wideo nagrywaniem wideo w sali operacyjnej .
Aby przedstawić kolory składające się na obraz, istnieje wiele innych modeli. Na przykład, można użyć palety indeksowanej, w której potrzebny jest tylko jeden bajt do reprezentacji każdego piksela, zamiast trzech, wymaganych przy używaniu modelu RGB. W takim modelu można zastosować macierz 2D zamiast 3D do przedstawienia każdego koloru. Oszczędza to pamięć, ale daje mniejszą gamę kolorów.
RGB
Na przykład, spójrz na ten obrazek poniżej. Pierwsza twarz jest całkowicie pokryta. Pozostałe to płaszczyzny czerwone, zielone i niebieskie (intensywność odpowiadających kolorów pokazana w odcieniach szarości).
Na przykład, spójrz na ten obrazek poniżej. Pierwsza twarz jest całkowicie pokolorowana. Pozostałe to czerwone, zielone i niebieskie płaszczyzny (intensywność odpowiednich kolorów przedstawiona w odcieniach szarości).
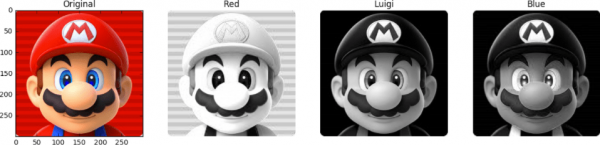
Widzimy, że odcienie czerwieni w oryginale będą w tych samych miejscach, w których obserwuje się najjaśniejsze części drugiej osoby. Z kolei wkład niebieskiego koloru można dostrzec głównie tylko w oczach Mario (ostatnie twarz) oraz elementach jego odzieży. Zwróć uwagę, gdzie wszystkie trzy płaszczyzny kolorów mają najmniejszy wkład (najciemniejsze części obrazów) — jest to w wąsach Mario.
Do przechowywania intensywności każdego koloru potrzebna jest określona liczba bitów — ta wartość nazywana jest głębią bitową.Przyjmijmy, że na jedną płaszczyznę kolorów wydawane są 8 bity (w zakresie od 0 do 255). Wówczas mamy głębię koloru wynoszącą 24 bity (8 bitów * 3 płaszczyzny R/G/B).
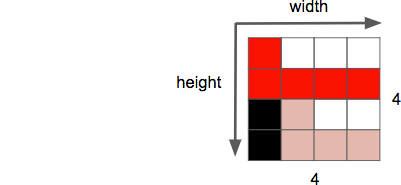
Inną cechą obrazu jest rozdzielczość,która określa liczbę pikseli w jednym wymiarze. Często oznaczana jako szerokość × wysokość,jak poniżej na obrazku-przykładzie 4 na 4.
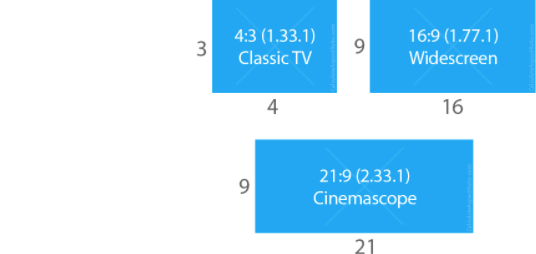
Kolejną cechą, którą mamy do czynienia przy pracy z obrazami/wideo, jest proporcja, opisująca zwykły proporcjonalny związek między szerokością a wysokością obrazu lub piksela.
Kiedy mówi się, że jakiś film lub obraz ma rozmiar 16 na 9, zazwyczaj ma się na myśli proporcję ekranu (DAR — od Wyświetlacz Proporcjonal Wskaźnik,). Jednak czasami mogą występować różne formy poszczególnych pikseli — w tym przypadku mówimy o proporcji pikseli, (PAR. — od Wskaźnik Proporcjonal Piksela.).
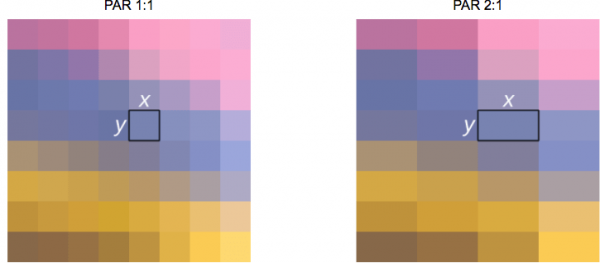
Gospodyni na uwadze: DVD -the node, and the other — DAR 4 na 3.
Chociaż rzeczywista rozdzielczość DVD wynosi 704×480, to zachowuje ono proporcję 4:3, ponieważ PAR ma wartość 10:11 (704×10 / 480×11).
No i na koniec, możemy określić wideo jako sekwencję n klatek w okresie, czasu, które można uznać za dodatkowy wymiar. A n wtedy — to liczba klatek na sekundę (FPS, — od Klatek na sekundę.).
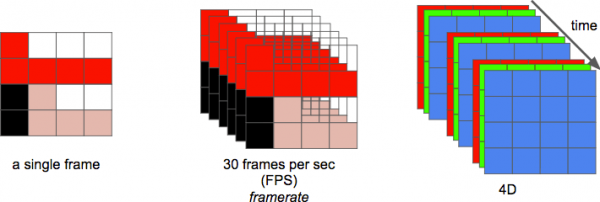
Liczba bitów na sekundę, potrzebna do wyświetlenia wideo, jest jego przepływowością, — bitrate,.
bitrate = szerokość * wysokość * głębia bitowa * klatki na sekundę.
Przykładowo, dla wideo z 30 klatkami na sekundę, 24 bitami na piksel, o rozdzielczości 480×240 potrzeba 82,944,000 bitów na sekundę, czyli 82,944 Mbps (30x480x240x24) — ale tylko wtedy, gdy nie używa się żadnych metod kompresji.
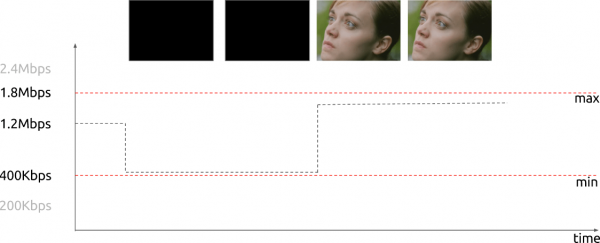
Jeśli przepływowość jest prawie stała,nazywana jest stałą przepływowością, (CBR, — od stałym wskaźnikiem bitowym.). Ale może też być zmienna, w takim przypadku nazywa się zmienną prędkość transferu (VBR — od zmienna przepływność).
Ten wykres przedstawia ograniczone VBR, kiedy nie wydaje się zbyt wiele bitów w przypadku całkowicie ciemnej klatki.
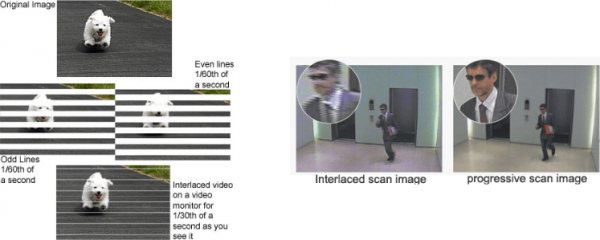
Początkowo inżynierowie opracowali metodę podwajania postrzeganego współczynnika odświeżania wideo bez użycia dodatkowej przepustowości. Metoda ta znana jest jako wideo przeplotowe; w zasadzie wysyła połowę ekranu w pierwszej „klatce”, a drugą połowę w następnej „klatce”.
Obecnie wizualizacja scen odbywa się głównie przy użyciu technologii progresywnego skanowania. To sposób wyświetlania, przechowywania lub przesyłania ruchomych obrazów, w którym wszystkie linie każdej klatki są rysowane kolejno.
Cóż! Teraz wiemy, jak obraz jest przedstawiany w formie cyfrowej, jak są zbudowane jego kolory, ile bitów na sekundę wydajemy na pokazanie wideo, jeśli prędkość transferu jest stała (CBR) lub zmienna (VBR). Znamy podane rozdzielczości przy użyciu zadanej częstotliwości klatek, zapoznaliśmy się z wieloma innymi terminami, takimi jak wideo przeplotowe, PAR i innymi.
Usuwanie nadmiarowości
Wiadomo, że wideo bez kompresji jest niewykonalne w normalnym użytku. Godzinne wideo w rozdzielczości 720p i częstotliwości 30 klatek na sekundę zajmowałoby 278 GB. Do tego wyniku dochodzimy, mnożąc 1280 x 720 x 24 x 30 x 3600 (szerokość, wysokość, bity na piksel, FPS i czas w sekundach).
Użycie algorytmy kompresji bezstratnej, takie jak DEFLATE (używane w PKZIP, Gzip i PNG), nie zapewni wystarczającego zmniejszenia wymaganej przepustowości. Musimy poszukać innych metod kompresji wideo.
Można to osiągnąć, korzystając z cech naszego wzroku. Lepiej rozróżniamy jasność niż kolory. Wideo jest zestawem kolejnych obrazów, powtarzających się w czasie. Różnice między sąsiadującymi klatkami tej samej sceny są niewielkie. Ponadto każda klatka zawiera wiele obszarów używających tego samego (lub podobnego) koloru.
Kolor, jasność i nasze oczy
Nasze oczy są bardziej wrażliwe na jasność niż na kolor. Możesz się o tym przekonać samemu, patrząc na ten obrazek.
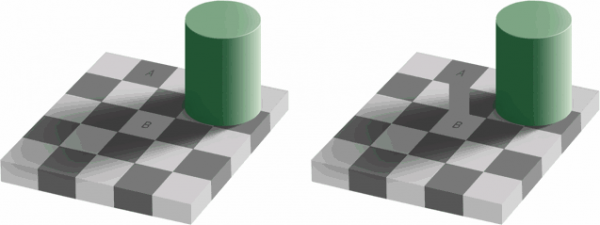
Jeśli nie widzisz, co jest w lewej połowie obrazu, kolory kwadratów A i B w rzeczywistości są takie same, więc to w porządku. Nasz mózg sprawia, że zwracamy większą uwagę na światłocień, a nie na kolor. Po prawej stronie między oznaczonymi kwadratami znajduje się przerywana linia w tym samym kolorze — dlatego łatwo określamy (znaczy to nasz mózg), że w rzeczywistości tam jest ten sam kolor.
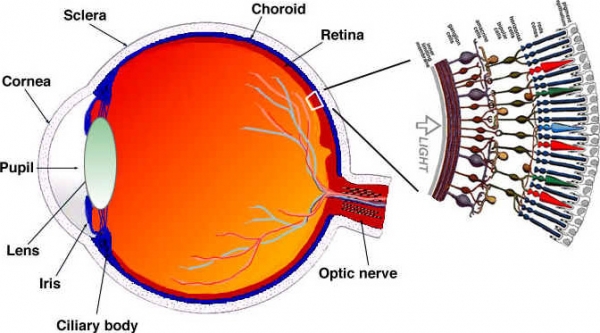
Przyjrzyjmy się (w uproszczeniu), jak działają nasze oczy. Oko to skomplikowany organ składający się z wielu części. Jednak najbardziej interesują nas czopki i pręciki. Oko zawiera około 120 milionów pręcików i 6 milionów czopków.
Rozważmy percepcję koloru i jasności jako oddzielne funkcje określonych części oka (w rzeczywistości jest to nieco bardziej skomplikowane, ale uprościmy). Komórki pręcikowe w większości odpowiadają za jasność, podczas gdy komórki czopek odpowiadają za kolor. Czopki dzielą się na trzy typy, w zależności od zawartego pigmentu: czopki S (niebieski), czopki M (zielony) i czopki L (czerwony).
Ponieważ mamy znacznie więcej pręcików (jasność) niż czopków (kolorów), można stwierdzić, że jesteśmy bardziej zdolni do rozróżniania przejść między ciemnością a światłem niż kolorami.
Funkcje czułości na kontrast
Badacze psychologii eksperymentalnej i wielu innych dziedzin opracowali wiele teorii ludzkiego wzroku. I jedna z nich nazywa się funkcje czułości na kontrast. Są one związane z przestrzennym i czasowym oświetleniem. Krótko mówiąc, chodzi o to, ile zmian jest potrzebnych, zanim obserwator je zauważy. Zauważmy liczbę mnogą słowa „funkcja”. Jest to związane z tym, że możemy mierzyć funkcje czułości na kontrast nie tylko dla obrazów czarno-białych, ale i kolorowych. Wyniki tych eksperymentów pokazują, że w większości przypadków nasze oczy są bardziej wrażliwe na jasność niż na kolor.
Ponieważ wiadomo, że jesteśmy bardziej wrażliwi na jasność obrazu, można spróbować wykorzystać ten fakt.
Model kolorów
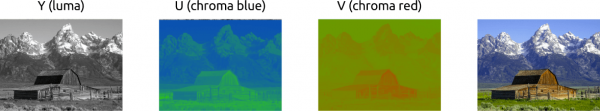
Nieco zrozumieliśmy, jak pracować z obrazami kolorowymi, używając schematu RGB. Istnieją też inne modele. Jest model, który oddziela jasność od kolorowości i jest znany jako YCbCr. Zresztą, istnieją inne modele, które robią analogiczne rozdzielenie, ale omówimy tylko ten.
W tym modelu kolorów Y — to reprezentacja jasności, a także wykorzystywane są dwa kanały kolorów: Cb (nasycony niebieski) oraz Cr (nasycony czerwony). YCbCr może być uzyskany z RGB, a także możliwe jest odwrotne przekształcenie. Korzystając z tego modelu, możemy tworzyć obrazy w pełnym kolorze, jak widać poniżej:
Przekształcenie między YCbCr a RGB
Niektórzy mogą zapytać: jak można uzyskać wszystkie kolory, jeśli nie używa się zielonego?
Aby odpowiedzieć na to pytanie, przekształcamy RGB w YCbCr. Skorzystamy z współczynników przyjętych w standardzie BT.601, który został zalecany przez jednostkę ITU-R. Ta jednostka określa standardy wideo cyfrowego. Na przykład: czym jest 4K? Jakie powinny być częstotliwość klatek, rozdzielczość, model kolorów?
Najpierw obliczymy jasność. Skorzystamy z stałych zaproponowanych przez ITU i zastąpimy wartości RGB.
Y = 0.299R + 0.587G + 0.114B
Po uzyskaniu jasności oddzielimy niebieski i czerwony kolor:
Cb = 0.564(B — Y)
Cr = 0.713(R — Y)
Możemy również przekształcić z powrotem i nawet uzyskać zielony za pomocą YCbCr:
R = Y + 1.402Cr
B = Y + 1.772Cb
G = Y — 0.344Cb — 0.714Cr
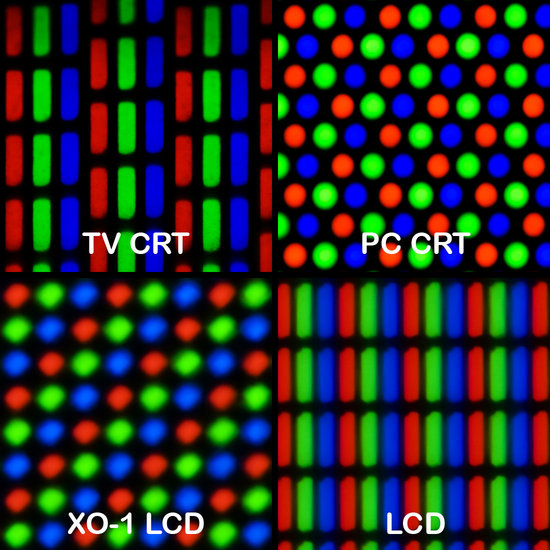
Zazwyczaj wyświetlacze (monitory, telewizory, ekrany itp.) używają tylko modelu RGB. Ale ten model można zorganizować na różne sposoby:
Subskrypcja kolorów
Z obrazem przedstawionym jako kombinacja jasności i chrominancji, możemy wykorzystać większą wrażliwość ludzkiego wzroku na jasność niż na chrominancję, jeśli będziemy selektywnie usuwać informacje. Subdyskrypcja kolorów to metoda kodowania obrazów, która wykorzystuje mniejsze rozdzielczenie dla chrominancji niż dla jasności.
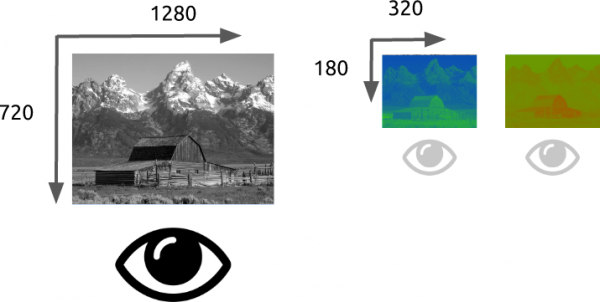
Jak bardzo można zmniejszyć rozdzielczość chrominancji?! Okazuje się, że istnieją już pewne schematy, które opisują, jak przetwarzać rozdzielczość i łączenie (Kolor końcowy = Y + Cb + Cr).
Te schematy znane są jako systemy subdyskrypcji i są wyrażane w postaci współczynnika 3:1 — a:x:y, który określa liczbę próbek sygnałów jasności i chrominancji.
a — standardowa próba pozioma (zwykle równa 4)
x — liczba próbek chrominancji w pierwszym wierszu pikseli (rozdzielczość pozioma w stosunku do a)
y — liczba zmian próbek chrominancji między pierwszym a drugim wierszem pikseli.
Wyjątkiem jest 4:1:0, zapewniający jedną próbkę chrominancji w każdym bloku rozdzielczości jasności 4 na 4.
Ogólne schematy stosowane w nowoczesnych kodekach:
- 4:4:4 (bez subpróbkowania)
- 4:2:2
- 4:1:1
- 4:2:0
- 4:1:0
- 3:1:1
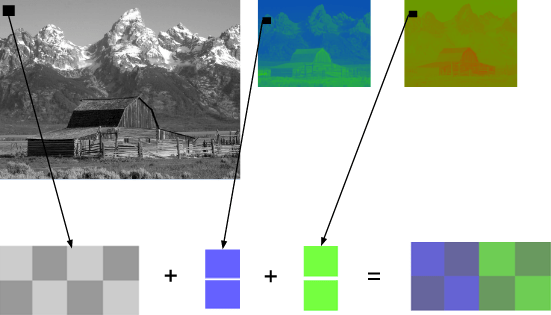
YCbCr 4:2:0 — przykład łączenia
Oto połączony fragment obrazu przy użyciu YCbCr 4:2:0. Zauważ, że wydajemy tylko 12 bitów na piksel.
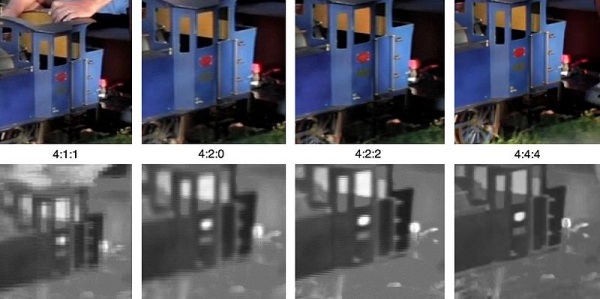
Tak wygląda to samo zdjęcie zakodowane głównymi typami subpróbkowania kolorów. Górny rząd to końcowy YCbCr, dolny rząd pokazuje rozdzielczość koloru. Całkiem przyzwoite wyniki, biorąc pod uwagę niewielkie straty jakości.
Pamiętacie, że obliczyliśmy 278 GB miejsca na dysku do przechowywania godzinnego pliku wideo o rozdzielczości 720p i 30 klatkach na sekundę? Przy użyciu YCbCr 4:2:0, ta wielkość zmniejszy się o połowę — 139 GB. Jak na razie wciąż daleko do akceptowalnego wyniku.
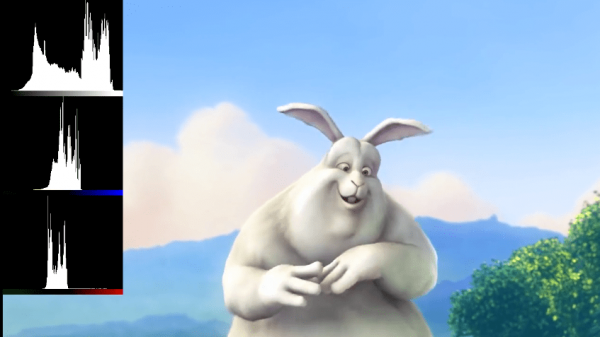
Możesz samodzielnie uzyskać histogram YCbCr za pomocą FFmpeg. Na tym obrazku niebieski dominuje nad czerwonym, co dobrze widać na samym histogramie.
Kolorowość, jasność, gama kolorów — przegląd wideo
Zalecamy obejrzenie tego niesamowitego wideo. Wyjaśnia, czym jest jasność, a także wszystko wyjaśnia do końca. o jasności i kolorze. Rodzaje klatek
Przechodzimy dalej. Spróbujemy wyeliminować nadmiarowość w czasie. Ale najpierw zdefiniujmy trochę podstawowej terminologii. Załóżmy, że mamy film z 30 klatkami na sekundę, oto jego pierwsze 4 klatki:
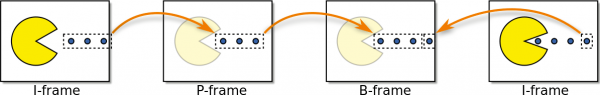
Widzimy wiele powtórzeń w klatkach: na przykład niebieskie tło, które nie zmienia się z klatki na klatkę. Aby rozwiązać ten problem, możemy abstrakcyjnie sklasyfikować je jako trzy typy klatek.


I-klatka (
ntro Frame)II-klatka (klatka kluczowa, klatka referencyjna, klatka wewnętrzna) jest autonomiczna. Niezależnie od tego, co trzeba wizualizować, I-klatka jest w istocie statycznym zdjęciem. Pierwsza klatka jest zazwyczaj I-klatką, jednak regularnie będziemy obserwować I-klatki również wśród tych, które nie są na początku.
P-klatka (

redicted Frame)PP-klatka (klatka przewidywana) wykorzystuje przewagę tego, że prawie zawsze bieżący obraz może być odtworzony za pomocą poprzedniej klatki. Na przykład w drugiej klatce jedyną zmianą jest poruszająca się w przód piłka. Możemy uzyskać klatkę 2, po prostu nieco zmieniając klatkę 1, używając tylko różnicy między tymi klatkami. Aby zbudować klatkę 2, odniesiemy się do wcześniejszej klatki 1.
←
 ←

B-klatka (Bi-ramka przewidywana)
A co z linkami nie tylko do przeszłych, ale także do przyszłych klatek, aby zapewnić jeszcze lepsze kompresje?! To w dużej mierze jest B-klatka (klatka dwukierunkowa).
 ←
 →

Wyjście pośrednie
Te typy klatek są wykorzystywane do zapewnienia najlepszej kompresji. Omówimy, jak to działa w następnej sekcji. Na razie zauważmy, że najbardziej „kosztowną” pod względem użytej pamięci jest I-klatka, P-klatka kosztuje znacznie mniej, a najbardziej opłacalnym wyborem dla wideo jest B-klatka.
Nadmierność czasowa (prognozowanie międzyklatkowe)
Zobaczmy, jakie mamy możliwości minimalizacji powtórzeń w czasie. Ten typ nadmiarowości rozwiążemy za pomocą metod wzajemnego prognozowania.
Postaramy się wydać jak najmniej bitów na kodowanie sekwencji klatek 0 i 1.
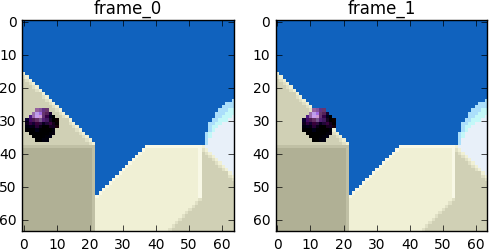
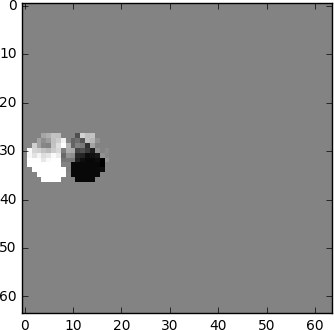
Możemy wykonać odejmowanie, po prostu odejmujemy klatkę 1 od klatki 0. Uzyskujemy klatkę 1, używając różnicy między nią a poprzednią klatką, w rzeczywistości kodując tylko uzyskaną pozostałość.
Ale co, jeśli powiem ci, że istnieje jeszcze lepsza metoda, która wykorzystuje nawet mniej bitów?! Najpierw podzielmy klatkę 0 na wyraźną siatkę składającą się z bloków. A potem spróbujmy dopasować bloki z klatki 0 do klatki 1. Innymi słowy, ocenimy ruch między klatkami.
Z Wikipedii — kompensacja ruchu blokowego
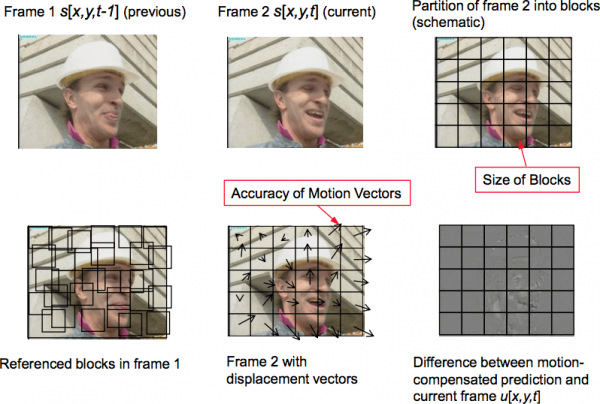
Kompensacja ruchu blokowego dzieli bieżącą klatkę na nieprzecinające się bloki, a wektor kompensacji ruchu informuje o pochodzeniu bloków (powszechne nieporozumienie polega na tym, że poprzednia klatka jest dzielona na nieprzecinające się bloki, a wektory kompensacji ruchu informują, dokąd te bloki się przemieszczają. W rzeczywistości jest odwrotnie — analizowana jest nie poprzednia klatka, a następna, ustala się nie dokąd przesuwają się bloki, ale skąd się pojawiły). Zwykle początkowe bloki nakładają się w klatce źródłowej. Niektóre algorytmy kompresji wideo zbierają bieżącą klatkę z części nawet nie jednego, a od razu kilku wcześniej przesłanych klatek.
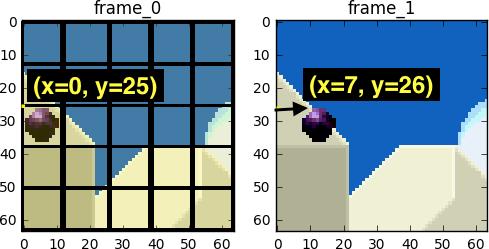
W procesie oceny widzimy, że kula przemieściła się z (x=0, y=25) na (x=6, y=26), wartości x i y określają kierunek ruchu. Kolejny krok, jaki możemy podjąć, aby zachować bity, to kodowanie tylko różnicy wektorów ruchu pomiędzy ostatnią pozycją bloku a przewidywaną, więc ostateczny wektor ruchu będzie (x=6-0=6, y=26-25=1).
W rzeczywistej sytuacji ta kulka byłaby podzielona na n bloki, ale nie zmienia to istoty sprawy.
Obiekty w kadrze poruszają się w trzech wymiarach, więc podczas ruchu kulki może ona stać się wizualnie mniejsza (lub większa, gdy zbliża się do widza). To normalne, że nie będzie idealnego dopasowania pomiędzy blokami. Oto złożony widok naszej oceny i rzeczywistego obrazu.
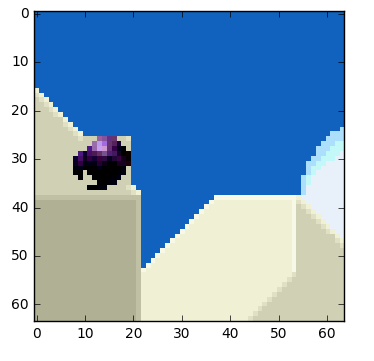
Jednak widzimy, że kiedy stosujemy ocenę ruchu, danych do kodowania jest znacząco mniej niż przy użyciu prostszej metody obliczania różnicy pomiędzy klatkami.
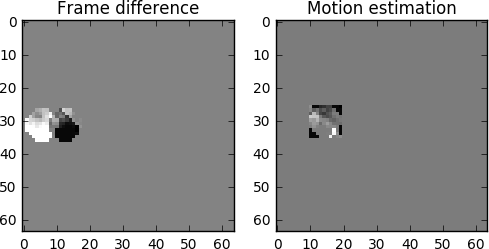
Jak będzie wyglądać rzeczywista kompensacja ruchu
Ta metoda stosowana jest od razu do wszystkich bloków. Często nasza hipotetyczna poruszająca się kulka zostanie podzielona na kilka bloków.
Możesz samodzielnie zbadać te koncepcje, używając .
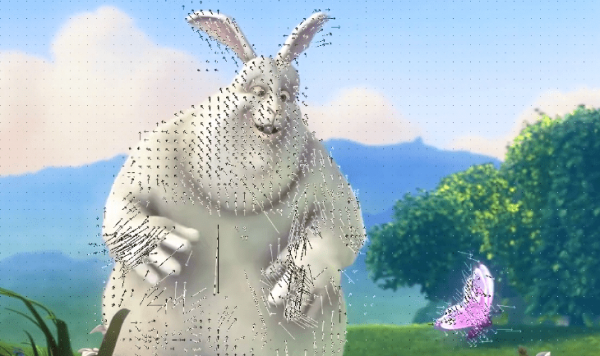
Aby zobaczyć wektory ruchu, możesz stworzyć film z zewnętrznym przewidywaniem za pomocą .
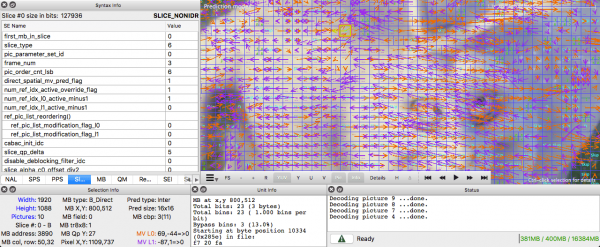
Można również skorzystać z (jest płatny, ale dostępna jest bezpłatna wersja próbna, która ogranicza się tylko do pierwszych dziesięciu klatek).
Redundancja przestrzenna (prognoza wewnętrzna)
Jeśli przeanalizujemy każdą klatkę w wideo, odkryjemy wiele powiązanych obszarów.
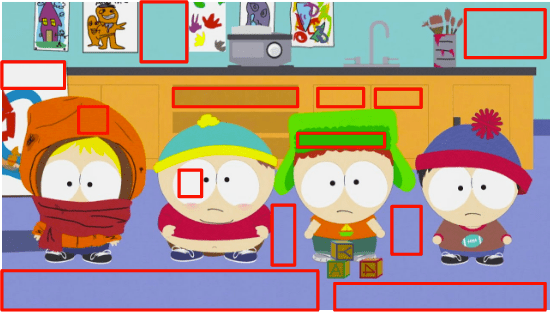
Przyjrzyjmy się temu przykładzie. Ta scena składa się głównie z niebieskiego i białego koloru.
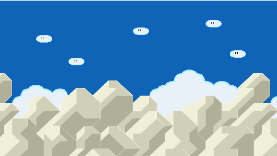
To jest klatka I. Nie możemy wziąć poprzednich klatek do prognozowania, ale możemy ją skompresować. Zakodujemy na czerwono zaznaczony blok. Jeśli spojrzymy na sąsiadów, zauważymy, że w jego otoczeniu występują pewne tendencje kolorystyczne.
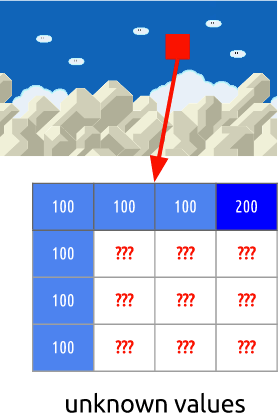
Zakładamy, że kolory w kadrze rozprzestrzeniają się w pionie. Co oznacza, że wartości nieznanych pikseli będą zawierały wartości jego sąsiadów.
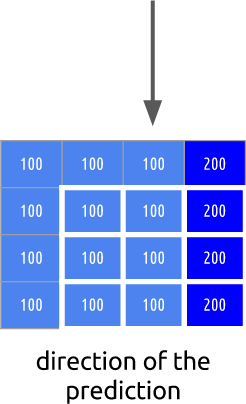
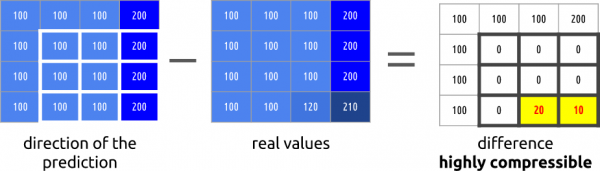
Taka prognoza może okazać się również nietrafiona. Właśnie dlatego należy zastosować tę metodę (prognoza wewnętrzna), a następnie jeszcze odjąć rzeczywiste wartości. To da nam blok resztkowy, co doprowadzi do znacznie bardziej skompresowanej macierzy w porównaniu do oryginału.
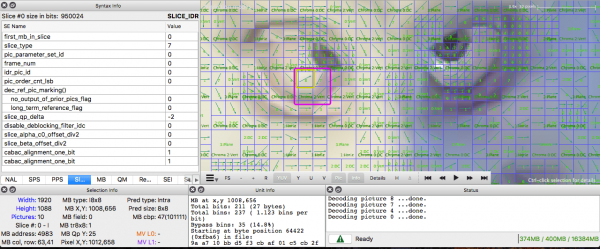
Jeśli chcesz poćwiczyć z wewnętrznymi przewidywaniami, możesz stworzyć wideo z makroblokami oraz ich przewidywaniami za pomocą ffmpeg. Aby zrozumieć znaczenie każdego koloru bloku, musisz zapoznać się z dokumentacją ffmpeg.
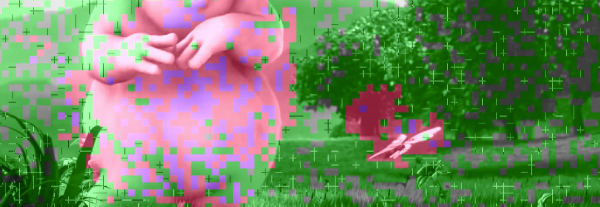
Możesz także skorzystać z Intel Video Pro Analyzer (jak już wspomniałem, w wersji próbnej bezpłatnej, ograniczenie do pierwszych 10 klatek, ale tego wystarczy na początek).
Część druga:
Źródło: habr.com
