

W ostatnich latach coraz więcej platform do optymalizacji projektów frontendowych oferuje możliwość samodzielnego hostingu lub proxy dla zasobów zewnętrznych. Akamai pozwala ustawić dla samodzielnie tworzonych URL. Cloudflare ma technologię Edge Workers. Fasterzine może URL na stronach, tak aby wskazywały na zewnętrzne zasoby znajdujące się na głównym domenie strony.
Jeśli wiadomo, że zewnętrzne usługi używane w Twoim projekcie nie zmieniają się zbyt często i że proces ich dostarczania do klientów może być ulepszony, to z pewnością rozważasz proxy dla takich usług. Przy takim podejściu możesz w pełni "przybliżyć" te zasoby do użytkowników i uzyskać większą kontrolę nad ich buforowaniem po stronie klienta. To również chroni użytkowników przed problemami wywołanymi "awarią" zewnętrznej usługi lub degradacją jej wydajności.
Zaleta: poprawa wydajności
Samodzielny hosting zasobów zewnętrznych poprawia wydajność w całkowicie oczywisty sposób. Przeglądarka nie musi dodatkowo sięgać do DNS, nie musi nawiązywać połączenia TCP i przeprowadzać negocjacji TLS na zewnętrznej domenie. To, jak samodzielny hosting zasobów zewnętrznych wpływa na wydajność, można zobaczyć, porównując dwa następujące rysunki.
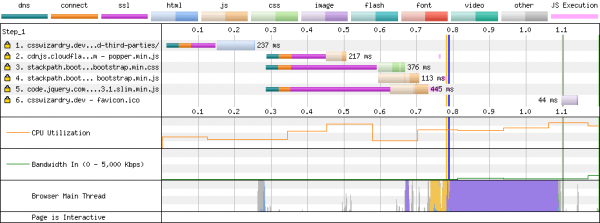
Zewnętrzne zasoby są ładowane z zewnętrznych źródeł (źródło )
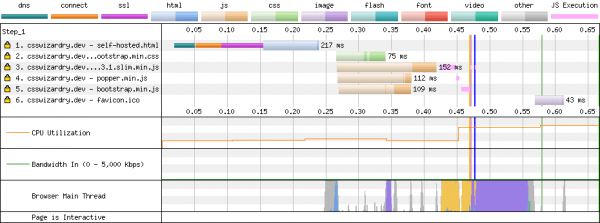
Zewnętrzne zasoby są przechowywane w tym samym miejscu, co pozostałe materiały strony (źródło )
Sytuację poprawia również fakt, że przeglądarka będzie wykorzystywać możliwości multiplexingu i priorytetyzacji danych z połączenia HTTP/2, które już zostało nawiązane z główną domeną.
Jeśli nie hostujesz zasobów zewnętrznych na swoim serwerze, będą one ładowane z domeny różnej od głównej, co uniemożliwi ich priorytetyzację. To spowoduje, że będą konkurować ze sobą o przepustowość klienta. Może to prowadzić do tego, że czas ładowania materiałów, które są krytyczne dla formowania strony, okaże się znacznie dłuższy niż czas możliwy do osiągnięcia w idealnych okolicznościach. wystąpienie na temat priorytetyzacji HTTP/2, w którym wszystko to jest bardzo dobrze wyjaśnione.
Można przypuszczać, że użycie w linkach do zewnętrznych zasobów atrybutów preconnect pomoże w rozwiązaniu problemu. Jednak jeśli takich linków do różnych domen będzie zbyt wiele, może to rzeczywiście przeciążyć linię komunikacyjną w najważniejszym momencie.
Jeśli hostujesz zewnętrzne zasoby samodzielnie — możesz kontrolować, w jaki sposób te zasoby są udostępniane klientowi. Mówiąc dokładniej, chodzi o to:
- Można zapewnić zastosowanie algorytmu kompresji danych, najlepiej dopasowanego do każdej przeglądarki (Brotli/gzip).
- Można zwiększyć czas cache'owania zasobów, który zazwyczaj, nawet w przypadku najbardziej znanych dostawców, nie jest zbyt długi (na przykład odpowiednia wartość dla tagu GA ustawiona jest na 30 minut).
Można nawet wydłużyć wskaźnik TTL dla zasobu, na przykład do roku, włączając odpowiednie materiały w swoją strategię zarządzania pamięcią podrzeczną (hash URL, wersjonowanie i tak dalej). O tym porozmawiamy poniżej.
▍Ochrona przed przerwami w działaniu zewnętrznych usług lub ich wyłączeniem
Inny interesujący aspekt samodzielnego hostingu zewnętrznych zasobów polega na tym, że pozwala to złagodzić ryzyko związane z przerwami w działaniu zewnętrznych usług. Załóżmy, że używane zewnętrzne rozwiązanie do przeprowadzania testów A/B jest realizowane w postaci blokującego skryptu, ładowanego w sekcji nagłówkowej strony. Ten skrypt ładowany jest wolno. Jeśli odpowiedni skrypt nie uda się załadować — strona będzie pusta. Jeśli jego ładowanie zajmie bardzo dużo czasu — strona pojawi się z dużym opóźnieniem. Lub załóżmy, że w projekcie używana jest biblioteka, ładowana z zewnętrznego zasobu CDN. Wyobraźmy sobie, że ten zasób doznał awarii lub został zablokowany w jakimś kraju. Taka sytuacja spowoduje zakłócenie logiki działania strony.
Aby dowiedzieć się, jak działa Twoja strona w warunkach braku dostępności jakiejkolwiek zewnętrznej usługi, możesz skorzystać z sekcji SPOF na .
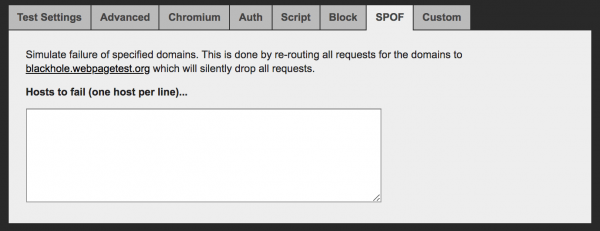
Sekcja SPOF na webpagetest.org
▍Co z problemami z pamięcią podręczną materiałów w przeglądarkach? (podpowiedź: to mit)
Można pomyśleć, że korzystanie z publicznych CDN automatycznie prowadzi do lepszej wydajności zasobów, ponieważ usługi te posiadają wystarczającej jakości sieci i są rozproszone na całym świecie. Ale w rzeczywistości wszystko jest nieco bardziej skomplikowane.
Załóżmy, że mamy kilka różnych stron internetowych: website1.com, website2.com, website3.com. Na wszystkich tych stronach używana jest biblioteka jQuery. Podłączamy ją do nich korzystając z CDN, na przykład — googleapis.com. Można oczekiwać, że przeglądarka raz załadowuje i buforuje bibliotekę, a następnie używa jej w pracy ze wszystkimi trzema stronami. To mogłoby zmniejszyć obciążenie sieci. Może to pozwolić na pewne oszczędności i poprawić wydajność zasobów. Z praktycznego punktu widzenia wygląda to jednak inaczej. Na przykład w Safari wprowadzono możliwość, zwaną : w pamięci podręcznej używane są podwójne klucze, oparte na źródle dokumentu i źródle zasobu zewnętrznego. dobry artykuł na ten temat.
Stare badania i , a także nowsze Pola Calvano pokazują, że zasoby nie są przechowywane w pamięciach podręcznych przeglądarek tak długo, jak moglibyśmy się tego spodziewać: „Istnieje poważna rozbieżność między czasem buforowania własnych i zewnętrznych zasobów projektu. Mówi się o CSS i czcionkach internetowych. Zwłaszcza, że czas buforowania 95% własnych czcionek przekracza tydzień, podczas gdy czas buforowania 50% zewnętrznych czcionek wynosi mniej niż tydzień! To daje deweloperom internetowym solidne powody do samodzielnego hostowania plików czcionek!”
W rezultacie, jeśli będziesz hostować obce materiały, nie zauważysz problemów z wydajnością spowodowanych buforowaniem w przeglądarkach.
Teraz, gdy omówiliśmy mocne strony samodzielnego hostowania zasobów zewnętrznych, porozmawiajmy o tym, jak odróżnić dobrą realizację tego podejścia od złej.
Zła: diabeł tkwi w szczegółach
Przeniesienie zasobów zewnętrznych na własną domenę nie może być wykonane automatycznie, nie dbając o prawidłowe buforowanie tych zasobów.
Jednym z głównych problemów jest czas buforowania. Na przykład informacje o wersjach są zawierane w nazwach skryptów zewnętrznych w mniej więcej taki sposób: jquery-3.4.1.js. Taki plik w przyszłości nie zmieni się, w związku z czym nie spowoduje żadnych problemów z jego buforowaniem.
Jednak jeśli nie stosuje się żadnego schematu wersjonowania przy pracy z plikami, buforowane skrypty, których zawartość zmienia się przy niezmienionej nazwie pliku, mogą stać się nieaktualne. Może to stać się poważnym problemem, ponieważ na przykład uniemożliwia automatyczne wprowadzanie poprawek zabezpieczeń w skryptach, które klienci powinny otrzymać jak najszybciej. Programista będzie musiał podjąć wysiłek, aby zaktualizować takie skrypty w buforze. Ponadto może to spowodować awarie aplikacji, ponieważ kod używany po stronie klienta z bufora różni się od świeżej wersji kodu, na którą opiera się część serwerowa projektu.
Jednak mówiąc o materiałach, które są często aktualizowane (menedżerowie tagów, rozwiązania do testów A/B), ich buforowanie w systemach CDN to zadanie co prawda wykonalne, ale znacznie bardziej skomplikowane. Serwisy takie jak Commanders Act, rozwiązania do zarządzania tagami, przy publikacji nowych wersji korzystają z webhooków. To umożliwia zorganizowanie wyczyszczenia bufora w CDN, lub co jeszcze lepsze, możliwość wywołania aktualizacji hasha lub wersji URL.
▍Adaptacyjne wydawanie materiałów klientom
Ponadto, gdy mówimy o buforowaniu, należy również uwzględnić fakt, że ustawienia buforowania stosowane na CDN mogą nie być odpowiednie dla pewnych zasobów zewnętrznych. Na przykład takie zasoby mogą stosować technologię sniffingu agenta użytkownika (user agent sniffing, adaptive serving), aby dostarczać wersje materiałów zoptymalizowane specjalnie dla tych przeglądarek. Technologie te, aby ustalić możliwości przeglądarki, polegają na wyrażeniach regularnych lub bazie danych, w której zebrane są informacje o nagłówkach HTTP. User-Agent. Dowiadując się, z jaką przeglądarką mają do czynienia, przekazują jej materiały zaprojektowane specjalnie dla niej.
Można tutaj przypomnieć sobie dwa serwisy. Pierwszy to googlefonts.com. Drugi to polyfill.io. Serwis Google Fonts dostarcza, dla pewnego zasobu, różny kod CSS, w zależności od możliwości przeglądarki (podając linki do zasobów w formacie woff2, używając unicode-range).
Oto wyniki kilku zapytań do Google Fonts, wykonanych z różnych przeglądarek.
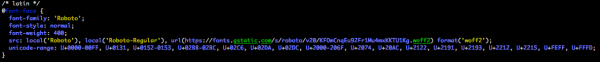
Wynik zapytania do Google Fonts, wykonany z Chrome
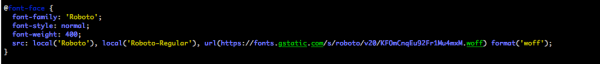
Wynik zapytania do Google Fonts, wykonany z IE10
Polyfill.io przesyła przeglądarkom tylko te polifile, które są potrzebne. Zrobione jest to z powodów wydajności.
Na przykład, przyjrzyjmy się, co się stanie, gdy wykonamy następujące zapytanie z różnych przeglądarek:
W odpowiedzi na takie zapytanie, wykonane z IE10, przyjdzie 34 kB danych. A odpowiedź na nie, wykonana z Chrome, będzie pusta.
Złe: kilka kwestii dotyczących prywatności
Ten punkt jest ostatni w kolejności, ale nie mniej ważny. Chodzi o to, że samodzielne hostowanie zewnętrznych zasobów na głównym domenie projektu lub na jego poddomenie może zagrozić prywatności użytkowników i negatywnie wpłynąć na główny projekt internetowy.
Jeśli twój system CDN jest źle skonfigurowany, może to skończyć się tym, że wyślesz pliki cookie swojej domeny do zewnętrznego serwisu. Jeśli na poziomie CDN nie będzie zorganizowanej odpowiedniej filtracji, twoje sesyjne pliki cookie, które w normalnych warunkach nie mogą być używane w JavaScripcie (z atrybutem httponly), mogą zostać wysłane do obcego hosta.
To może się właśnie zdarzyć z trackerami takimi jak Eulerian czy Criteo. Zewnętrzne trackery mogły umieszczać unikalny identyfikator w plikach cookie. Jeśli były częścią materiałów na stronach, mogły odczytywać identyfikator według własnego uznania w trakcie korzystania przez użytkownika z różnych zasobów internetowych.
Dziś większość przeglądarek zawiera zabezpieczenia przed takim zachowaniem trackerów. W rezultacie teraz trackery wykorzystują technologię , ukrywając się pod własnymi skryptami różnych projektów. A dokładnie, trackery proponują właścicielom stron dodanie do swoich ustawień CNAME dla pewnej domeny, której adres zwykle wygląda jak losowy ciąg znaków.
Chociaż nie jest zalecane, aby pliki cookie witryny były dostępne dla wszystkich poddomen (np. *.website.com), to na wielu stronach się to robi. W takim przypadku takie pliki cookie są automatycznie wysyłane do zamaskowanego zewnętrznego trackera. W rezultacie o jakiejkolwiek prywatności nie można już mówić.
Ponadto to samo dzieje się z nagłówkami HTTP , które są wysyłane tylko do głównej domeny, ponieważ mogą być używane do tworzenia użytkownika. Upewnij się, że używana przez Ciebie usługa CDN odpowiednio filtruje podobne nagłówki.
Podsumowanie
Jeśli zamierzasz wkrótce wdrożyć samodzielne hostowanie zasobów zewnętrznych — pozwól, że podzielę się kilkoma wskazówkami:
- Hostuj najważniejsze biblioteki JS, czcionki i pliki CSS na swoich serwerach. Zmniejszy to ryzyko awarii strony lub spadku jej wydajności w wyniku niedostępności zasobów niezbędnych do działania strony z winy zewnętrznej usługi.
- Zanim zbuforujesz zasoby zewnętrzne na CDN, upewnij się, że w nazewnictwie ich plików używana jest jakaś system wersjonowania, lub masz możliwość zarządzania cyklem życia tych zasobów, ręcznie lub automatycznie czyszcząc pamięć podręczną CDN przy publikacji nowej wersji skryptu.
- Bardzo dokładnie podchodź do ustawień CDN, serwera proxy i pamięci podręcznej. Pomoże to uniknąć wysyłania plików cookie projektu lub nagłówków
Client-Hintsdo zewnętrznych usług.
Drodzy Czytelnicy! Czy umieszczasz na swoich serwerach cudze materiały, które są niezwykle ważne dla działania Twoich projektów?
Źródło: habr.com
