

W tym artykule opisano implementację potoków w jądrze Unix. Byłem nieco rozczarowany, że niedawny artykuł zatytułowany „” okazał się nie dotyczyć wewnętrznej konstrukcji. Zainteresowałem się tym i zagłębiłem się w stare źródła, aby znaleźć odpowiedź.
O co chodzi?
Potoki — „prawdopodobnie najważniejsze wynalazki w Unixie” — to cecha definiująca podstawową filozofię Unix, polegającą na łączeniu małych programów, a także znana komenda w wierszu poleceń:
$ echo hello | wc -c
6
Ta funkcjonalność opiera się na wywołaniu systemowym zapewnianym przez jądro pipe, które opisano w dokumentacji i :
Potoki zapewniają jednokierunkowy kanał komunikacji między procesami. Potok ma wejście (write end) i wyjście (read end). Dane zapisane w wejściu potoku mogą być odczytane na wyjściu.
Potok tworzy się za pomocą wywołania
pipe(2), które zwraca dwa deskryptory plików: jeden wskazuje na wejście potoku, a drugi na wyjście.
Wyniki śledzenia powyższej komendy ilustrują powstawanie potoku i przepływ danych przez niego z jednego procesu do drugiego:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4]) = 0
[pid 2604795] dup2(4, 1) = 1
[pid 2604795] write(1, "hellon", 6) = 6
[pid 2604796] dup2(3, 0) = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2) = 2
Proces macierzysty wywołuje pipe(), aby uzyskać podłączone deskryptory plików. Jeden proces potomny zapisuje do jednego deskryptora, a inny proces odczytuje te same dane z drugiego deskryptora. Powłoka za pomocą dup2 'zmienia nazwy' deskryptorów 3 i 4, aby odpowiadały stdin i stdout.
Bez potoków powłoka musiałaby zapisywać wyniki jednego procesu do pliku i przesyłać je do drugiego procesu, aby ten mógł odczytać dane z pliku. W rezultacie marnowalibyśmy więcej zasobów i miejsca na dysku. Jednak potoki są dobre nie tylko dlatego, że pozwalają uniknąć użycia tymczasowych plików:
Jeśli proces próbuje odczytać z pustego potoku, to
read(2)zablokuje się, aż dane będą dostępne. Jeśli proces spróbuje zapisać do pełnego potoku, towrite(2)będzie zablokowane, dopóki z potoku nie zostanie odczytana wystarczająca ilość danych do wykonania zapisu.
Jak wymaga POSIX, to istotna cecha: zapis do potoku do PIPE_BUF bajtów (minimum 512) musi być atomowy, aby procesy mogły ze sobą współdziałać poprzez potok w sposób, w jaki zwykłe pliki (które takich gwarancji nie zapewniają) nie mogą.
Kiedy używamy zwykłego pliku, proces może zapisać w nim wszystkie swoje dane wyjściowe i przekazać je innemu procesowi. Lub procesy mogą działać w trybie ścisłego równoległego przetwarzania, informując się nawzajem o zakończeniu zapisu lub odczytu za pomocą zewnętrznego mechanizmu sygnalizacyjnego (takiego jak semafor). Potoki oszczędzają nas od wszystkich tych problemów.
Czego szukamy?
Wyjaśnię to na prostym przykładzie, aby łatwiej było sobie wyobrazić, jak może działać potok. Będziesz potrzebować zarezerwować w pamięci bufor oraz pewien stan. Będą potrzebne funkcje do dodawania i usuwania danych z bufora. Będziesz również potrzebować jakiegoś narzędzia do wywoływania funkcji podczas operacji odczytu i zapisu w deskryptorach plików. I będziesz potrzebować blokad, aby zrealizować opisane powyżej specjalne zachowanie.
Teraz jesteśmy gotowi zbadać w jasnym świetle lamp źródłowy kod jądra, aby potwierdzić lub obalić nasz niejasny model myślowy. Ale zawsze bądź gotowy na niespodzianki.
Gdzie szukamy?
Nie wiem, gdzie znajduje się mój egzemplarz znanej książki „„ z kodem źródłowym Unix 6, ale dzięki można poszukać online w jeszcze starszych wersji Unix.
Przemierzanie archiwów TUHS przypomina wizytę w muzeum. Możemy spojrzeć na naszą wspólną historię, a ja czuję szacunek dla wieloletnich wysiłków na rzecz odtworzenia wszystkich tych materiałów bit po bicie ze starych taśm i wydruków. I wyraźnie dostrzegam te fragmenty, które wciąż brakuje.
Zaspokajając swoją ciekawość w zakresie starożytnej historii potoków, dla porównania, możemy przyjrzeć się nowoczesnym jądrami.
Przy okazji, pipe jest numerem wywołania systemowego 42 w tabeli sysent[]. Zbieg okoliczności?
Tradycyjne jądra Unix (1970–1974)
Nie znalazłem żadnych śladów pipe(2) ani w (styczeń 1970 roku), ani w (listopad 1971 roku), ani w niekompletnym kodzie źródłowym (czerwiec 1972 roku).
TUHS twierdzi, że (luty 1973) był pierwszą wersją z potokami:
Trzecia edycja Unix była ostatnią wersją z jądrem napisanym w assemblerze, ale jednocześnie pierwszą wersją z potokami. W 1973 roku trwały prace nad usprawnieniem trzeciej edycji, jądro przepisano w C, co zaowocowało czwartą edycją Unix.
Jeden z czytelników znalazł skan dokumentu, w którym Dag McIlroy zaproponował pomysł "łączenia programów według zasady węża ogrodowego".
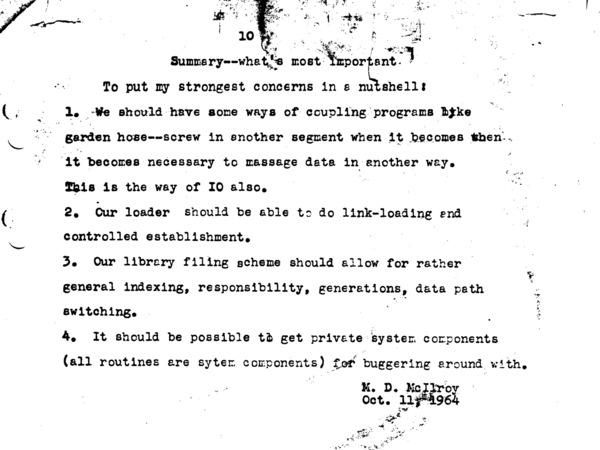
W książce Briana Kernighana "", historia pojawienia się potoków także odnosi się do tego dokumentu: „… wisiał on na ścianie w moim biurze w Bell Labs przez 30 lat”. Oto , a także jedna historia z :
Kiedy pojawił się Unix, moje zainteresowanie korutynami skłoniło mnie do poproszenia autora OS, Kena Thompsona, o umożliwienie przekazywania danych zapisanych w jednym procesie nie tylko na urządzenie, ale i na wyjście do innego procesu. Ken postanowił, że to możliwe. Jednak jako minimalistyczny twórca chciał, aby każda funkcja systemowa odgrywała istotną rolę. Czy bezpośrednie zapisywanie między procesami ma rzeczywiście przewagę nad zapisem do pliku pośredniego? I dopiero gdy złożyłem konkretne propozycje z chwytliwą nazwą "potok" i opisem składni interakcji procesów, Ken w końcu zawołał: "Zrobię to!".
I zrobił. Pewnego wieczoru Ken zmienił jądro i powłokę, poprawił kilka standardowych programów, standaryzując ich procedury przyjmowania danych wejściowych (które mogą pochodzić z potoku), a także zmienił nazwy plików. Następnego dnia potoki zaczęły być powszechnie stosowane w aplikacjach. Pod koniec tygodnia sekretarki wysyłały dokumenty z edytorów tekstu na drukarki z ich pomocą. Niedługo później Ken zastąpił oryginalne API i składnię użycia potoków na czystsze ustalenia, które są stosowane do dziś.
Niestety, kod źródłowy jądra trzeciej edycji Unix jest zagubiony. I chociaż mamy kod źródłowy jądra , wydanej w listopadzie 1973 roku, to jednak ukazał się on kilka miesięcy przed oficjalną premierą i nie zawiera implementacji potoków. Szkoda, że kod źródłowy legendarnej funkcji Unix został stracony, być może na zawsze.
Mamy tekst dokumentacji dotyczącej pipe(2) obu wydań, więc można zacząć od przeszukiwania dokumentacji (pod względem określonych słów, podkreślonych «ręcznie», linia z literalami ^H, po której występuje podkreślenie!). Ten proto-pipe(2) jest napisany w asemblerze i zwraca tylko jeden deskryptor pliku, ale już zapewnia oczekiwaną podstawową funkcjonalność:
Wywołanie systemowe pipe tworzy mechanizm wejścia-wyjścia, zwany potokiem. Zwracany deskryptor pliku można używać do operacji odczytu i zapisu. Kiedy coś jest zapisywane do potoku, buforuje do 504 bajtów danych, po czym proces zapisu zostaje wstrzymany. Przy odczycie z potoku buforowane dane są pobierane.
Do następnego roku jądro zostało przepisane w C, a uzyskało swój nowoczesny wygląd z prototypem «pipe(fildes)»:
Wywołanie systemowe pipe tworzy mechanizm wejścia-wyjścia, zwany potokiem. Zwracane deskryptory plików można używać w operacjach odczytu i zapisu. Gdy coś jest zapisywane do potoku, używany jest deskryptor zwracany w r1 (odpowiednio fildes[1]), buforowane do 4096 bajtów danych, po czym proces zapisu zostaje wstrzymany. Przy odczycie z potoku deskryptor zwracany w r0 (odpowiednio fildes[0]) pobiera dane.
Zakłada się, że po zdefiniowaniu potoku dwa (lub więcej) współdziałające procesy (utworzone przez kolejne wywołania fork) będą przekazywać dane z potoku za pomocą wywołań read i write.
W powłoce występuje składnia pozwalająca na definiowanie liniowej tablicy procesów połączonych za pomocą potoku.
Wywołania odczytu z pustego potoku (niezawierającego buforowanych danych), mającego tylko jeden koniec (wszystkie deskryptory plików do zapisu są zamknięte), zwracają «koniec pliku». Wywołania zapisu w podobnej sytuacji są ignorowane.
Najwcześniejsza odnosi się (czerwiec 1974 roku), ale jest niemal identyczna z tą, która pojawiła się w następnym wydaniu. Dodane zostały jedynie komentarze, więc piątą edycję można pominąć.
Szósta edycja Unix (1975)
Zaczynamy czytać kod źródłowy Unix (maj 1975 roku). Dzięki Lions znalezienie go jest znacznie łatwiejsze niż źródła wcześniejszych wersji:
Od wielu lat książka Lions był jedynym dokumentem dotyczącym jądra Unix dostępnym poza murami Bell Labs. Chociaż licencja szóstej edycji pozwalała nauczycielom na wykorzystanie jej kodu źródłowego, to jednak licencja siódmej edycji tę możliwość wykluczyła, dlatego książka była rozpowszechniana w formie nielegalnych kserokopii.
Dziś można kupić reprint książki, na okładce której widać studentów przy kserokopiarce. A dzięki Warrenowi Toomeyowi (który uruchomił projekt TUHS) można pobrać . Chcę dać ci pojęcie o tym, ile pracy włożono w stworzenie tego pliku:
Ponad 15 lat temu przepisałem kopię kodu źródłowego podanego w Lions, ponieważ nie podobała mi się jakość mojej kopii z nieznanej liczby innych kopii. TUHS nie istniało jeszcze, a ja nie miałem dostępu do starych źródeł. Jednak w 1988 roku znalazłem starą taśmę o 9 ścieżkach, która zawierała kopię zapasową z komputera PDP11. Trudno było określić, czy działa, ale znajdowało się tam nienaruszone drzewo /usr/src/, w którym większość plików była oznaczona rokiem 1979, co już wtedy wyglądało na starożytność. To była siódma edycja lub jej pochodna PWB, jak uważałem.
Wziąłem to znalezisko jako podstawę i ręcznie edytowałem źródła do stanu szóstej edycji. Część kodu pozostała niezmieniona, część musiała zostać lekko poprawiona, zmieniając nowoczesny token += na przestarzały =+. Coś po prostu usunąłem, a coś musiałem przepisać całkowicie, ale nie było tego zbyt wiele.
I dzisiaj możemy online czytać na TUHS kod źródłowy szóstej edycji z .
Przy okazji, na pierwszy rzut oka główną cechą kodu w języku C przed okresem Kerrighana i Ritchie'ego jest jego zwięzłość. Rzadko udaje mi się wstawić fragmenty kodu bez szerokich poprawek, aby pasowały do stosunkowo wąskiego obszaru wyświetlania na mojej stronie.
Na początku znajduje się komentarz wyjaśniający (i tak, są tam też ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
Rozmiar bufora nie zmieniał się od czasów czwartej edycji. Jednak tutaj, bez jakiejkolwiek publicznej dokumentacji, widzimy, że kiedyś potoki używały plików jako zapasowego miejsca przechowywania!
Jeśli chodzi o pliki LARG, to odpowiadają one , która jest używana przez "algorytm dużego adresowania" do przetwarzania w celu wsparcia większych systemów plików. Skoro Ken powiedział, że lepiej ich nie używać, to z chęcią uwierzę mu na słowo.
To jest prawdziwe wywołanie systemowe. pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
W komentarzu jasno opisano, co tu się dzieje. Ale zrozumienie kodu nie jest takie proste, częściowo z powodu tego, jak za pomocą „” oraz rejestrów R0 i R1 są przekazywane parametry wywołań systemowych i wartości zwracane.
Spróbujmy za pomocą umieścić na dysku , a za pomocą – umieścić w pamięci dwa . Jeśli wszystko przebiegnie pomyślnie, ustawimy flagi, aby zdefiniować te pliki jako dwa końce potoku, wskaźmy je w tym samym inode (czyjego licznik odniesień stanie się równy 2), i oznaczymy inode jako zmieniony i używany. Zwróć uwagę na wywołania do w ścieżkach błędów (error paths), aby zmniejszyć licznik odniesień w nowym inode.
pipe() powinien poprzez R0 i R1 zwracać numery deskryptorów plików do odczytu i zapisu. falloc() zwraca wskaźnik na strukturę pliku, ale także „zwraca” przez u.u_ar0[R0] i deskryptor pliku. To znaczy, kod zachowuje w r deskryptorze pliku do odczytu i przypisuje deskryptor do zapisu bezpośrednio z u.u_ar0[R0] po drugim wywołaniu falloc().
Flaga FPIPE, który ustawiliśmy przy tworzeniu potoku, zarządza zachowaniem funkcji , wywołującej konkretne podprogramy wejścia-wyjścia I/O:
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Następnie funkcja readp() do pipe.c odczytuje dane z potoku. Ale lepiej śledzić implementację zaczynając od writep(). Powtarzam, kod stał się bardziej skomplikowany z powodu szczególności konwencji przekazywania argumentów, ale niektóre szczegóły można pominąć.
writep(fp)
{
    register *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

loop:
    /* Jeśli wszystko zrobione, zwróć. */

    plock(ip);
    if(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }

    /*
     * Jeśli nie ma obu stron odczytu i zapisu w
     * rurze aktywnych, zwróć błąd i sygnalizuj też.
     * */

    if(ip->i_count i_size1 == PIPSIZ) {
        ip->i_mode |= IWRITE;
        prele(ip);
        sleep(ip+1, PPIPE);
        goto loop;
    }

    /* Napisz to, co możliwe, i wróć do początku. */

    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ-u.u_offset[1]);
    c -= u.u_count;
    writei(ip);
    prele(ip);
    if(ip->i_mode & IREAD) {
        ip->i_mode &= ~IREAD;
        wakeup(ip+2);
    }
    goto loop;
}
Do wejścia potoku chcemy zapisać bajty u.u_count. Najpierw zażądamy zablokowania indeksowego deskryptora (zob. poniżej plock/prele).
Następnie sprawdzamy licznik linków inode. Z chwilą, gdy oba końce potoku pozostają otwarte, licznik powinien wynosić 2. Trzymamy jeden link (z rp->f_inode), więc jeśli licznik będzie mniejszy niż 2, to powinno to oznaczać, że proces czytający zamknął swój koniec potoku. Innymi słowy, próbujemy pisać do zamkniętego potoku, co jest błędem. Po raz pierwszy kod błędu EPIPE i sygnał SIGPIPE pojawiły się w szóstym wydaniu Unix.
Jednak nawet jeśli potok jest otwarty, może być pełny. W takim przypadku zdejmujemy blokadę i idziemy spać, mając nadzieję, że inny proces odczyta z potoku i zwolni w nim wystarczająco dużo miejsca. Po przebudzeniu wracamy do początku, znowu zakładamy blokadę i rozpoczynamy nową pętlę zapisu.
Jeśli w potoku jest wystarczająco dużo wolnego miejsca, zapisujemy dane za pomocą . Parametr i_size1 w inode'ie (przy pustym potoku może być równy 0) wskazuje na koniec danych, które już się w nim znajdują. Jeśli miejsca na zapis jest wystarczająco dużo, możemy wypełnić potok od i_size1 do PIPESIZ. Następnie zdejmujemy blokadę i próbujemy obudzić każdy proces, który czeka na możliwość odczytu z potoku. Wracamy na początek, aby zobaczyć, czy udało się zapisać tyle bajtów, ile potrzebowaliśmy. Jeśli się nie uda, zaczynamy nową pętlę zapisu.
Zazwyczaj parametr i_mode w inode'ie jest używany do przechowywania uprawnień. r, w i x. Ale w przypadku potoków sygnalizujemy oczekiwanie przez jakiś proces zapisu lub odczytu za pomocą bitów IREAD i IWRITE odpowiednio. Proces ustawia flagę i wywołuje sleep(), a oczekuje się, że w przyszłości jakiś inny proces wywoła wakeup().
Prawdziwa magia dzieje się w sleep() i wakeup(). Są one zaimplementowane w , źródle słynnego komentarza „Nie musisz tego rozumieć” (You are not expected to understand this). Na szczęście nie musimy rozumieć kodu, po prostu przyjrzymy się niektórym komentarzom:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Proces, który wywołuje sleep() dla odpowiedniego kanału, może być później obudzony przez inny proces, który wywoła wakeup() dla tego samego kanału. writep() i readp() koordynują swoje działania za pomocą takich parzystych wywołań. Zauważ, że pipe.c zawsze daje priorytet PPIPE przy wywołaniu sleep(), dlatego wszystkie sleep() mogą być przerywane przez sygnał.
Teraz mamy wszystko, aby zrozumieć funkcję readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Bardzo ostrożne blokowanie. */

    plock(ip);

    /*
     * Jeśli głowa (odczyt) dogoniła
     * ogon (zapis), zresetuj oba do 0.
     * */

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode &= ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Jeśli nie ma aktywnych zarówno czytnika, jak i
         * pisarza, wróć bez
         * zaspokojenia odczytu.
         * */

        prele(ip);
        if(ip->i_count i_mode |= IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Odczytaj i zwróć */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Może być łatwiej zrozumieć tę funkcję od dołu do góry. Część „odczyt i zwróć” jest zazwyczaj używana, gdy w potoku są jakieś dane. W tym przypadku za pomocą czytamy tyle danych, ile jest dostępnych od aktualnego f_offset odczytu, a następnie aktualizujemy wartość odpowiedniego przesunięcia.
Przy następnym odczycie potok będzie pusty, jeśli przesunięcie odczytu osiągnie wartość i_size1 inode'a. Resetujemy pozycję na 0 i próbujemy obudzić każdy proces, który chce zapisać do potoku. Wiemy, że kiedy potok będzie pełny, writep() zaśnie na ip+1. A teraz, gdy potok jest pusty, możemy go obudzić, aby wznowił swój cykl zapisu.
Jeśli nie ma nic do odczytu, to readp() może ustawić flagę IREAD i zaśnąć na ip+2. Wiemy, że obudzi go writep(), gdy zapisze do potoku jakieś dane.
Komentarze do pomogą zrozumieć, że zamiast przekazywać parametry przez „u” możemy traktować je jak zwykłe funkcje wejścia/wyjścia, które biorą plik, pozycję, bufor w pamięci i liczą liczbę bajtów do odczytu lub zapisu.
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
Co do „ostrożnego” blokowania, to readp() i writep() blokują inode, dopóki nie zakończą pracy lub nie otrzymają wynik (to znaczy wywołają wakeup). plock() i prele() działają prosto: przy pomocy innego zestawu wywołań sleep i wakeup pozwalają nam obudzić każdy proces, któremu potrzebna jest blokada, którą właśnie zdjęliśmy:
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
Na początku nie mogłem zrozumieć, dlaczego readp() nie wywołuje prele(ip) przed wywołaniem wakeup(ip+1). Pierwsze, co writep() wywołuje w swojej pętli, to plock(ip), co prowadzi do zablokowania, jeśli readp() nie zdjął jeszcze swojej blokady, więc kod w jakiś sposób musi działać poprawnie. Jeśli się przyjrzeć na wakeup(), to jest jasne, że tylko oznacza proces śpiący jako gotowy do wykonania, aby w przyszłości sched() został naprawdę uruchomiony. Tak więc readp() wywołuje wakeup(), usuwa blokadę, ustawia IREAD i wywołuje sleep(ip+2)— to wszystko przed tym, jak writep() wznawia cykl.
Na tym kończy się opis potoków w szóstej wersji. Prosty kod, dalekosiężne konsekwencje.
(styczeń 1979 roku) była nową główną wersją (po czterech latach), w której pojawiło się wiele nowych aplikacji i właściwości jądra. Zastosowano również znaczne zmiany w związku z użyciem rzutowania typów, unionów i typowanych wskaźników do struktur. Jednak praktycznie się nie zmienił. Możemy tę edycję pominąć.
Xv6, uproszczone jądro podobne do Unix
Na stworzenie jądra wpłynęła szósta edycja Unix, jednak napisane jest w nowoczesnym C, aby mogło działać na procesorach x86. Kod jest łatwy do odczytania, zrozumiały. Co więcej, w przeciwieństwie do źródeł Unix z TUHS, można go skompilować, zmodyfikować i uruchomić na czymś innym poza PDP 11/70. Dlatego to jądro jest szeroko stosowane w uczelniach jako materiał dydaktyczny dotyczący systemów operacyjnych. Źródła .
Kod zawiera zrozumiałą i przemyślaną implementację , wspartą buforem w pamięci zamiast inode na dysku. Tutaj przedstawiam jedynie definicję «potoku strukturalnego» i funkcje pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() ustawia stan całej pozostałej implementacji, która obejmuje funkcje piperead(), pipewrite() i pipeclose(). Faktyczne systemowe wywołanie sys_pipe jest opakowaniem, zaimplementowanym w . Polecam przeczytać cały jego kod. Trudność na poziomie źródła szóstej edycji, ale czyta się znacznie łatwiej i przyjemniej.
Linux 0.01
Można znaleźć źródłowy kod Linux 0.01. Będzie pouczające badać implementację potoków w nim. fs/pipe.c. Tutaj do reprezentacji potoku używa się inode, ale sam potok jest napisany w nowoczesnym C. Jeśli przebrnąłeś przez kod szóstej edycji, nie napotkasz trudności. Tak wygląda funkcja write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* no readers */
        current->signal |= (1<0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Nawet nie patrząc na definicje struktur, można zrozumieć, jak licznik odniesień inode jest używany do sprawdzenia, czy operacja zapisu prowadzi do SIGPIPE. Oprócz operacji bajtowych tę funkcję łatwo przypisać do wcześniej opisanych idei. Nawet logika sleep_on/wake_up nie wydaje się taka obca.
Nowoczesne jądra Linux, FreeBSD, NetBSD, OpenBSD
Szybko przebiegłem przez kilka nowoczesnych jądr. Żadne z nich nie ma już implementacji wykorzystującej dysk (nic dziwnego). W Linux jest własna implementacja. Chociaż trzy nowoczesne jądra BSD zawierają implementacje oparte na kodzie napisanym przez Johna Dixona, z biegiem lat stały się one zbyt różne od siebie.
Aby przeczytać fs/pipe.c (na Linuxie) lub sys/kern/sys_pipe.c (na *BSD), potrzeba prawdziwego poświęcenia. Dziś w kodzie ważne są wydajność i wsparcie funkcji takich jak wektorowe i asynchroniczne operacje wejścia-wyjścia. A szczegóły dotyczące alokacji pamięci, blokad i konfiguracji jądra - wszystko to mocno się różni. To nie jest to, czego należy uczyć na wstępnym kursie o systemach operacyjnych.
W każdym razie zainteresowało mnie odkrycie kilku starych wzorców (np. generowanie SIGPIPE i zwracanie EPIPE przy zapisie do zamkniętego potoku) w tych, tak różnych, nowoczesnych jądrach. Prawdopodobnie nigdy nie zobaczę na żywo komputera PDP-11, ale wciąż można się wiele nauczyć z kodu, który został napisany kilka lat przed moim narodzeniem.
Artykuł napisany przez Divi Kapur w 2011 roku „” jest przeglądem tego, jak działają (nadal) potoki w Linuxie. A ilustruje model potokowy interakcji, którego możliwości przewyższają możliwości plików tymczasowych; a także pokazuje, jak daleko potoki odeszły od „bardzo konserwatywnej blokady” w jądrze Uniksa szóstej wersji.
Źródło: habr.com
