

Nasza firma od 2008 roku zajmuje się głównie zarządzaniem infrastrukturą oraz całodobowym wsparciem technicznym projektów internetowych: mamy ponad 400 klientów, co stanowi około 15% handlu elektronicznego w Rosji. Odpowiednio, wsparcie wiąże się z bardzo zróżnicowaną architekturą. Jeśli coś się psuje, mamy obowiązek naprawić to w ciągu 15 minut. Ale żeby zrozumieć, że wystąpiła awaria, należy monitorować projekt i reagować na incydenty. Jak to zrobić?
Uważam, że w organizacji odpowiedniego systemu monitorowania występuje problem. Gdyby problem nie istniał, moja wypowiedź składałaby się z jednego osądzenia: „Proszę zainstalować Prometheus + Grafana oraz wtyczki 1, 2, 3”. Niestety, teraz tak to nie działa. Główny problem polega na tym, że wszyscy wciąż wierzą w coś, co istniało w 2008 roku, pod względem komponentów oprogramowania.
Jeśli chodzi o organizację systemu monitorowania, odważę się powiedzieć, że… projekty z sensownym monitorowaniem nie istnieją. Sytuacja jest na tyle zła, że jeśli coś upadnie, istnieje ryzyko, że pozostanie niezauważone - wszyscy są pewni, że „wszystko jest monitorowane”.
Być może wszystko jest monitorowane. Ale jak?
Wszyscy spotkaliśmy się z historią podobną do następującej: pracuje jakiś devops, jakiś administrator, przychodzi do nich zespół programistów i mówi - „zrobiliśmy wydanie, teraz przeprowadź monitoring”. Co monitorować? Jak to działa?
Dobrze. Monitorujemy w stary sposób. A to już się zmienia, i okazuje się, że monitorowałeś serwis A, który stał się serwisem B, który współdziała z serwisem C. Ale zespół programistów mówi ci: „Zainstaluj oprogramowanie, ono wszystko powinno monitorować!”
Co się więc zmieniło? - Wszystko się zmieniło!
Rok 2008. Wszystko w porządku.
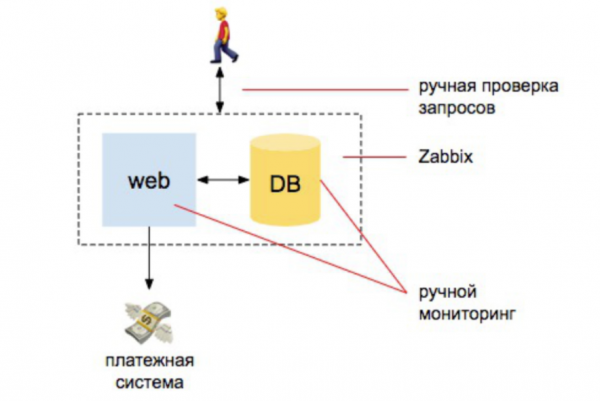
Jest kilku programistów, jeden serwer, jeden serwer bazy danych. Stąd wszystko się zaczyna. Mamy jakieś informacje, instalujemy Zabbix, Nagios, Cacti. A następnie ustawiamy jasne alerty na CPU, na działanie dysków, na miejsce na dyskach. Wykonujemy również kilka ręcznych kontroli, aby sprawdzić, czy strona odpowiada, czy zamówienia trafiają do bazy. I to wszystko - jesteśmy mniej więcej chronieni.
Porównując objętość pracy, którą wówczas wykonywał administrator, aby zapewnić monitoring, to w 98% była automatyczna: osoba zajmująca się monitoringiem musi zrozumieć, jak zainstalować Zabbix, jak go skonfigurować i ustawić alerty. A 2% — na zewnętrzne kontrole: czy strona odpowiada i wykonuje zapytania do bazy, czy przyszły nowe zamówienia.
Rok 2010. Obciążenie rośnie
Zaczynamy skalować systemy webowe, dodajemy silnik wyszukiwania. Chcemy mieć pewność, że katalog produktów zawiera wszystkie produkty. I że wyszukiwanie produktów działa. Że baza działa, że zamówienia są składane, że strona odpowiada zewnętrznie i odpytuje z dwóch serwerów i użytkownika nie wyrzuca ze strony, podczas gdy jest przeładowywana na inny serwer, itd. Obiektów przybywa.
Co więcej, obiekt związany z infrastrukturą wciąż pozostaje największy w głowie menedżera. Wciąż w umyśle tkwi idea, że osoba zajmująca się monitoringiem — to ktoś, kto zainstaluje Zabbix i będzie w stanie go skonfigurować.
Jednak pojawiają się prace związane z przeprowadzaniem zewnętrznych kontroli, tworzeniem zestawu skryptów zapytań dla indeksatora wyszukiwania, zestawu skryptów do weryfikacji, że wyszukiwanie zmienia się w procesie indeksacji, zestawu skryptów, które sprawdzają, że produkty są przekazywane do usługi dostawy, itd.
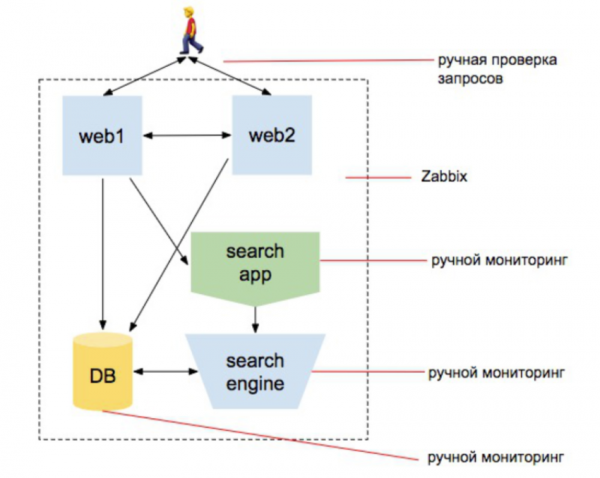
Zauważcie: trzy razy napisałem „zestaw skryptów”. To znaczy, że odpowiedzialny za monitoring — to już nie ten, kto tylko instaluje Zabbix. To osoba, która zaczyna programować. Ale w głowach zespołu na razie nic się nie zmienia.
Ale zmienia się świat, stając się coraz bardziej skomplikowany. Pojawia się warstwa wirtualizacji, kilka nowych systemów. Zaczynają one ze sobą współdziałać. Kto powiedział „pachnie mikroserwisami?” Ale każda usługa wciąż wygląda jak osobna strona. Możemy się do niej zwrócić i zrozumieć, że dostarcza niezbędne informacje i sama w sobie działa. A jeśli jesteś administratorem, który nieprzerwanie zajmuje się projektem rozwijającym się przez 5-7-10 lat, te wiedze się kumulują: pojawia się nowy poziom — ty go dostrzegasz, pojawia się kolejny poziom — ty go dostrzegasz...
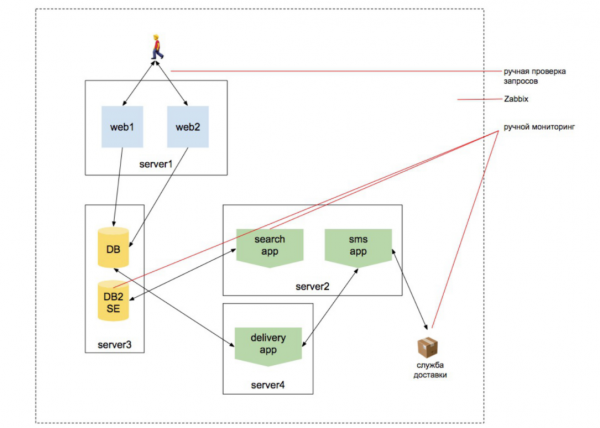
Jednak rzadko kto towarzyszy projektowi przez 10 lat.
Podsumowanie monitoringu
Załóżmy, że dołączyłeś do nowego startupu, który od razu zatrudnił 20 programistów, napisał 15 mikroserwisów, a ty jesteś administratorem, któremu mówią: „Zrób CI/CD. Proszęęę”. Zbudowałeś CI/CD i nagle słyszysz: „Trudno nam pracować z produkcją w ‚kube’, nie rozumiejąc, jak w nim działa aplikacja. Zrób nam piaskownicę w tym samym ‚kube’.”
Robisz piaskownicę w tym kube. Od razu mówią ci: „Chcemy stage bazy danych, która codziennie aktualizuje się z produkcji, aby zrozumieć, że to działa na bazie danych, ale przy tym nie zepsuć bazy danych produkcji”.
Żyjesz w tym wszystkim. Zostały 2 tygodnie do wydania, a oni mówią: „Teraz chcielibyśmy to wszystko zamonitorować…” Tzn. monitorować infrastrukturę klastrową, monitorować architekturę mikroserwisów, monitorować współpracę z zewnętrznymi usługami…
A koledzy wyciągają z pamięci znany schemat i mówią: „To wszystko jest oczywiste! Wstaw program, który to wszystko zamonitoruje”. Tak, tak: Prometheus + Grafana + wtyczki.
I dodają przy tym: „Masz dwa tygodnie, zrób to tak, aby wszystko było niezawodne”.
W szeregu projektów, które widzimy, na monitorowanie przypisuje się jedną osobę. Wyobraź sobie, że chcemy na 2 tygodnie zatrudnić osobę, która zajmie się monitorowaniem, i składamy dla niej CV. Jakie umiejętności powinien mieć ta osoba — biorąc pod uwagę wszystko, co powiedzieliśmy wcześniej?
- Powinna rozumieć monitoring i specyfikę pracy infrastruktury sprzętowej.
- Powinna rozumieć specyfikę monitorowania Kubernetes (wszyscy chcą w ‚kube’, bo można się abstrahować od wszystkiego, schować, bo z resztą poradzi sobie administrator) — jego samego, jego infrastruktury, oraz rozumieć, jak monitorować aplikacje wewnątrz.
- Powinna zrozumieć, że usługi komunikują się między sobą w szczególny sposób i znać specyfikę interakcji usług. Całkiem realne jest zobaczyć projekt, gdzie część usług komunikuje się synchronicznie, bo inaczej nie da się. Na przykład backend idzie przez REST, przez gRPC do usługi katalogu, otrzymuje listę produktów i odsyła z powrotem. Tutaj nie można czekać. A z innymi usługami działa asynchronicznie. Przekazać zamówienie do firmy kurierskiej, wysłać e-mail itp.
Pewnie już opuściłeś się od całego tego zamieszania? A administrator, któremu trzeba to monitorować, ma jeszcze większy chaos. - Musi umieć planować i robić to właściwie — ponieważ pracy przybywa coraz więcej.
- Musiałby zatem opracować strategię dla stworzonej usługi, aby zrozumieć, jak dokładnie to monitorować. Potrzebna mu jest wiedza na temat architektury projektu oraz jego rozwoju, plus znajomość technologii używanych w tworzeniu.
Przypomnijmy sobie całkowicie normalny przypadek: część usług działa na PHP, część na Go, a część na JS. W jakiś sposób współdziałają ze sobą. Stąd wzięło się określenie „mikroserwis”: oddzielnych systemów stało się tak dużo, że programiści nie mogą zrozumieć projektu w całości. Część zespołu pisze usługi na JS, które działają same w sobie i nie wiedzą, jak działa reszta systemu. Inna część pisze usługi na Pythonie i nie interesuje się tym, jak działają inne usługi, są izolowane w swojej dziedzinie. Trzecia grupa — pisze usługi na PHP lub czymś innym.
Wszystkie te 20 osób jest podzielonych na 15 usług i jest tylko jeden administrator, który musi to wszystko zrozumieć. Stop! Właśnie podzieliliśmy system na 15 mikroserwisów, ponieważ 20 osób nie może zrozumieć całego systemu.
Ale trzeba to w jakiś sposób monitorować…
Co z tego wynika? W efekcie jest jedna osoba, która rozumie wszystko, czego nie może zrozumieć cały zespół programistów, i jednocześnie musi znać i umieć to, co wskazaliśmy powyżej — infrastrukturę sprzętową, infrastrukturę Kubernetes itd.
Co tu powiedzieć… Houston, mamy problem.
Monitorowanie nowoczesnego projektu programistycznego — to samodzielny projekt programistyczny.
Z fałszywym przekonaniem, że monitorowanie to oprogramowanie, pojawia się wiara w cuda. A cudów, niestety, nie ma. Nie można postawić Zabbixa i czekać, aż wszystko zacznie działać. Nie ma sensu stawiać Grafany i mieć nadzieję, że wszystko będzie w porządku. Większość czasu poświęci się na organizację weryfikacji pracy usług i ich interakcji między sobą, sprawdzania, jak działają zewnętrzne systemy. Faktycznie 90% czasu zajmie nie pisanie skryptów, a rozwój oprogramowania. I powinna tym się zajmować ekipa, która rozumie działanie projektu.
Jeśli w tej sytuacji jedną osobę postawić na monitorowanie, to dojdzie do katastrofy. Co dzieje się wszędzie.
Na przykład istnieje kilka usług, które komunikują się ze sobą za pośrednictwem Kafka. Przyszedł zamówienie, wysłaliśmy wiadomość o zamówieniu do Kafka. Jest usługa, która nasłuchuje informacji o zamówieniu i zajmuje się wysyłką towaru. Jest usługa, która nasłuchuje informacji o zamówieniu i wysyła wiadomość do użytkownika. A potem pojawia się jeszcze wiele innych usług i zaczynamy się gubić.
A jeśli oddasz to administratorowi i programistom na etapie, gdy do wydania zostaje mało czasu, osoba musi zrozumieć cały ten protokół. Tzn. projekt podobnej skali zajmuje dużo czasu, i w rozwijaniu systemu powinno to być uwzględnione.
Często jednak, szczególnie w startupach, widzimy, jak monitorowanie odkładają na później. "Teraz zrobimy Proof of Concept, uruchomimy go, niech pada - jesteśmy gotowi na poświęcenia. A potem wszystko to będziemy monitorować". Kiedy (lub jeśli) projekt zaczyna przynosić pieniądze, biznes chce rozwijać jeszcze więcej funkcji — bo zaczęło działać, więc trzeba jeszcze więcej dodać! A ty jesteś w punkcie, w którym na początku musisz zamonitować wszystko, co zajmuje więcej niż 1% czasu, a znacznie więcej. I tak, do monitorowania będą potrzebni programiści, a ich łatwiej wysłać na nowe funkcje. W końcu pisane są nowe funkcje, wszystko się rozwija, a ty jesteś w nieskończonym martwym punkcie.
Jak więc zamonitować projekt, zaczynając od samego początku, i co zrobić, jeśli masz projekt, który należy zamonitować, a nie wiesz, od czego zacząć?
Po pierwsze, trzeba planować.
Liryczne odejście: bardzo często zaczynają od monitorowania infrastruktury. Na przykład mamy Kubernetes. Zacznijmy od tego, że zainstalujemy Prometheusa z Grafaną, zainstalujemy wtyczki do monitorowania "kube". Nie tylko programiści, ale także administratorzy mają smutną praktykę: "Zainstalujemy tę wtyczkę, a wtyczka chyba wie, jak to zrobić". Ludzie lubią zaczynać od prostych i zrozumiałych rzeczy, a nie od ważnych działań. A monitorowanie infrastruktury to po prostu prosta rzecz.
Na początku zdecyduj, co i jak chcesz monitorować, a potem dobierz narzędzie, ponieważ inni ludzie nie mogą myśleć za ciebie. I czy powinni? Inni myśleli o sobie, o uniwersalnym systemie – albo w ogóle nie myśleli, kiedy ten plugin był pisany. A to, że ten plugin ma 5 tysięcy użytkowników, nie oznacza, że przynosi jakąkolwiek korzyść. Możliwe, że będziesz 5001-ym tylko dlatego, że wcześniej było tam już 5000 osób.
Jeśli zacząłeś monitorować infrastrukturę, a backend twojej aplikacji przestał odpowiadać, wszyscy użytkownicy stracą połączenie z aplikacją mobilną. Pojawi się błąd. Przyjdą do ciebie i powiedzą: „Aplikacja nie działa, co tutaj robicie?” – „Monitorujemy.” – „Jak możecie monitorować, skoro nie widzicie, że aplikacja nie działa?!"
- Uważam, że monitorowanie należy rozpocząć od punktu wejścia użytkownika. Jeśli użytkownik nie widzi, że aplikacja działa – jest po wszystkim, to porażka. System monitorowania powinien zostać powiadomiony o tym w pierwszej kolejności.
- Dopiero potem możemy monitorować infrastrukturę. Lub zrobić to równolegle. Z infrastrukturą jest łatwiej – w końcu możemy po prostu zainstalować Zabbixa.
- I teraz musimy zajrzeć do korzeni aplikacji, aby zrozumieć, co nie działa.
Moja główna myśl to – monitorowanie powinno iść równolegle z procesem rozwoju. Jeśli oderwiesz zespół monitorujący na inne zadania (tworzenie CI/CD, środowisko testowe, reorganizacja infrastruktury), monitorowanie zacznie się opóźniać i być może już nigdy nie dogonisz rozwoju (lub wcześniej czy później będziesz musiał go zatrzymać).
Wszystko na poziomach
Oto jak widzę organizację systemu monitorowania.
1) Poziom aplikacji:
- monitorowanie logiki biznesowej aplikacji;
- monitorowanie metryk zdrowotnych usług;
- monitorowanie integracyjne.
2) Poziom infrastruktury:
- monitorowanie poziomu orkiestracji;
- monitorowanie oprogramowania systemowego;
- monitorowanie poziomu sprzętu.
3) Znowu poziom aplikacji — ale już jako produkt inżynieryjny:
- zbieranie i obserwacja logów aplikacji;
- APM;
- śledzenie.
4) Alerting:
- organizacja systemu powiadamiania;
- organizacja systemu dyżurów;
- organizacja „bazy wiedzy” i workflow obsługi incydentów.
Ważne: docieramy do alertowania nie później, ale od razu! Nie trzeba uruchamiać monitoringu i „jakoś potem” wymyślać, komu będą wysyłane alerty. W końcu wykonanie monitoringu ma na celu zrozumienie, gdzie w systemie coś działa nieprawidłowo i poinformowanie o tym odpowiednich osób. Jeśli zostawisz to na koniec, odpowiednie osoby dowiedzą się, że coś jest nie tak, dopiero po telefonie „nic u nas nie działa”.
Poziom aplikacji — monitoring logiki biznesowej
Chodzi tutaj o sprawdzenie samego faktu, że aplikacja działa dla użytkownika.
Ten poziom powinien być realizowany na etapie rozwoju. Na przykład mamy hipotetycznego Prometheusa: podchodzi do serwera, który zajmuje się sprawdzaniami, wywołuje endpoint, a ten sprawdza API.
Kiedy często proszą o monitorowanie strony głównej, aby upewnić się, że strona działa, programiści dają rękę, którą można wywołać za każdym razem, gdy trzeba upewnić się, że API działa. A programiści w tym momencie dodatkowo piszą /api/test/helloworld
Jedyny sposób, aby upewnić się, że wszystko działa? — Nie!
- Tworzenie takich testów to w zasadzie zadanie programistów. Testy jednostkowe powinny pisać programiści, którzy piszą kod. Bo jeśli przekażesz to administratorowi „Kolego, oto lista protokołów API wszystkich 25 funkcji, proszę, monitoruj wszystko!” — nic z tego nie wyjdzie.
- Jeśli zrobisz print “hello world”, nikt nigdy nie dowie się, że API powinno działać i rzeczywiście działa. Każda zmiana w API powinna wiązać się z odpowiednią zmianą testów.
- Jeśli już masz taki problem – zatrzymaj funkcje i wyznacz programistów, którzy napiszą te testy, albo pogódź się z stratami, zgódź się, że nic nie jest testowane i będzie się sypać.
Wskazówki techniczne:
- Obowiązkowo zorganizuj zewnętrzny serwer do realizacji testów — musisz być pewny, że Twój projekt jest dostępny dla świata zewnętrznego.
- Zorganizuj testy dla całego protokołu API, a nie tylko dla poszczególnych endpointów.
- Stwórz endpoint prometheus z wynikami testów.
Poziom aplikacji — monitoring metryk zdrowia
Teraz mówimy o zewnętrznych metrykach zdrowia usług.
Zdecydowaliśmy, że wszystkie „endpointy” aplikacji monitorujemy za pomocą zewnętrznych kontroli, które wywołujemy z zewnętrznego systemu monitorowania. Ale to właśnie „endpointy”, które „widzi” użytkownik. Chcemy być pewni, że nasze usługi działają. Tutaj historia jest lepsza: w K8s są zdrowotne kontrole, aby przynajmniej sam „kube” upewnił się, że usługa działa. Ale połowa kontroli, które widziałem, to ten sam print „hello world”. Tzn. wywołuje raz po wdrożeniu, odpowiedział, że wszystko w porządku — i to wszystko. A usługa, jeśli obsługuje swoje API poprzez REST, ma ogromną liczbę punktów wejścia tego samego API, które również musimy monitorować, ponieważ chcemy wiedzieć, że działa. Już to monitorujemy wewnątrz.
Jak to właściwie zrealizować technicznie: każda usługa wystawia endpoint na temat swojej aktualnej sprawności, a na wykresach Grafana (lub dowolnej innej aplikacji) widzimy status wszystkich usług.
- Każda zmiana API powinna prowadzić do zmiany kontroli.
- Nową usługę twórzcie od razu z metrykami zdrowia.
- Administrator może podejść do programistów i poprosić: „napiszcie mi kilka funkcji, abym wszystko rozumiał i dodał informację o tym do swojego systemu monitorowania”. Ale programiści zazwyczaj odpowiadają: „Na dwa tygodnie przed wydaniem nic nie będziemy dodawać.”
Niech menedżerowie projektu wiedzą, że będą takie straty, niech również kierownictwo menedżerów o tym wie. Ponieważ, gdy wszystko upadnie, ktoś i tak zadzwoni i zażąda monitorowania „ciągle spadającej usługi” (c) - Zresztą, wyznaczcie programistów do pisania wtyczek dla Grafana — to będzie dobra pomoc dla administratorów.
Poziom aplikacji — Monitorowanie integracyjne
Monitorowanie integracyjne koncentruje się na monitorowaniu komunikacji między krytycznymi systemami dla biznesu.
Na przykład, jest 15 usług, które komunikują się ze sobą. To już nie są oddzielne witryny. Tzn. nie możemy wywołać usługi samodzielnie, uzyskać /helloworld i zrozumieć, że usługa działa. Ponieważ internetowa usługa składania zamówień musi wysłać informacje o zamówieniu na szynę — z szyny usługa zarządzania magazynem musi otrzymać tę wiadomość i dalej z nią pracować. A usługa wysyłania e-maili musi to jakoś dalej obsłużyć, itd.
W związku z tym nie możemy zrozumieć, badając każdy pojedynczy serwis, jak to wszystko działa. Ponieważ mamy pewną szynę, przez którą wszystko się komunikuję i współdziała.
Dlatego ten etap powinien oznaczać etap testowania serwisów pod kątem współpracy z innymi serwisami. Nie można, monitorując brokera wiadomości, zorganizować monitoringu komunikacji. Jeśli jest serwis, który wydaje dane, oraz serwis, który je przyjmuje, monitorując brokera zobaczymy tylko dane, które przelatują tam i z powrotem. Nawet jeśli jakoś uda nam się zmierzyć interakcję tych danych wewnątrz — że jakiś producent przesyła dane, ktoś je czyta, ten strumień nadal płynie do Kafki — to i tak nie da nam to informacji, jeśli jeden serwis wysłał wiadomość w jednej wersji, a drugi serwis nie spodziewał się tej wersji i ją pominął. Nie dowiemy się o tym, ponieważ nasze serwisy powiedzą, że wszystko działa.
Jak polecam to zrobić:
- Dla synchronnej komunikacji: endpoint wykonuje zapytania do powiązanych serwisów. Tzn. bierzemy ten endpoint, wywołujemy skrypt wewnątrz serwisu, który przeszukuje wszystkie punkty i mówi: „mogę wywołać stąd, i stamtąd, mogę wywołać stąd…"
- Dla asynchronicznej komunikacji: wiadomości przychodzące – endpoint sprawdza szynę pod kątem obecności testowych wiadomości i wydaje status przetwarzania.
- Dla asynchronicznej komunikacji: wiadomości wychodzące – endpoint wysyła testowe wiadomości na szynę.
Jak zazwyczaj to się odbywa: mamy serwis, który rzuca dane na szynę. Przychodzimy do tego serwisu i prosimy go, aby opowiedział o swoim integracyjnym zdrowiu. I jeśli serwis powinien przesłać jakąś wiadomość gdzieś dalej (WebApp), to przesyła tę testową wiadomość. A jeśli wywołujemy serwis po stronie OrderProcessing, najpierw przesyła to, co może przesłać niezależnie, a jeśli są jakieś zależne rzeczy — to czyta z szyny zestaw testowych wiadomości, rozumie, co może przetworzyć, informuje o tym i, jeśli to konieczne, przesyła je dalej, mówiąc o tym — wszystko w porządku, żyję.
Bardzo często słyszymy pytanie „jak możemy to testować na danych produkcyjnych?” Na przykład chodzi o tę samą usługę zamówień. Zamówienie wysyła wiadomości do magazynu, gdzie są odliczane towary: nie możemy tego testować na danych produkcyjnych, ponieważ „moje towary będą się odliczać!” Rozwiązanie: na etapie początkowym zaplanujcie ten cały test. Macie już testy jednostkowe, które robią mocki. Zróbcie to na głębszym poziomie, gdzie będziecie mieli kanał komunikacji, który nie zaszkodzi działalności biznesowej.
Poziom infrastruktury
Monitorowanie infrastruktury – to, co od dawna uważane jest za samo monitorowanie.
- Monitorowanie infrastruktury można i trzeba uruchomić jako osobny proces.
- Nie należy zaczynać od monitorowania infrastruktury w działającym projekcie, nawet jeśli bardzo tego chcecie. To bolączka wszystkich devopsów. „Najpierw zamonituję klaster, zamonituję infrastrukturę” – to znaczy, że najpierw monitoruje to, co leży na dole, a do aplikacji nie sięgnie. Ponieważ aplikacja to niejasna sprawa dla devopsa. Została mu przekazana, i nie rozumie, jak to działa. Natomiast infrastrukturę rozumie i zaczyna od niej. Ale nie – zawsze na początku należy monitorować aplikację.
- Nie przesadzajcie z ilością powiadomień. Biorąc pod uwagę złożoność nowoczesnych systemów, alerty przychodzą nieustannie, a z tą masą alertów trzeba jakoś żyć. A osoba on-call, patrząc na setki kolejnych alertów, pomyśli „nie chcę o tym myśleć”. Alerty powinny informować tylko o krytycznych kwestiach.
Poziom aplikacji jako jednostki biznesowej
Kluczowe punkty:
- ELK. To standard przemysłowy. Jeśli z jakiegoś powodu nie agregujecie logów, jak najszybciej zacznijcie to robić.
- APM. Zewnętrzne APM jako sposób na szybkie zamknięcie monitorowania aplikacji (NewRelic, BlackFire, Datadog). Możecie tymczasowo zainstalować to, aby choć w jakiś sposób zrozumieć, co się u Was dzieje.
- Tracing. W dziesiątkach mikrousług musicie wszystko śledzić, ponieważ zapytanie już nie istnieje samo w sobie. Bardzo trudno jest dodać to później, dlatego lepiej zaplanować tracing w procesie rozwoju – to praca i narzędzie dla programistów. Jeśli jeszcze nie wdrożyliście – wdrażajcie! Zobaczcie Jaeger/Zipkin.
Alerting
- Organizacja systemu powiadomień: w warunkach monitorowania wielu rzeczy powinna istnieć jednolita system powiadomień. Można to zrobić w Grafana. Na Zachodzie wszyscy używają PagerDuty. Powiadomienia powinny być jasne (na przykład, skąd pochodzą…). Dobrze by było również kontrolować, czy powiadomienia w ogóle docierają.
- Organizacja systemu dyżurów: alerty nie powinny przychodzić do wszystkich (albo wszyscy będą w tłumie reagować, albo nikt nie zareaguje). Oncall powinien być również dla programistów: koniecznie określcie obszary odpowiedzialności, stwórzcie jasną instrukcję i zapiszcie w niej, do kogo konkretnie dzwonić w poniedziałek i środę, a do kogo — we wtorek i piątek (w przeciwnym razie nikt nie zadzwoni nawet w przypadku poważnych problemów — będą się bać obudzić innych, bo ludzie generalnie nie lubią dzwonić i budzić innych, zwłaszcza w nocy). Wyjaśnijcie, że proszenie o pomoc nie jest oznaką niekompetencji („proszę o pomoc — więc jestem złym pracownikiem”), zachęcajcie do prośby o pomoc.
- Organizacja „bazy wiedzy” i workflow przetwarzania incydentów: dla każdego poważnego incydentu powinien być zaplanowany postmortem, jako tymczasowy środek powinny być zapisane działania, które rozwiążą incydent. Wprowadźcie praktykę, że powtarzające się alerty to grzech; należy je naprawić w kodzie lub pracach infrastrukturalnych.
Stos technologiczny
Załóżmy, że nasz stos technologiczny wygląda następująco:
- zbieranie danych — Prometheus + Grafana;
- analiza logów — ELK;
- dla APM lub Tracing — Jaeger (Zipkin).

Wybór opcji nie jest krytyczny. Ponieważ, jeśli na początku rozumiesz, jak monitorować system i opracowujesz plan, to potem zaczynasz wybierać narzędzia zgodnie z własnymi wymaganiami. Chodzi o to, co zdecydowałeś się monitorować na początku. Ponieważ być może narzędzie, które wybrałeś na początku — w ogóle nie spełnia twoich wymagań.
Kilka technicznych punktów, które widzę ostatnio wszędzie:
Prometheus wpychają do Kubernetes — kto to wymyślił?! Co zrobisz, jeśli twój klaster się zawali? Jeśli masz złożony klaster wewnątrz, to powinna działać pewna system monitorowania wewnątrz klastra, a pewna — na zewnątrz, która będzie zbierać dane z wnętrza klastra.
Wewnątrz klastra zbieramy logi i wszystko inne. Systemy monitorowania powinny być umieszczone na zewnątrz. Bardzo często w klastrze, w którym zainstalowano Promtheus, znajdują się systemy przeprowadzające zewnętrzne kontrole działania strony. A co jeśli połączenia zewnętrzne padły i aplikacja nie działa? W środku wszystko może być w porządku, ale użytkownicy tego nie odczują.
Wnioski
- Rozwój monitoringu to nie instalacja narzędzi, lecz tworzenie produktu programistycznego. 98% dzisiejszego monitoringu to kodowanie. Kodowanie w usługach, kodowanie zewnętrznych kontroli, sprawdzanie zewnętrznych serwisów i tak dalej.
- Nie żałujcie czasu deweloperów na monitoring: to może zająć do 30% ich pracy, ale warto.
- DevOpsy, nie martwcie się, jeśli nie jesteście w stanie czegoś monitorować, bo niektóre rzeczy to zupełnie inny sposób myślenia. Nie byliście programistami, a praca monitoringu to właśnie ich zadanie.
- Jeżeli projekt już działa i nie jest monitorowany (a ty jesteś menedżerem) — przeznacz zasoby na monitoring.
- Jeżeli produkt już jest w produkcji, a ty jesteś devopsem, któremu powiedziano „skonfiguruj monitoring” — spróbuj wytłumaczyć kierownictwu to, o czym napisałem.
To rozszerzona wersja prezentacji na konferencji Saint Highload++.
Jeśli interesują cię moje pomysły i refleksje na temat IT i pokrewnych zagadnień, to możesz 🙂
Źródło: habr.com
