

Wprowadzenie do systemów operacyjnych
Cześć, Habr! Chcę przedstawić Wam serię artykułów-przekładów jednej ciekawej literatury — OSTEP. W tym materiale omawiane są dość dogłębnie zasady działania systemów operacyjnych typu unix, a mianowicie — praca z procesami, różnymi planistami, pamięcią i innymi podobnymi komponentami, które składają się na nowoczesny system operacyjny. Oryginał wszystkich materiałów można zobaczyć tutaj . Proszę pamiętać, że tłumaczenie zostało wykonane w sposób nieprofesjonalny (dosyć luźno), ale mam nadzieję, że ogólny sens zachowałem.
Laboratoria dotyczące tego tematu można znaleźć tutaj:
- oryginał:
- oryginał:
- moja osobista adaptacja:
Inne części:
Możecie również zajrzeć na mój kanał w =)
Rozważmy najbardziej fundamentalną abstrakcję, którą system operacyjny oferuje użytkownikom: proces. Definicja procesu jest dość prosta — to działająca aplikacja. Program sam w sobie jest bezżywotnym obiektem, znajdującym się na dysku — to zestaw instrukcji i być może jakieś statyczne dane, które czekają na moment uruchomienia. To system operacyjny bierze te bajty i uruchamia je, przekształcając program w coś użytecznego.
Najczęściej użytkownicy chcą uruchamiać więcej niż jeden program jednocześnie, na przykład możesz uruchomić na swoim laptopie przeglądarkę, grę, odtwarzacz multimedialny, edytor tekstu i tym podobne. W rzeczywistości typowy system może uruchamiać dziesiątki, a nawet setki procesów jednocześnie. Fakt ten sprawia, że system jest łatwiejszy w użyciu, nigdy nie musisz się martwić o to, czy CPU jest wolny, po prostu uruchamiasz programy.
Stąd wynika problem: jak zapewnić iluzję wielu CPU? Jak system operacyjny może stworzyć iluzję praktycznie nieskończonej liczby CPU, nawet jeśli masz tylko jeden fizyczny CPU?
System operacyjny tworzy tę iluzję poprzez wirtualizację CPU. Uruchamiając jeden proces, następnie go zatrzymując, uruchamiając inny proces i tak dalej, system operacyjny może utrzymywać iluzję istnienia wielu wirtualnych CPU, chociaż faktycznie będzie to jeden lub kilka fizycznych procesorów. Technika ta nazywa się dzieleniem zasobów CPU w czasieTa technika pozwala użytkownikom uruchamiać tyle równoległych procesów, ile chcą. Kosztem tego rozwiązania jest wydajność – ponieważ jeśli CPU dzieli wiele procesów, każdy proces będzie przetwarzany wolniej.
Aby zrealizować wirtualizację CPU, a zwłaszcza aby robić to dobrze, system operacyjny potrzebuje zarówno wsparcia niskopoziomowego, jak i wysokopoziomowego. Wsparcie niskopoziomowe nazywane jest mechanizmami – to niskopoziomowe metody lub protokoły, które wdrażają potrzebną część funkcjonalności. Przykładem takiej funkcjonalności jest przełączanie kontekstu, które pozwala systemowi operacyjnemu wstrzymać jeden program i uruchomić na procesorze inny program. Takie podział czasu jest realizowany we wszystkich nowoczesnych systemach operacyjnych.
Na szczycie tych mechanizmów znajduje się pewna logika, zakodowana w systemie operacyjnym, w postaci „polityk”. Polityka – to pewien algorytm podejmowania decyzji przez system operacyjny. Takie polityki, na przykład, decydują, który program trzeba uruchomić (z listy zadań) w pierwszej kolejności. Na przykład, takie zadanie rozwiąże polityka nazywana polityką harmonogramu (scheduling policy) i przy wyborze decyzji będzie kierować się takimi danymi jak: historia uruchamiania (który program był uruchomiony najdłużej w ostatniej minucie), jakie obciążenie generuje dany proces (jakie typy programów zostały uruchomione), metryki wydajności (czy system jest zoptymalizowany do interaktywnej współpracy, czy do przepustowości) i tak dalej.
Abstrakcja: proces
Abstrakcja działającego programu, wykonywana przez system operacyjny, to to, co nazywamy proces. Jak już wspomniano wcześniej, proces to po prostu działający program w każdym momencie czasowym. Program, za pomocą którego możemy uzyskać zbiorcze informacje z różnych zasobów systemu, do których ten program się odnosi lub które te program obejmuje w trakcie swojego działania.
Aby zrozumieć składniki procesu, należy zrozumieć stany systemu: co program może odczytywać lub modyfikować podczas swojej pracy. W każdym momencie czasu należy znać, które elementy systemu są istotne dla wykonania programu.
Jednym z oczywistych elementów stanu systemu, które obejmuje proces, jest pamięć. Instrukcje są umieszczane w pamięci. Dane, które program odczytuje lub zapisuje, także znajdują się w pamięci. W ten sposób pamięć, którą proces może adresować (tzw. przestrzeń adresowa), jest częścią procesu.
Częścią stanu systemu są również rejestry. Wiele instrukcji ma na celu zmianę wartości rejestrów lub ich odczyt, w ten sposób rejestry stają się istotną częścią działania procesu.
Należy zauważyć, że stan maszyny jest również formowany przez niektóre specjalne rejestry. Na przykład, IP — wskaźnik instrukcji — wskazuje na instrukcję, którą program wykonuje w danymmomencie. Istnieje także wskaźnik stosu i związany z nim wskaźnik ramki, które są używane do zarządzania: parametrami funkcji, zmiennymi lokalnymi i adresami powrotu.
Na koniec programy często odwołują się do ROM (pamięci stałej). Tego rodzaju informacje o „I/O” (wejście-wyjście) powinny zawierać listę plików, które są aktualnie otwarte przez proces.
API Procesu
Aby poprawić zrozumienie działania procesu, zbadamy przykłady wywołań systemowych, które powinny być zawarte w każdym interfejsie systemu operacyjnego. Te API są w tej czy innej formie dostępne na każdym systemie operacyjnym.
● Utwórz (tworzenie): W systemie operacyjnym musi być dostępna jakakolwiek metoda umożliwiająca tworzenie nowych procesów. Gdy wprowadzasz polecenie w terminalu lub uruchamiasz aplikację przez podwójne kliknięcie ikony, wysyłane jest żądanie do systemu operacyjnego o stworzenie nowego procesu i uruchomienie wskazanej aplikacji.
● Usunięcie: Skoro istnieje interfejs do tworzenia procesu, system operacyjny powinien również umożliwić wymuszone zakończenie procesu. Większość programów naturalnie będzie się uruchamiać i kończyć sama w miarę wykonywania. W przeciwnym razie użytkownik chciałby mieć możliwość zakończenia ich, w związku z czym interfejs do zatrzymania procesu będzie przydatny.
● Oczekiwanie (oczekiwanie): Czasami przydatne jest, aby poczekać na zakończenie procesu, dlatego zapewniane są różne interfejsy umożliwiające oczekiwanie.
● Inna kontrola (różne zarządzanie): Oprócz zabijania i oczekiwania na proces istnieją także inne różnorodne metody kontrolne. Na przykład większość systemów operacyjnych oferuje możliwość zamrażania procesu (wstrzymanie jego wykonywania na pewien czas) i następne wznowienie (kontynuację wykonywania)
● Status (stan): Istnieją różne interfejsy do uzyskania informacji o statusie procesu, takie jak czas jego działania lub w jakim stanie obecnie się znajduje.
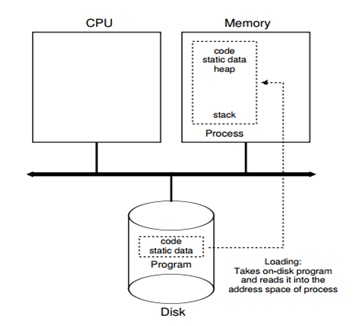
Tworzenie procesu: szczegóły
Jedną z interesujących rzeczy jest to, jak programy przekształcają się w procesy. Szczególnie to, jak system operacyjny podnosi i uruchamia program. Jak dokładnie tworzony jest proces.
W pierwszej kolejności system operacyjny musi załadować kod programu i dane statyczne do pamięci (do przestrzeni adresowej procesu). Programy zazwyczaj znajdują się na dysku lub nośniku SSD w odpowiednim formacie wykonywalnym. W związku z tym proces ładowania programu i danych statycznych do pamięci wymaga od systemu operacyjnego możliwości odczytu tych bajtów z dysku i umieszczenia ich gdzieś w pamięci.
W poprzednich systemach operacyjnych proces ładowania był wykonywany niecierpliwie (eagerly), co oznacza, że kod był ładowany do pamięci w całości przed uruchomieniem programu. Nowoczesne systemy operacyjne robią to leniwie (lazily), czyli ładując kawałki kodu lub danych tylko wtedy, gdy są one potrzebne programowi podczas jego wykonywania.
Po załadowaniu kodu i danych statycznych do pamięci, system operacyjny musi wykonać jeszcze kilka czynności przed uruchomieniem procesu. Musi zostać przydzielona pewna ilość pamięci na stos. Programy używają stosu do zmiennych lokalnych, parametrów funkcji i adresów powrotu. System operacyjny przydziela tę pamięć i przekazuje ją procesowi. Stos może być również przydzielany z pewnymi argumentami, w szczególności wypełnia parametry funkcji main(), takie jak tablice argc i argv.
System operacyjny może także przydzielać pewną ilość pamięci na stertę (heap) programu. Stos jest używany przez programy do jawnie żądanych dynamicznie przydzielonych danych. Programy żądają tej przestrzeni, wywołując funkcję malloc() i jawnie ją zwalniają, wywołując funkcję free(). Stos używany jest dla struktur danych jak: listy powiązane, tabele haszowe, drzewa i inne. Na początku alokowana jest mała ilość pamięci dla stosu, ale z czasem w trakcie działania programu stos może zażądać większej ilości pamięci poprzez wywołanie API malloc(). System operacyjny jest zaangażowany w proces alokacji większej ilości pamięci, aby pomóc w zaspokojeniu tych żądań.
System operacyjny będzie również realizował zadania inicjalizacji, w szczególności te dotyczące wejścia-wyjścia. Na przykład w systemach UNIX każdy proces domyślnie ma 3 otwarte deskryptory plików dla standardowego strumienia wejścia, wyjścia i błędów. Deskryptory te umożliwiają programom odczytywanie wejścia z terminala oraz wypisywanie informacji na ekran.
W ten sposób, ładując kod i dane statyczne do pamięci, tworząc i inicjalizując stos oraz wykonując inne prace związane z realizacją zadań wejścia-wyjścia, system operacyjny przygotowuje grunt do realizacji procesu. Ostatecznie pozostaje ostatnie zadanie: uruchomienie programu przez jego punkt wejścia, zwany funkcją main(). Przechodząc do realizacji funkcji main(), system operacyjny przekazuje kontrolę CPU nowo utworzonemu procesowi, w ten sposób program zaczyna się wykonywać.
Stan procesu
Teraz, gdy mamy pewne zrozumienie, czym jest proces i jak jest tworzony, wymieńmy stany procesu, w których może się znajdować. W najprostszej formie proces może znajdować się w jednym z tych stanów:
● Running. W stanie uruchomionym proces jest realizowany na procesorze. Oznacza to, że następuje wykonanie instrukcji.
● Gotowy. W stanie gotowości proces jest gotowy do uruchomienia, ale z jakiegoś powodu system operacyjny nie wykonuje go w danej chwili.
● Zablokowany. W stanie zablokowanym proces wykonuje pewne operacje, które uniemożliwiają mu bycie gotowym do wykonania, dopóki nie wystąpi jakieś zdarzenie. Przykładem może być, gdy proces inicjalizuje operację IO, staje się zablokowany, a w ten sposób inny proces może używać procesora.
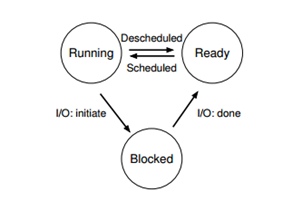
Można wyobrazić sobie te stany jako graf. Jak możemy zobaczyć na ilustracji, stan procesu może się zmieniać między RUNNING a READY według uznania systemu operacyjnego. Gdy stan procesu zmienia się z READY na RUNNING, oznacza to, że proces został zaplanowany. W przeciwną stronę — usunięty z kolejki. W momencie, gdy proces staje się BLOCKED, na przykład, inicjując operację IO, system operacyjny będzie utrzymywał go w tym stanie do momentu wystąpienia pewnego wydarzenia, na przykład zakończenia IO. W tym momencie nastąpi przejście w stan READY, a być może natychmiast do stanu RUNNING, jeśli tak zdecyduje system operacyjny.
Przyjrzyjmy się przykładowi, jak dwa procesy przechodzą przez te stany. Na początek wyobraźmy sobie, że oba procesy są uruchomione i każde z nich używa tylko CPU. W takim przypadku ich stany będą wyglądały następująco.
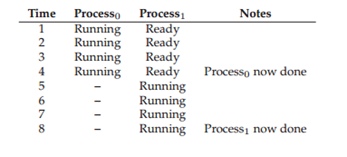
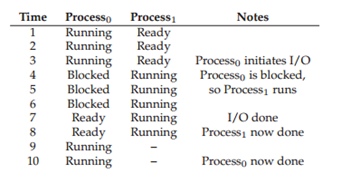
W następnym przykładzie pierwszy proces po pewnym czasie pracy żąda IO i przechodzi w stan BLOCKED, dając drugiemu procesowi możliwość uruchomienia (RYS. 1.4). System operacyjny widzi, że proces 0 nie korzysta z CPU i uruchamia proces 1. W trakcie wykonywania procesu 1 — IO kończy się i status procesu 0 zmienia się na READY. Na koniec proces 1 kończy się, a po jego zakończeniu proces 0 jest uruchamiany, wykonuje swoje zadanie i kończy pracę.
Struktura danych
System operacyjny sam w sobie jest programem, a jak każdy inny program ma pewne kluczowe struktury danych, które śledzą różnorodne istotne informacje. Aby śledzić stan każdego procesu, system operacyjny będzie utrzymywał pewien lista procesów dla wszystkich procesów w stanie READY oraz dodatkowe informacje do śledzenia procesów, które są aktualnie wykonywane. Ponadto system operacyjny musi śledzić również zablokowane procesy. Po zakończeniu IO, system operacyjny musi obudzić odpowiedni proces i przenieść go w stan gotowości do uruchomienia.
Na przykład, system operacyjny musi zapisać stan rejestrów procesora. W momencie zatrzymania procesu stan rejestrów jest zapisany w przestrzeni adresowej procesu, a w momencie wznowienia jego pracy — przywraca wartości rejestrów, a tym samym kontynuuje wykonywanie tego procesu.
Oprócz stanów gotowych, zablokowanych i działających istnieją również inne stany. Czasami w momencie tworzenia proces może mieć stan INIT. W końcu proces może być umieszczony w stanie FINAL, gdy już zakończył działanie, ale informacje o nim nie zostały jeszcze usunięte. W systemach UNIX taki stan nazywa się procesem-zombie. Ten stan jest przydatny, gdy proces macierzysty chce poznać kod zwrotu procesu potomnego; zazwyczaj 0 informuje o pomyślnym zakończeniu, a 1 o błędzie, jednak programiści mogą używać dodatkowych kodów wyjścia, sygnalizując różne problemy. Po zakończeniu proces macierzysty wykonuje ostatnie wywołanie systemowe, na przykład wait(), aby poczekać na zakończenie pracy procesu potomnego i poinformować system operacyjny, że można usunąć wszelkie dane związane z zakończonym procesem.
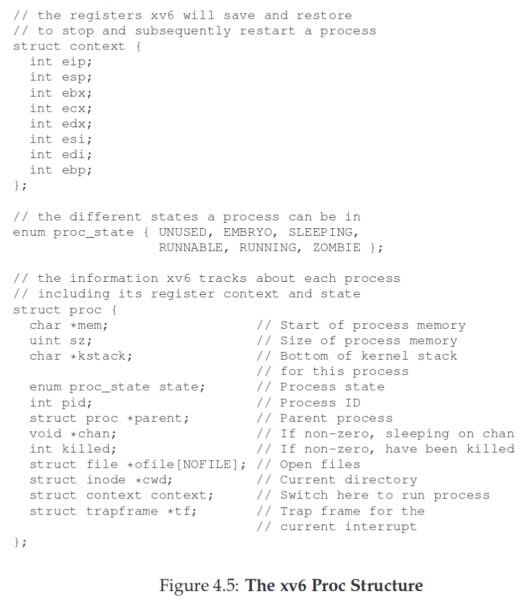
Kluczowe punkty wykładu:
● Proces — główna abstrakcja działającego programu w systemie operacyjnym. W każdej chwili proces można opisać przez jego stan: zawartość pamięci w jego przestrzeni adresowej, zawartość rejestrów procesora, w tym wskaźnik instrukcji i wskaźnik stosu oraz informację o IO, na przykład o otwartych plikach, które są odczytywane lub zapisywane.
● API Procesu składa się z wywołań, które programy mogą dokonywać w odniesieniu do procesów. Zwykle są to wywołania tworzenia, usuwania lub inne.
● Proces znajduje się w jednym z wielu stanów, w tym działaniu, gotowości, zablokowanym. Różne wydarzenia, takie jak planowanie, wyjątek z planowania lub oczekiwanie mogą zmieniać stan procesu z jednego na inny.
● Lista procesów zawiera informacje o wszystkich procesach w systemie. Każdy wpis w niej nazywa się blokiem sterującym procesu, który w rzeczywistości jest strukturą, zawierającą wszystkie niezbędne informacje o danym procesie.
Źródło: habr.com
