

Architektura sterowana zdarzeniami zwiększa efektywność kosztową wykorzystywanych zasobów, ponieważ są one angażowane tylko w momencie, gdy są potrzebne. Istnieje wiele sposobów na to, aby to zrealizować i nie tworzyć dodatkowych chmurowych bytów jako aplikacji roboczych. Dziś nie omówię FaaS, a skupię się na webhookach. Pokażę prosty przykład przetwarzania zdarzeń przy użyciu webhooków w obiektowym magazynie.
Kilka słów o obiektowym magazynie i webhookach. Obiektowe magazyny pozwalają przechowywać dowolne dane w chmurze w postaci obiektów, dostępnych przez S3 lub inne API (w zależności od realizacji) za pośrednictwem HTTP/HTTPS. Webhooki (webhooks) w ogólnym przypadku to użytkownikowskie wywołania zwrotne za pomocą HTTP. Zwykle są uruchamiane przez zdarzenie, takie jak przesłanie kodu do repozytorium lub komentarz publikowany na blogu. Gdy zdarzenie występuje, strona źródłowa wysyła żądanie HTTP pod wskazany adres URL dla webhooka. W efekcie można sprawić, że zdarzenia na jednej stronie wywołują działania na innej. W przypadku, gdy stroną źródłową jest obiektowe magazyn, zmiany jego zawartości pełnią rolę zdarzeń.). W przypadku, gdy źródłowym serwisem jest obiektowa pamięć masowa, zdarzeniami są zmiany jej zawartości.
Przykłady prostych przypadków, w których można wykorzystać taką automatyzację:
- Tworzenie kopii wszystkich obiektów w innym obiektowym magazynie. Kopie powinny być tworzone 'na bieżąco', przy każdym dodaniu lub zmianie plików.
- Automatyczne tworzenie serii miniaturek plików graficznych, dodawanie znaków wodnych do zdjęć, inne modyfikacje obrazów.
- Powiadomienie o nadejściu nowych dokumentów (na przykład, rozproszona służba rachunkowości umieszcza w chmurze raporty, a monitoring finansowy otrzymuje powiadomienia o nowych raportach, sprawdza i analizuje je).
- Nieco bardziej złożone przypadki dotyczą na przykład generowania zapytania do Kubernetes, które tworzy pod z odpowiednimi kontenerami, przekazuje mu parametry zadania, a po przetworzeniu zamyka kontener.
Jako przykład zrealizujemy wariant zadania 1, w którym zmiany w wiadrze obiektowego magazynu Mail.ru Cloud Solutions (MCS) są synchronizowane w obiektowym magazynie AWS za pomocą webhooków. W rzeczywistym przypadku obciążenia należy przewidzieć asynchroniczną pracę poprzez rejestrację webhooków w kolejce, ale dla ćwiczenia zrealizujemy implementację bez tego.
Schemat działania
Protokół interakcji jest szczegółowo opisany w . W schemacie działania znajdują się następujące elementy:
- Usługa publikacji, która znajduje się po stronie magazynu S3 i publikuje zapytania HTTP przy wyzwoleniu webhooka.
- Serwer odbioru webhooków, który nasłuchuje zapytań usługi publikacji za pomocą HTTP i wykonuje odpowiednie akcje. Serwer może być napisany w dowolnym języku, w naszym przykładzie napiszemy serwer w Go.
Cechą realizacji webhooków w API S3 — rejestracja serwera odbioru webhooków w usłudze publikacji. W szczególności serwer odbioru webhooków musi potwierdzić subskrypcję wiadomości usługi publikacji (w innych realizacjach webhooków zazwyczaj potwierdzenie subskrypcji nie jest wymagane).
W związku z tym serwer odbioru webhooków musi obsługiwać dwie podstawowe operacje:
- odpowiadać na zapytanie usługi publikacji o potwierdzenie rejestracji,
- przetwarzać nadchodzące zdarzenia.
Instalacja serwera odbioru webhooków
Aby uruchomić serwer odbioru webhooków, potrzebny jest serwer Linux. W tym artykule jako przykład użyjemy wirtualnego instancji, który uruchamiamy na MCS.
Zainstalujemy niezbędne oprogramowanie i uruchomimy serwer odbioru webhooków.
ubuntu@ubuntu-basic-1-2-10gb:~$ sudo apt-get install git
Czytanie list pakietów... Gotowe
Budowanie drzewa zależności
Czytanie informacji o stanie... Gotowe
Następujące pakiety zostały automatycznie zainstalowane i nie są już wymagane:
 bc dns-root-data dnsmasq-base ebtables landscape-common liblxc-common
liblxc1 libuv1 lxcfs lxd lxd-client python3-attr python3-automat
python3-click python3-constantly python3-hyperlink
 python3-incremental python3-pam python3-pyasn1-modules
python3-service-identity python3-twisted python3-twisted-bin
python3-zope.interface uidmap xdelta3
Użyj 'sudo apt autoremove', aby je usunąć.
Sugestie pakietów:
 git-daemon-run | git-daemon-sysvinit git-doc git-el git-email git-gui
gitk gitweb git-cvs git-mediawiki git-svn
Następujące NOWE pakiety zostaną zainstalowane:
 git
0 zaktualizowanych, 1 nowo zainstalowany, 0 do usunięcia i 46 nie zaktualizowanych.
Trzeba pobrać 3915 kB archiwów.
Po tej operacji dodatkowe 32,3 MB miejsca na dysku będzie używane.
Pobranie:1 http://MS1.clouds.archive.ubuntu.com/ubuntu bionic-updates/main
amd64 git amd64 1:2.17.1-1ubuntu0.7 [3915 kB]
Pobrano 3915 kB w 1s (5639 kB/s)
Wybieranie wcześniej niewybranego pakietu git.
(Czytanie bazy danych ... 53932 pliki i katalogi obecnie zainstalowane.)
Przygotowywanie do wypakowania .../git_12.17.1-1ubuntu0.7_amd64.deb ...
Wypakowywanie git (1:2.17.1-1ubuntu0.7) ...
Konfigurowanie git (1:2.17.1-1ubuntu0.7) ...
Klonujemy folder z serwerem odbioru webhooków:
ubuntu@ubuntu-basic-1-2-10gb:~$ git clone
https://github.com/RomanenkoDenys/s3-webhook.git
Klonowanie do 's3-webhook'...
remote: Wyliczanie obiektów: 48, gotowe.
remote: Liczenie obiektów: 100% (48/48), gotowe.
remote: Kompresowanie obiektów: 100% (27/27), gotowe.
remote: Łącznie 114 (delta 20), wykorzystano 45 (delta 18), pack-reused 66
Odbieranie obiektów: 100% (114/114), 23.77 MiB | 20.25 MiB/s, gotowe.
Rozwiązywanie delt: 100% (49/49), gotowe.
Uruchamiamy serwer:
ubuntu@ubuntu-basic-1-2-10gb:~$ cd s3-webhook/
ubuntu@ubuntu-basic-1-2-10gb:~\/s3-webhook$ sudo .\/s3-webhook -port 80
Subskrypcja usługi publikacji
Możesz zarejestrować swój serwer do odbioru webhooków za pomocą API lub interfejsu webowego. Dla prostoty zarejestrujemy go przez interfejs webowy:
- w panelu zarządzania.
- Wchodzimy do bucketa, dla którego będziemy konfigurować webhooki, i klikamy na ikonę koła zębatego:
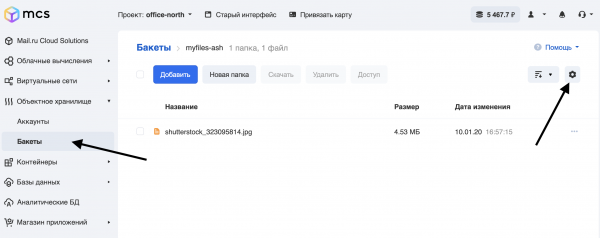
Przechodzimy do zakładki Webhooks i klikamy Dodaj:
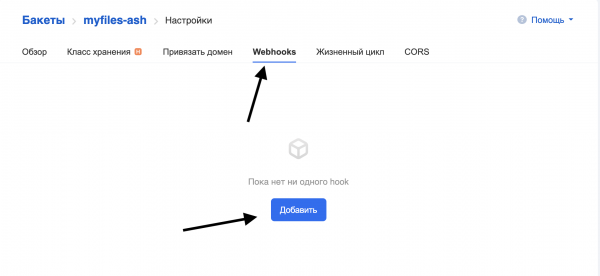
Wypełniamy pola:
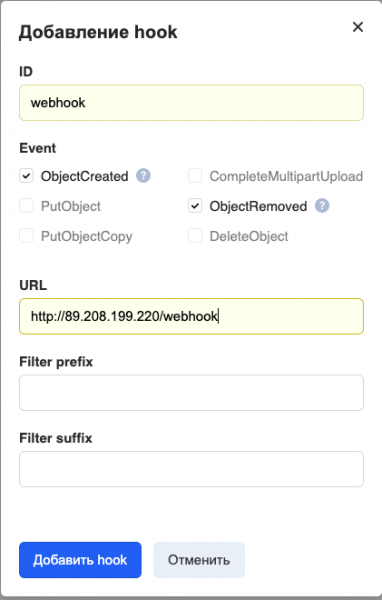
ID — nazwa webhooka.
Event — jakie zdarzenia wysyłać. Ustawiliśmy przesyłanie wszystkich zdarzeń, które występują podczas pracy z plikami (dodawanie i usuwanie).
URL — adres serwera do odbioru webhooków.
Filter prefix/suffix — filtr, który pozwala generować webhooki tylko dla obiektów, których nazwy odpowiadają określonym regułom. Na przykład, aby webhook działał tylko dla plików z rozszerzeniem .png, w Filter suffix trzeba wpisać „png”.
W tej chwili obsługiwane są tylko porty 80 i 443 do komunikacji z serwerem do odbioru webhooków.
Klikamy Dodaj hook i zobaczymy następujące:
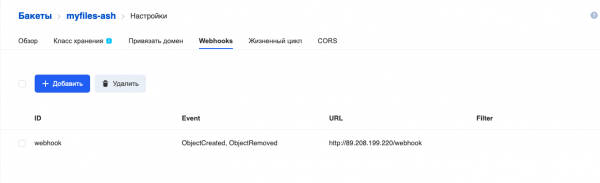
Hook dodany.
Serwer do odbioru webhooków w logach pokazuje przebieg procesu rejestracji huka:
ubuntu@ubuntu-basic-1-2-10gb:~\/s3-webhook$ sudo .\/s3-webhook -port 80
2020\/06\/15 12:01:14 [POST] incoming HTTP request from
95.163.216.92:42530
2020\/06\/15 12:01:14 Got timestamp: 2020-06-15T15:01:13+03:00 TopicArn:
mcs5259999770|myfiles-ash|s3:ObjectCreated:*,s3:ObjectRemoved:* Token:
E2itMqAMUVVZc51pUhFWSp13DoxezvRxkUh5P7LEuk1dEe9y URL:
http:\/\/89.208.199.220\/webhook
2020\/06\/15 12:01:14 Generate response signature:
3754ce36636f80dfd606c5254d64ecb2fd8d555c27962b70b4f759f32c76b66d
Rejestracja zakończona. W następnej sekcji dokładniej omówimy algorytm działania serwera do odbioru webhooków.
Opis serwera do odbioru webhooków
W naszym przykładzie serwer został napisany w Go. Omówimy podstawowe zasady jego działania.
package main

// Generate hmac_sha256_hex
func HmacSha256hex(message string, secret string) string {
}

// Generate hmac_sha256
func HmacSha256(message string, secret string) string {
}

// Send subscription confirmation
func SubscriptionConfirmation(w http.ResponseWriter, req *http.Request, body []byte) {
}

// Send subscription confirmation
func GotRecords(w http.ResponseWriter, req *http.Request, body []byte) {
}

// Liveness probe
func Ping(w http.ResponseWriter, req *http.Request) {
    // log request
    log.Printf("[%s] incoming HTTP Ping request from %sn", req.Method, req.RemoteAddr)
    fmt.Fprintf(w, "Pongn")
}

//Webhook
func Webhook(w http.ResponseWriter, req *http.Request) {
}

func main() {

    // get command line args
    bindPort := flag.Int("port", 80, "number between 1-65535")
    bindAddr := flag.String("address", "", "ip address in dot format")
    flag.StringVar(&actionScript, "script", "", "external script to execute")
    flag.Parse()

    http.HandleFunc("/ping", Ping)
    http.HandleFunc("/webhook", Webhook)

log.Fatal(http.ListenAndServe(*bindAddr+":"+strconv.Itoa(*bindPort), nil))
}
Omówmy główne funkcje:
- Ping() — trasa, która odpowiada na URL/ping, najprostsza implementacja liveness probe.
- Webhook() — podstawowa trasa, przetwarzająca URL/webhook:
- potwierdza rejestrację w usłudze publikacji (przechodzi do funkcji SubscriptionConfirmation),
- przetwarza przychodzące webhooki (funkcja Gotrecords).
- Funkcje HmacSha256 i HmacSha256hex — implementacje algorytmów szyfrowania HMAC-SHA256 i HMAC-SHA256 z wyjściem w postaci ciągu szesnastkowego dla obliczenia sygnatury.
- main — główna funkcja, przetwarza parametry wiersza poleceń i rejestruje obsługiwane trasy URL.
Parametry wiersza poleceń, akceptowane przez serwer:
- -port — port, na którym serwer będzie nasłuchiwał.
- -address — adres IP, na którym serwer będzie nasłuchiwał.
- -script — zewnętrzny program, który jest wywoływany dla każdego nadchodzącego webhooka.
Przyjrzyjmy się bliżej niektórym funkcjom:
//Webhook
func Webhook(w http.ResponseWriter, req *http.Request) {

    // Read body
    body, err := ioutil.ReadAll(req.Body)
    defer req.Body.Close()
    if err != nil {
        http.Error(w, err.Error(), 500)
        return
    }

    // log request
    log.Printf("[%s] incoming HTTP request from %sn", req.Method, req.RemoteAddr)
    // check if we got subscription confirmation request
    if strings.Contains(string(body),
""Type":"SubscriptionConfirmation"") {
        SubscriptionConfirmation(w, req, body)
    } else {
        GotRecords(w, req, body)
    }

}
Ta funkcja określa, co przychodzi — żądanie potwierdzenia rejestracji lub webhook. Jak wynika z , w przypadku potwierdzenia rejestracji przychodzi następująca struktura Json w żądaniu Post:
POST http://test.com HTTP/1.1
x-amz-sns-messages-type: SubscriptionConfirmation
content-type: application/json

{
    "Timestamp":"2019-12-26T19:29:12+03:00",
    "Type":"SubscriptionConfirmation",
    "Message":"Wybrałeś subskrypcję tematu $topic. Aby potwierdzić subskrypcję, musisz odpowiedzieć obliczoną sygnaturą",
    "TopicArn":"mcs2883541269|bucketA|s3:ObjectCreated:Put",
    "SignatureVersion":1,
    "Token":«RPE5UuG94rGgBH6kHXN9FUPugFxj1hs2aUQc99btJp3E49tA»
}
Na to żądanie należy odpowiedzieć:
content-type: application/json

{"signature":«ea3fce4bb15c6de4fec365d36bcebbc34ccddf54616d5ca12e1972f82b6d37af»}
Gdzie sygnatura obliczana jest jako:
signature = hmac_sha256(url, hmac_sha256(TopicArn,
hmac_sha256(Timestamp, Token)))
Jeśli jednak nadchodzi webhook, struktura żądania Post wygląda tak:
POST  HTTP/1.1
x-amz-sns-messages-type: SubscriptionConfirmation

{ "Records":
    [
        {
            "s3": {
                "object": {
                    "eTag":"aed563ecafb4bcc5654c597a421547b2",
                    "sequencer":1577453615,
                    "key":"some-file-to-bucket",
                    "size":100
                },
            "configurationId":"1",
            "bucket": {
                "name": "bucketA",
                "ownerIdentity": {
                    "principalId":"mcs2883541269"}
                },
                "s3SchemaVersion":"1.0"
            },
            "eventVersion":"1.0",
            "requestParameters":{
                "sourceIPAddress":"185.6.245.156"
            },
            "userIdentity": {
                "principalId":"2407013e-cbc1-415f-9102-16fb9bd6946b"
            },
            "eventName":"s3:ObjectCreated:Put",
            "awsRegion":"ru-msk",
            "eventSource":"aws:s3",
            "responseElements": {
                "x-amz-request-id":"VGJR5rtJ"
            }
        }
    ]
}
W odpowiedzi, w zależności od żądania, należy zrozumieć, jak przetwarzać dane. Wybrałem jako wskaźnik zapis "Type":"SubscriptionConfirmation", ponieważ jest obecna w żądaniu potwierdzenia subskrypcji i nie występuje w webhooku. W zależności od obecności/braku tego wpisu w żądaniu POST, dalsze wykonywanie programu przechodzi albo do funkcji PotwierdzenieSubskrypcji, albo do funkcji OdebraneRekordy.
Funkcji PotwierdzenieSubskrypcji nie będziemy szczegółowo omawiać, jest ona zrealizowana na podstawie zasad przedstawionych w . Kod źródłowy tej funkcji można znaleźć w .
Funkcja OdebraneRekordy analizuje przychodzące żądanie i dla każdego obiektu Record wywołuje zewnętrzny skrypt (nazwa którego została przekazana w parametrze -script) z parametrami:
- nazwa bucketu
- klucz obiektu
- działanie:
- copy — jeśli w pierwotnym żądaniu EventName = ObjectCreated | PutObject | PutObjectCopy
- delete — jeśli w pierwotnym żądaniu EventName = ObjectRemoved | DeleteObject
W związku z tym, jeśli przychodzi webhook z zapytaniem POST, jak opisano , a parametr -script=script.sh, to skrypt będzie wywołany w następujący sposób:
script.sh bucketA some-file-to-bucket copyNależy rozumieć, że ten serwer odbioru webhooków to nie ukończone rozwiązanie produkcyjne, a uproszczony przykład możliwej implementacji.
Przykład działania
Zrealizujemy synchronizację plików głównego bucketu w MCS do zapasowego bucketu w AWS. Główny bucket nazywa się myfiles-ash, zapasowy — myfiles-backup (konfiguracja bucketu w AWS wykracza poza zakres tego artykułu). Odpowiednio, gdy plik jest umieszczany w głównym buckecie, jego kopia powinna pojawić się w zapasowym, a gdy jest usuwany z głównego — usunąć z zapasowego.
Będziemy pracować z bucketami przy użyciu narzędzia awscli, które jest kompatybilne zarówno z chmurą MCS, jak i AWS.
ubuntu@ubuntu-basic-1-2-10gb:~$ sudo apt-get install awscli
Czytanie listy pakietów... Zrobione
Tworzenie drzewa zależności
Czytanie stanu informacji... Zrobione
Po tej operacji, 34.4 MB dodatkowej przestrzeni dyskowej zostanie użyte.
Rozpakowywanie awscli (1.14.44-1ubuntu1) ...
Konfigurowanie awscli (1.14.44-1ubuntu1) ...
Skonfigurujemy dostęp do API S3 MCS:
ubuntu@ubuntu-basic-1-2-10gb:~$ aws configure --profile mcs
AWS Access Key ID [None]: hdywEPtuuJTExxxxxxxxxxxxxx
AWS Secret Access Key [None]: hDz3SgxKwXoxxxxxxxxxxxxxxxxxx
Domyślna nazwa regionu [None]:
Domyślny format wyjściowy [None]:
Skonfigurujemy dostęp do API S3 AWS:
ubuntu@ubuntu-basic-1-2-10gb:~$ aws configure --profile aws
AWS Access Key ID [None]: AKIAJXXXXXXXXXXXX
AWS Secret Access Key [None]: dfuerphOLQwu0CreP5Z8l5fuXXXXXXXXXXXXXXXX
Domyślna nazwa regionu [None]:
Domyślny format wyjściowy [None]:
Sprawdzimy dostęp:
Do AWS:
ubuntu@ubuntu-basic-1-2-10gb:~$ aws s3 ls --profile aws
2020-07-06 08:44:11 myfiles-backup
Dla MCS, przy pracy z tym poleceniem należy dodawać —endpoint-url:
ubuntu@ubuntu-basic-1-2-10gb:~$ aws s3 ls --profile mcs --endpoint-url
https://hb.bizmrg.com
2020-02-04 06:38:05 databasebackups-0cdaaa6402d4424e9676c75a720afa85
2020-05-27 10:08:33 myfiles-ash
Dostęp uzyskany.
Teraz napiszemy skrypt do obsługi przychodzącego hooka, nazwijmy go s3_backup_mcs_aws.sh
#!/bin/bash
# Require aws cli
# if file added — copy it to backup bucket
# if file removed — remove it from backup bucket
# Variables
ENDPOINT_MCS="https://hb.bizmrg.com"
AWSCLI_MCS=`which aws`" --endpoint-url ${ENDPOINT_MCS} --profile mcs s3"
AWSCLI_AWS=`which aws`" --profile aws s3"
BACKUP_BUCKET="myfiles-backup"

SOURCE_BUCKET="${1}"
SOURCE_FILE="${2}"
ACTION="${3}"

SOURCE="s3://${SOURCE_BUCKET}/${SOURCE_FILE}"
TARGET="s3://${BACKUP_BUCKET}/${SOURCE_FILE}"
TEMP="/tmp/${SOURCE_BUCKET}/${SOURCE_FILE}"

case ${ACTION} in
    "copy")
    ${AWSCLI_MCS} cp "${SOURCE}" "${TEMP}"
    ${AWSCLI_AWS} cp "${TEMP}" "${TARGET}"
    rm ${TEMP}
    ;;

    "delete")
    ${AWSCLI_AWS} rm ${TARGET}
    ;;

    *)
    echo "Usage: ${0} sourcebucket sourcefile copy/delete"
    exit 1
    ;;
esac
Uruchamiamy serwer:
ubuntu@ubuntu-basic-1-2-10gb:~\/s3-webhook$ sudo .\/s3-webhook -port 80 -
skrypt scripts\/s3_backup_mcs_aws.sh
Sprawdzamy, jak to zadziała. Przez dodamy plik test.txt do koszyka myfiles-ash. W logach w konsoli widać, że wykonano zapytanie do serwera webhooków:
2020\/07\/06 09:43:08 [POST] przychodzące żądanie HTTP od
95.163.216.92:56612
download: s3:\/myfiles-ash\/test.txt do ..\/..\/..\/tmp\/myfiles-ash\/test.txt
upload: ..\/..\/..\/tmp\/myfiles-ash\/test.txt do
s3:\/myfiles-backup\/test.txt
Sprawdzimy zawartość koszyka myfiles-backup w AWS:
ubuntu@ubuntu-basic-1-2-10gb:~\/s3-webhook$ aws s3 --profile aws ls
myfiles-backup
2020-07-06 09:43:10       1104 test.txt
Teraz przez interfejs webowy usuniemy plik z koszyka myfiles-ash.
Logi serwera:
2020\/07\/06 09:44:46 [POST] przychodzące żądanie HTTP od
95.163.216.92:58224
delete: s3:\/myfiles-backup\/test.txt
Zawartość koszyka:
ubuntu@ubuntu-basic-1-2-10gb:~\/s3-webhook$ aws s3 --profile aws ls
myfiles-backup
ubuntu@ubuntu-basic-1-2-10gb:~$
Plik został usunięty, zadanie zakończone.
Podsumowanie i ToDo
Cały kod użyty w tym artykule znajduje się . Tam także znajdują się przykłady skryptów i przykłady obliczania sygnatur dla rejestracji webhooków.
Ten kod to tylko przykład, jak można wykorzystać webhooki S3 w swojej działalności. Jak wspomniałem na początku, planując użycie takiego serwera w produkcji, należy przynajmniej przepisać serwer na asynchroniczną pracę: przychodzące webhooki rejestrować w kolejce (RabbitMQ lub NATS), a stamtąd je rozbierać i przetwarzać przez aplikacje robocze. W przeciwnym razie przy masowym napływie webhooków można napotkać na brak zasobów serwera do realizacji zadań. Posiadanie kolejek pozwala na rozdzielenie serwera i workerów, a także rozwiązywanie problemów z powtarzaniem zadań w przypadku awarii. Również warto zmienić logowanie na bardziej szczegółowe i bardziej ustandaryzowane.
Powodzenia!
Więcej do przeczytania na ten temat:
Źródło: habr.com
