

Czasami, aby rozwiązać problem, wystarczy spojrzeć na niego z innej perspektywy. Nawet jeśli przez ostatnie 10 lat takie problemy rozwiązywano w ten sam sposób z różnym skutkiem, nie ma pewności, że to jedyny sposób.
Jest taki temat, jak odpływ klientów. To zjawisko jest nieuniknione, ponieważ klienci każdej firmy mogą z różnych powodów przestać korzystać z jej produktów lub usług. Oczywiście, dla firmy odpływ — choć naturalny — jest działaniem, którego nie pożąda, dlatego wszyscy starają się go minimalizować. A jeszcze lepiej — przewidywać prawdopodobieństwo odpływu danej grupy użytkowników lub konkretnego klienta oraz proponować jakieś kroki mające na celu ich zatrzymanie.
Analiza i próby zatrzymania klienta, jeśli to możliwe, są konieczne przynajmniej z następujących powodów:
- pozyskanie nowych klientów jest droższe niż procedury zatrzymywania. Z reguły na pozyskanie nowych klientów trzeba wydać określoną kwotę (reklama), podczas gdy istniejących klientów można aktywować specjalną ofertą z wyjątkowymi warunkami;
- zrozumienie przyczyn odejścia klientów to klucz do poprawy produktów i usług.
Istnieją standardowe metody przewidywania odpływu. Jednak na jednym z mistrzostw w dziedzinie sztucznej inteligencji postanowiliśmy spróbować zastosować rozkład Weibulla. Najczęściej wykorzystuje się go do analizy przetrwania, prognozowania pogody, analizy klęsk żywiołowych, inżynierii przemysłowej i tym podobnych zastosowań. Rozkład Weibulla to specjalna funkcja rozkładu, parametryzowana dwoma parametrami.  i
 .
Wikipedia
Ogólnie rzecz biorąc, to ciekawa rzecz, ale rzadko stosowana w przewidywaniu odpływu, a także w fintechu. W dalszej części opowiemy, jak to zrobiliśmy (Laboratoria Inteligentnej Analizy Danych), zdobywając przy tym złoto na Mistrzostwach Sztucznej Inteligencji w kategorii „AI w bankowości”.
O odpływie w ogóle
Zrozummy trochę, czym jest odejście klienta i dlaczego jest to tak ważne. Dla biznesu istotna jest baza klientów. Do tej bazy przychodzą nowi klienci, na przykład dowiadując się o produkcie lub usłudze z reklamy, przez jakiś czas korzystają (aktywnie używają produktów) i po pewnym czasie przestają korzystać. Taki okres nazywa się „cyklem życia klienta” (ang. Customer Lifecycle) — to termin opisujący etapy, które przechodzi klient, gdy dowiaduje się o produkcie, podejmuje decyzję o zakupie, płaci, używa i staje się lojalnym konsumentem, a ostatecznie przestaje korzystać z różnych przyczyn. Odpowiednio odejście to końcowy etap cyklu życia klienta, kiedy to klient przestaje korzystać z usług, a dla biznesu oznacza to, że klient przestał przynosić zysk i jakiekolwiek korzyści.
Każdy klient banku to konkretna osoba, która wybiera konkretną kartę bankową specjalnie dostosowaną do swoich potrzeb. Często podróżuje — przyda się karta z milami. Dużo kupuje — witaj, karta z cashbackiem. Dużo kupuje w konkretnych sklepach — a do tego już jest specjalny plastik partnerski. Oczywiście, czasem karta wybierana jest także według kryterium „najtańsza obsługa”. Ogólnie rzecz biorąc, zmiennych jest tutaj sporo.
A jeszcze człowiek wybiera sam bank — jaki sens wybierać kartę banku, którego oddziały są tylko w Moskwie i okolicach, kiedy jesteś z Chabarowska? Niech karta tego banku będzie nawet 2 razy korzystniejsza, ale obecność oddziałów banku w pobliżu nadal jest ważnym kryterium. Tak, 2019 już tutaj i digital to nasze wszystko, ale w przypadku niektórych banków pewne kwestie można rozwiązać tylko w oddziale. Plus, ponownie, pewna część społeczeństwa znacznie bardziej ufa fizycznemu bankowi, a nie aplikacji w smartfonie, to także trzeba brać pod uwagę.
W związku z tym przyczyn rezygnacji z produktów banku (lub samego banku) może być wiele. Zmienił pracę, a taryfa karty zmieniła się z płatniczej na „Dla zwykłych śmiertelników”, co jest mniej korzystne. Przeprowadził się do innego miasta, gdzie nie ma oddziałów banku. Nie podobała mu się rozmowa z niewykwalifikowanym pracownikiem w oddziale. To znaczy, że przyczyn do zamknięcia konta może być znacznie więcej niż do korzystania z produktu.
Klient może nie tylko wyrazić swoje zamiary w sposób jawny — przyjść do banku i złożyć wniosek, ale również po prostu zaprzestać korzystania z produktów, nie rozwiązując umowy. To właśnie w celu zrozumienia takich sytuacji postanowiono zastosować uczenie maszynowe i sztuczną inteligencję.
Co więcej, odpływ klientów może występować w każdej branży (telekomunikacja, dostawcy internetu, firmy ubezpieczeniowe, ogólnie wszędzie, gdzie istnieje baza klientów i regularne transakcje).
Co zrobiliśmy
Przede wszystkim należy dokładnie określić granicę — od kiedy zaczynamy liczyć klienta jako utraconego. Z perspektywy banku, który dostarczył nam dane do analizy, stan aktywności klienta był binarny — był on albo aktywny, albo nie. W tabeli „Aktywność” znajdował się flag ACTIVE_FLAG, którego wartością mogło być „0” lub „1” (odpowiednio „Nieaktywny” i „Aktywny”). I wszystko byłoby w porządku, ale człowiek ma to do siebie, że może przez jakiś czas aktywnie korzystać, a następnie na miesiąc przestać być aktywnym — może zachorował, wyjechał na wakacje do innego kraju lub w ogóle zaczął testować kartę innego banku. A może po długim okresie nieaktywności znowu zacznie korzystać z usług banku.
Dlatego postanowiliśmy nazywać określony okres braku aktywności jako ciągły fragment czasu, w którym jego flaga była ustawiona na „0”.
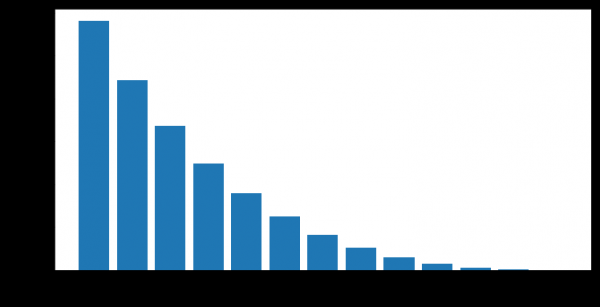
Klienci przechodzą z nieaktywnych w aktywnych po różnych długościach okresów nieaktywności. Pojawia się możliwość oszacowania stopnia empirycznego pojęcia „wiarygodność okresów nieaktywności” — czyli prawdopodobieństwa, że osoba znowu zacznie korzystać z produktów banku po czasowej nieaktywności.
Na przykład, na tym wykresie przedstawiono wznowienie aktywności (ACTIVE_FLAG=1) klientów po kilku miesiącach nieaktywności (ACTIVE_FLAG=0).
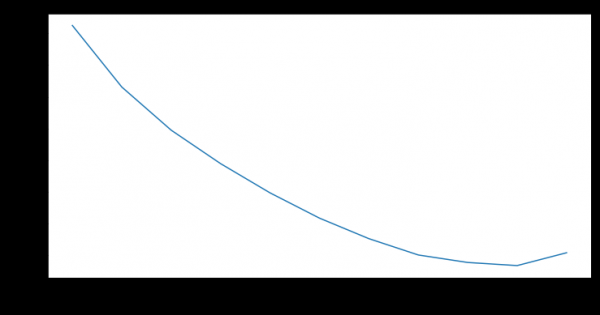
Tutaj nieco sprecyzujemy zestaw danych, z którymi zaczęliśmy pracować. Tak więc bank dostarczył zintegrowane informacje za 19 miesięcy w następujących tabelach:
- „Aktywność” — miesięczne transakcje klientów (za pomocą kart, w bankowości internetowej i mobilnej), włączając w to wypłaty wynagrodzenia oraz informacje o obrotach.
- „Karty” — dane o wszystkich kartach, które posiada klient, z szczegółową taryfikacją.
- „Umowy” – informacje o umowach klienta (zarówno otwartych, jak i zamkniętych): kredyty, depozyty i inne, z podaniem parametrów każdego z nich.
- „Klienci” – zbiór danych demograficznych (płeć i wiek) oraz posiadanie danych kontaktowych.
Do pracy potrzebowaliśmy wszystkich tabel, poza „Kartami”.
Trudność polegała również na tym, że w tych danych bank nie wskazywał, jaka dokładnie aktywność miała miejsce na kartach. To znaczy mogliśmy określić, czy były transakcje, czy nie, ale już nie mogliśmy określić ich typu. Dlatego nie było jasne, czy klient wypłacał gotówkę, otrzymywał pensję, czy wydawał pieniądze na zakupy. A dodatkowo nie mieliśmy danych o saldach na kontach, co byłoby przydatne.
Sama próbka była nieprzesunięta – w tym wycinku przez 19 miesięcy bank nie podjął żadnych prób zatrzymania klientów i minimalizacji odpływu.
Tak więc, o okresach braku aktywności.
Aby sformułować definicję odpływu, należy wybrać okres braku aktywności. Aby stworzyć prognozę odpływu w danym momencie,  należy mieć historię klientów minimum 3 miesiące w przedziale
 . Historia była u nas ograniczona do 19 miesięcy, dlatego postanowiliśmy brać okres braku aktywności wynoszący 6 miesięcy, jeśli taki istnieje. A za minimalny okres dla jakościowej prognozy przyjęliśmy 3 miesiące. Liczby 3 i 6 miesięcy wzięliśmy empirycznie na podstawie analizy zachowań tych klientów.
Definicję odpływu sformułowaliśmy tak: miesiąc odpływu klienta  to pierwszy miesiąc z ACTIVE_FLAG=0, gdzie od tego miesiąca występuje co najmniej sześć zer z rzędu w polu ACTIVE_FLAG, innymi słowy, miesiąc, od którego klient był nieaktywny przez 6 miesięcy.
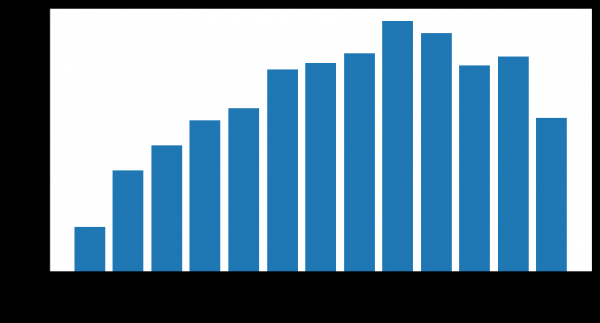
Liczba odejść klientów
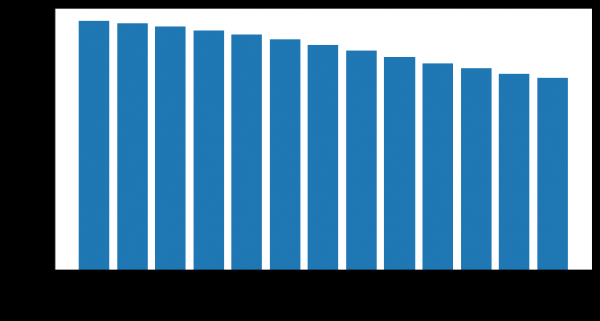
Liczba pozostałych klientów
Jak powszechnie uważa się odpływ
W takich zawodach, a i w praktyce, odpływ często prognozuje się w ten sposób. Klient korzysta z produktów i usług w różnych odstępach czasu, a dane o interakcji z nim przedstawiane są w postaci wektora cech o stałej długości n. Najczęściej w tej informacji uwzględnia się:
- Dane charakteryzujące użytkownika (dane demograficzne, segment marketingowy).
- Historię korzystania z produktów i usług bankowych (to działania klientów zawsze związane z konkretnym czasem lub okresem potrzebnego nam przedziału).
- Dane zewnętrzne, jeśli zostały uzyskane — na przykład opinie z mediów społecznościowych.
I dopiero potem określają wskaźnik odpływu, swoje dla każdego zadania. Następnie używają algorytmu uczenia maszynowego, który przewiduje prawdopodobieństwo odejścia klienta  na podstawie wektora czynników
 . Do uczenia algorytmu wykorzystuje się jeden z popularnych frameworków do budowy zespołów drzew decyzyjnych, , , lub ich modyfikacje.
Sam algorytm jest dobry, ale w zakresie prognozowania odpływu ma kilka poważnych wad.
- Nie ma tzw. "pamięci". Na wejście modelu podawana jest określona liczba cech, które odpowiadają bieżącemu momentowi czasowemu. Aby uwzględnić informacje o historii zmian parametrów, konieczne jest obliczenie specjalnych cech, które charakteryzują zmiany parametrów w czasie, na przykład liczba lub suma transakcji bankowych za ostatnie 1,2,3 miesiące. Takie podejście może jedynie częściowo odzwierciedlać charakter zmian w czasie.
- Stały horyzont prognozowania. Model jest w stanie przewidywać odpływ klientów tylko na wcześniej określony okres czasu, na przykład prognoza na miesiąc do przodu. Jeśli potrzebna jest prognoza na inny okres czasu, na przykład na trzy miesiące, konieczne jest przebudowanie zbioru uczącego i ponowne wytrenowanie nowego modelu.
Nasze podejście
Postanowiliśmy od razu, że nie będziemy korzystać z standardowych podejść. W mistrzostwach zarejestrowało się oprócz nas jeszcze 497 osób, z których każda miała za sobą solidne doświadczenie. Dlatego próba zrobienia czegokolwiek według standardowego schematu w takich warunkach to nie najlepszy pomysł.
Zaczęliśmy rozwiązywać problemy związane z modelem klasyfikacji binarnej, wykorzystując prognozowanie rozkładu prawdopodobieństwa czasu odpływu klientów. Takie podejście pozwala bardziej elastycznie prognozować odpływ i testować bardziej skomplikowane hipotezy niż w klasycznym podejściu. Jako rodzinę rozkładów modelujących czas odpływu wybraliśmy rozkład Weibulla ze względu na jego szerokie zastosowanie w analizie przeżywalności. Zachowanie klienta można postrzegać jako swego rodzaju przeżywalność.
Oto przykłady rozkładów gęstości prawdopodobieństwa Weibulla w zależności od parametrów  i
 :
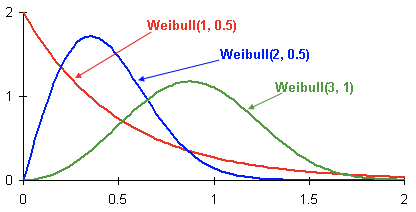
To jest gęstość rozkładu prawdopodobieństwa odpływu klientów trzech różnych klientów w miarę upływu czasu. Czas przedstawiony jest w miesiącach. Innymi słowy, ten wykres pokazuje, kiedy prawdopodobnie nastąpi odpływ klienta w ciągu następnych dwóch miesięcy. Jak widać, klient z rozkładem ma większy potencjał na wcześniejszy odpływ niż klienci z rozkładami Weibull(2, 0.5) i Weibull(3,1).
W rezultacie otrzymujemy model, który dla każdego klienta w każdym
miesiącu przewiduje parametry rozkładu Weibulla, najlepiej odzwierciedlające prawdopodobieństwo odpływu w miarę upływu czasu. Jeśli chodzi o szczegóły:
- Cechy docelowe w zbiorze danych do nauki — czas pozostały do odpływu w konkretnym miesiącu dla konkretnego klienta.
- Jeśli nie mamy wskaźnika odpływu dla klienta, zakładamy, że czas odpływu jest dłuższy niż liczba miesięcy, poczynając od obecnego i kończąc na dostępnej historii.
- Używany model: sieć neuronowa rekurencyjna z warstwą LSTM.
- Jako funkcję strat wykorzystujemy ujemną logarytmiczną funkcję prawdopodobieństwa dla rozkładu Weibulla.
Oto zalety tej metody:
- Rozkład prawdopodobieństwa, poza oczywistą możliwością klasyfikacji binarnej, pozwala elastycznie przewidywać różne zdarzenia, na przykład, czy klient przestanie korzystać z usług banku w ciągu 3 miesięcy. Ponadto, w razie potrzeby, na podstawie tego rozkładu można uśredniać różne metryki.
- Rekurencyjna sieć neuronowa LSTM ma pamięć i efektywnie wykorzystuje całą dostępną historię. Z rozszerzeniem lub dokładniejszym opisem historii dokładność wzrasta.
- Podejście można bezproblemowo skalować poprzez podział okresów czasu na mniejsze (na przykład, dzieląc miesiące na tygodnie).
Jednak stworzenie dobrego modelu to nie wszystko, trzeba również właściwie ocenić jego jakość.
Jak ocenialiśmy jakość
Jako metrykę wybraliśmy krzywą Lift. Używa się jej w biznesie w podobnych przypadkach ze względu na jasną interpretację, jest dobrze opisana i . Jeśli opiszemy sens tej metryki jednym zdaniem, otrzymamy „O ile lepiej algorytm przewiduje na pierwszych  % w porównaniu do losowości”.
Uczymy modele
Warunki konkursu nie określały konkretnej metryki jakości, według której można porównywać różne modele i podejścia. Co więcej, definicja pojęcia churn może być różna i zależeć od postawienia zadania, które z kolei definiuje cele biznesowe. Dlatego, aby zrozumieć, która metoda jest lepsza, wytrenujemy dwa modele:
- Często stosowane podejście do klasyfikacji binarnej przy użyciu algorytmu uczenia maszynowego opartego na zespołach drzew decyzyjnych ();
- Model Weibull-LSTM
Zbiór testowy składał się z 500 wcześniej wybranych klientów, którzy nie znajdowali się w zbiorze treningowym. Dla modelu przeprowadzono dobór hiperparametrów przy użyciu walidacji krzyżowej z podziałem na klientów. Do trenowania każdego modelu wykorzystano te same zestawy cech.
W związku z tym, że model nie ma pamięci, użyto specjalnych cech, które pokazują relację zmiany parametrów danego miesiąca do średniej wartości parametrów za ostatnie trzy miesiące. Opisuje to prędkość zmian wartości w ostatnim okresie trzech miesięcy. Bez tego model oparty na Random Forest byłby z góry na straconej pozycji w porównaniu do Weibull-LSTM.
Dlaczego LSTM z rozkładem Weibulla jest lepsze od podejścia opartego na zespołach drzew decyzyjnych?
Tutaj wszystko jest jasno pokazane dosłownie na kilku obrazkach.
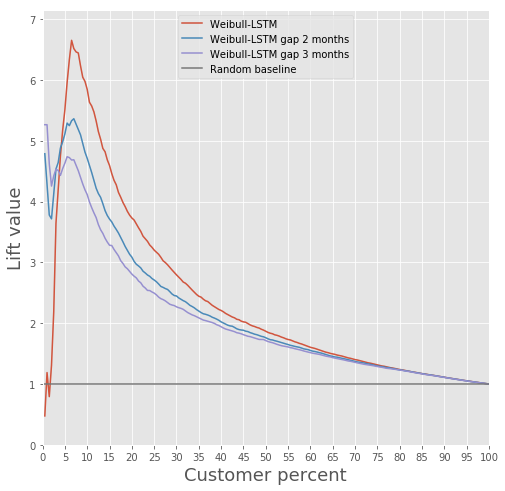
Porównanie Lift Curve dla klasycznego algorytmu i Weibull-LSTM
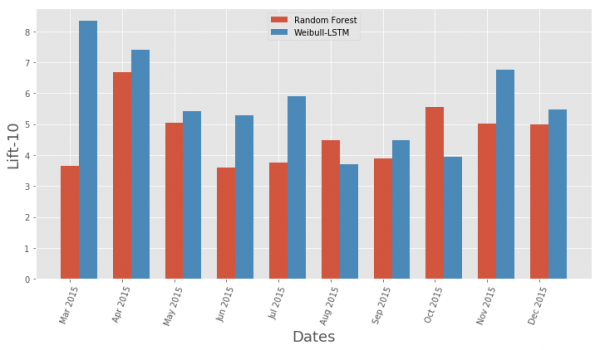
Porównanie metryki Lift Curve miesięcznie dla klasycznego algorytmu i Weibull-LSTM
Ogólnie rzecz biorąc, LSTM przewyższa klasyczny algorytm prawie we wszystkich przypadkach.
Prognozowanie churnu
Model oparty na rekurencyjnej sieci neuronowej z komórkami LSTM z rozkładem Weibulla może prognozować churn z wyprzedzeniem, na przykład przewidując odejście klienta w ciągu następnych n miesięcy. Rozważmy przypadek dla n = 3. W tym przypadku dla każdego miesiąca sieć neuronowa musi prawidłowo określić: czy klient odejdzie, zaczynając od następnego miesiąca aż do n-tego miesiąca. Innymi słowy, musi prawidłowo określić, czy klient pozostanie po upływie n miesięcy. Można to uznać za prognozę z wyprzedzeniem: przewidywanie momentu, w którym klient zaczął myśleć o odejściu.
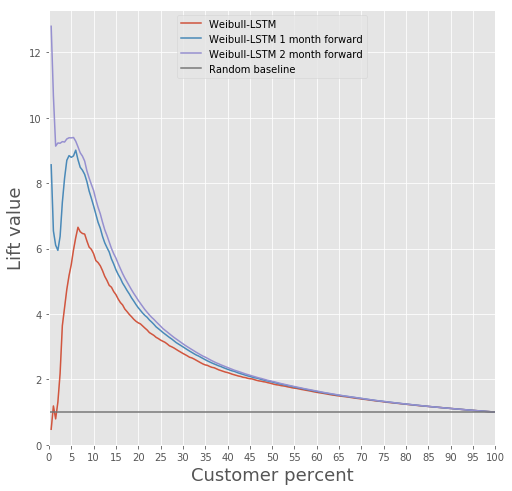
Porównajmy Lift Curve dla Weibull-LSTM na 1, 2 i 3 miesiące przed odejściem klienta:
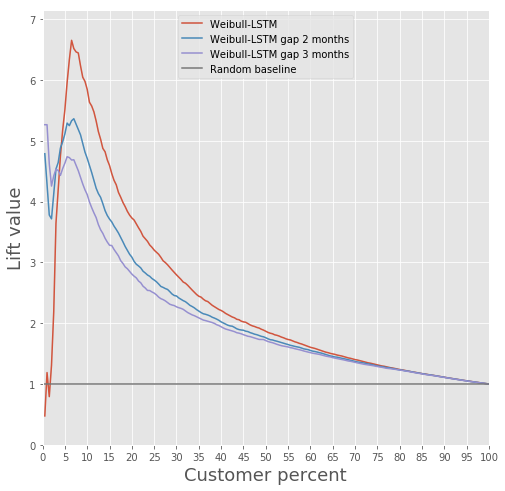
Już wcześniej mówiliśmy, że ważne są także prognozy dotyczące klientów, którzy na jakiś czas przestają być aktywni. Dlatego dodamy do próby takie przypadki, gdy klient, który odszedł, był nieaktywny przez jeden lub dwa miesiące, i sprawdzimy, czy model Weibull-LSTM prawidłowo klasyfikuje takie przypadki jako odpływ. Ponieważ takie przypadki były obecne w próbie, oczekujemy, że sieć dobrze sobie z nimi poradzi:
Utrzymanie klientów
Właściwie to jest kluczowe, co można zrobić, mając informacje o tym, że tacy klienci zamierzają przestać korzystać z produktu. Mówiąc o budowie modelu, który mógłby oferować coś użytecznego dla klientów, aby ich zatrzymać — nie da się tego zrobić, jeśli nie masz historycznych prób, które zakończyły się sukcesem.
Nie mieliśmy takiej historii, więc zdecydowaliśmy się na to w ten sposób.
- Budujemy model, który określa interesujące produkty dla każdego klienta.
- Każdego miesiąca uruchamiamy klasyfikator i określamy potencjalnych klientów, którzy mogą odejść.
- Części klientów oferujemy produkt, zgodnie z modelem z punktu 1, pamiętając nasze działania.
- Po kilku miesiącach sprawdzamy, którzy z tych potencjalnych klientów odeszli, a którzy zostali. W ten sposób tworzymy zbiór treningowy.
- Szkolimy model na historii uzyskanej w punkcie 4.
- Opcjonalnie powtarzamy procedurę, zastępując model z punktu 1 modelem uzyskanym w punkcie 5.
Ocena jakości takiego utrzymania może być przeprowadzona za pomocą standardowego testowania A/B — dzielimy klientów, którzy mogą odejść, na dwie grupy. Jednej oferujemy produkty na podstawie naszego modelu utrzymania, drugiej nie oferujemy nic. Postanowiliśmy wytrenować model, który mógłby przynieść korzyści już w punkcie 1 naszego przykładu.
Chcieliśmy, aby segmentacja była maksymalnie interpretowalna. Dlatego wybraliśmy kilka cech, które mogłyby być łatwo interpretowane: całkowita liczba transakcji, wynagrodzenie, łączny obrót na koncie, wiek, płeć. Cechy z tabeli "Mapy" nie były brane pod uwagę ze względu na małą informatywność, a cechy z tabeli 3 "Umowy" — z powodu trudności w przetwarzaniu, aby uniknąć przecieku danych między zbiorem walidacyjnym a zbiorem treningowym.
Klasteryzacja została przeprowadzona za pomocą modeli mieszanin Gaussa. Kryterium informacyjne Akaike pozwoliło określić 2 optima. Pierwsze optimum odpowiada 1 klastrowi. Drugie, mniej wyraźne optimum, odpowiada 80 klastrom. Na podstawie tego wyniku można wysnuć następujący wniosek: informacje są niezwykle trudne do podziału na klastry bez apriorycznej wiedzy. Aby uzyskać lepszą klasteryzację, potrzebne są dane, które szczegółowo opisują każdego klienta.
Z tego powodu rozważono zadanie uczenia pod okiem nauczyciela, aby zaproponować każdemu klientowi odpowiedni produkt. Rozważano następujące produkty: „Lokata terminowa”, „Karta kredytowa”, „Overdraft”, „Kredyt konsumpcyjny”, „Kredyt samochodowy”, „Kredyt hipoteczny”.
W danych występował jeszcze jeden rodzaj produktu: „Rachunek bieżący”. Jednak nie rozważaliśmy go ze względu na niską informacyjność. Na podstawie użytkowników, którzy są klientami banku, czyli nie zaprzestali korzystania z jego produktów, zbudowano model przewidujący, jaki produkt może ich interesować. Model wybrano jako regresję logistyczną, a jako miarę oceny jakości zastosowano wartość Lift dla pierwszych 10 percentyli.
Jakość modelu można ocenić na rysunku.
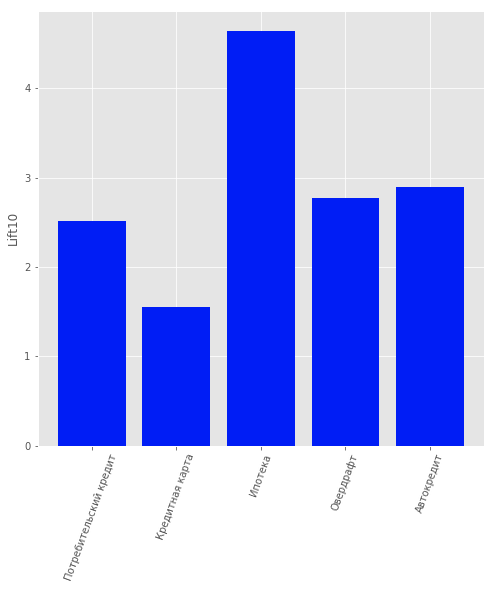
Wyniki modelu rekomendacji produktów dla klientów
Podsumowanie
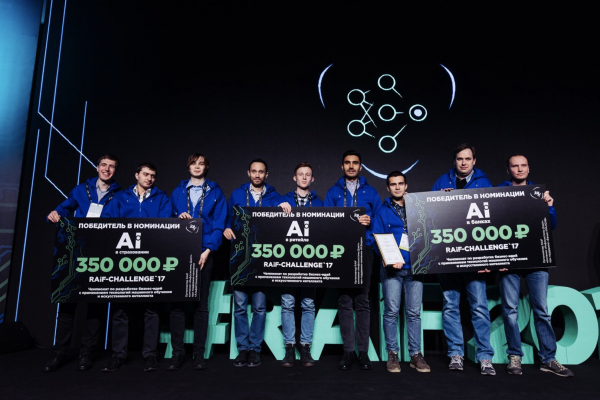
Podejście to przyniosło nam pierwsze miejsce w kategorii „AI w bankowości” na Mistrzostwach AI RAIF-Challenge 2017.
Najwidoczniej kluczowe było podejście do problemu z nieco innej perspektywy oraz zastosowanie metody, która jest zwykle używana w innych sytuacjach.
Chociaż masowy odpływ użytkowników może być dla usług katastrofą naturalną.
Metodę tę można wykorzystać również w innych dziedzinach, gdzie ważne jest uwzględnienie odpływu, nie tylko przez banki. Na przykład, wykorzystaliśmy ją do obliczenia własnego odpływu — w Syberyjskim i Petersburskim oddziale Rostelekomu.
„Laboratorium inteligentnej analizy danych” firma „Portal wyszukiwania „Sputnik”
Źródło: habr.com
