

Ten artykuł ma na celu pomóc w wyborze odpowiedniego rozwiązania oraz zrozumieniu różnic pomiędzy takimi systemami SDS jak Gluster, Ceph i Vstorage (Virtuozzo).
W tekście znajdują się odniesienia do artykułów z bardziej szczegółowym omówieniem poszczególnych problemów, dlatego opisy będą maksymalnie zwięzłe, koncentrując się na kluczowych aspektach bez zbędnych słów i wprowadzenia, które można łatwo znaleźć w internecie.
Rzeczywiście, poruszane tematy wymagają odpowiedniego tonu tekstu, ale w dzisiejszym świecie coraz więcej osób nie lubi zbyt dużo czytać))), dlatego można szybko przeszukać i podjąć decyzję, a jeśli coś jest niejasne, można skorzystać z odnośników lub poszukać niezrozumiałych słów))), a ten artykuł stanowi przezroczysty wstęp do tych głębokich tematów, pokazując kluczowe punkty każdego rozwiązania.
Gluster
Zacznijmy od Gluster, który jest szeroko stosowany przez producentów hiper-zwirtualizowanych platform z SDS opartych na open source do środowisk wirtualnych. Można go znaleźć na stronie RedHat w sekcji storage, gdzie oferowane są dwa warianty SDS: Gluster lub Ceph.
Gluster składa się z zestawu translatorów – usług, które wykonują wszystkie zadania związane z dystrybucją plików itd. Brick to usługa obsługująca jeden dysk, Volume – to tom (pul) łączący te bricki. Następnie znajduje się usługa dystrybucji plików za pomocą funkcji DHT (distributed hash table). Usługa Sharding nie będzie opisana tutaj, ponieważ w poniżej zamieszczonych linkach będą dostępne opisy związanych z nią problemów.
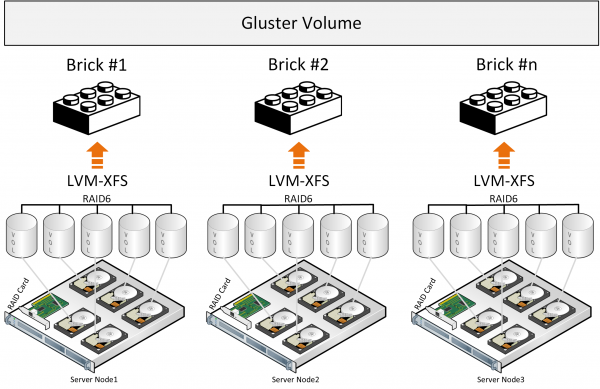
Podczas zapisu plik całkowicie trafia do bricka, a jego kopia jest równolegle zapisywana na bricku na drugim serwerze. Następnie drugi plik będzie zapisywany w drugiej grupie składającej się z dwóch bricków (lub więcej) na różnych serwerach.
Jeśli pliki mają mniej więcej ten sam rozmiar i tom będzie składał się tylko z jednej grupy, wszystko działa w porządku, ale w innych warunkach wystąpią następujące problemy:
- miejsce w grupach jest wykorzystywane nierównomiernie, co zależy od rozmiarów plików. Jeśli w grupie nie ma wystarczająco miejsca na zapisanie pliku — otrzymasz błąd, plik nie zostanie zapisany i nie zostanie ponownie przypisany do innej grupy;
- podczas zapisu jednego pliku IO odbywa się tylko w jednej grupie, inne są nieaktywne;
- nie można uzyskać IO dla całego tomu przy zapisie jednego pliku;
- Ogólna koncepcja wydaje się mniej wydajna z powodu braku rozdzielenia danych na bloki, co umożliwia łatwiejsze balansowanie i rozwiązanie problemu równomiernego rozkładu, a nie jak obecnie, gdy plik jest w całości umieszczany w bloku.
Z oficjalnego opisu pojawia się również zrozumienie, że gluster działa jak magazyn plików na klasycznym sprzętowym RAID. Podejmowano próby rozwijania (shardingu) plików na bloki, ale jest to wszystko dodatkowe, co narzuca straty wydajności do już istniejącego podejścia architektonicznego, a także stosowanie takich ogólnie dostępnych komponentów z ograniczeniem wydajności jak Fuse. Brakuje usług metadanych, co ogranicza możliwości wydajności i odporności na awarie magazynu podczas rozdzielania plików na bloki. Lepsze wyniki wydajności można zaobserwować w konfiguracji „Distributed Replicated”, a liczba węzłów powinna wynosić co najmniej 6, aby zorganizować niezawodną replikę 3 z optymalnym rozkładem obciążenia.
Te wnioski są również związane z opisem doświadczeń i podczas porównania z , a także istnieje opis doświadczeń, które prowadzą do zrozumienia tej bardziej wydajnej i bardziej niezawodnej konfiguracji
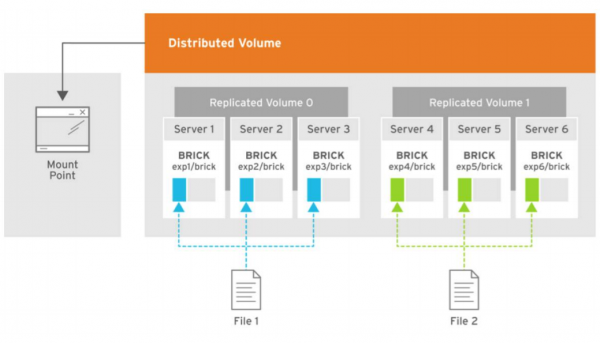
Na obrazku przedstawione jest rozkład obciążenia podczas zapisu dwóch plików, gdzie kopie pierwszego pliku rozmieszczane są na trzech pierwszych serwerach, które są połączone w grupie volume 0, a trzy kopie drugiego pliku są umieszczane w drugiej grupie volume1 z trzech serwerów. Każdy serwer ma jeden dysk.
Ogólny wniosek jest taki, że można używać Gluster, ale z zrozumieniem, że będą ograniczenia w wydajności i odporności na awarie, które stwarzają trudności w określonych warunkach rozwiązań hiperkonwergentnych, gdzie zasoby są również potrzebne do obciążeń obliczeniowych środowisk wirtualnych.
Są również pewne wskaźniki wydajności Gluster, które można osiągnąć w określonych warunkach, ograniczając się w
Ceph
Teraz rozważmy Ceph z opisu architektury, które udało mi się Jest również porównanie pomiędzy , gdzie można od razu zrozumieć, że Ceph najlepiej wdrażać na oddzielnych serwerach, ponieważ jego usługom potrzebne są wszystkie zasoby sprzętowe przy obciążeniach.
Architektura jest bardziej skomplikowany niż Gluster i posiada takie usługi jak usługi metadanych, ale cały zestaw komponentów jest dość skomplikowany i nie bardzo elastyczny do użycia w rozwiązaniach wirtualizacyjnych. Dane są przechowywane w blokach, co wygląda na bardziej wydajne, ale w hierarchii wszystkich usług (komponentów) występują straty i opóźnienia przy określonych obciążeniach i warunkach awaryjnych, na przykład następujące.
Z opisu architektury sercem systemu jest CRUSH, dzięki któremu wybierane jest miejsce na przechowywanie danych. Następnie wchodzi PG — jest to najbardziej skomplikowana abstrakcja (logiczna grupa) do zrozumienia. PG są potrzebne, aby CRUSH był bardziej efektywny. Głównym celem PG jest grupowanie obiektów w celu zmniejszenia zużycia zasobów, zwiększenia wydajności i skalowalności. Adresowanie obiektów bezpośrednio, indywidualnie, bez ich grupowania w PG byłoby bardzo kosztowne. OSD – to usługa dla każdego pojedynczego dysku.
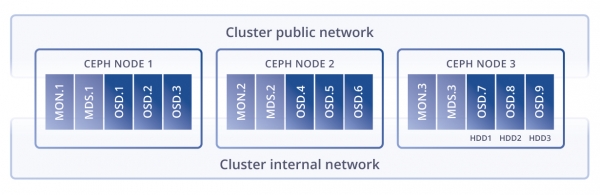
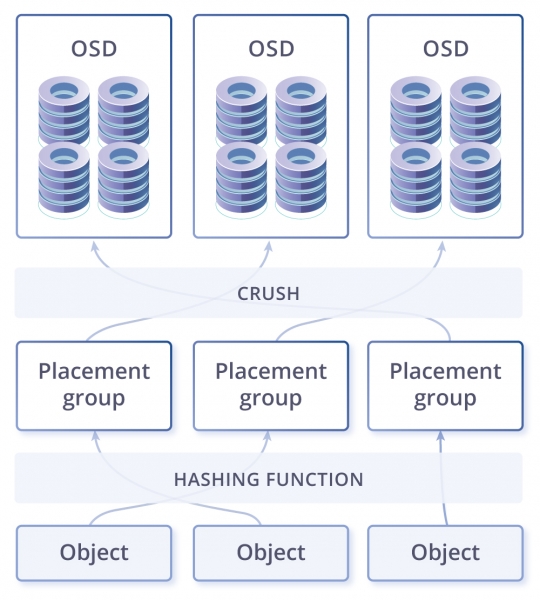
Klaster może mieć jeden lub więcej pul danych o różnych przeznaczeniach i z różnymi ustawieniami. Puli dzielą się na grupy rozmieszczania. W grupach rozmieszczania przechowywane są obiekty, do których mają dostęp klienci. Na tym poziomie logicznym się kończy, a zaczyna fizyczny, ponieważ każda grupa rozmieszczania jest przypisana do jednego głównego dysku i kilku dysków-replik (ich liczba zależy od czynnika replikacji puli). Innymi słowy, na poziomie logicznym obiekt jest przechowywany w konkretnej grupie rozmieszczania, a na poziomie fizycznym — na dyskach, które są do niej przypisane. Przy tym dyski fizycznie mogą znajdować się w różnych węzłach lub nawet w różnych centrach danych.
W tej schemacie grupy umieszczania wyglądają jak niezbędny poziom dla elastyczności całego rozwiązania, ale jednocześnie jak zbędne ogniwo w tym łańcuchu, co nieuchronnie nasuwa myśli o utracie wydajności. Na przykład, przy zapisie danych system musiałby dzielić je na te grupy, a potem na poziomie fizycznym na główny dysk i na dyski dla replik. To znaczy, że funkcja haszująca działa podczas wyszukiwania i wstawiania obiektów, ale istnieje efekt uboczny – są to bardzo duże wydatki i ograniczenia przy przebudowie hasha (przy dodawaniu, usuwaniu dysku). Innym problemem hasha jest ściśle ustalone rozmieszczenie danych, których nie można zmieniać. To znaczy, że jeśli jakiś dysk doświadcza zwiększonego obciążenia, system nie ma możliwości zapisania danych na innym dysku, ponieważ funkcja haszująca obliguje do rozmieszczenia danych według ustalonej zasady, niezależnie od tego, jak źle dysk sobie radzi, dlatego Ceph zużywa dużo pamięci przy przebudowie grup PG w przypadku samonaprawy lub zwiększania pojemności. Wniosek jest taki, że Ceph działa dobrze (choć powoli), ale tylko wtedy, gdy nie ma skalowania, awarii i aktualizacji.
Oczywiście istnieją sposoby na zwiększenie wydajności poprzez cache'owanie i tiering pamięci podręcznej, ale wymaga to dobrego sprzętu i wciąż będą występować straty. Generalnie Ceph wydaje się bardziej kuszący niż Gluster w produktach produkcyjnych. Również korzystając z tych produktów, należy uwzględnić istotny czynnik – to wysoki poziom kompetencji, doświadczenia i profesjonalizmu ze szczególnym naciskiem na Linuxa, ponieważ bardzo ważne jest, aby wszystko było poprawnie wdrożone, skonfigurowane i utrzymane, co nakłada jeszcze większą odpowiedzialność i obciążenie na administratora.
Vstorage
Architektura staje się jeszcze bardziej interesująca w przypadku , którą można używać wspólnie z hipernadzorcą na tych samych węzłach, na tym samym , ale bardzo ważne jest, aby wszystko poprawnie skonfigurować, aby osiągnąć dobrą wydajność. To znaczy, że wdrożenie takiego produktu z pudełka na jakiejkolwiek konfiguracji, bez uwzględnienia rekomendacji zgodnie z architekturą, będzie bardzo łatwe, ale nie wydajne.
Jakie usługi mogą współistnieć w przechowywaniu obok hypervisora kvm-qemu? To zaledwie kilka usług, w których znalazła się kompaktowa, optymalna hierarchia komponentów: usługa klienta montowana przez FUSE (zmodyfikowana, nie open source), usługa metadanych MDS (usługa metadanych), usługa bloków danych Chunk service, która na poziomie fizycznym odpowiada jednemu dyskowi i na tym koniec. Jeśli chodzi o prędkość, optymalnie używać zduplikowaną schemę z dwoma replikami, ale jeśli wykorzystać pamięć podręczną i logi na dyskach SSD, to kodowanie odporne na zakłócenia (erase coding lub raid6) można całkiem nieźle przyspieszyć w hybrydowym schemacie lub nawet lepiej na all flash. Przy EC (erase coding) pewnym minusem jest to, że przy zmianie jednego bloku danych konieczne jest przeliczenie sum parzystości. Aby obejść straty przy tej operacji, Ceph zapisuje w EC w trybie odłożonym, co może prowadzić do problemów z wydajnością przy pewnych zapytaniach, gdy na przykład potrzeba obliczyć wszystkie bloki, a w przypadku Virtuozzo Storage zapis zmienionych bloków odbywa się przy użyciu podejścia 'log-structured file system', co minimalizuje koszty obliczeń parzystości. Aby przybliżyć opcje przyspieszenia pracy przy EC i bez niego, są – liczby można otrzymać przybliżone, zależy to od współczynnika dokładności producenta sprzętu, ale wynik obliczeń bardzo pomaga w zaplanowaniu konfiguracji.
Prosta schemat komponentów przechowywania nie oznacza, że te komponenty nie pochłaniają ale jeśli wcześniej wszystkie wydatki zostaną dokładnie obliczone, można liczyć na współpracę obok hypervisora.
Istnieje schemat porównania zużycia zasobów sprzętowych przez usługi Ceph i Virtuozzo storage.
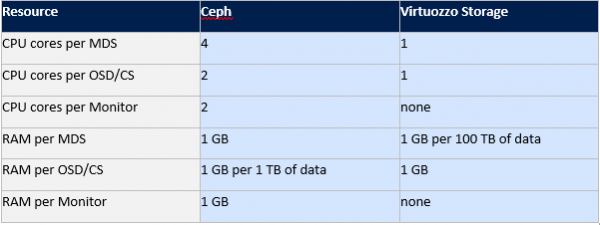
Jeśli wcześniej porównywanie Gluster i Ceph można było przeprowadzić według starych artykułów, wybierając najważniejsze wątki, to z Virtuozzo jest trudniej. Artykułów o tym produkcie nie jest tak dużo i informacje można czerpać tylko z dokumentacji na lub po rosyjsku, jeśli rozważać Vstorage jako magazyn używany w niektórych rozwiązaniach hiperzwirtualnych w takich firmach jak i Acronis.
Postaram się pomóc w opisaniu tej architektury, więc tekst będzie nieco dłuższy, ale aby samodzielnie zrozumieć dokumentację, potrzebujesz dużo czasu, a posiadaną dokumentację można wykorzystać jedynie jako podręcznik, przeglądając spis treści lub szukając po słowach kluczowych.
Rozważmy proces zapisu w hybrydowej konfiguracji sprzętowej z powyżej opisanymi komponentami: zapis rozpoczyna się na tym węźle, z którego został zainicjowany przez klienta (usługa punktu montowania FUSE), jednak komponent głównej usługi metadanych (MDS) oczywiście skieruje klienta bezpośrednio do odpowiedniej usługi chunk (usługi przechowywania bloków CS), co oznacza, że MDS nie bierze udziału w procesie zapisu, a jedynie kieruje do odpowiedniego serwisu chunk. Ogólnie można porównać zapis do rozlewania wody po beczkach. Każda beczka to blok danych o pojemności 256MB.
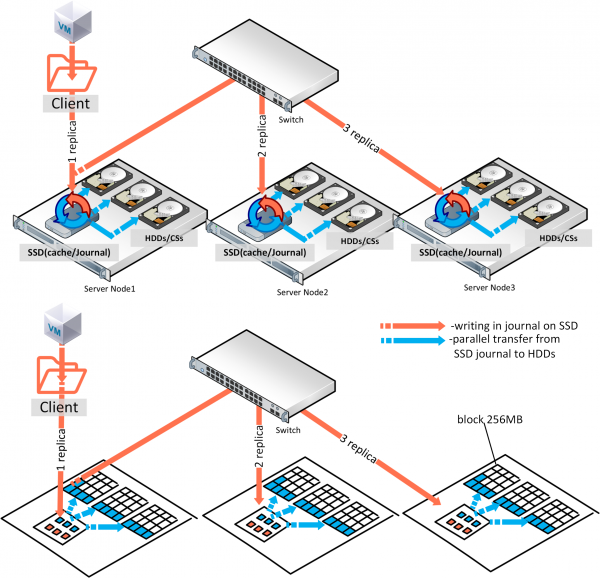
To znaczy, że jeden dysk to pewna liczba takich beczek, więc objętość dysku dzielona przez 256MB. Każda kopia jest rozlewana na jeden węzeł, druga niemal równocześnie na inny węzeł itd. Jeśli mamy trzy repliki i są dyski SSD do buforowania (do odczytu i dzienników zapisu), to potwierdzenie zapisu następuje po zapisaniu dziennika w SSD, a równoległe przesyłanie z SSD kontynuuje się na HDD w tle. W przypadku trzech replik zatwierdzenie zapisu następuje po potwierdzeniu od SSD trzeciego węzła. Może się wydawać, że sumę prędkości zapisu trzech SSD można podzielić na trzy i otrzymamy prędkość zapisu jednej repliki, ale zapis kopii odbywa się równolegle, a opóźnienie sieci zwykle jest wyższe niż w przypadku SSD, a w rzeczywistości wydajność zapisu będzie zależała od sieci. W związku z tym, aby zobaczyć rzeczywiste IOPS należy prawidłowo obciążyć cały Vstorage zgodnie z , to znaczy testować rzeczywiste obciążenie, a nie pamięć i cache, gdzie należy uwzględnić odpowiedni rozmiar bloku danych, liczbę wątków itd.
Wymieniony powyżej dziennik zapisu na SSD działa tak, że gdy tylko dane do niego trafią, są natychmiast odczytywane przez serwis i zapisywane na HDD. Serwisów metadanych (MDS) jest kilka na klaster, a ich liczba jest określana przez kworum, które działa według algorytmu Paxos. Z punktu widzenia klienta punkt montowania FUSE to folder pamięci klastra, który jest jednocześnie widoczny dla wszystkich węzłów klastra. Każdy węzeł ma zamontowanego klienta na tej zasadzie, dlatego każdemu węzłowi dostępne jest to przechowywanie.
Dla wydajności każdego z powyżej opisanych podejść bardzo ważne jest, na etapie planowania i wdrażania, prawidłowe skonfigurowanie sieci, w której zbalansowanie odbywa się dzięki agregacji oraz odpowiednio dobranej przepustowości kanału sieciowego. W agregacji kluczowe jest właściwe dobranie trybu haszowania i rozmiarów ramki. Istnieje również znacząca różnica w porównaniu do powyżej opisanych SDS, jest to FUSE z technologią fast path w Virtuozzo Storage. Ten, oprócz zmodyfikowanego FUSE, w przeciwieństwie do innych rozwiązań open source, znacznie zwiększa IOPS i pozwala na skalowanie zarówno horyzontalne, jak i pionowe. W porównaniu do wyżej opisanych architektur, ta wydaje się być bardziej wydajna, ale za tę przyjemność należy oczywiście wykupić licencje, w przeciwieństwie do Ceph i Gluster.
Podsumowując, można wyróżnić czołową trójkę: pierwsze miejsce pod względem wydajności i niezawodności zajmuje Virtuozzo Storage, drugie Ceph, a trzecie Gluster.
Kryteria, według których wybrano Virtuozzo Storage: to optymalny zestaw komponentów architektury, zmodyfikowany FUSE z fast path, elastyczny zestaw konfiguracji sprzętowej, mniejsze zużycie zasobów oraz możliwość współdzielenia z obliczeniami/wirtualizacją, co czyni go idealnym do rozwiązań hiper-konwergentnych, w skład których wchodzi. Drugie miejsce zajmuje Ceph, ponieważ jest to bardziej wydajna architektura w porównaniu do Gluster, dzięki operowaniu blokami oraz bardziej elastycznymi scenariuszami i możliwością pracy w bardziej rozbudowanych klastrach.
W planach jest chęć napisania porównania między vSAN, Space Direct Storage, Vstorage i Nutanix Storage, testowania Vstorage na sprzęcie HPE, Huawei, a także scenariuszy integracji Vstorage z zewnętrznymi systemami pamięci masowej, dlatego jeśli artykuł przypadł Ci do gustu, fajnie byłoby uzyskać od Ciebie opinie, które mogłyby wzmocnić motywację do pisania nowych artykułów z uwzględnieniem Twoich uwag i sugestii.
Źródło: habr.com
