

Cześć wszystkim. Z tej strony Omyelnitsky Sergey. Niedawno prowadziłem strumień na temat programowania reaktywnego, gdzie opowiadałem o asynchroniczności w JavaScript. Dziś chciałbym podsumować ten materiał.
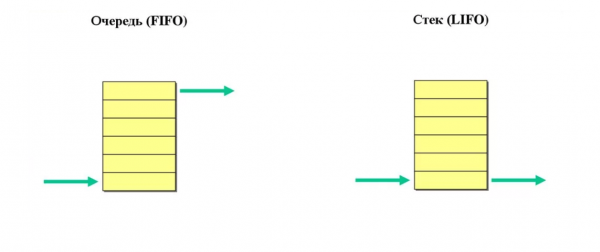
Ale zanim zaczniemy od głównego materiału, musimy zrobić wprowadzenie. Zacznijmy od definicji: co to jest stos i kolejka?
Stos to zbiór, w którym elementy są pobierane według zasady „ostatni wszedł, pierwszy wyszedł” LIFO.
Kolejka to zbiór, w którym elementy są pobierane według zasady „pierwszy wszedł, pierwszy wyszedł” FIFO.
Dobrze, kontynuujmy.
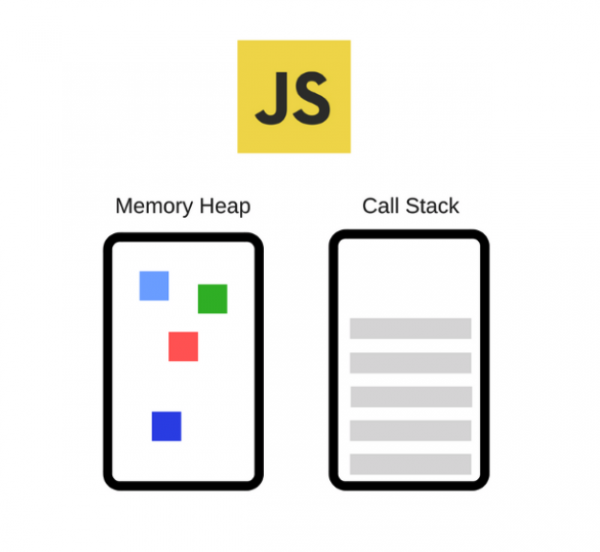
JavaScript to język programowania jednowątkowego. Oznacza to, że ma tylko jeden wątek wykonawczy i jeden stos, do którego funkcje są dodawane w kolejce do wykonania. W związku z tym w danym momencie JavaScript może wykonać tylko jedną operację, a pozostałe operacje będą czekać w kolejce na stosie, aż zostaną wywołane.
Stos wywołań to struktura danych, która, mówiąc uproszczonym językiem, zapisuje informacje o miejscu w programie, w którym się znajdujemy. Gdy przechodzimy do funkcji, dodajemy wpis o niej do górnej części stosu. Kiedy wracamy z funkcji, usuwamy z góry stosu najnowszy element i wracamy tam, skąd wywołano tę funkcję. To wszystko, czym dysponuje stos. A teraz bardzo interesujące pytanie: jak zatem działa asynchroniczność w JavaScript?
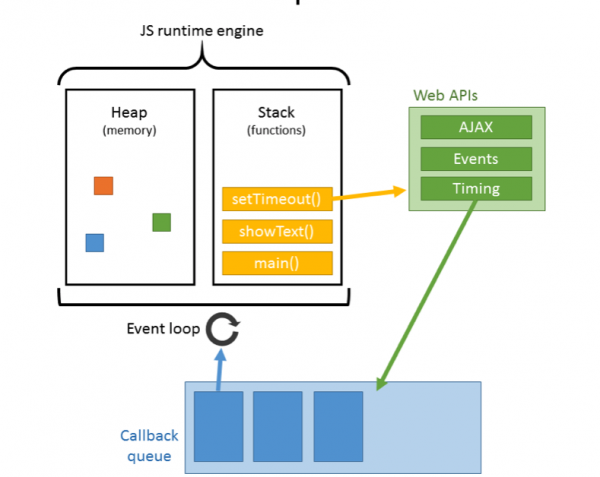
W rzeczywistości oprócz stosu w przeglądarkach istnieje specjalna kolejka do pracy z tzw. WebAPI. Funkcje w tej kolejce zostaną wykonane w porządku tylko po całkowitym opróżnieniu stosu. Dopiero wtedy zostaną przeniesione z kolejki do stosu do wykonania. Jeśli w stosie jest przynajmniej jeden element, nie mogą one wejść na stos. To właśnie z tego powodu wywołania funkcji po upływie czasu często są nieterminowe, ponieważ funkcja nie może wejść z kolejki do stosu, dopóki jest on zajęty.
Przyjrzyjmy się następującemu przykładowi i zajmijmy się jego krokowym „wykonaniem”. Zobaczmy również, co w tym czasie dzieje się w systemie.
console.log('Hi);
setTimeout(function cb1() {
    console.log('cb1');
}, 5000);
console.log('Bye');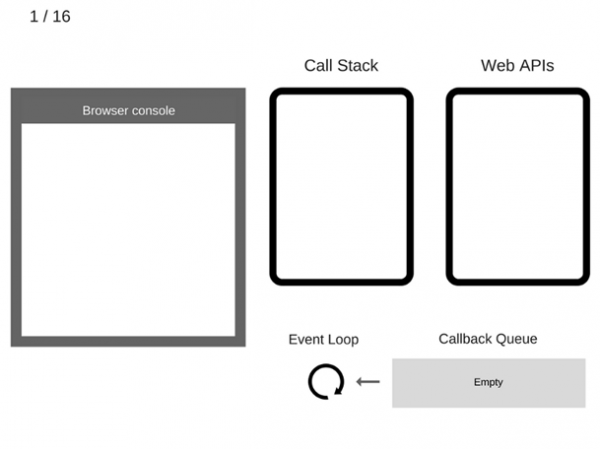
1) Na razie nic się nie dzieje. Konsola przeglądarki jest czysta, stos wywołań pusty.
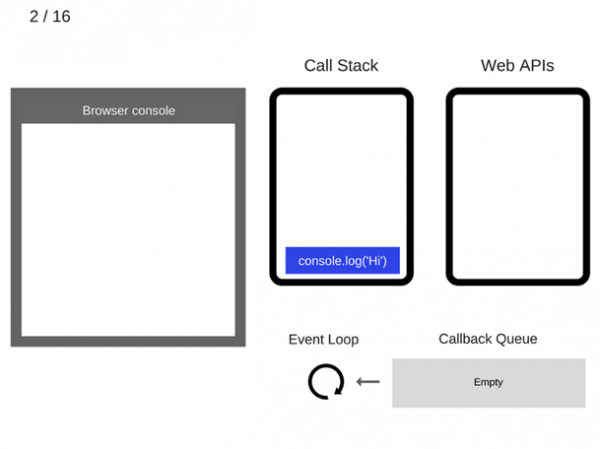
2) Następnie polecenie console.log(‘Hi’) jest dodawane do stosu wywołań.
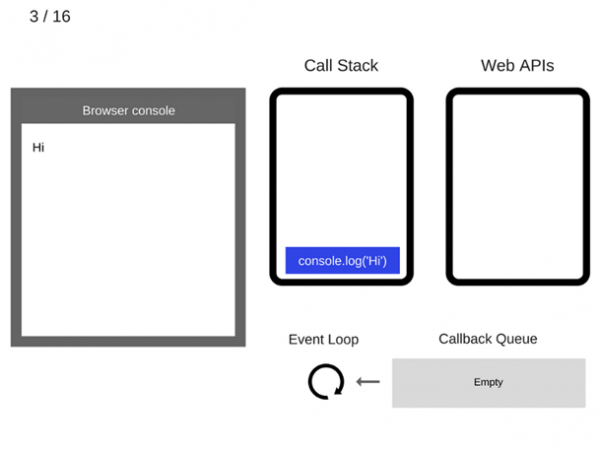
3) I jest wykonywane.
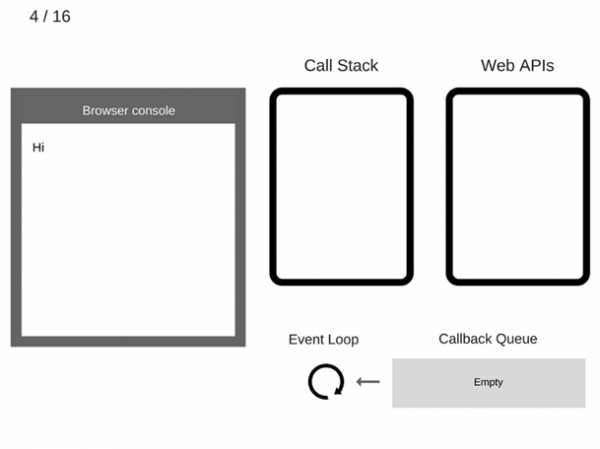
4) Następnie console.log(‘Hi’) jest usuwane ze stosu wywołań.
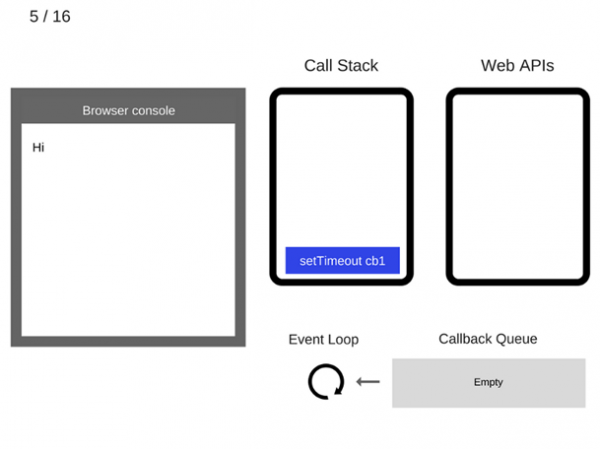
5) Teraz przechodzimy do polecenia setTimeout(function cb1() {… }). Zostaje dodane do stosu wywołań.
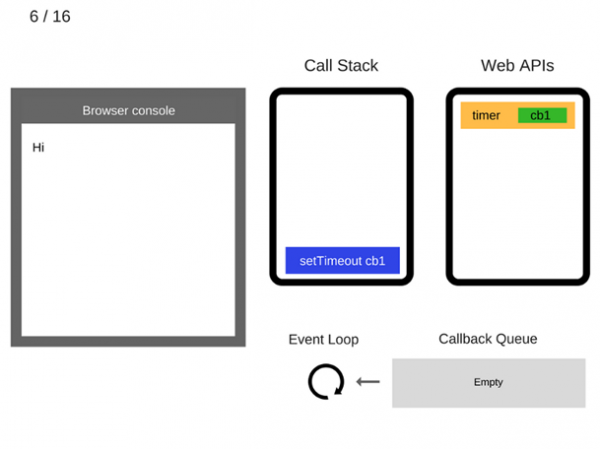
6) Polecenie setTimeout(function cb1() {… }) jest wykonywane. Przeglądarka tworzy licznik, który jest częścią Web API. Rozpocznie odliczanie czasu.
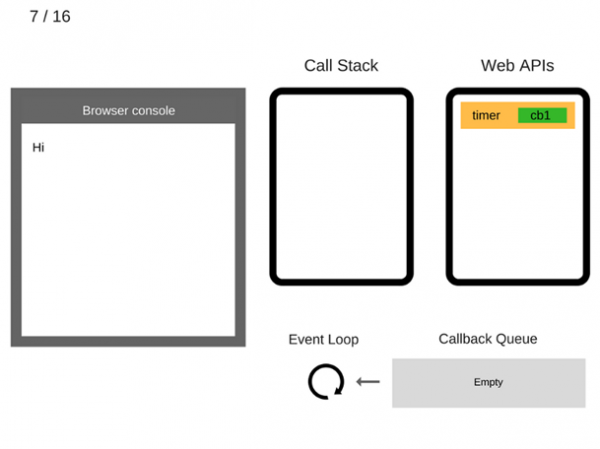
7) Polecenie setTimeout(function cb1() {… }) zakończyło działanie i zostało usunięte ze stosu wywołań.
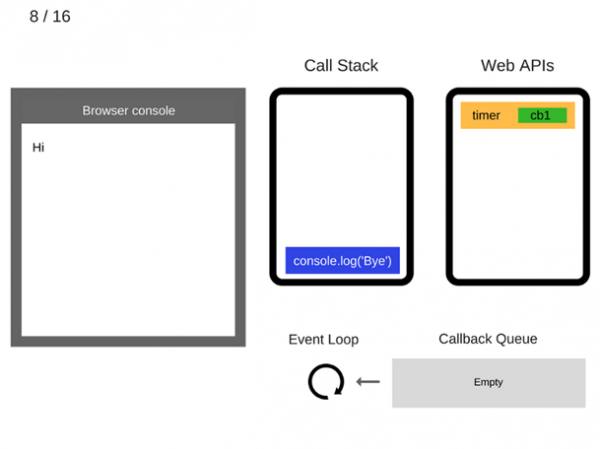
8) Polecenie console.log(‘Bye’) zostaje dodane do stosu wywołań.
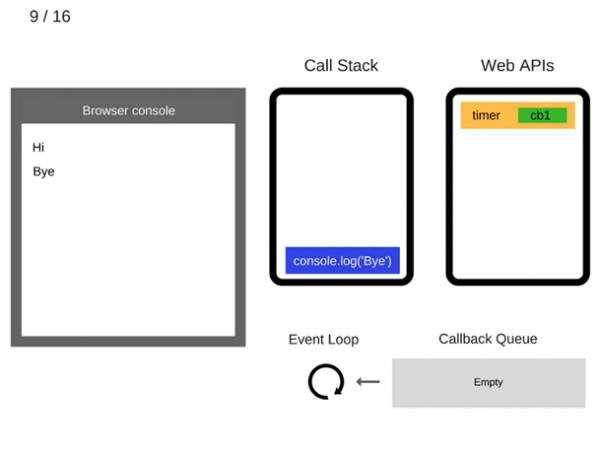
9) Polecenie console.log(‘Bye’) jest wykonywane.
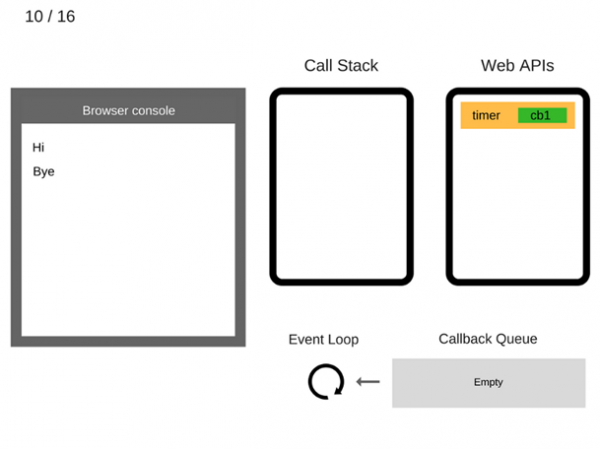
10) Polecenie console.log(‘Bye’) jest usuwane ze stosu wywołań.
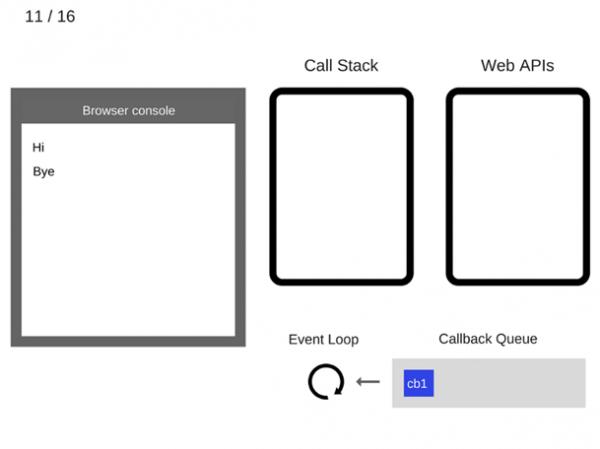
11) Po upływie co najmniej 5000 ms, licznik kończy działanie i umieszcza callback cb1 w kolejce callbacków.
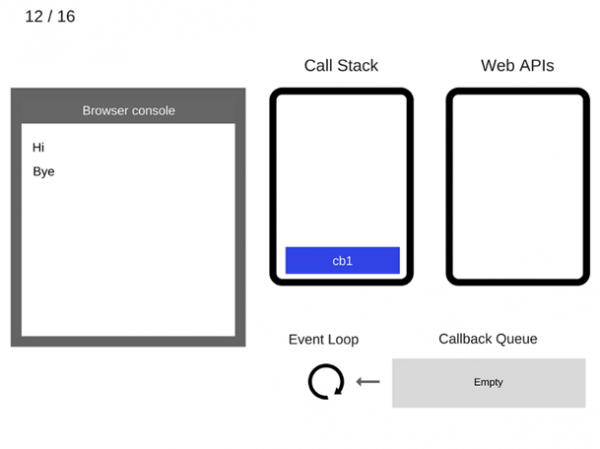
12) Pętla wydarzeń bierze funkcję cb1 z kolejki callbacków i umieszcza ją w stosie wywołań.
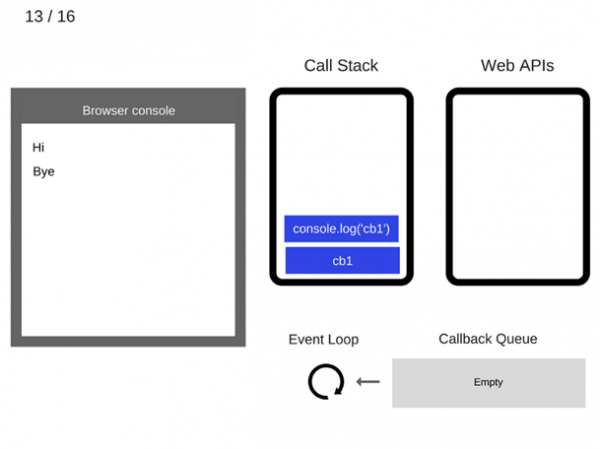
13) Funkcja cb1 jest wykonywana i dodaje console.log(‘cb1’) do stosu wywołań.
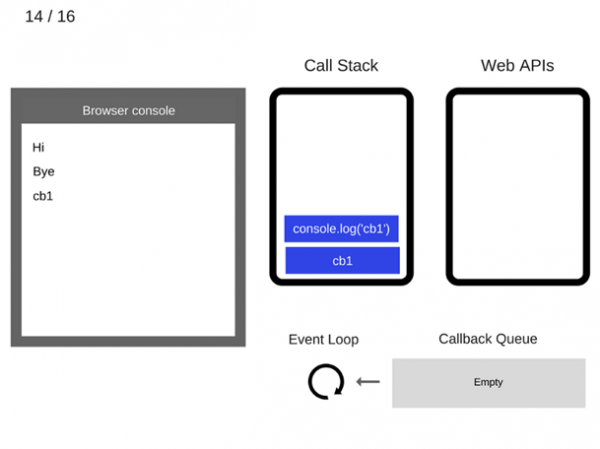
14) Polecenie console.log(‘cb1’) jest wykonywane.
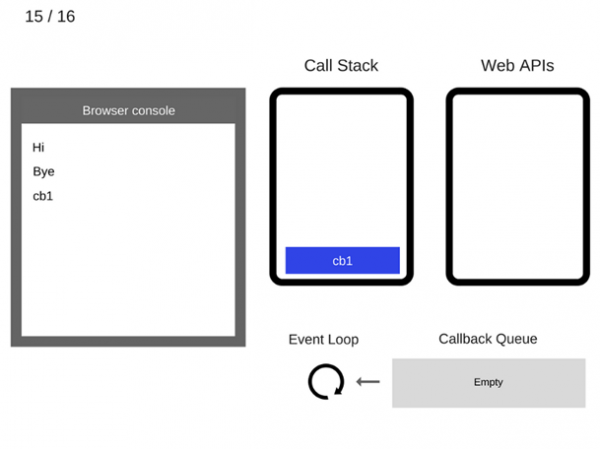
15) Polecenie console.log(‘cb1’) jest usuwane ze stosu wywołań.
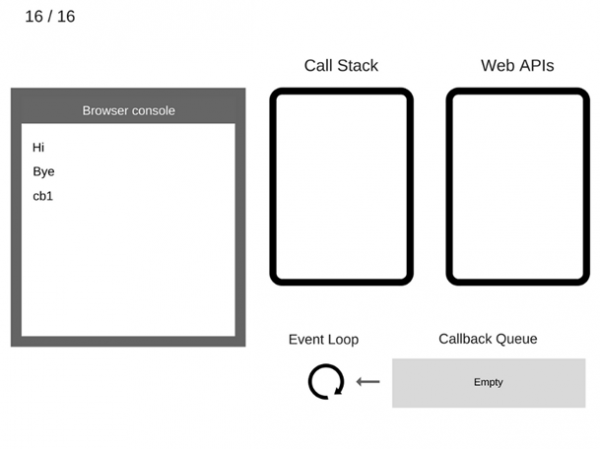
16) Funkcja cb1 jest usuwana ze stosu wywołań.
Spójrzmy na przykład w dynamicznej formie:
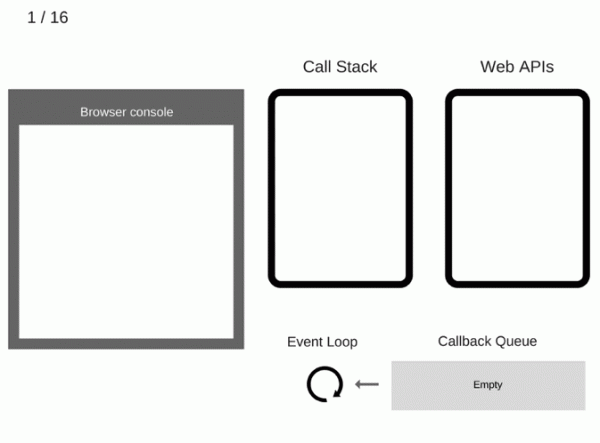
Oto my, omówiliśmy, jak w JavaScript zrealizowano asynchroniczność. Teraz porozmawiajmy krótko o ewolucji kodu asynchronicznego.
Ewolucja kodu asynchronicznego.
a(function (resultsFromA) {
    b(resultsFromA, function (resultsFromB) {
        c(resultsFromB, function (resultsFromC) {
            d(resultsFromC, function (resultsFromD) {
                e(resultsFromD, function (resultsFromE) {
                    f(resultsFromE, function (resultsFromF) {
                        console.log(resultsFromF);
                    })
                })
            })
        })
    })
});
Asynchroniczne programowanie, jakie znamy w JavaScript, można zrealizować tylko za pomocą funkcji. Mogą być przekazywane jak każda inna zmienna do innych funkcji. Tak narodziły się callbacki. I to jest fajne, zabawne i ekscytujące, dopóki nie zamienia się w smutek i tęsknotę. Dlaczego? Bo to proste:
- Wraz ze wzrostem złożoności kodu, projekt szybko przekształca się w trudne do zrozumienia wielokrotnie zagnieżdżone bloki — „callback hell”.
- Łatwo można przeoczyć obsługę błędów.
- Nie można zwracać wyrażeń za pomocą return.
Po pojawieniu się Promise sytuacja stała się nieco lepsza.
new Promise(function(resolve, reject) {
    setTimeout(() => resolve(1), 2000);

}).then((result) => {
    alert(result);
    return result + 2;

}).then((result) => {
    throw new Error('FAILED HERE');
    alert(result);
    return result + 2;

}).then((result) => {
    alert(result);
    return result + 2;

}).catch((e) => {
    console.log('error: ', e);
});- Pojawiły się łańcuchy obietnic, co poprawiło czytelność kodu.
- Pojawiła się oddzielna metoda przechwytywania błędów.
- Pojawiła się możliwość równoległego wykonywania za pomocą Promise.all.
- Zagnieżdżoną asynchroniczność możemy rozwiązać za pomocą async/await.
Jednak obietnica ma swoje ograniczenia. Na przykład, obietnicy, bez tańca z bębnem, nie można anulować, a co najważniejsze — działa z jedną wartością.
No i płynnie przeszliśmy do programowania reaktywnego. Zmęczony? Cóż, można zrobić sobie herbatę, przemyśleć to i wrócić do czytania. A ja kontynuuję.
Programowanie reaktywne— to paradygma programowania skoncentrowana na strumieniach danych i propagacji zmian. Przyjrzyjmy się bardziej szczegółowo, czym jest strumień danych.
// Получаем ссылку на элемент
const input = ducument.querySelector('input');

const eventsArray = [];

// Пушим каждое событие в массив eventsArray
input.addEventListener('keyup',
    event => eventsArray.push(event)
);
Wyobraźmy sobie, że mamy pole wejściowe. Tworzymy tablicę i na każde zdarzenie keyup w input będziemy zapisywać to zdarzenie w naszej tablicy. Przy tym chciałbym zaznaczyć, że nasza tablica jest posortowana według czasu, tzn. indeks późniejszych zdarzeń jest większy od indeksu wcześniejszych. Taka tablica jest uproszczoną wersją strumienia danych, ale to jeszcze nie strumień. Aby tę tablicę można było nazwali strumieniem, musi ona w jakiś sposób informować subskrybentów o tym, że nadeszły nowe dane. W ten sposób dotarliśmy do definicji strumienia.
Strumień danych
const { interval1 } = Rx;
const { take } = RxOperators;

interval(1000).pipe(
    take(4)
)
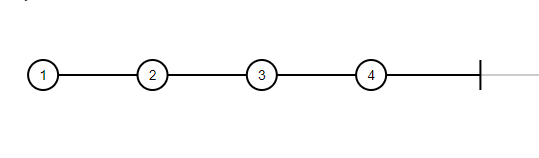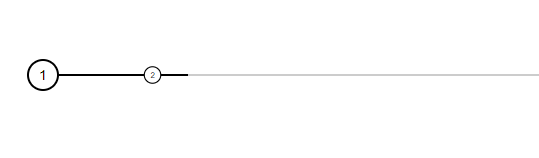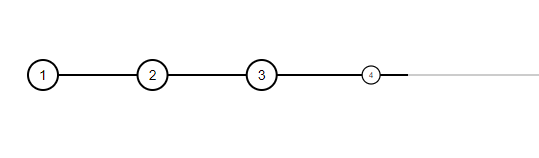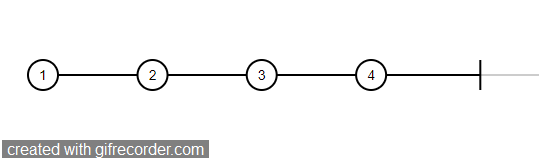
Strumień— to posortowana według czasu tablica danych, która może informować o tym, że dane się zmieniły. A teraz wyobraź sobie, jak wygodnie będzie pisać kod, w którym jedno działanie wymaga wywołania kilku zdarzeń w różnych miejscach kodu. Po prostu subskrybujemy strumień i on sam nas informuje, kiedy nastąpią zmiany. I to potrafi robić biblioteka RxJs.
RxJS — to biblioteka do pracy z asynchronicznymi i zdarzeniowymi programami z użyciem obserwowalnych sekwencji. Biblioteka dostarcza podstawowy typ Observable, kilka typów pomocniczych (Observer, Schedulers, Subjects) oraz operatory do pracy ze zdarzeniami jako kolekcjami (map, filter, reduce, every i podobne z JavaScript Array).
Przyjrzyjmy się podstawowym pojęciom tej biblioteki.
Observable, Observer, Producer
Observable — pierwszy podstawowy typ, który omówimy. Ta klasa zawiera główną część implementacji RxJs. Jest powiązana z obserwowalnym strumieniem, na który można subskrybować za pomocą metody subscribe.
W Observable wprowadzany jest pomocniczy mechanizm do tworzenia aktualizacji, zwany Observer. Źródłem wartości dla Observera jest Producent. Może to być tablica, iterator, websocket, jakieś zdarzenie itp. Można więc powiedzieć, że observable jest przewodnikiem między Producerem a Observerem.
Observable obsługuje trzy rodzaje zdarzeń Observera:
- next – nowe dane
- error – błąd, jeśli sekwencja zakończyła się z powodu wyjątku. To zdarzenie również sugeruje zakończenie sekwencji.
- complete — sygnał o zakończeniu sekwencji. Oznacza to, że nie będzie już nowych danych
Zobaczmy demo:
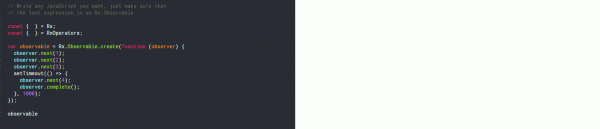
Na początku przetworzymy wartości 1, 2, 3, a po 1 sek. otrzymamy 4 i zakończymy nasz strumień.
Myśli na głos
I w tym momencie zrozumiałem, że bardziej interesujące jest opowiadanie o tym niż pisanie. 😀
Subscription
Kiedy subskrybujemy strumień, tworzymy nową klasę subscription, która daje nam możliwość anulowania subskrypcji za pomocą metody unsubscribe. Możemy również grupować subskrypcje za pomocą metody add. Oczywiście możemy również rozgrupować strumienie za pomocą usuń. Metody add i remove przyjmują inną subskrypcję jako argument. Należy zauważyć, że kiedy się wypisujemy, wypisujemy się ze wszystkich subskrypcji podrzędnych, jakbyśmy wywoływali metodę unsubscribe na nich. Przechodzimy dalej.
Rodzaje strumieni
| HOT | COLD |
|---|---|
| Producent jest tworzony na zewnątrz observable | Producent jest tworzony wewnątrz observable |
| Dane są przekazywane w momencie tworzenia observable | Dane są przekazywane w momencie subskrypcji |
| Wymagana jest dodatkowa logika do wypisania się | Strumień kończy się samodzielnie |
| Używa relacji jeden-do-wielu | Używa relacji jeden-do-jednego |
| Wszystkie subskrypcje mają tę samą wartość | Subskrypcje są niezależne |
| Dane mogą zostać utracone, jeśli nie ma subskrypcji | Wydaje wszystkie wartości strumienia dla nowej subskrypcji |
Gdybym miał to przyrównać, wyobraziłbym sobie gorący strumień jako film w kinie. W którym momencie przyszedłeś, od tego momentu zacząłeś oglądanie. Zimny strumień porównałbym do telefonu do wsparcia technicznego. Każdy, kto dzwoni, słucha nagrania automatycznej sekretarki od początku do końca, ale możesz rozłączyć się za pomocą unsubscribe.
Chciałbym zauważyć, że istnieją także tak zwane ciepłe strumienie (takie określenie spotkałem bardzo rzadko, tylko w zagranicznych społecznościach) — to strumień, który przekształca się z zimnego strumienia w gorący. Powstaje pytanie — gdzie go używać)) Podam przykład z praktyki.
Pracuję z angularem. Aktywnie wykorzystuje rxjs. Aby uzyskać dane z serwera, oczekuję zimnego strumienia i korzystam z niego w szablonie za pomocą asyncPipe. Jeśli używam tego pipera kilka razy, wracając do definicji zimnego strumienia, każdy pipe będzie pytał dane z serwera, co delikatnie mówiąc jest dziwne. A jeśli przekształcę zimny strumień w ciepły, to zapytanie odbędzie się tylko raz.
W ogóle zrozumienie rodzajów strumieni jest dość skomplikowane dla początkujących, ale istotne.
Operatory
return this.http.get(`${environment.apiUrl}/${this.apiUrl}/trade_companies`)
    .pipe(
        tap(({ data }: TradeCompanyList) => this.companies$$.next(cloneDeep(data))),
        map(({ data }: TradeCompanyList) => data)
    );
Możliwości pracy ze strumieniami rozszerzają nam operatory. Pomagają one kontrolować zdarzenia zachodzące w Observable. Omówimy kilka najpopularniejszych, a dokładniej z operatorami można zapoznać się w linkach w przydatnych informacjach.
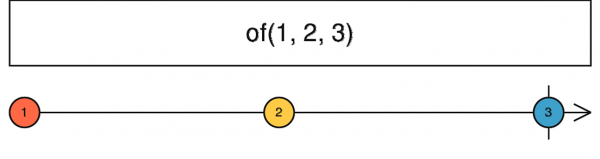
Operatory — of
Zaczniemy od pomocniczego operatora of. Tworzy on Observable na podstawie prostych wartości.
Operatory — filter
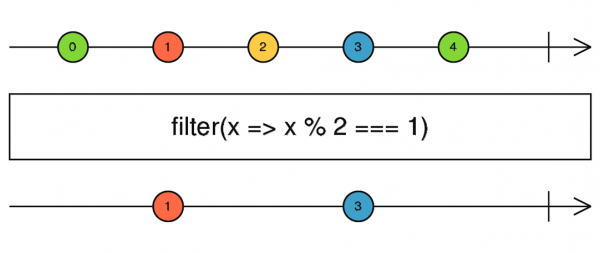
Operator filtrowania filter, jak można się domyślić po nazwie, filtruje sygnał strumienia. Jeśli operator zwraca prawdę, to przepuszcza dalej.
Operatory — take
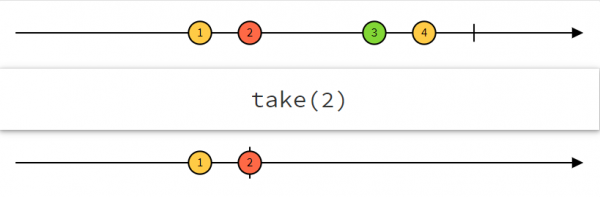
take — Przyjmuje wartość liczby emitów, po której kończy strumień.
Operatory — debounceTime
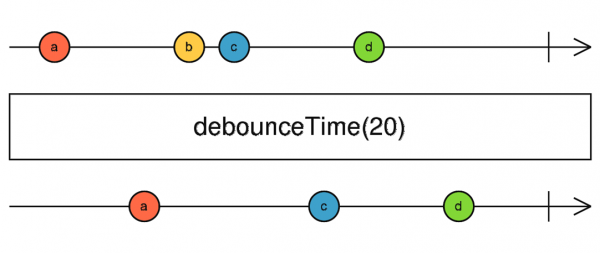
debounceTime — odrzuca emitowane wartości, które mieszczą się w określonym przedziale czasowym między wyjściowymi danymi — po upływie interwału czasowego emituje ostatnią wartość.
const { Observable } = Rx;
const { debounceTime, take } = RxOperators;

Observable.create((observer) => {
  let i = 1;
  observer.next(i++);
  // Emituj wartość co 1000ms
  setInterval(() => {
    observer.next(i++)
  }, 1000);

 // Emituj wartość co 1500ms
  setInterval(() => {
    observer.next(i++)
  }, 1500);
}).pipe(
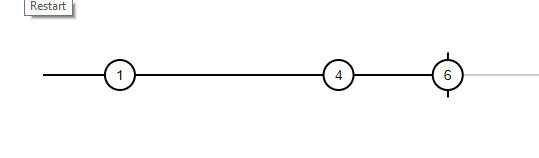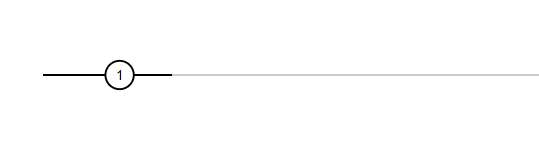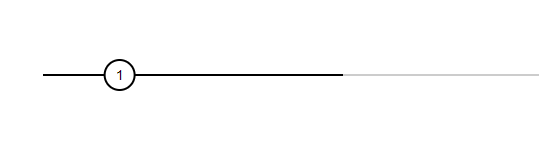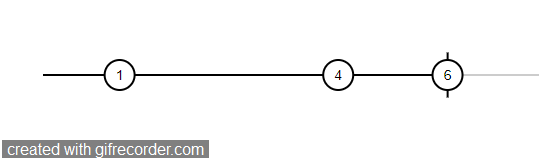
  debounceTime(700),  // Czekaj 700ms na wartość przed przetworzeniem
  take(3)
); 
Operatory — takeWhile
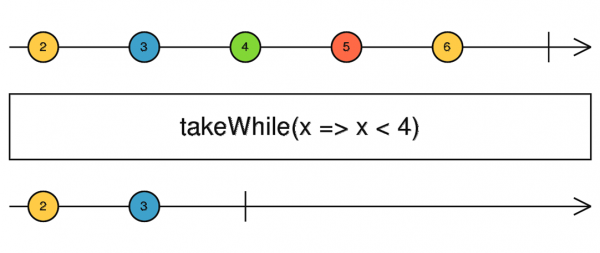
Emituje wartości, dopóki takeWhile nie zwróci false, po czym wypisuje się z strumienia.
const { Observable } = Rx;
const { debounceTime, takeWhile } = RxOperators;

Observable.create((observer) => {
  let i = 1;
  observer.next(i++);
  // Emit value every 1000ms
  setInterval(() => {
    observer.next(i++)
  }, 1000);
}).pipe(
  takeWhile(producer => producer < 5)
); 
Operatory — combineLatest
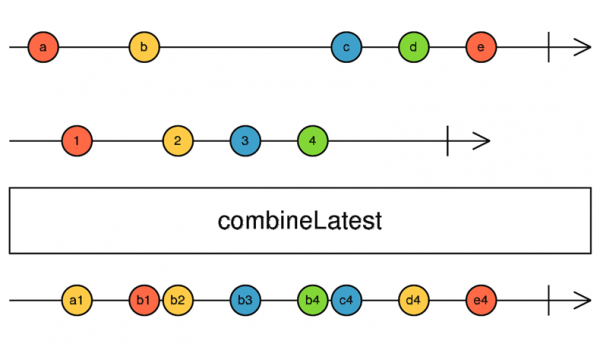
Operatory łączące combineLatest działają podobnie do promise.all. Łączą wiele strumieni w jeden. Po tym, jak każdy strumień emituje przynajmniej jeden wynik, otrzymujemy ostatnie wartości z każdego w postaci tablicy. Następnie, po dowolnym emisji z połączonych strumieni, będą one zwracać nowe wartości.
const { combineLatest, Observable } = Rx;
const { take } = RxOperators;

const observer_1 = Observable.create((observer) => {
  let i = 1;
  // Emit value every 1000ms
  setInterval(() => {
    observer.next('a: ' + i++);
  }, 1000);
});

const observer_2 = Observable.create((observer) => {
  let i = 1;
  // Emit value every 750ms
  setInterval(() => {
    observer.next('b: ' + i++);
  }, 750);
});

combineLatest(observer_1, observer_2).pipe(take(5));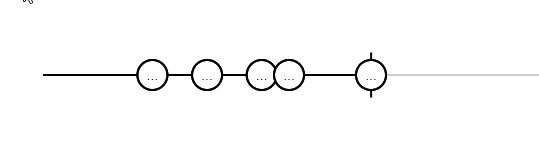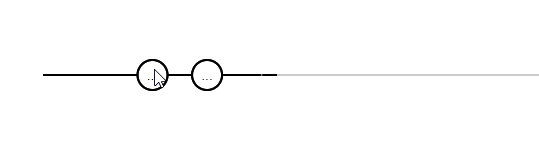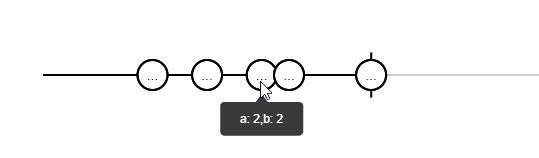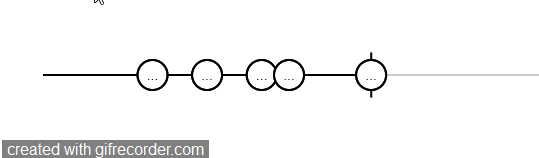
Operatory — zip
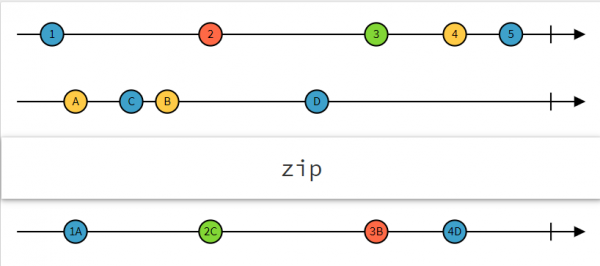
Zip — czeka na wartość z każdego strumienia i tworzy tablicę na podstawie tych wartości. Jeśli wartość nie przyjdzie z jakiegokolwiek strumienia, grupa nie zostanie utworzona.
const { zip, Observable } = Rx;
const { take } = RxOperators;

const observer_1 = Observable.create((observer) => {
  let i = 1;
  // Emit value every 1000ms
  setInterval(() => {
    observer.next('a: ' + i++);
  }, 1000);
});

const observer_2 = Observable.create((observer) => {
  let i = 1;
  // Emit value every 750ms
  setInterval(() => {
    observer.next('b: ' + i++);
  }, 750);
});

const observer_3 = Observable.create((observer) => {
  let i = 1;
  // Emit value every 500ms
  setInterval(() => {
    observer.next('c: ' + i++);
  }, 500);
});

zip(observer_1, observer_2, observer_3).pipe(take(5));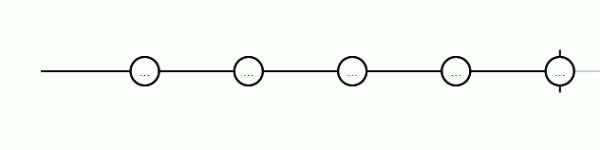
Operatory — forkJoin
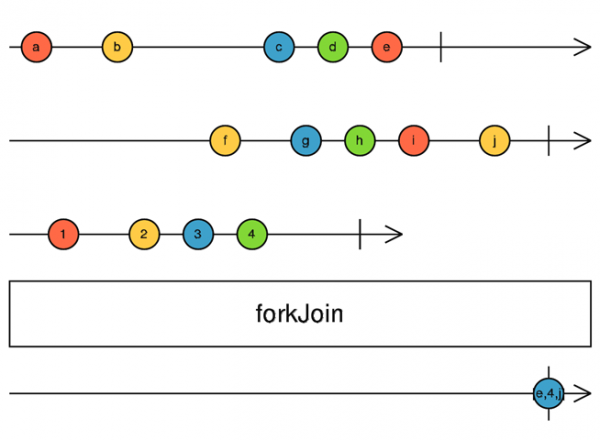
forkJoin również łączy strumienie, ale emituje wartość tylko wtedy, gdy wszystkie strumienie zostaną zakończone (complete).
const { forkJoin, Observable } = Rx;
const { take } = RxOperators;

const observer_1 = Observable.create((observer) => {
  let i = 1;
  // Emit value every 1000ms
  setInterval(() => {
    observer.next('a: ' + i++);
  }, 1000);
}).pipe(take(3));

const observer_2 = Observable.create((observer) => {
  let i = 1;
  // Emit value every 750
  setInterval(() => {
    observer.next('b: ' + i++);
  }, 750);
}).pipe(take(5));

const observer_3 = Observable.create((observer) => {
  let i = 1;
  // Emit value every 500
  setInterval(() => {
    observer.next('c: ' + i++);
  }, 500);
}).pipe(take(4));

forkJoin(observer_1, observer_2, observer_3);
Operatory — map
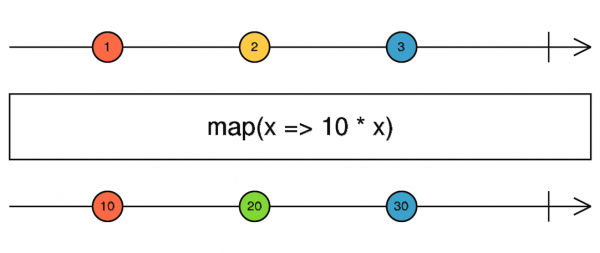
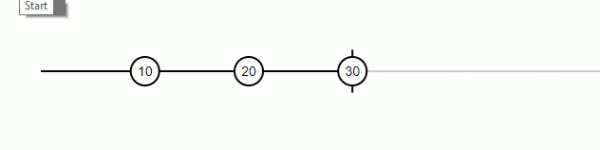
Operator transformacji map przekształca wartość emisji w nową.
const { Observable } = Rx;
const { take, map } = RxOperators;

Observable.create((observer) => {
  let i = 1;
  // Emit value every 1000ms
  setInterval(() => {
    observer.next(i++);
  }, 1000);
}).pipe(
  map(x => x * 10),
  take(3)
);
Operatory – share, tap
Operator tap pozwala na wykonywanie efektów ubocznych, to znaczy jakiekolwiek działania, które nie wpływają na sekwencję.
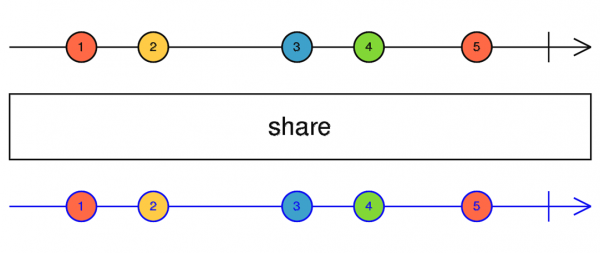
Operator pomocniczy share potrafi przekształcić zimny strumień w gorący.
Skończyliśmy z operatorami. Przejdźmy do Subject.
Myśli na głos
I wtedy poszedłem na herbatę. Te przykłady mnie zmęczyły 😀
Rodzina subjectów
Rodzina subjectów jest wyraźnym przykładem gorących strumieni. Te klasy są pewnym hybrydą, które pełnią jednocześnie rolę observable i observer. Ponieważ subject jest gorącym strumieniem, należy z niego wypisywać. Jeśli mówimy o głównych metodach, to są to:
- next – przesyłanie nowych danych do strumienia
- error – błąd i zakończenie strumienia
- complete – zakończenie strumienia
- subscribe – subskrybować strumień
- unsubscribe – wypisać się ze strumienia
- asObservable – przekształcamy w obserwatora
- toPromise – przekształca w promesę
Wyróżnia się 4 5 typów subjectów.
Myśli na głos
Na streamie mówiłem 4, a okazało się, że dodali jeszcze jeden. Jak to mówią, żyj i ucz się.
Prosty Subject new Subject()– najprostszy rodzaj subjectów. Tworzony bez parametrów. Przesyła wartości, które przychodzą tylko po subskrypcji.
BehaviorSubject new BehaviorSubject(defaultData) – moim zdaniem najpopularniejszy rodzaj subjectów. Przyjmuje na wejściu wartość domyślną. Zawsze zachowuje dane ostatniego emitowanej, które przesyła przy subskrypcji. Klasa ta ma również użyteczną metodę value, która zwraca bieżącą wartość strumienia.
ReplaySubject new ReplaySubject(bufferSize?: number, windowTime?: number) – Może opcjonalnie przyjąć jako pierwszy argument rozmiar bufora wartości, które będzie przechowywać, a jako drugi czas, w którym potrzebna jest zmiana.
AsyncSubject new AsyncSubject() – przy subskrypcji nic się nie dzieje, a wartość zostanie zwrócona tylko przy complete. Zwróci tylko ostatnią wartość strumienia.
WebSocketSubject new WebSocketSubject(urlConfigOrSource: string | WebSocketSubjectConfig | Observable, destination?: Observer) – O nim dokumentacja milczy i ja sam go widzę po raz pierwszy. Kto wie, co on robi, piszcie, uzupełnimy.
Uff. No cóż, omówiliśmy wszystko, co chciałem dzisiaj powiedzieć. Mam nadzieję, że te informacje były pomocne. Samodzielnie można zapoznać się z listą literatury w zakładce z przydatnymi informacjami.
Przydatne informacje
- – link do streamu
- – Jak działa JS: przegląd silnika, mechanizmów wykonywania, stosu wywołań
- — Jak działa JS: cykl zdarzeń, asynchroniczność i pięć sposobów na poprawę kodu za pomocą async / await
- — Jak działa Event Loop w JavaScript
- — Ewolucja asynchronicznego JavaScriptu
- — Czym jest RxJS i dlaczego warto o nim wiedzieć
- — Praktyczne zastosowanie RxJS
- — Samouczek RxJS Observables — Tworzenie i subskrypcja Observable’ów
- — RXJS: Obserwowalne gorące i zimne
- — Klasy, funkcje do tworzenia Observable. Operatory.
- — Operatory RxJS z przykładem
- — Lista API
- — Rodzaje Subject i harmonogramy w RxJS
Źródło: habr.com
