

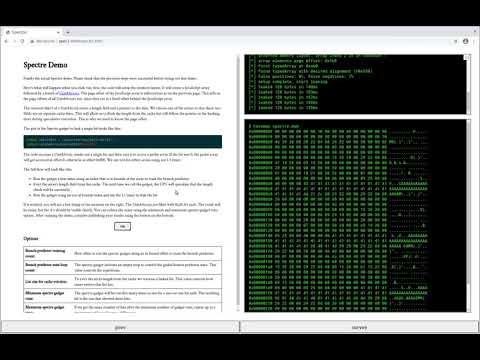
Firma Google opublikowała kilka prototypów exploitów, które pokazują możliwość wykorzystania luk klasy Spectre podczas wykonywania kodu JavaScript w przeglądarce, omijając wcześniej wprowadzone metody zabezpieczeń. Exploity mogą być używane do uzyskania dostępu do pamięci procesu, który przetwarza treści webowe na bieżącej karcie. W celu przetestowania działania exploitów uruchomiono stronę leaky.page, a kod opisujący logikę działania został umieszczony na GitHubie.
Proponowany prototyp jest zaprojektowany do przeprowadzania ataków na systemy z procesorami Intel Core i7-6500U w środowisku Linux i Chrome 88. Aby zastosować exploit w innych środowiskach, konieczne są zmiany. Metoda eksploatacji nie jest specyficzna dla procesorów Intel — po odpowiedniej adaptacji potwierdzono działanie exploita na systemach z CPU innych producentów, w tym Apple M1 opartych na architekturze ARM. Po niewielkich korektach exploit działa również w innych systemach operacyjnych oraz w innych przeglądarkach opartych na silniku Chromium.
W środowisku opartym na standardowym Chrome 88 i procesorach Intel Skylake udało się osiągnąć wyciek danych z procesu odpowiedzialnego za przetwarzanie treści webowych na bieżącej karcie Chrome (proces renderowania) z prędkością 1 kilobajta na sekundę. Dodatkowo opracowano alternatywne prototypy, na przykład exploit, który przy zmniejszonej stabilności zwiększa prędkość wycieku do 8 kB/s przy użyciu timera performance.now() z dokładnością 5 mikrosekund (0,005 milisekundy). Przygotowano także wariant działający przy dokładności timera na poziomie jednej milisekundy, który mógł być używany do organizowania dostępu do pamięci innego procesu z prędkością około 60 bajtów na sekundę.
Opublikowany kod demonstracyjny składa się z trzech części. Pierwsza część wykonuje kalibrację timera w celu oceny czasu potrzebnego na wykonanie operacji niezbędnych do przywrócenia danych pozostałych w pamięci podręcznej procesora w wyniku spekulacyjnego wykonywania instrukcji CPU. Druga część określa układ pamięci używany podczas rozmieszczania tablicy JavaScript.
Trzecia część bezpośrednio wykorzystuje lukę Spectre do określenia zawartości pamięci bieżącego procesu, tworząc warunki do spekulatywnego wykonywania określonych operacji, których wyniki są odrzucane przez procesor po ustaleniu nieudanego przewidywania, ale ślady wykonania pozostają w ogólnym cache’u i mogą być odzyskane za pomocą metod identyfikacji zawartości cache’u przez kanały boczne, analizujących zmiany czasu dostępu do danych pamiętanych i niepamiętanych.
Proponowana technika eksploatacji pozwala obejść się bez wysokiej precyzji timerów dostępnych przez API performance.now() oraz bez wsparcia dla typu SharedArrayBuffer, który umożliwia tworzenie tablic w pamięci współdzielonej. Eksploitat zawiera gadżet Spectre, który wywołuje kontrolowane spekulatywne wykonanie kodu oraz analizator wycieków przez kanały boczne, identyfikujący dane, które trafiły do cache’u w wyniku spekulatywnego wykonania.
Gadżet jest zrealizowany przy pomocy tablicy JavaScript, w której podejmowana jest próba dostępu do obszaru poza granicami bufora, mająca wpływ na stan bloku przewidywania przejść z powodu dodanej przez kompilator kontroli rozmiaru bufora (procesor spogląda w przyszłość, spekulatywnie wykonując dostęp, ale cofa stan po sprawdzeniu). W celu analizy zawartości cache’u przy niskiej precyzji timera zaproponowano metodę, która oszukuje stosowaną w procesorach strategię usuwania danych z cache’u Tree-PLRU, pozwalając na znaczne zwiększenie różnicy w czasie przy zwracaniu wartości z cache’u i przy braku wartości w cache’u.
Zauważono, że firma Google opublikowała prototyp eksploita, aby pokazać realistyczność ataków wykorzystujących luki klasy Spectre oraz aby zachęcić programistów webowych do stosowania technik minimalizujących ryzyko takich ataków. Przy tym Google uważa, że bez istotnej przeróbki proponowanego prototypu nie można stworzyć uniwersalnych eksploitatów, gotowych nie tylko do demonstracji, ale i do powszechnego zastosowania.
Aby zminimalizować ryzyko, właściciele stron internetowych powinni korzystać z ostatnio wprowadzonych nagłówków Cross-Origin Opener Policy (COOP), Cross-Origin Embedder Policy (COEP), Cross-Origin Resource Policy (CORP), Fetch Metadata Request, X-Frame-Options, X-Content-Type-Options oraz SameSite Cookie. Mechanizmy te nie chronią bezpośrednio przed atakami, ale pozwalają na izolację danych strony przed wyciekiem do procesów, w których może być wykonany kod JavaScript atakującego (wyciek następuje z pamięci bieżącego procesu, w którym oprócz kodu atakującego mogą być przetwarzane dane innej strony otwartej w tej samej karcie). Główną ideą jest rozdzielenie wykonywania kodu strony od zewnętrznego kodu pochodzącego z niepewnych źródeł, na przykład włączanego przez iframe.
Źródło: opennet.ru
