

30 listopada – 1 grudnia w Niżnym Nowogrodzie odbył się. Uczestnikom zaproponowano stworzenie prototypu rozwiązania produktowego z wykorzystaniem Intel OpenVINO toolkit. Organizatorzy przygotowali listę przykładowych tematów, którymi można było się kierować przy wyborze zadania, jednak ostateczna decyzja należała do zespołów. Dodatkowo premiowano wykorzystanie modeli, które nie wchodzą w skład produktu.
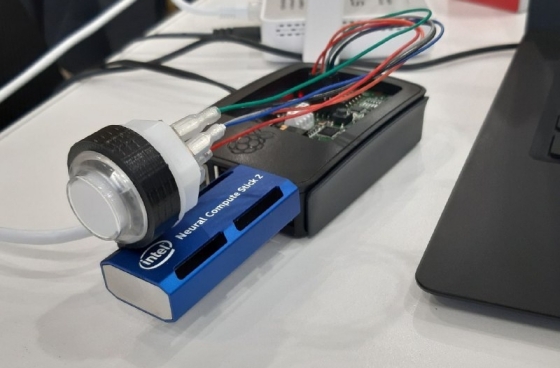
W artykule opowiemy, jak tworzyliśmy własny prototyp produktu, z którym ostatecznie zajęliśmy pierwsze miejsce.
W hackathonie wzięło udział ponad 10 zespołów. Cieszyło, że część z nich przyjechała z innych regionów. Na miejsce wydarzenia wybrano kompleks „Kremlewski na Poczainie”, gdzie wewnątrz rozwieszono stare fotografie Niżnego Nowogrodu — klimat był naprawdę wyjątkowy! (przypomnę, że obecnie centralne biuro firmy Intel znajduje się właśnie w Niżnym Nowogrodzie). Na napisanie kodu uczestnicy mieli 26 godzin, a na końcu trzeba było zaprezentować swoje rozwiązanie. Dodatkowym atutem była sesja demo, dzięki której można było upewnić się, że wszystko, co zaplanowano, rzeczywiście zostało zrealizowane, a nie pozostało jedynie pomysłem w prezentacji. Były też gadżety, przekąski i jedzenie!
Dodatkowo firma Intel na życzenie udostępniała kamery, Raspberry PI oraz Neural Compute Stick 2.
Wybór zadania
Jednym z najtrudniejszych etapów przygotowań do hackathonu o otwartej tematyce jest wybór zadania. Od razu postanowiliśmy wymyślić coś, czego jeszcze nie ma w produkcie, ponieważ w zapowiedzi wyraźnie zaznaczono, że takie podejście jest szczególnie mile widziane.
Analizując , które wchodzą w skład produktu w obecnym wydaniu, dochodzimy do wniosku, że większość z nich rozwiązuje różne zadania z zakresu computer vision. Co więcej, bardzo trudno wymyślić problem z obszaru computer vision, którego nie dałoby się rozwiązać przy użyciu OpenVINO, a nawet jeśli da się taki wymyślić, to trudno znaleźć publicznie dostępne, wstępnie wytrenowane modele. Postanawiamy więc pójść także w innym kierunku — w stronę przetwarzania i analizy mowy. Rozważamy interesujące zadanie rozpoznawania emocji na podstawie mowy. Trzeba przyznać, że w OpenVINO istnieje już model określający emocje człowieka na podstawie twarzy, ale:
- Teoretycznie można stworzyć połączony algorytm, który będzie działał zarówno na podstawie dźwięku, jak i obrazu, co powinno przełożyć się na większą dokładność.
- Kamery zwykle mają wąski kąt widzenia, więc aby objąć większy obszar, potrzeba więcej niż jednej kamery. Dźwięk nie ma takiego ograniczenia.
Rozwijając ten pomysł, weźmy jako bazę rozwiązanie dla segmentu retail. Można mierzyć poziom zadowolenia klientów przy kasach sklepowych. Jeśli któryś z klientów jest niezadowolony z obsługi i zaczyna podnosić głos, można od razu wezwać administratora.
W takim przypadku trzeba dodać rozpoznawanie osoby po głosie. Dzięki temu będziemy mogli odróżniać pracowników sklepu od klientów i generować analitykę dla każdej osoby z osobna. Dodatkowo będzie można analizować zachowanie samych pracowników sklepu i oceniać atmosferę w zespole — brzmi nieźle!
Określamy wymagania dla naszego rozwiązania:
- Mały rozmiar urządzenia docelowego
- Praca w czasie rzeczywistym
- Niska cena
- Łatwa skalowalność
Ostatecznie jako urządzenie docelowe wybieramy Raspberry Pi 3 z .
Warto tu zwrócić uwagę na jedną ważną cechę NCS — najlepiej działa ze standardowymi architekturami CNN. Jeśli jednak trzeba będzie uruchomić na nim model z niestandardowymi warstwami, należy spodziewać się niskopoziomowej optymalizacji.
Pozostała drobnostka: trzeba zdobyć mikrofon. Zwykły mikrofon USB też się nada, choć wizualnie nie będzie dobrze komponował się z RPI. Ale i na to rozwiązanie dosłownie „leży pod ręką”. Do nagrywania głosu postanawiamy użyć płytki Voice Bonnet z zestawu , na której znajduje się wlutowany mikrofon stereo.
Pobieramy Raspbian z i nagrywamy go na kartę pamięci, po czym sprawdzamy, czy mikrofon działa, za pomocą następującego polecenia (nagra ono 5 sekund dźwięku i zapisze go do pliku):
arecord -d 5 -r 16000 test.wavOd razu zaznaczę, że mikrofon jest bardzo czuły i dobrze wychwytuje szumy. Aby to skorygować, wejdźmy do alsamixer, wybierzmy Capture devices i zmniejszmy poziom sygnału wejściowego do 50–60%.
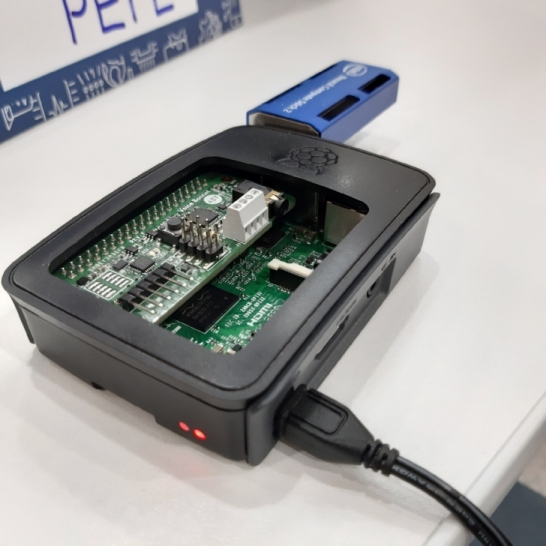
Lekko dopracowujemy obudowę pilnikiem i wszystko się mieści, można nawet zamknąć pokrywę
Dodajemy przycisk-wskaźnik
Podczas rozbierania AIY Voice Kit na części przypominamy sobie, że znajduje się tam przycisk RGB, którego podświetleniem można sterować programowo. Szukamy „Google AIY Led” i znajdujemy dokumentację:
Dlaczego nie użyć tego przycisku do wyświetlania rozpoznanej emocji? Mamy tylko 7 klas, a przycisk ma 8 kolorów, więc idealnie wystarczy!
Podłączamy przycisk przez GPIO do Voice Bonnet i importujemy potrzebne biblioteki (są już zainstalowane w dystrybucji od AIY projects)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Utwórzmy dict, w którym każdej emocji będzie odpowiadał kolor w postaci RGB Tuple oraz obiekt klasy aiy.leds.Leds, za pomocą którego będziemy aktualizować kolor:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
I na koniec po każdej nowej predykcji emocji będziemy aktualizować kolor przycisku zgodnie z jej wartością (po kluczu).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))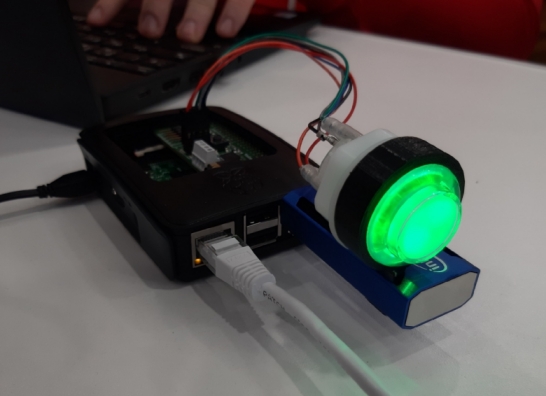
Przycisku, świeć!
Pracujemy z głosem
Do przechwytywania strumienia z mikrofonu użyjemy pyaudio, a do filtrowania szumu i wykrywania głosu — webrtcvad. Dodatkowo utworzymy kolejkę, do której będziemy asynchronicznie dodawać i z której będziemy pobierać fragmenty zawierające głos.
Ponieważ webrtcvad ma ograniczenie dotyczące rozmiaru przekazywanego fragmentu — musi on mieć długość 10/20/30 ms, a model rozpoznawania emocji (jak za chwilę zobaczymy) był trenowany na zbiorze danych 48 kHz, będziemy przechwytywać chunki o rozmiarze 48000×20 ms/1000×1(mono)=960 bajtów. Webrtcvad będzie zwracać True/False dla każdego takiego chunka, co będzie oznaczać obecność lub brak głosu w danym fragmencie.
Zaimplementujemy następującą logikę:
- Będziemy dodawać do list te chunki, w których występuje głos; jeśli głosu nie ma, zwiększamy licznik pustych chunków.
- Jeśli licznik pustych chunków >=30 (600 ms), sprawdzamy rozmiar listy zgromadzonych chunków: jeśli jest >250, dodajemy je do kolejki; w przeciwnym razie uznajemy, że długość nagrania jest niewystarczająca, aby przekazać je do modelu identyfikacji mówcy.
- Jeśli natomiast licznik pustych chunków jest nadal < 30, a rozmiar listy zgromadzonych chunków przekroczył 300, dodajemy fragment do kolejki, aby uzyskać dokładniejszą predykcję. (ponieważ z czasem emocje mają tendencję do zmian)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Nadszedł czas, aby poszukać publicznie dostępnych modeli pretrenowanych — przechodzimy na GitHub, szukamy w Google, ale pamiętamy, że mamy ograniczenia dotyczące używanej architektury. To dość złożony etap, ponieważ trzeba testować modele na własnych danych wejściowych, a dodatkowo konwertować je do wewnętrznego formatu OpenVINO — IR (Intermediate Representation). Przetestowaliśmy około 5–7 różnych rozwiązań z GitHub. O ile model do rozpoznawania emocji zadziałał od razu, to nad rozpoznawaniem głosu trzeba było posiedzieć dłużej, ponieważ wykorzystuje bardziej złożone architektury.
Zatrzymaliśmy się na następujących rozwiązaniach:
- Emocje z głosu —
Działa to według następującej zasady: dźwięk jest dzielony na fragmenty o określonym rozmiarze, dla każdego z tych fragmentów wyodrębniamy a następnie podajemy je na wejście do CNN - Rozpoznawanie po głosie —
Tutaj zamiast MFCC pracujemy ze spektrogramem; po FFT podajemy sygnał do CNN, gdzie na wyjściu otrzymujemy wektorową reprezentację głosu.
Dalej omówimy konwersję modeli, zaczynając od teorii. OpenVINO obejmuje kilka modułów:
- Open Model Zoo, którego modele można było wykorzystywać i integrować z własnym produktem
- Model Optimzer, dzięki któremu można przekonwertować model z różnych formatów frameworków (Tensorflow, ONNX itp.) do formatu Intermediate Representation, z którym będziemy dalej pracować
- Inference Engine umożliwia uruchamianie modeli w formacie IR na procesorach Intel, układach Myriad i akceleratorach Neural Compute Stick
- Najbardziej wydajna wersja OpenCV (z obsługą Inference Engine)
Każdy model w formacie IR jest opisywany przez dwa pliki: .xml i .bin.
Modele są konwertowane do formatu IR za pomocą Model Optimizer w następujący sposób:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typepozwala wybrać format danych, z którym będzie pracował model. Obsługiwane są FP32, FP16, INT8. Dobór optymalnego typu danych może dać zauważalny wzrost wydajności.
--input_shapeokreśla wymiary danych wejściowych. Możliwość ich dynamicznej zmiany najwyraźniej istnieje w C++ API, ale nie zagłębialiśmy się aż tak daleko i dla jednego z modeli po prostu ustawiliśmy je na stałe.
Następnie spróbujemy załadować już przekonwertowany model w formacie IR przez moduł DNN w OpenCV i wykonać na nim forward.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Ostatnia linia w tym przypadku pozwala przekierować obliczenia na Neural Compute Stick. Domyślnie obliczenia wykonywane są na procesorze, ale w przypadku Raspberry Pi to się nie sprawdzi — potrzebny będzie stick.
Dalsza logika jest następująca: dzielimy nasze audio na okna o określonym rozmiarze (u nas to 0,4 s), każde z tych okien przekształcamy do MFCC, a następnie podajemy je do sieci:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Następnie wybieramy klasę, która najczęściej występuje dla wszystkich okien. To proste rozwiązanie, ale na hackathon nie trzeba wymyślać niczego przesadnie skomplikowanego, chyba że jest na to czas. Pracy mamy jeszcze sporo, więc idziemy dalej i zajmujemy się rozpoznawaniem głosu. Trzeba przygotować bazę, w której będą przechowywane spektrogramy wcześniej nagranych głosów. Ponieważ czasu zostało niewiele, rozwiązujemy ten problem najlepiej, jak się da.
Konkretnie: tworzymy skrypt do nagrywania fragmentu głosu (działa tak samo, jak opisano wyżej, tylko po przerwaniu z klawiatury zapisuje głos do pliku).
Próbujemy:
python3 voice_db/record_voice.py test.wavNagrywamy głosy kilku osób (w naszym przypadku trzech członków zespołu)
Następnie dla każdego nagranego głosu wykonujemy fast fourier transform, otrzymujemy spektrogram i zapisujemy go jako numpy array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Więcej szczegółów w pliku
create_base.py
W efekcie przy uruchomieniu głównego skryptu na samym początku otrzymamy embeddingi z tych spektrogramów:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Po uzyskaniu embeddingu z wypowiedzianego fragmentu możemy określić, do kogo należy, obliczając cosine distance między tym fragmentem a wszystkimi głosami w bazie (im mniejsza wartość, tym większe prawdopodobieństwo) — na potrzeby demo ustawiliśmy próg 0.3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Na koniec zaznaczę, że szybkość inferencji była wysoka i pozwalała dodać jeszcze 1–2 modele (dla próbki o długości 7 sekund inferencja zajmowała 2.5). Nie zdążyliśmy już dodać nowych modeli i skupiliśmy się na przygotowaniu prototypu aplikacji webowej.
Aplikacja webowa
Ważna kwestia: zabieramy ze sobą router z domu i konfigurujemy własną sieć lokalną, co pomaga połączyć urządzenie i laptopy w jednej sieci.
Backend stanowi przelotowy kanał komunikatów między frontendem a Raspberry Pi, oparty na technologii websocket (protokół http over tcp).
Pierwszym etapem jest odbiór przetworzonych informacji z Raspberry Pi, czyli predykcji spakowanych do json, które w połowie drogi są zapisywane w bazie danych, aby można było tworzyć statystyki dotyczące tła emocjonalnego użytkownika w danym okresie. Następnie ten pakiet jest wysyłany do frontendu, który korzysta z subskrypcji i odbioru pakietów z endpointu websocket. Cały mechanizm backendu został zbudowany w języku golang; wybór padł na niego, ponieważ dobrze nadaje się do zadań asynchronicznych, z którymi goroutines radzą sobie bardzo dobrze.
Przy dostępie do endpointu użytkownik jest rejestrowany i dodawany do struktury, po czym następuje odebranie jego komunikatu. Zarówno użytkownik, jak i komunikat trafiają do wspólnego hubu, z którego wiadomości są następnie przekazywane dalej (do zasubskrybowanego frontendu), a jeśli użytkownik zamknie połączenie (Raspberry Pi lub frontend), jego subskrypcja jest anulowana i zostaje on usunięty z hubu.
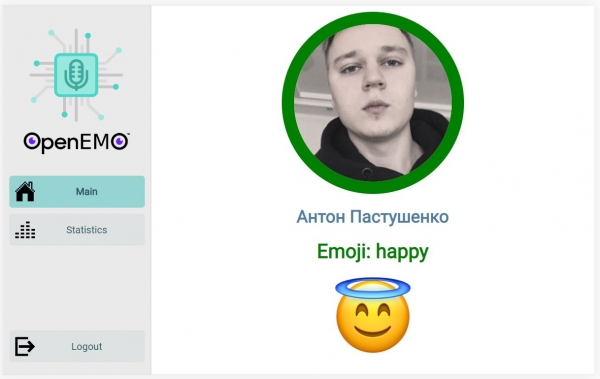
Oczekiwanie na połączenie z backendemFront-end to aplikacja webowa napisana w JavaScript z wykorzystaniem biblioteki React, co przyspiesza i upraszcza proces tworzenia. Celem tej aplikacji jest wizualizacja danych uzyskanych za pomocą algorytmów uruchomionych po stronie back-endu oraz bezpośrednio na Raspberry Pi. Strona posiada routing między sekcjami, zrealizowany przy użyciu react-router, jednak największe znaczenie ma strona główna, na której w czasie rzeczywistym pojawia się ciągły strumień danych z serwera przesyłany przez WebSocket. Raspberry Pi wykrywa głos, określa, do której osoby z zarejestrowanej bazy należy, i wysyła klientowi listę probability. Klient wyświetla najnowsze aktualne dane, pokazuje awatar osoby, która z największym prawdopodobieństwem mówiła do mikrofonu, a także emocję, z jaką wypowiada słowa.

Strona główna z aktualizowanymi predykcjamiPodsumowanie
Nie udało się dopracować wszystkiego zgodnie z planem — po prostu zabrakło czasu, dlatego największą nadzieję pokładaliśmy w demo i w tym, że wszystko zadziała. Podczas prezentacji opowiedzieliśmy, jak całość jest zbudowana, jakie modele wybraliśmy i z jakimi problemami się zmierzyliśmy. Następnie przyszła pora na demo — eksperci chodzili po sali w dowolnej kolejności i podchodzili do każdej drużyny, aby zobaczyć działający prototyp. Nam również zadawali pytania, a każdy odpowiadał za swoją część. Na laptopie zostawiliśmy otwartą aplikację webową i rzeczywiście wszystko działało tak, jak oczekiwaliśmy.
Warto zaznaczyć, że łączny koszt naszego rozwiązania wyniósł 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (można użyć płytki respeaker) ~ 15$
- Intel NCS 2 ~ 100$
Co można ulepszyć:
- Wprowadzić rejestrację po stronie klienta — poprosić o przeczytanie tekstu generowanego losowo
- Dodać jeszcze kilka modeli: na podstawie głosu można określać płeć i wiek
- Rozdzielać głosy brzmiące jednocześnie (diaryzacja)
Repozytorium:

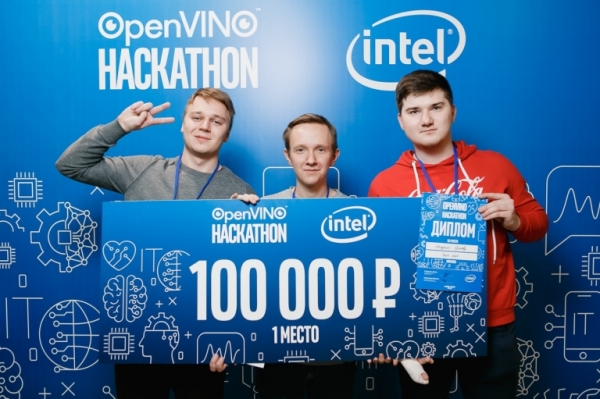
Zmęczeni, ale szczęśliwi — myNa zakończenie chcielibyśmy podziękować organizatorom i uczestnikom. Spośród projektów innych zespołów szczególnie spodobało nam się rozwiązanie do monitorowania wolnych miejsc parkingowych. Było to dla nas niesamowicie wartościowe doświadczenie zanurzenia się w produkt i proces tworzenia. Mam nadzieję, że w regionach będzie odbywać się coraz więcej interesujących wydarzeń, także związanych z tematyką AI.
Źródło: habr.com
